Base vectorielle Elasticsearch : transférez en quelques minutes, scalez à un coût abordable jusqu'à des centaines de milliards
Les aspects complexes de la recherche hybride sont déjà pris en compte. Des paramètres par défaut optimisés, des modèles Jina AI natifs et tiers, ainsi que l'inférence GPU gérée sont disponibles immédiatement. Créez des applications d'IA rapides et scalables, sans vous soucier de l'infrastructure.

Que doit faire votre base de données vectorielle pour vous ?


Base vectorielle Elasticsearch : plus que de simples vecteurs, appréciée des développeurs
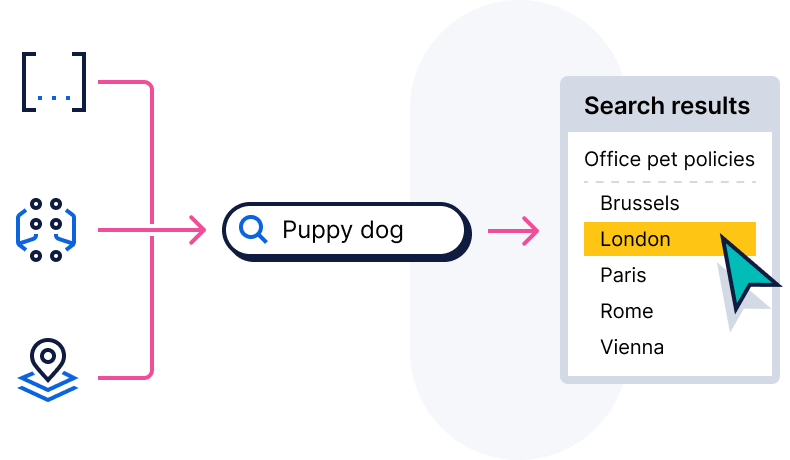
Pas de lacunes ni de compromis. Paramètres par défaut optimisés. Recherche hybride. Tout fonctionne ensemble, parce qu’il a été conçu de cette manière.
Un seul appel suffit : de zéro à la recherche vectorielle en quelques minutes
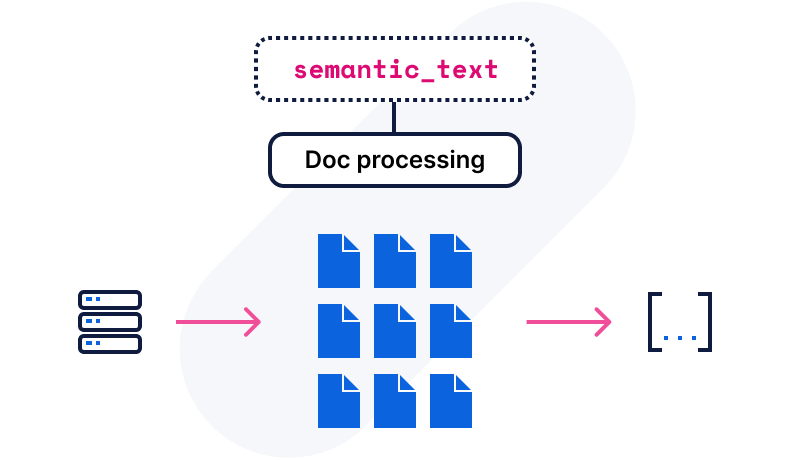
Lancez-vous avec la base vectorielle Elasticsearch. La solution la plus rapide pour la recherche vectorielle grâce à des paramètres par défaut adaptés aux charges de travail vectorielles, la recherche hybride, ainsi que la possibilité de générer des embeddings ou d'utiliser les vôtres.
Apportez votre contenu et laissez-nous nous occuper du reste.
from elasticsearch import Elasticsearch

client = Elasticsearch(
   "https://xyz.elastic.cloud:443",
   api_key="..",

)

client.indices.create(
   index="my_semantic_vectors",
   mappings={
       "properties": {
           "content": {"type": "text", "copy_to": "semantic_content"},
           "semantic_content": {"type": "semantic_text"},
       }
   },
)

client.bulk(
   operations=[
       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Yellowstone National Park spans Wyoming, Montana, and Idaho, covering over 2.2 million acres. It is famous for the geyser Old Faithful and sits atop the Yellowstone Caldera, a supervolcano."},

       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Yosemite National Park covers over 750,000 acres in California. A UNESCO World Heritage Site, it is best known for its granite cliffs, waterfalls, and giant sequoia trees."},

       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Rocky Mountain National Park is known for its mountainous terrain, including Longs Peak, the highest in the park. It is a popular destination for hiking, camping, and wildlife viewing."},
   ],
)
from elasticsearch import Elasticsearch

client = Elasticsearch(
   "https://xyz.elastic.cloud:443",
   api_key="..",

)

client.indices.create(
   index="my_semantic_vectors",
   mappings={
       "properties": {
           "content": {"type": "text", "copy_to": "semantic_content"},
           "semantic_content": {"type": "semantic_text"},
       }
   },
)

client.bulk(
   operations=[
       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Yellowstone National Park spans Wyoming, Montana, and Idaho, covering over 2.2 million acres. It is famous for the geyser Old Faithful and sits atop the Yellowstone Caldera, a supervolcano."},

       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Yosemite National Park covers over 750,000 acres in California. A UNESCO World Heritage Site, it is best known for its granite cliffs, waterfalls, and giant sequoia trees."},

       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Rocky Mountain National Park is known for its mountainous terrain, including Longs Peak, the highest in the park. It is a popular destination for hiking, camping, and wildlife viewing."},
   ],
)
Développer avec la base vectorielle Elasticsearch


Base de données vectorielle, et le reste de ce dont vous avez réellement besoin
La recherche vectorielle en conditions réelles exige bien plus que de simples vecteurs. Combinez recherche sémantique, filtres, sécurité, champs structurés et classement BM25 au sein d'une requête unique, sans assemblage complexe.

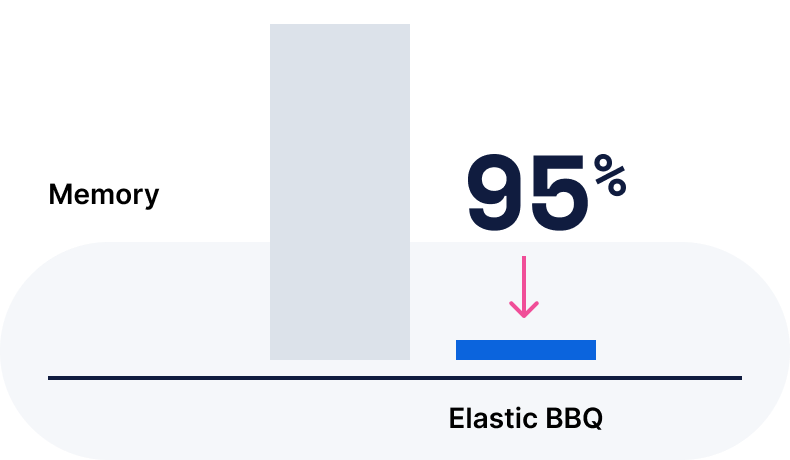
Un voisinage de haute qualité
Du prompt au produit, comment les équipes développent avec la base vectorielle Elasticsearch.
Témoignage client
FRAIM s'appuie sur Elasticsearch pour développer une plateforme de recherche de connaissances adaptée à l'ère de l'IA, regroupant nativement la recherche textuelle et vectorielle afin de réduire les coûts globaux de sa plateforme de recherche de plus de 50 % et d'accélérer considérablement le développement de solutions RAG et d'agents IA.
Témoignage client
WP Engine utilise Elasticsearch pour intégrer l'innovation IA aux sites web WordPress, en tirant parti des intégrations natives de Google Cloud pour réduire le temps de développement des fonctionnalités IA de plusieurs semaines à quelques heures et offrir des temps de réponse de recherche de 5 ms sans aucune indisponibilité.
Témoignage client

Adobe scale, gère plusieurs cas d'utilisation et met les fonctionnalités de Machine Learning au service d'Elastic.
Résultats, en chiffres
Benchmarks de performance et résultats de la base vectorielle Elasticsearch.


Lancez-vous : des ressources pour chaque étape du développement
Ingestion, analyse et indexation
Intégrer
Récupération
Outils de développement
Intégrer
Récupération
Outils de développement
Questions fréquentes
Qu’est-ce qu’une base vectorielle et comment fonctionne-t-elle ?
Qu’est-ce qu’une base vectorielle et comment fonctionne-t-elle ?
Une base vectorielle stocke les informations sous forme de vecteurs, qui sont des représentations numériques d'objets de données, également appelées embeddings. Elle utilise ces embeddings pour effectuer des recherches multimodales au sein d'ensembles de données massifs comprenant des données structurées, non structurées et semi-structurées, telles que des images, du texte, des vidéos et de l'audio. Conçues pour gérer les embeddings, ces bases de données offrent ainsi une solution complète de gestion des données.
Que sont les plongements vectoriels ?
Que sont les plongements vectoriels ?
Les plongements vectoriels utilisent un modèle de Machine Learning pour traduire le texte en chiffres, ce qui vous permet d'effectuer des recherches vectorielles. En convertissant les données en vecteurs, les plongements facilitent la comparaison, la recherche et l'analyse des similitudes entre les éléments de cet espace.
Quels sont les avantages d’une base vectorielle ?
Quels sont les avantages d’une base vectorielle ?
Une base vectorielle offre une efficacité à grande échelle en permettant une migration transparente des données dans les environnements sur site, isolés physiquement et de cloud souverain, tout en assurant le stockage des embeddings.
Les bases vectorielles excellent dans la recherche par similarité, permettant de trouver aisément des éléments connexes, ce qui est essentiel pour les systèmes de recommandation, la recherche d'images et la découverte de contenu. Grâce à leurs capacités de recherche sémantique, elles dépassent la simple correspondance de mots-clés pour fournir des résultats fondés sur le sens et le contexte. En stockant les embeddings, elles prennent en charge les applications d'IA et de Machine Learning, facilitant ainsi le déploiement de modèles de traitement du langage naturel (NLP) et de recommandation.
Elasticsearch est une base vectorielle.
Elasticsearch est une base vectorielle.
Oui, Elasticsearch est la base de données vectorielle open source la plus largement déployée au monde, vous offrant un moyen efficace de créer, de stocker et de rechercher des plongements vectoriels à grande échelle. Avec la base de données vectorielle d'Elastic, prête pour l'entreprise, vous obtenez des temps de requête rapides et des performances optimales, même avec des données qui changent rapidement. Conçu pour scaler, elle fournit des résultats de recherche pertinents et personnalisés tout en simplifiant les processus de développement.
Pourquoi choisir Elastic comme base vectorielle ?
Pourquoi choisir Elastic comme base vectorielle ?
Elasticsearch est la base vectorielle la plus téléchargée au monde, conçue spécialement pour permettre aux développeurs de créer plus rapidement et à moindre coût des expériences d'IA scalables et des fonctionnalités de recherche de haute précision. La base vectorielle Elasticsearch prend en charge les aspects complexes de la recherche hybride grâce à des paramètres par défaut optimisés, une prise en charge native des modèles Jina AI et tiers, ainsi qu'une inférence GPU gérée, le tout prêt à l'emploi. Effectuez des recherches vectorielles et par mots-clés sur des données textuelles, d'image et multimodales au sein d'un index unique, sans avoir à créer ni à maintenir de pipeline d'embeddings. Préconfigurée pour les charges de travail vectorielles, elle offre des performances élevées, absorbe automatiquement les pics de trafic et réduit ses ressources lorsque la demande diminue. Bénéficiez des fonctionnalités de sécurité, de contrôle d'accès basé sur les rôles (RBAC) et de récupération des données que vous attendez, afin de vous concentrer sur le développement d'applications plutôt que sur la gestion de l'infrastructure.
Puis-je exécuter Elasticsearch en tant que base vectorielle sur site ou isolée ?
Puis-je exécuter Elasticsearch en tant que base vectorielle sur site ou isolée ?
Oui. Elasticsearch est entièrement déployable sur site — sur serveur physique, dans un cloud privé ou sur des réseaux totalement isolés sans connectivité externe. Les agences gouvernementales, les sous-traitants de la défense et les entreprises réglementées utilisent Elastic Cloud Enterprise (ECE) pour orchestrer à grande échelle des clusters Elasticsearch sur site, y compris dans des environnements classifiés et déconnectés. Toutes les capacités de recherche vectorielle, de recherche hybride et de RAG disponibles sur Elastic Cloud sont également disponibles dans les déploiements sur site.