Observabilité tout signal, deux fois moins chère
Elastic Observability peut traiter des données à l’échelle du pétaoctet deux fois moins cher que Datadog, afin que l’IA agentique dispose d’une vue d’ensemble complète sur les logs, les métriques et les traces pour détecter et résoudre rapidement les problèmes.
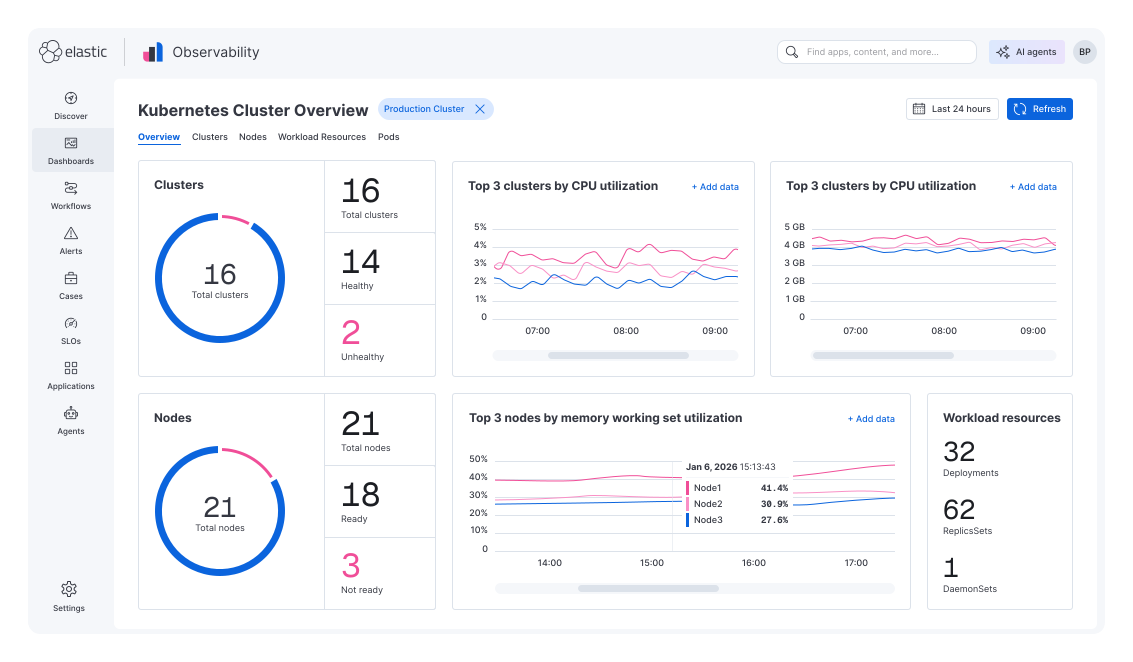
Observability à l'échelle de l'IA
Les charges de travail d’IA et cloud-native génèrent davantage de données de télémétrie que les équipes ne peuvent se permettre de conserver. Résultat : des angles morts qui compromettent la gestion des incidents et l’analyse des causes profondes.
Efficacité hors pair pour les logs, les métriques et les traces
Conservez tout. Elasticsearch intègre davantage de données télémétriques dans moins d’espace de stockage, pour des coûts réduits et des performances élevées — même pour les données à haute cardinalité.
Vos logs ont la réponse. Elastic la trouve.
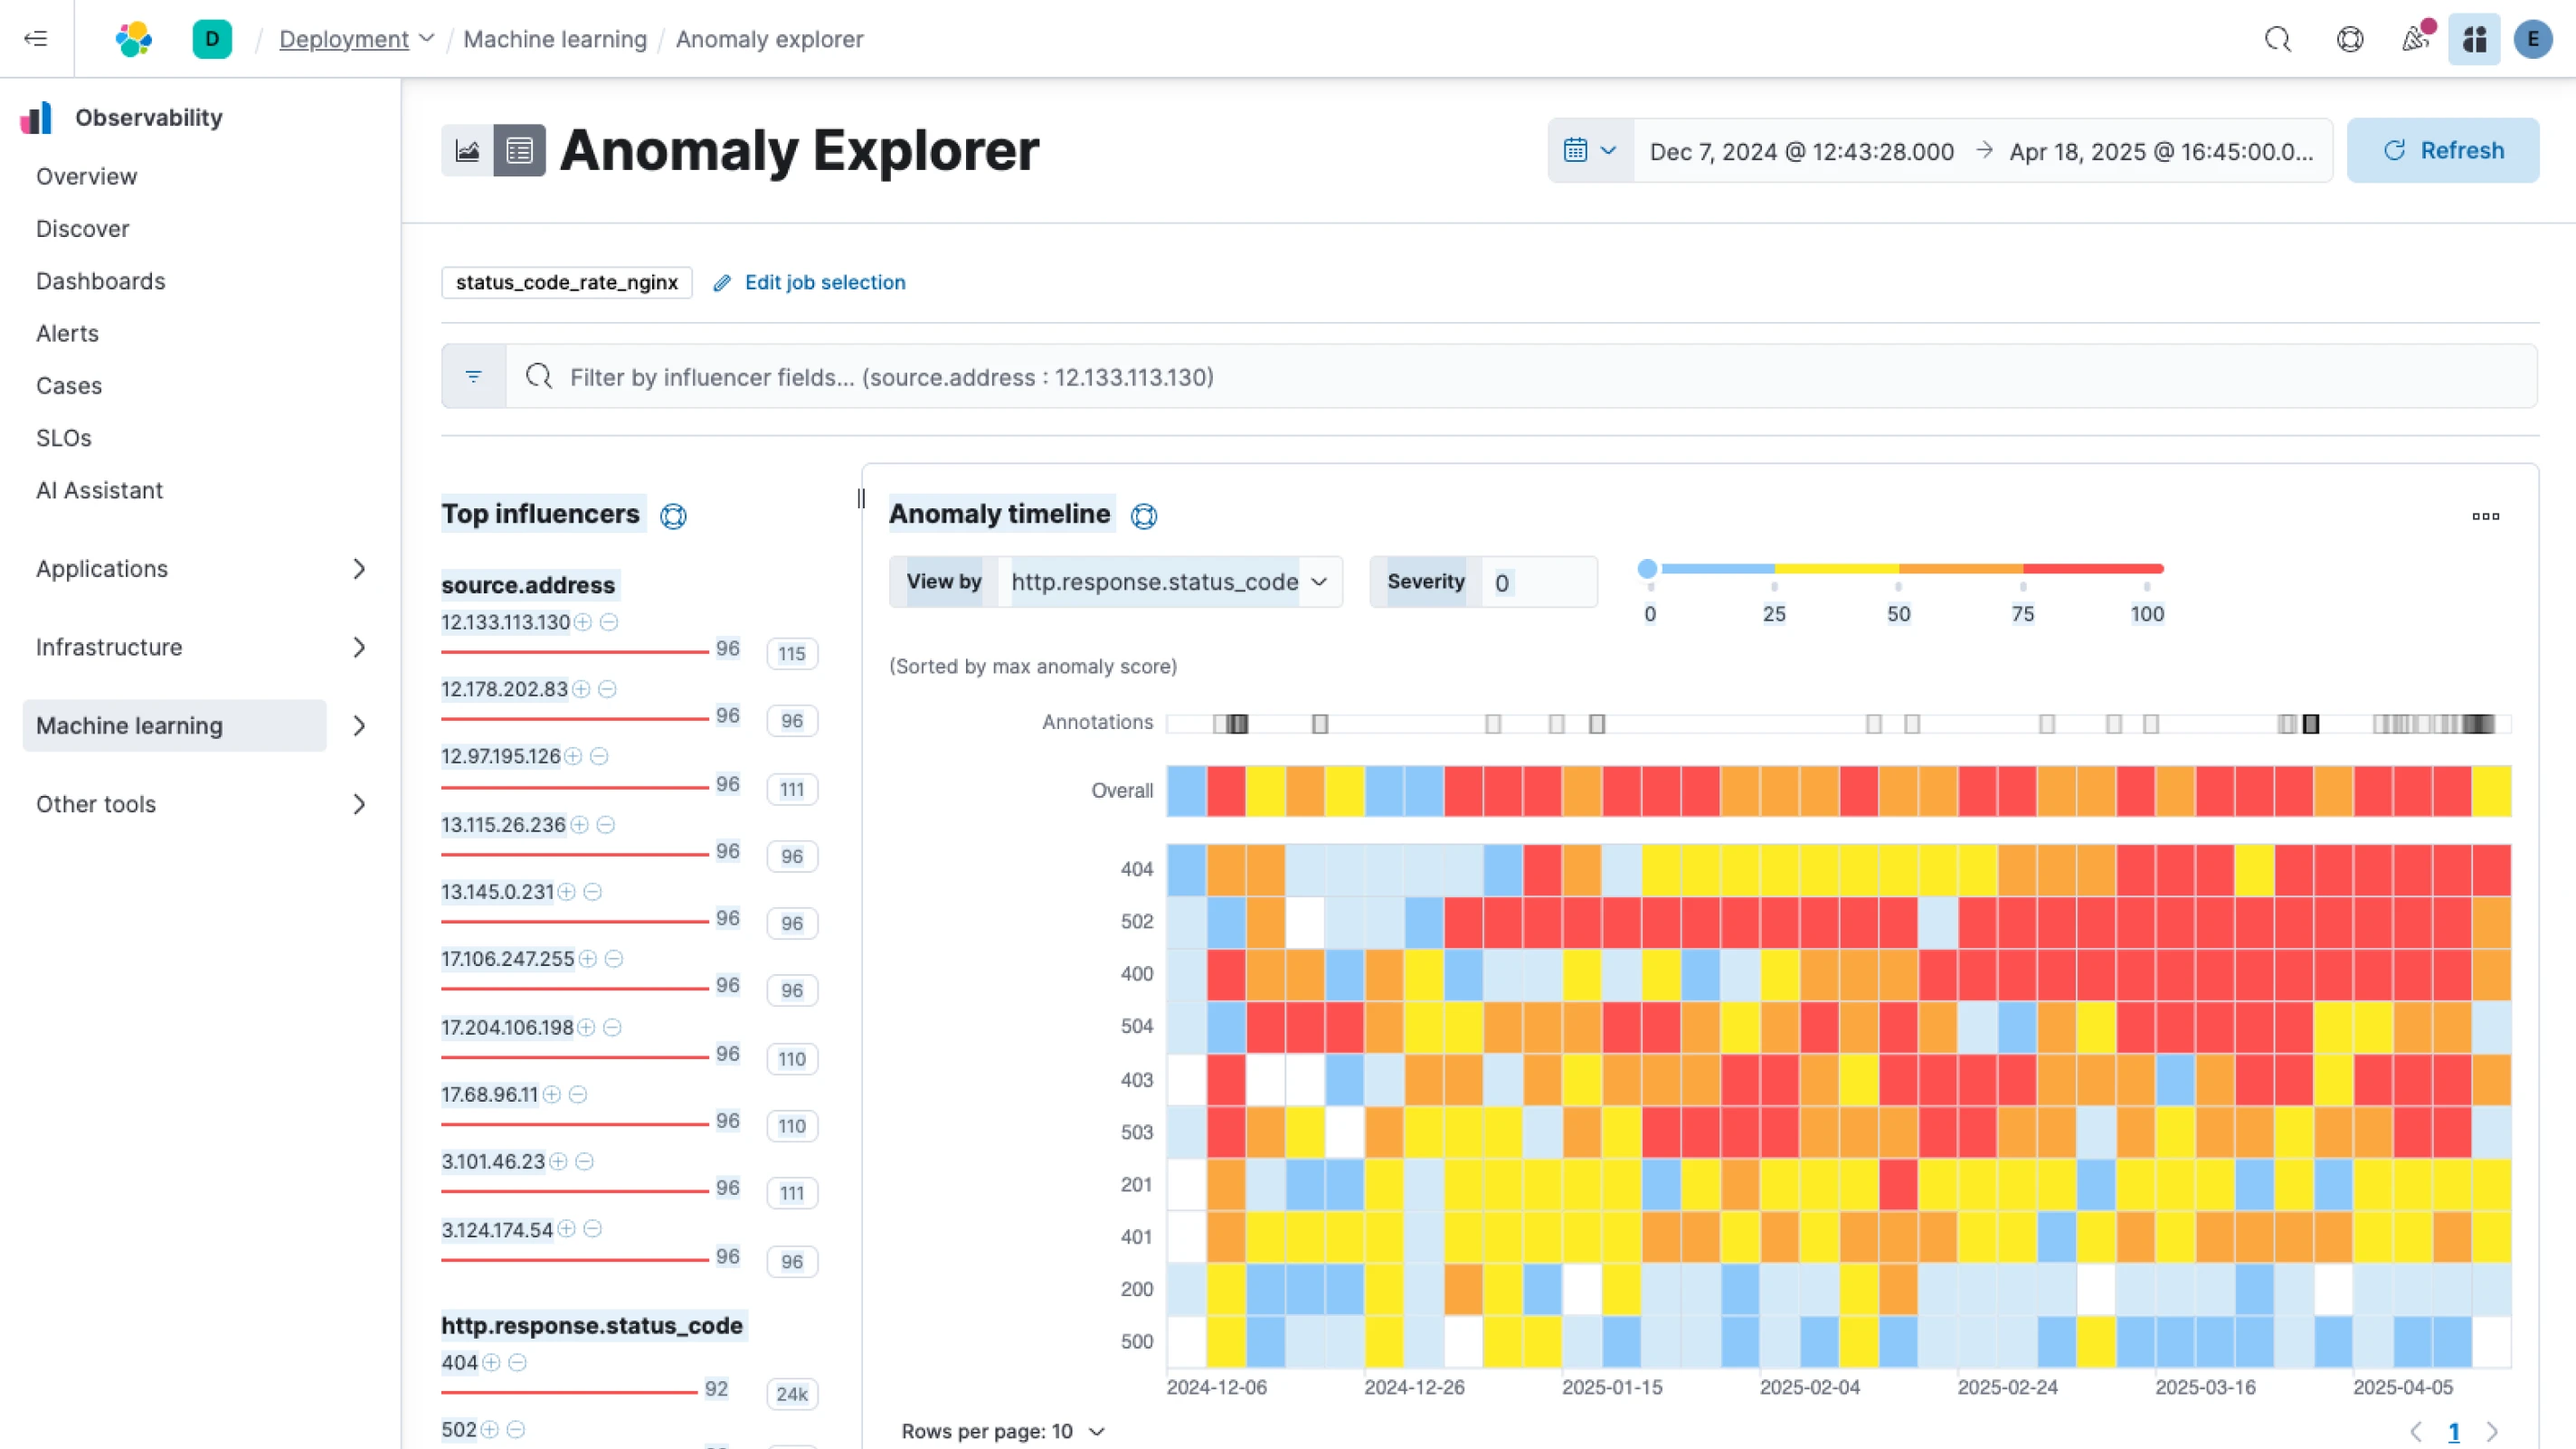
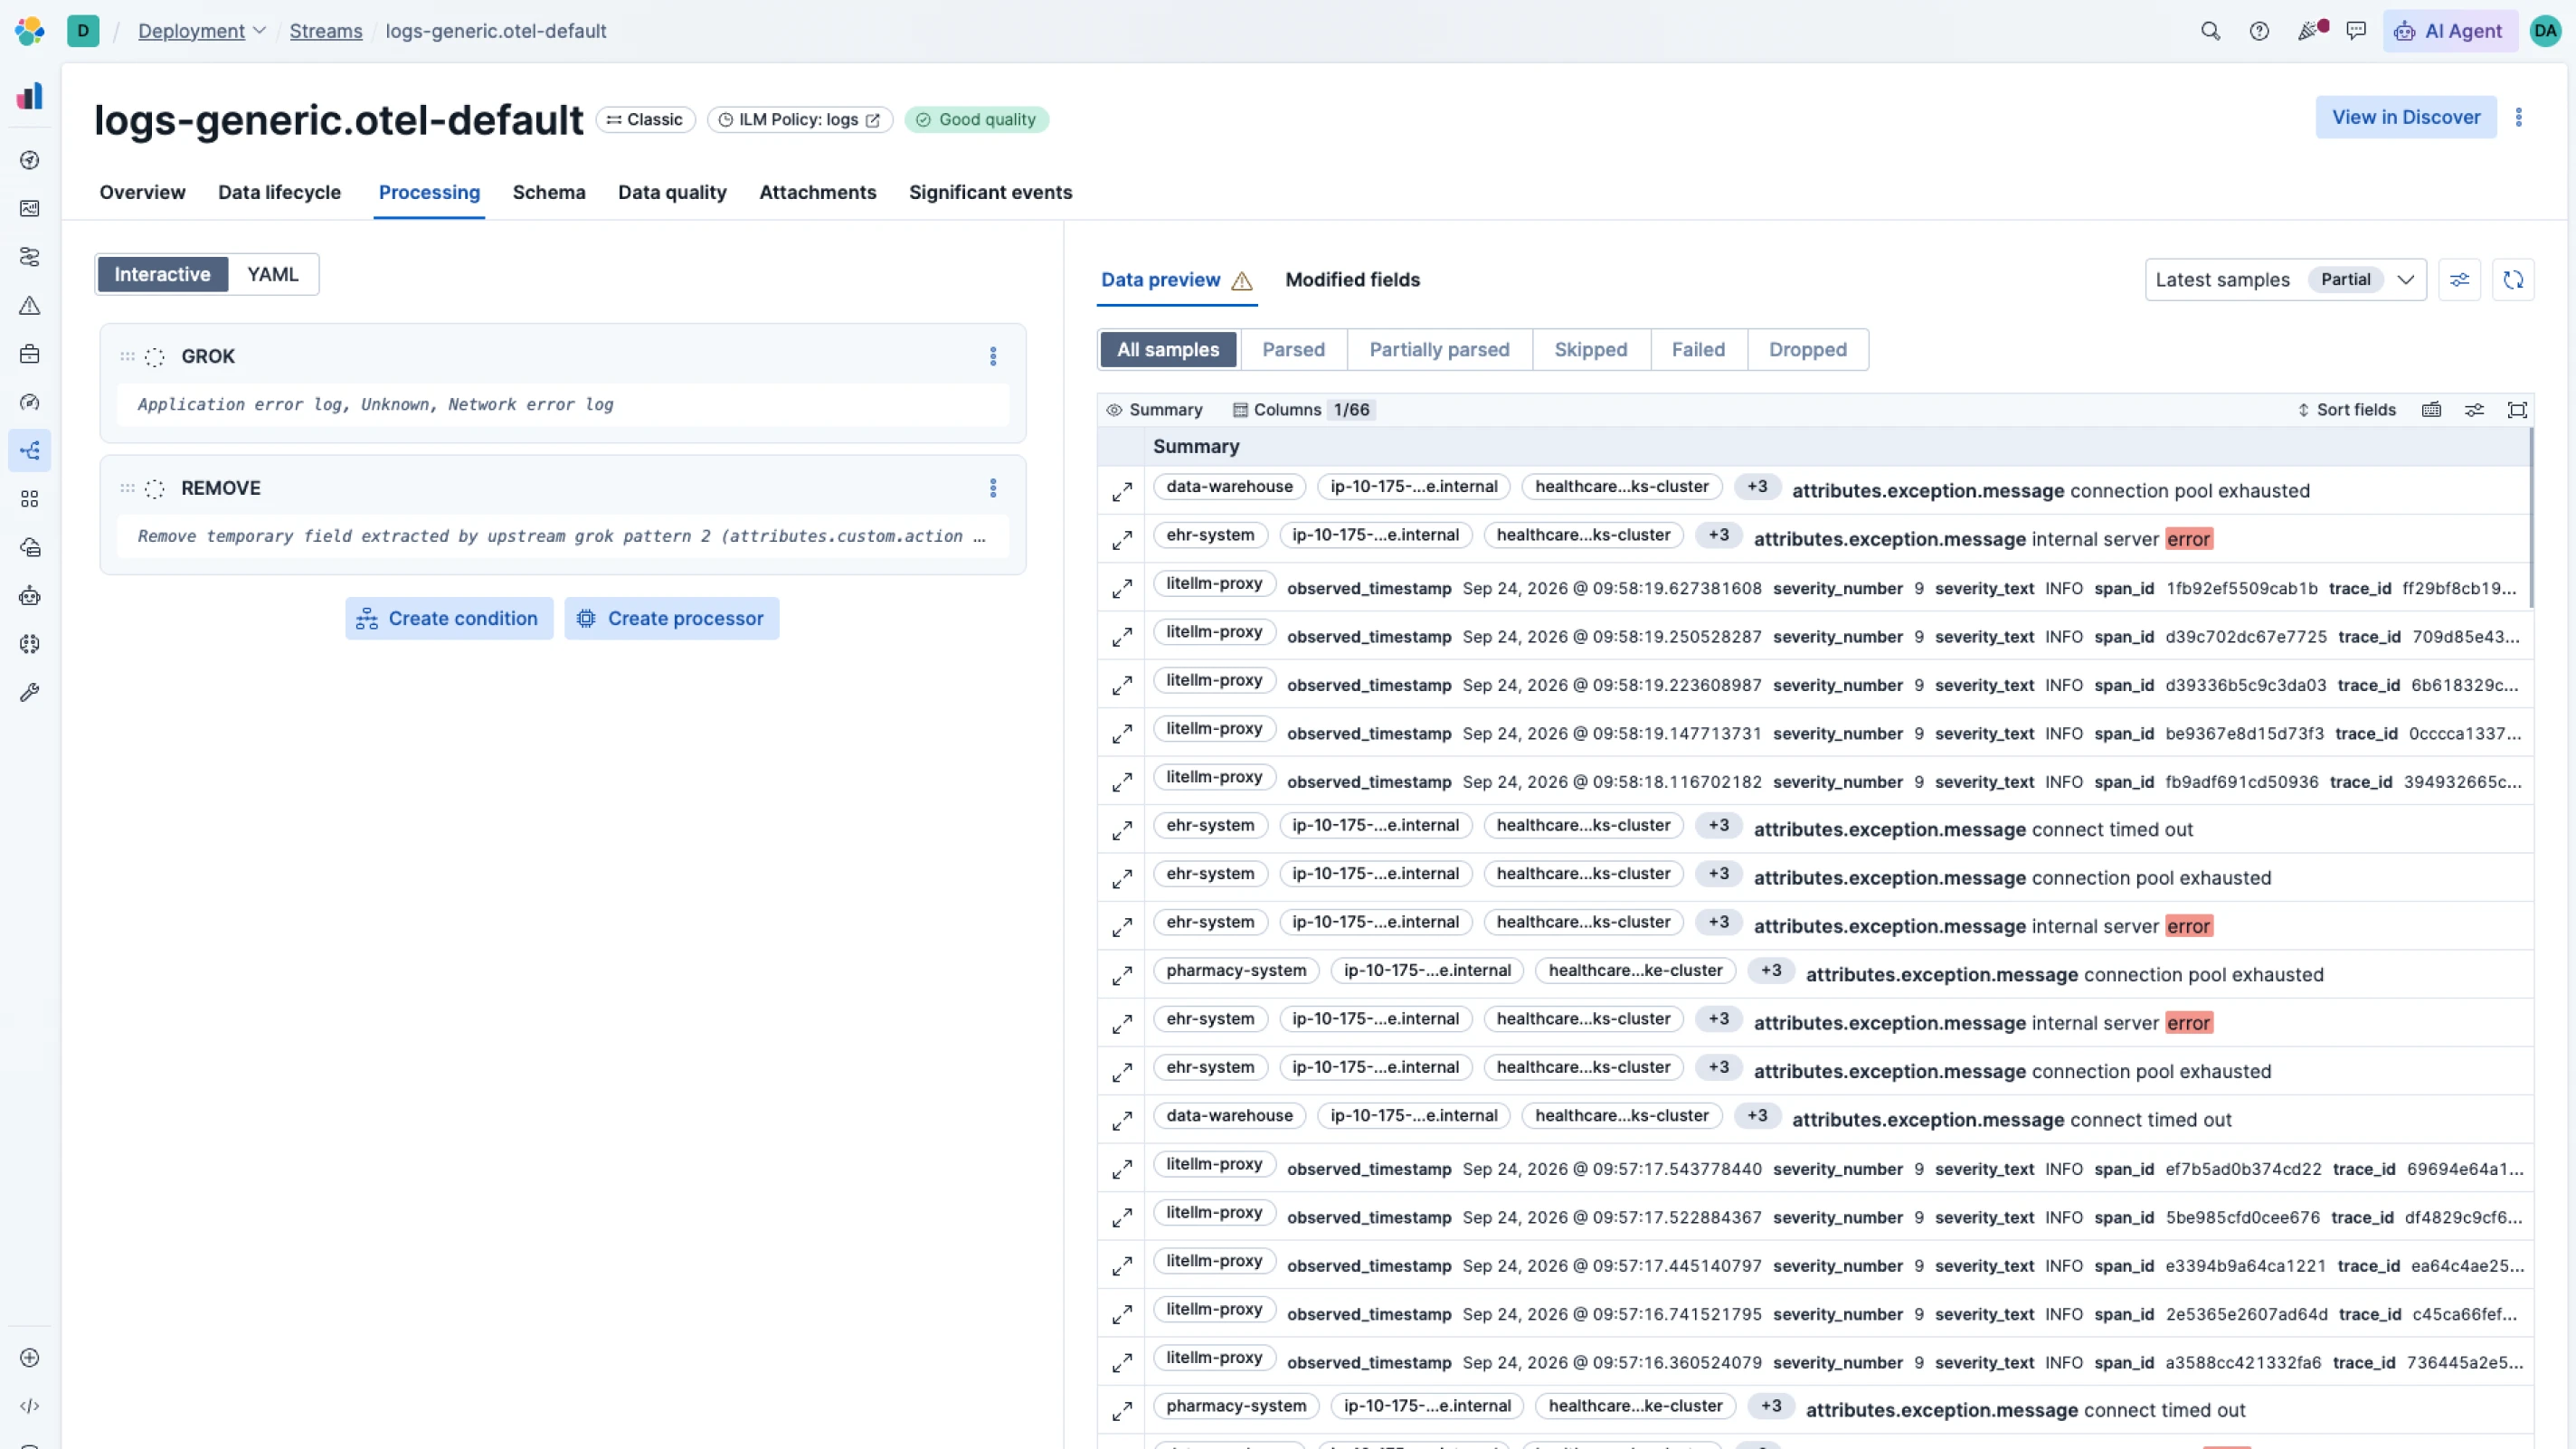
Elastic extrait la structure, le sens et le contexte opérationnel de la télémétrie brute, transformant un signal réactif et réservé aux experts en un signal proactif.
Enquêtes pilotées par l’IA avec un contexte complet
Elastic offre aux agents IA SRE et au ML le contexte le plus riche possible pour mener des investigations, identifier les causes premières et automatiser la remédiation, avec une transparence qui permet aux équipes de garder le contrôle.
OpenTelemetry-first et Prometheus natif
Ingérez toutes les données depuis n’importe quelle source. Elastic est ouvert par conception, indépendant des schémas, natif Prometheus et construit dès le départ sur OpenTelemetry (OTel).
Une seule et même plateforme pour tout
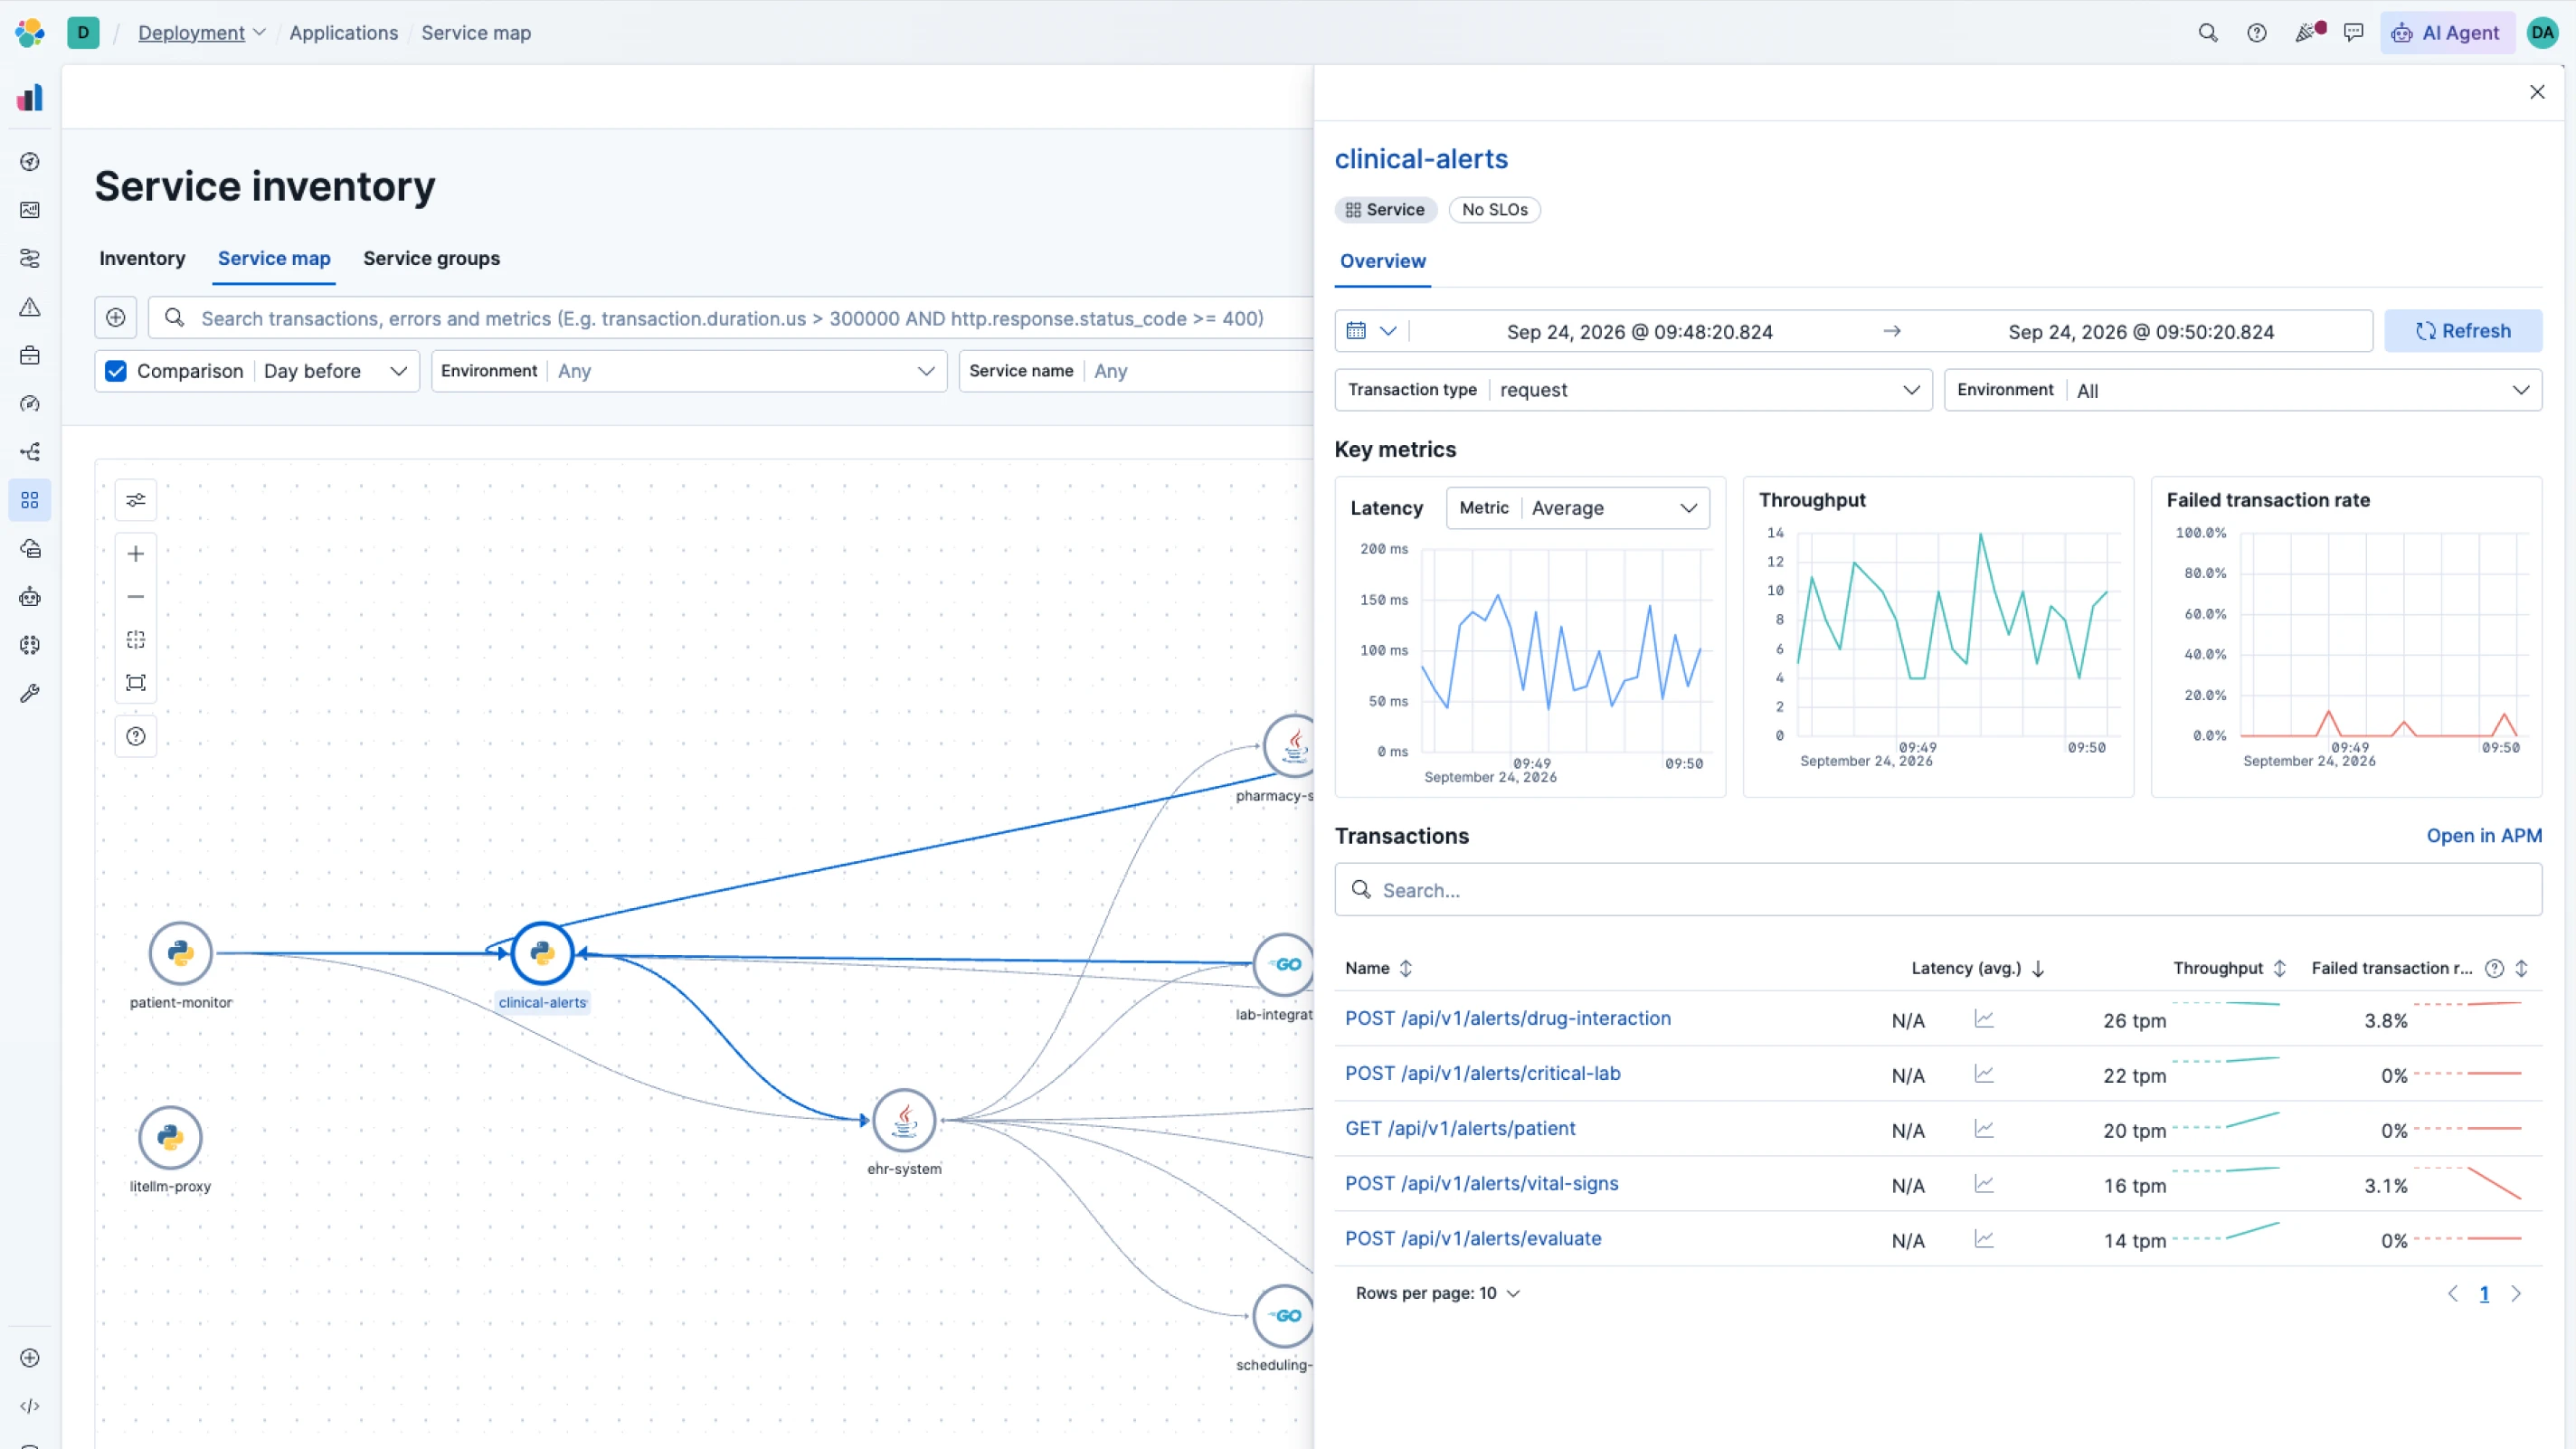
Tous les signaux, une seule source de référence. Connectez vos données avec plus de 550 intégrations en un clic dans les clouds, le CI/CD, les bases de données et bien plus.
Efficacité hors pair
La qualité de l’IA dépend de la plateforme de données qui la soutient. De l’architecture de stockage aux performances des requêtes, chaque élément d’Elasticsearch a été conçu dans un but précis.
Découvrez comment nous avons reconstruit Elasticsearch pour en faire un datastore de métriques en colonnes de premier plan.
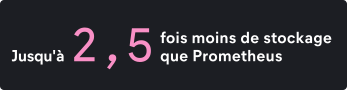
Mode d'indexation LogsDB
Un mode d’indexation spécialement conçu pour les données de logs et de traces. Le tri intelligent par host.name et @timestamp améliore considérablement la compression. Synthetic _source reconstruit les champs à la demande.
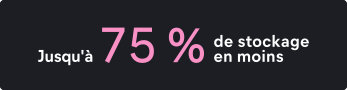
Métriques requête performance
ES|QL fournit des réponses en moins d'une seconde à des millions de métriques de séries temporelles, la vitesse qu'exigent les demandes d'investigations par IA.
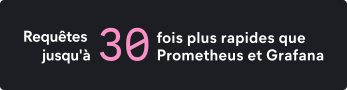
Efficacité du stockage des métriques
Stockez davantage de données pour un contexte IA plus riche à moindre coût grâce aux fonctions de saut de valeurs doc, d’identifiants Synthetic et de réduction de seq_no — une amélioration multipliée par 6,6 depuis un an.
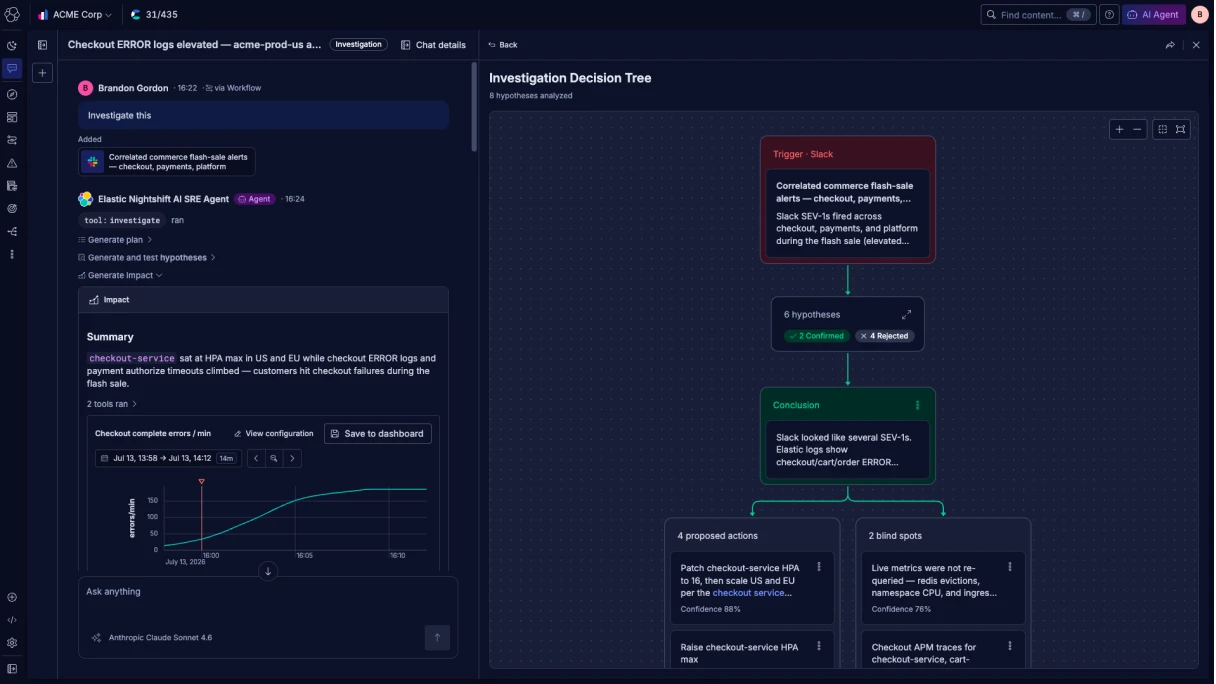
Mène des investigations comme un SRE et vous montre comment il y est parvenu
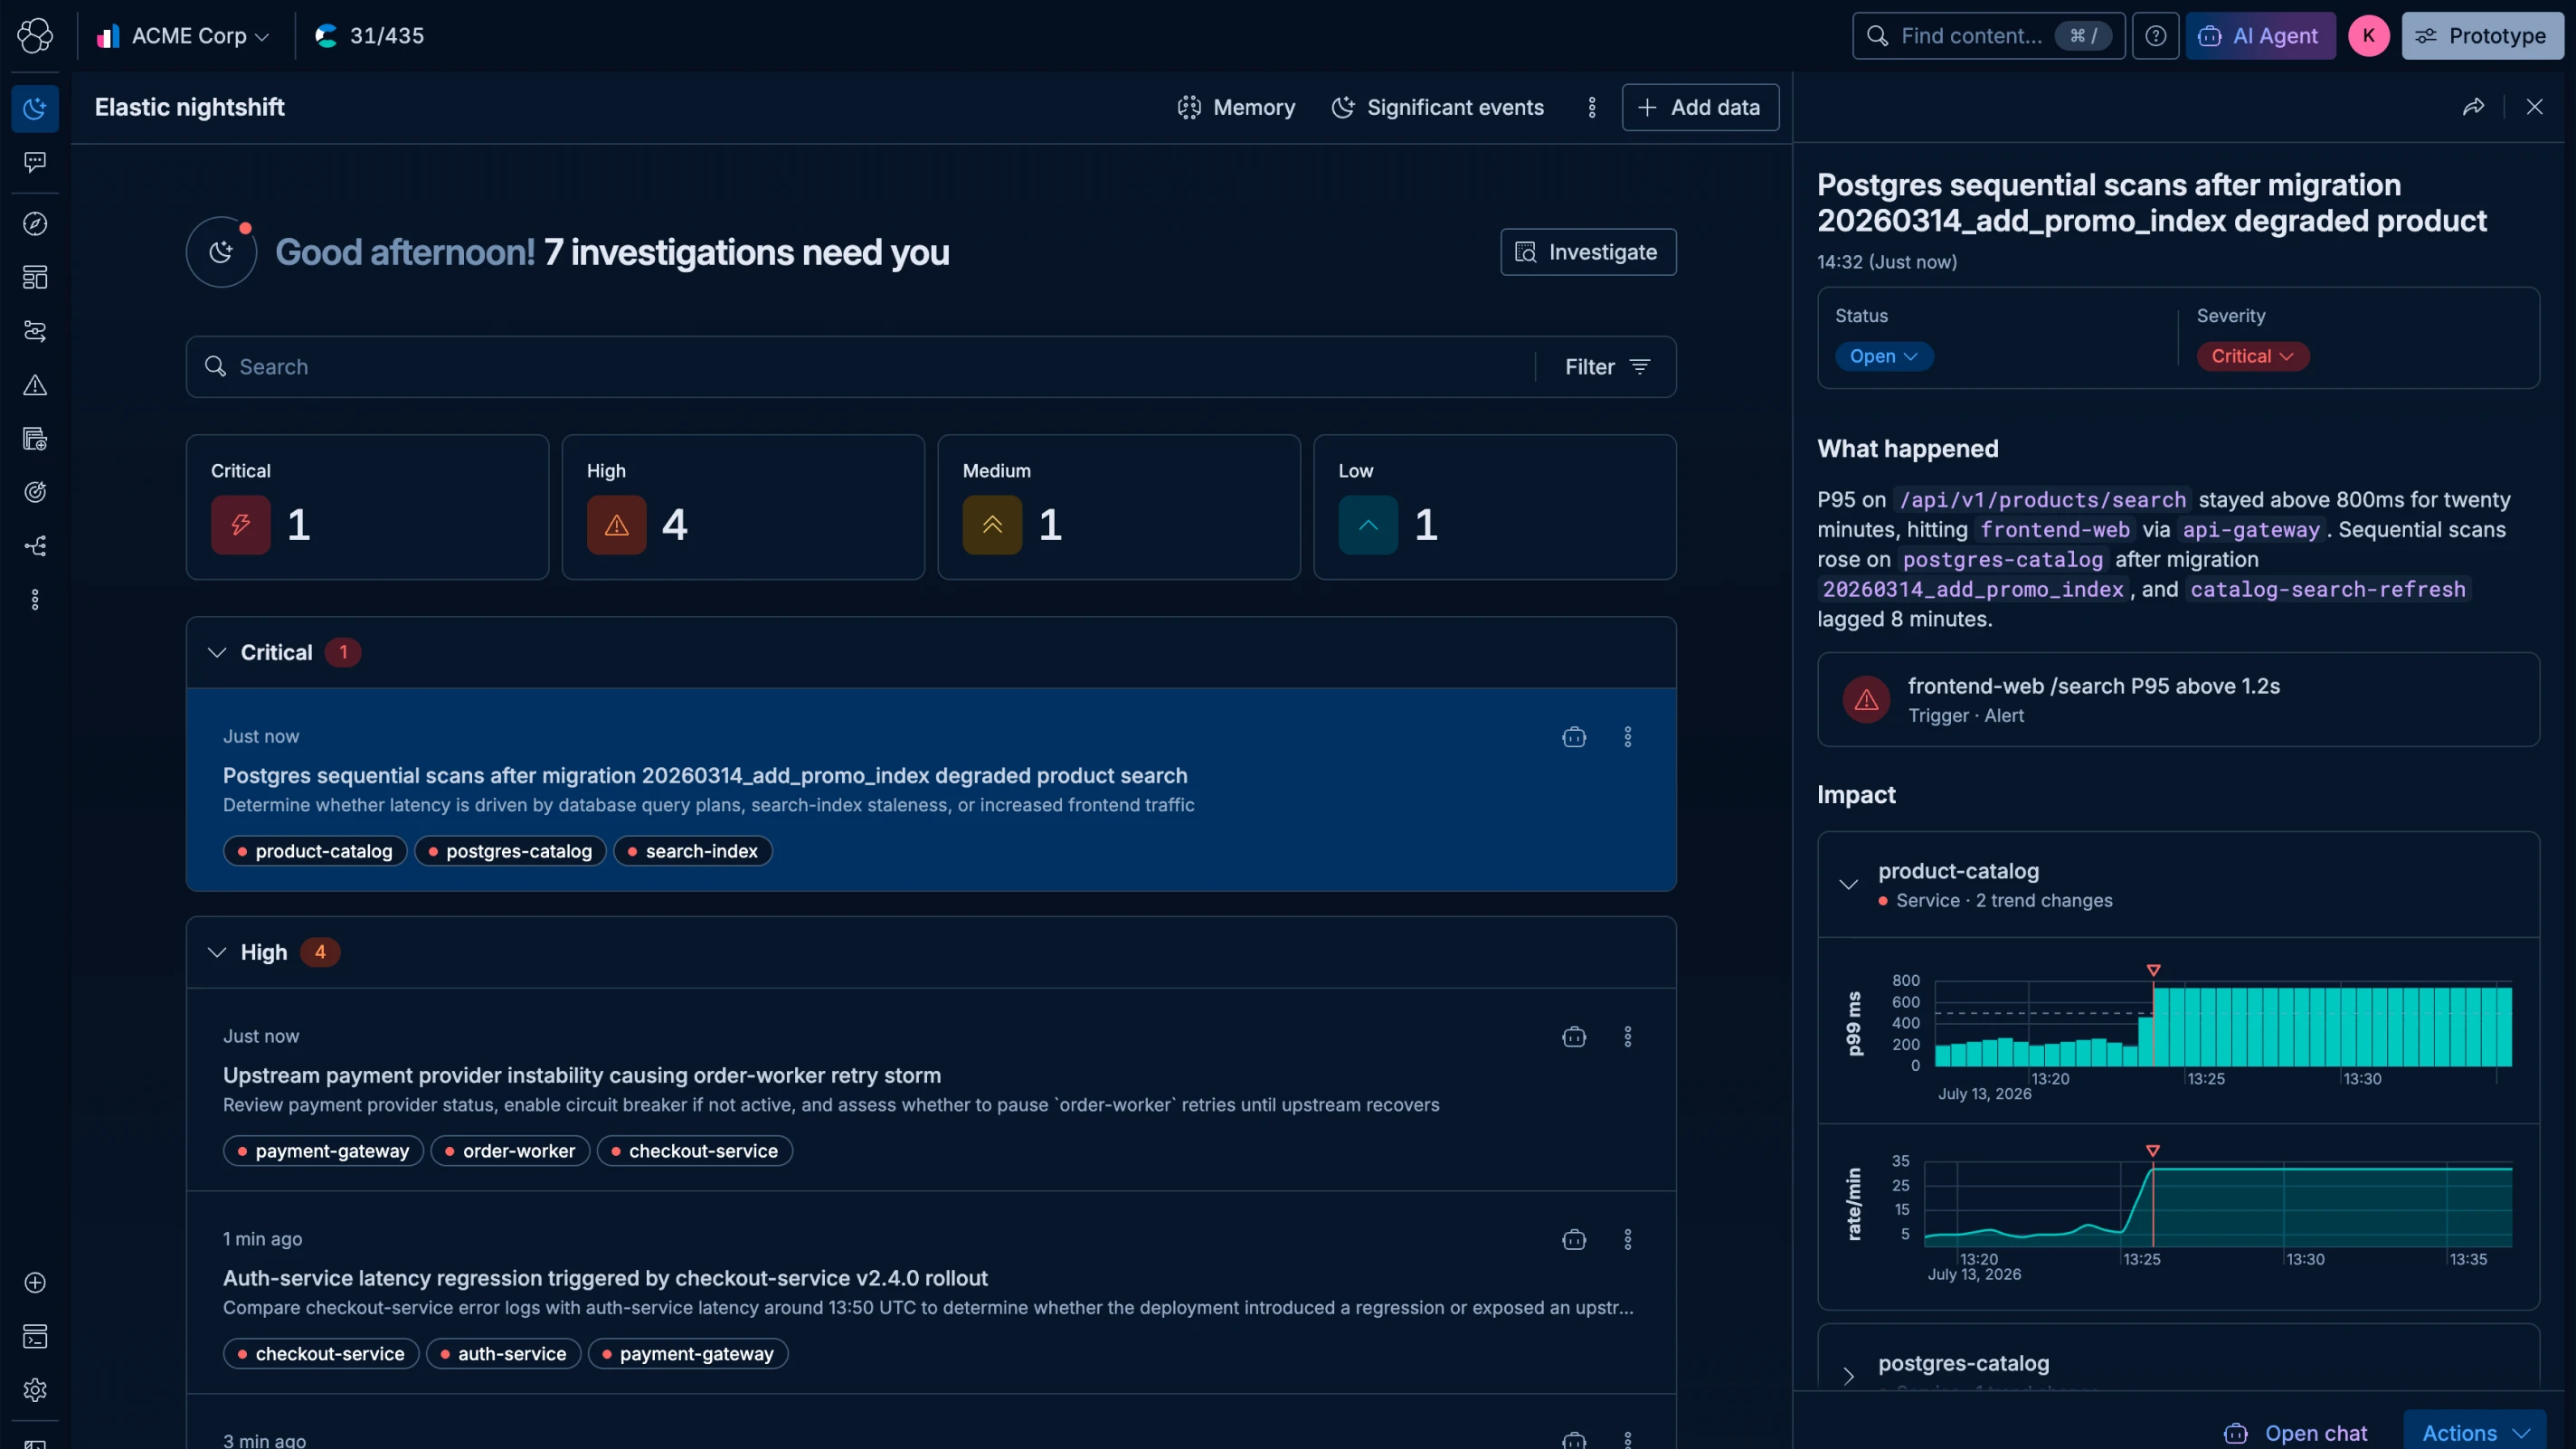
Elastic nightshift AI SRE ne se contente pas de savoir quoi chercher : elle apprend à enquêter. En suivant la chaîne causale à la manière d'un SRE, elle examine plusieurs hypothèses simultanément et identifie la cause fondamentale en toute transparence quant à sa démarche.
Apprend de chaque incident
Raisonnement transparent, étayé par des preuves
Une résolution à laquelle vous pouvez faire confiance
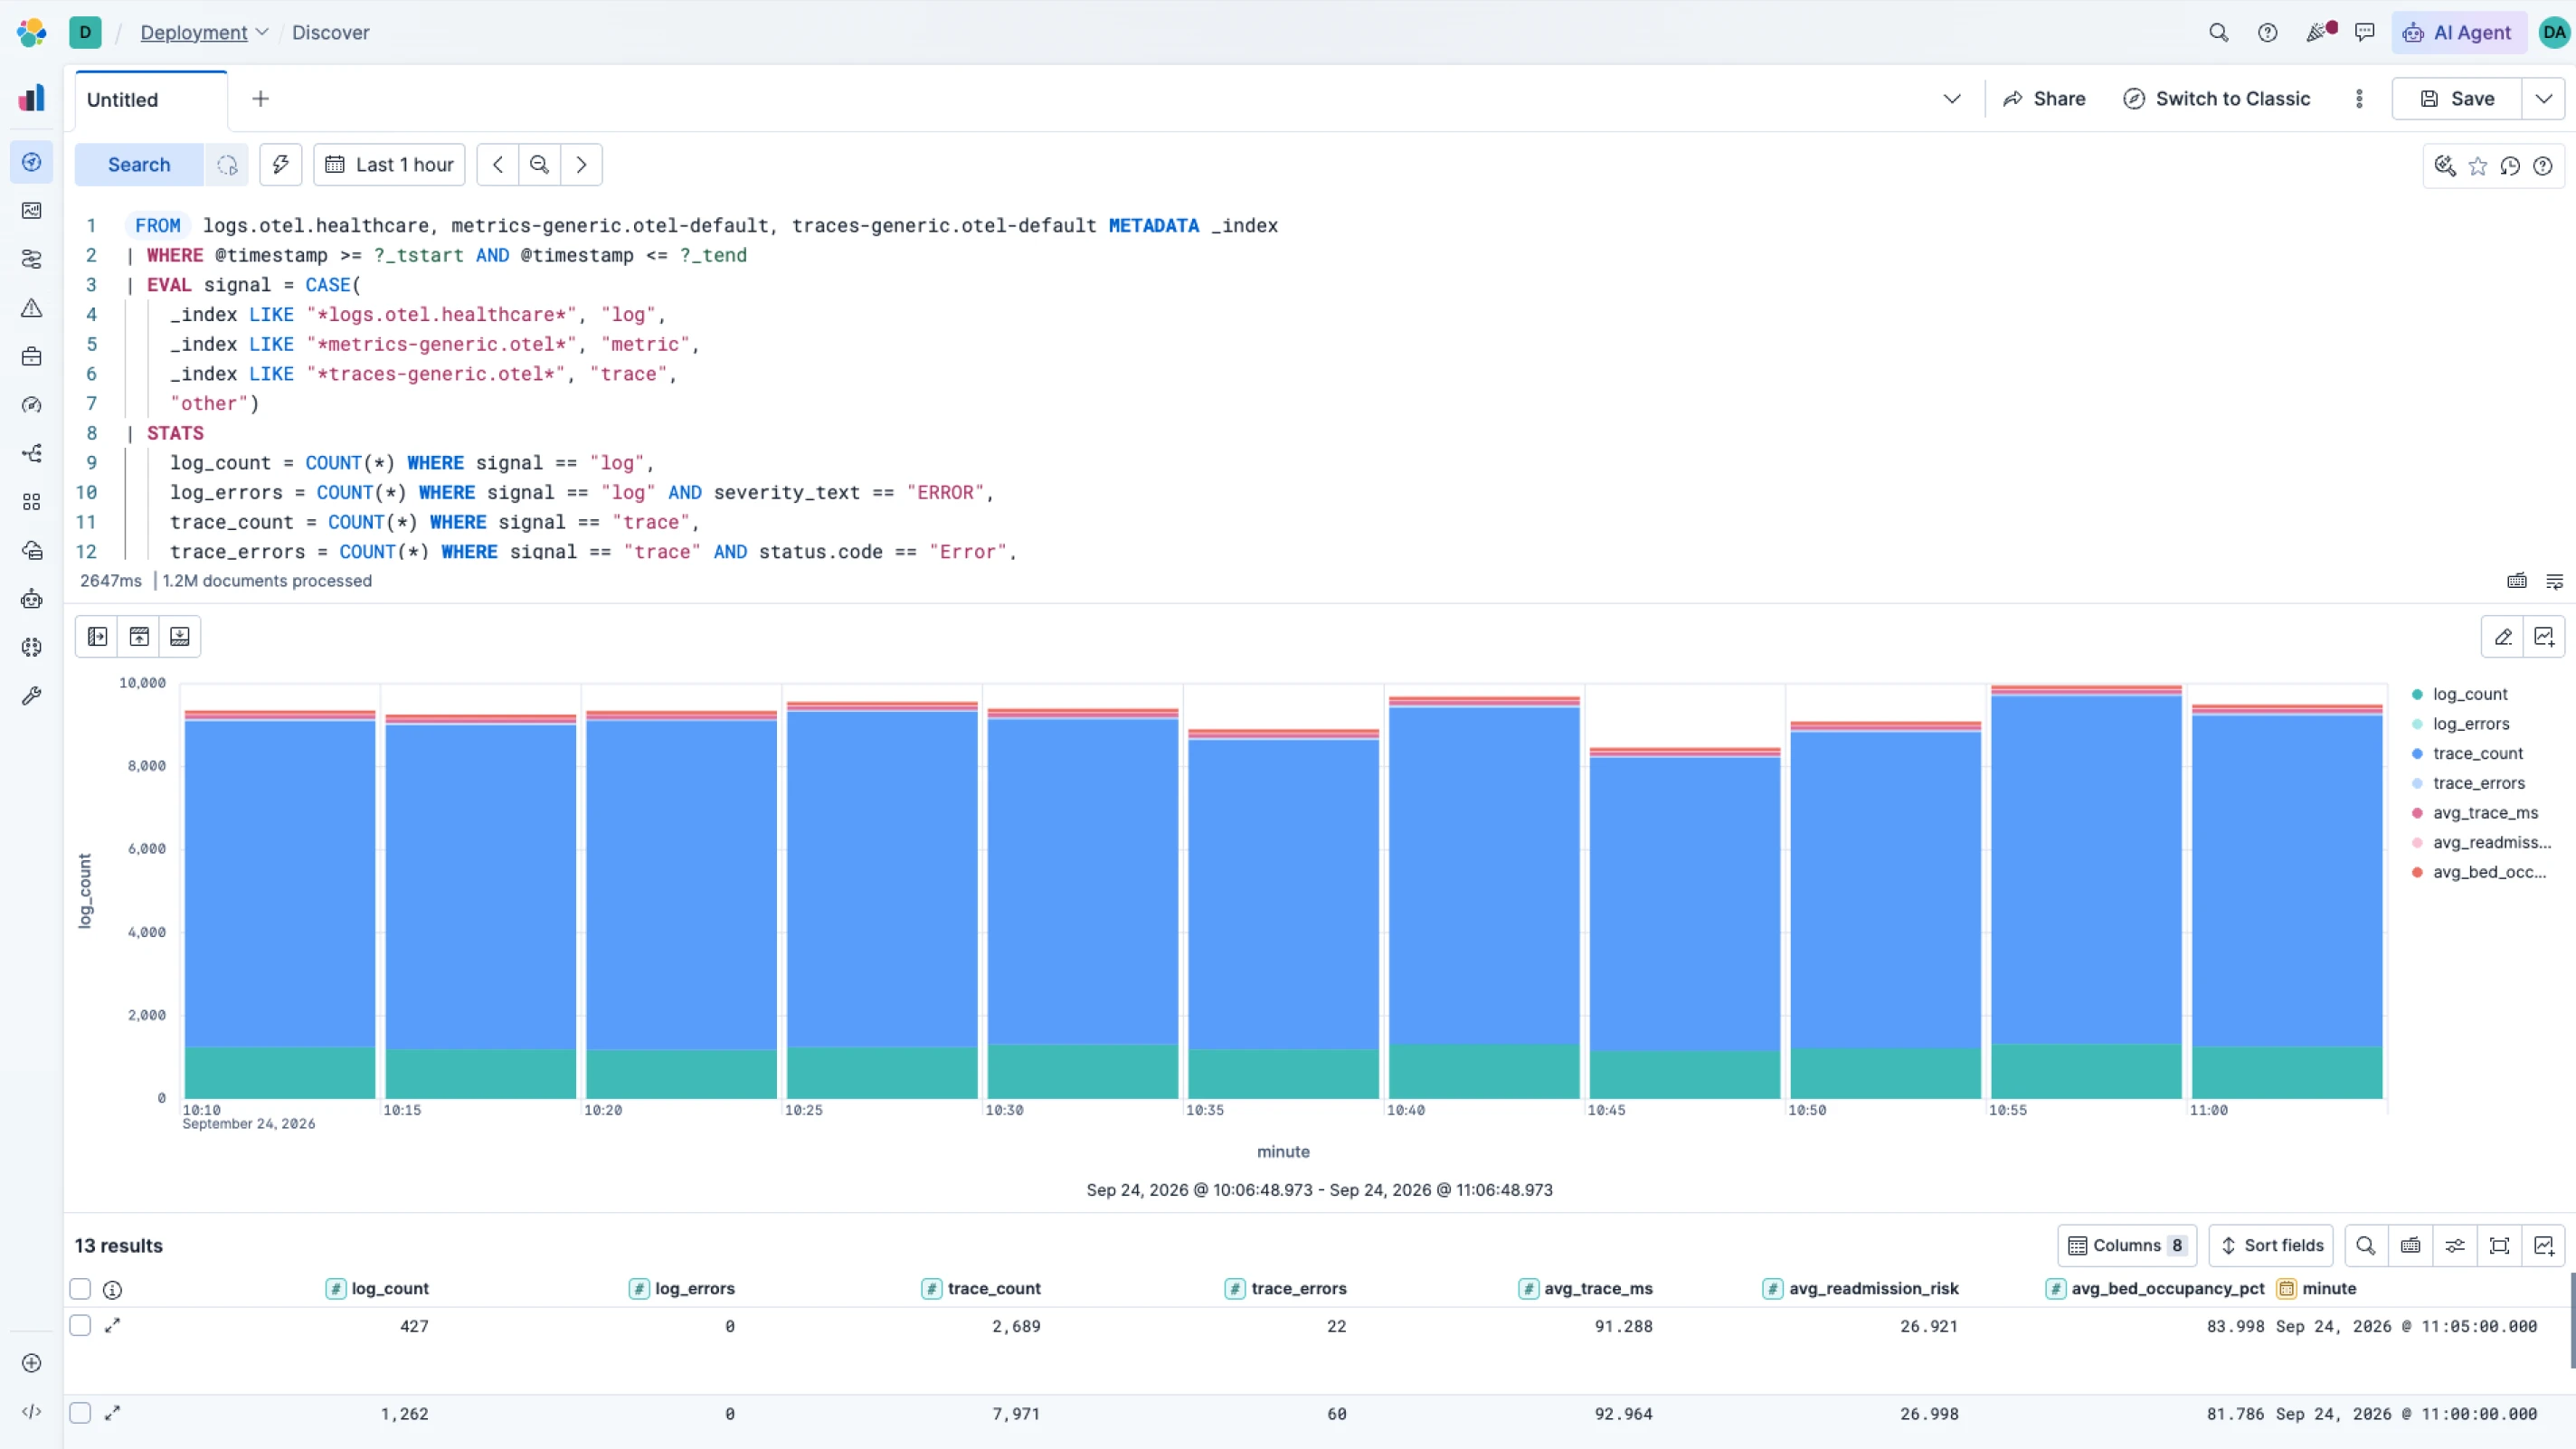
Des données aux réponses — sans autre recherche
De l’exploration des logs aux investigations agentiques, Elastic Observability est conçu autour de la façon dont les SRE de permanence pensent et travaillent réellement.
Le SRE IA intégré d’Elastic pilote l’analyse des causes premières et la correction. Interagissez directement avec votre télémétrie en langage naturel et résolvez les problèmes plus rapidement sans changer d’onglet ni de contexte.
Ce que disent les analystes sur Elastic Observability
75 % des entreprises classées au Fortune 100 lui font confiance pour stimuler l’innovation
« Avec Elastic Observability, nous pouvons réduire ou prévenir les pannes de réseau, accélérer l'analyse de la cause première et mettre au jour des informations intéressantes sur le comportement du réseau.Tout ceci contribue à réduire les problèmes du réseau et à améliorer la satisfaction des clients. »
« Avec Elastic Observability, nous pouvons réduire ou prévenir les pannes de réseau, accélérer l'analyse de la cause première et mettre au jour des informations intéressantes sur le comportement du réseau.Tout ceci contribue à réduire les problèmes du réseau et à améliorer la satisfaction des clients. »
Erwin Halmans, chef de projet, Data Driven Network Operations and Assurance
Rejoignez la discussion
Connectez-vous à la communauté mondiale d'Elastic et participez à des conversations ouvertes et à la collaboration.
Questions fréquentes
Qu'est-ce que l'observabilité ?
L’observabilité fait référence à la collecte et à l’analyse de la télémétrie, telle que les logs, les métriques et les traces, provenant d’une grande variété de sources, afin de fournir des informations détaillées sur le comportement de l'infrastructure et des applications qui s’exécutent dans vos environnements.
Quelle est la différence entre l'observabilité et le monitoring ?
L'observabilité peut être considérée comme l'évolution du monitoring pour les applications modernes. Il s'agit essentiellement de la capacité des applications et de l'infrastructure à exposer leur état interne via des logs exploitables, des métriques publiées et des traces distribuées. En tant qu'approche, l'observabilité est mieux adaptée que la surveillance traditionnelle pour gérer la complexité et l'échelle des environnements cloud natifs grâce à la collecte, la transformation, la corrélation, l'analyse et la visualisation de ces signaux de télémétrie. Elastic Observability rassemble toutes ces fonctionnalités au sein d'une seule et même plateforme. L'observabilité continue d'évoluer au rythme des nouvelles tendances et technologies.
Qu'est-ce que l'observabilité agentique ?
L’observabilité agentique est une approche dans laquelle des agents IA enquêtent activement sur les incidents et les résolvent au lieu d’attendre que les ingénieurs interprètent les tableaux de bord et les alertes. Les agents IA effectuent une analyse des causes racines en raisonnant à partir des données de télémétrie afin d’identifier la cause sous-jacente d’un incident. Ils corrèlent les signaux issus des logs, des métriques, des traces et d’autres données de télémétrie pour brosser un tableau complet de la situation. Grâce à l’ automatisation des workflows, les agents peuvent recommander ou automatiser des mesures de remédiation en fonction de leurs conclusions. La prise en charge des serveurs MCP étend ces fonctionnalités au-delà de la plateforme d’observabilité, en donnant aux agents accès à des outils et à des systèmes externes pendant leurs investigations.
Elastic nightshift AI SRE l’outil apprend à enquêter comme le ferait votre meilleur ingénieur, en testant plusieurs hypothèses en parallèle et en proposant des correctifs s'appuyant sur des preuves, le tout avec un raisonnement transparent.
Quels sont les avantages de l'AIOps et de l'observabilité agentique ?
En mettant en œuvre l’AIOps et l'observabilité agentique, les équipes SRE peuvent détecter et résoudre les problèmes plus rapidement et de manière proactive grâce à une analyse contextuelle des causes premières et à une corrélation entre les signaux. Les entreprises peuvent ainsi respecter leurs SLA tout en améliorant les délais de mise sur le marché, l’efficacité opérationnelle et la satisfaction client. PepsiCo a amélioré son efficacité et réduit son MTTR de 30 % grâce à Elastic Observability, résolvant ainsi les problèmes en quelques minutes plutôt qu’en plusieurs jours.
Pourquoi les entreprises passent-elles de Datadog à Elastic Observability ?
La raison la plus fréquente pour laquelle les entreprises passent de Datadog à Elastic Observability est le coût. La tarification par hôte et par métrique de Datadog augmente rapidement à mesure que l’infrastructure grandit, et de nombreuses équipes se retrouvent contraintes à faire des arbitrages difficiles quant aux données à conserver ou à supprimer. Elasticsearch stocke les logs, les métriques et les traces avec une efficacité de stockage inégalée afin que la rétention haute fidélité ne soit plus un arbitrage budgétaire — haute cardinalité incluse. Rien que pour les métriques, Elastic permet de réaliser jusqu’à 4 fois plus d’économies par rapport à Datadog, offrant ainsi aux équipes un meilleur contrôle sur ce qu’elles stockent, la durée de conservation et ce qu’elles paient.
Elastic Observability prend-il en charge OpenTelemetry et Prometheus de manière native ?
Oui. Elastic Observability donne la priorité à OpenTelemetry, avec une prise en charge native des données et des workflows OpenTelemetry. Elastic Distributions of OpenTelemetry (EDOT) propose des distributions prêtes pour la production afin de collecter et d’envoyer la télémétrie à Elastic. Elastic propose également une supervision Prometheus native, comprenant Prometheus remote write et la prise en charge de PromQL directement dans Kibana. Les équipes peuvent utiliser les standards OpenTelemetry et Prometheus sans agents propriétaires, sans conversion de données, ni pile d’observabilité distincte.