Banco de dados vetorial do Elasticsearch: envie em minutos, redimensione de forma acessível para centenas de bilhões
As partes difíceis da recuperação híbrida já estão prontas. Padrões otimizados, modelos Jina AI nativos e de terceiros e inferência em GPU gerenciada já estão disponíveis para uso imediato. Crie apps de IA rápidos e escaláveis, não infraestrutura.

O que seu banco de dados vetorial deve fazer por você?


Banco de dados vetorial do Elasticsearch: mais do que apenas vetores, adorado por desenvolvedores
Sem lacunas ou concessões. Padrões otimizados. Recuperação híbrida. Tudo funciona junto porque foi criado dessa forma.
Uma chamada e pronto: do zero à busca vetorial em minutos
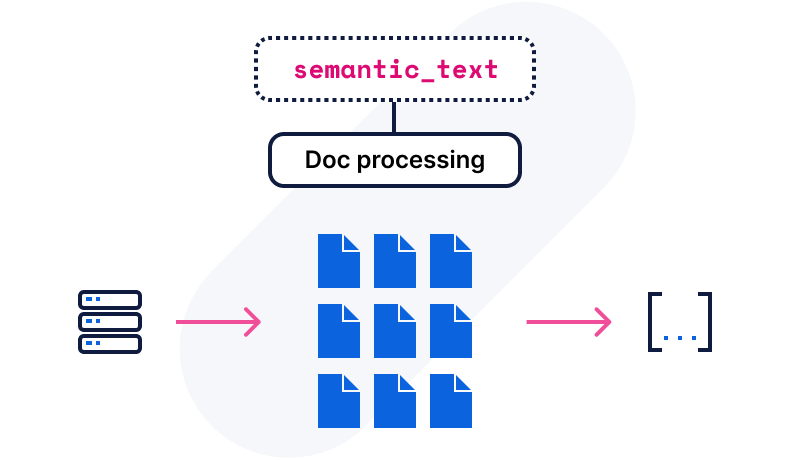
Comece a usar o banco de dados vetorial do Elasticsearch. O caminho mais rápido para a busca vetorial com padrões para cargas de trabalho vetoriais, busca híbrida e a opção de gerar embeddings ou importar os seus.
Traga seu conteúdo e deixe o resto conosco.
from elasticsearch import Elasticsearch

client = Elasticsearch(
   "https://xyz.elastic.cloud:443",
   api_key="..",

)

client.indices.create(
   index="my_semantic_vectors",
   mappings={
       "properties": {
           "content": {"type": "text", "copy_to": "semantic_content"},
           "semantic_content": {"type": "semantic_text"},
       }
   },
)

client.bulk(
   operations=[
       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Yellowstone National Park spans Wyoming, Montana, and Idaho, covering over 2.2 million acres. It is famous for the geyser Old Faithful and sits atop the Yellowstone Caldera, a supervolcano."},

       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Yosemite National Park covers over 750,000 acres in California. A UNESCO World Heritage Site, it is best known for its granite cliffs, waterfalls, and giant sequoia trees."},

       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Rocky Mountain National Park is known for its mountainous terrain, including Longs Peak, the highest in the park. It is a popular destination for hiking, camping, and wildlife viewing."},
   ],
)
from elasticsearch import Elasticsearch

client = Elasticsearch(
   "https://xyz.elastic.cloud:443",
   api_key="..",

)

client.indices.create(
   index="my_semantic_vectors",
   mappings={
       "properties": {
           "content": {"type": "text", "copy_to": "semantic_content"},
           "semantic_content": {"type": "semantic_text"},
       }
   },
)

client.bulk(
   operations=[
       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Yellowstone National Park spans Wyoming, Montana, and Idaho, covering over 2.2 million acres. It is famous for the geyser Old Faithful and sits atop the Yellowstone Caldera, a supervolcano."},

       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Yosemite National Park covers over 750,000 acres in California. A UNESCO World Heritage Site, it is best known for its granite cliffs, waterfalls, and giant sequoia trees."},

       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Rocky Mountain National Park is known for its mountainous terrain, including Longs Peak, the highest in the park. It is a popular destination for hiking, camping, and wildlife viewing."},
   ],
)
Crie com o banco de dados vetorial do Elasticsearch


Banco de dados vetorial e o restante do que você realmente precisa
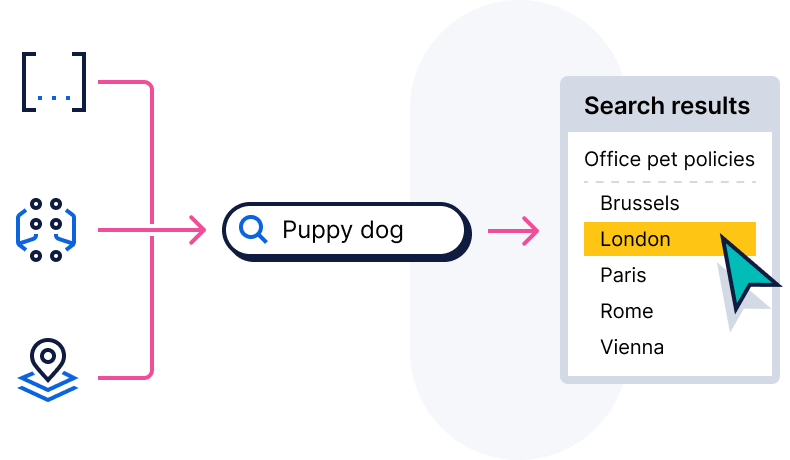
A busca vetorial no mundo real precisa de mais do que vetores. Combine busca semântica com filtros, segurança, campos estruturados e classificação BM25 em uma única consulta, sem necessidade de unificação.

Um bairro de alta qualidade
Do prompt ao produto, como as equipes estão criando com o banco de dados vetorial do Elasticsearch.
Cliente em destaque
A FRAIM usa o Elasticsearch para criar uma plataforma de busca de conhecimento para a era da IA, consolidando de forma nativa a busca textual e vetorial para reduzir os custos gerais da plataforma de busca em mais de 50% e acelerar significativamente o desenvolvimento de agentes de IA e RAG.
Cliente em destaque
A WP Engine usa o Elasticsearch para trazer inovação em IA para websites WordPress, aproveitando integrações nativas com o Google Cloud para reduzir o desenvolvimento de recursos de IA de semanas para horas e oferecer tempos de resposta de busca de 5 ms sem tempo de inatividade.
Cliente em destaque

A Adobe redimensiona, gerencia vários casos de uso e coloca os recursos de machine learning para trabalhar com a Elastic.
Resultados, em números
Benchmarks de desempenho e resultados do banco de dados vetorial do Elasticsearch.


Primeiros passos: recursos para cada etapa da criação
Ingestão, análise e índice
Incorporar
Recuperação
Ferramentas de desenvolvimento
Incorporar
Recuperação
Ferramentas de desenvolvimento
Perguntas frequentes
O que é um banco de dados vetorial e como ele funciona?
O que é um banco de dados vetorial e como ele funciona?
Um banco de dados vetorial armazena informações como vetores, que são representações numéricas de objetos de dados, também conhecidos como embeddings vetoriais. Ele utiliza embeddings vetoriais para busca multimodal em um enorme conjunto de dados estruturados, não estruturados e semiestruturados, como imagens, texto, vídeos e áudio. Como os bancos de dados vetoriais são criados para gerenciar embeddings vetoriais, eles oferecem uma solução completa para o gerenciamento de dados.
O que são embeddings vetoriais?
O que são embeddings vetoriais?
Embeddings vetoriais usam um modelo de machine learning para traduzir texto em números, permitindo que você realize buscas vetoriais. Ao converter dados em vetores, os embeddings facilitam a comparação, a busca e a análise de semelhanças entre itens nesse espaço.
Quais são os benefícios de um banco de dados vetorial?
Quais são os benefícios de um banco de dados vetorial?
Um banco de dados vetorial oferece eficiência em escala ao permitir a migração contínua de dados entre ambientes locais, isolados e de nuvem soberana e fornecer armazenamento para embeddings vetoriais.
Bancos de dados vetoriais são excelentes na busca por similaridade, permitindo que você encontre itens relacionados facilmente, o que é essencial para sistemas de recomendação, busca de imagens e descoberta de conteúdo. Com recursos de busca semântica, eles vão além da simples correspondência de palavras-chave para fornecer resultados com base no significado e no contexto. Ao armazenar embeddings vetoriais, eles aceitam aplicações de IA e machine learning, facilitando a implantação de modelos de processamento de linguagem natural (PLN) e de recomendação.
O Elasticsearch é um banco de dados vetorial?
O Elasticsearch é um banco de dados vetorial?
Sim, o Elasticsearch é o banco de dados vetorial open source mais amplamente implantado no mundo, oferecendo uma maneira eficiente de criar, armazenar e buscar incorporações de vetores em escala. Com o banco de dados vetorial empresarial da Elastic, você obtém tempos de consulta rápidos e desempenho ideal, mesmo com dados que mudam rapidamente. Construído para redimensionar, ele fornece resultados de busca relevantes e personalizados, ao mesmo tempo em que simplifica os processos de desenvolvimento.
Por que escolher o Elastic como seu banco de dados vetorial?
Por que escolher o Elastic como seu banco de dados vetorial?
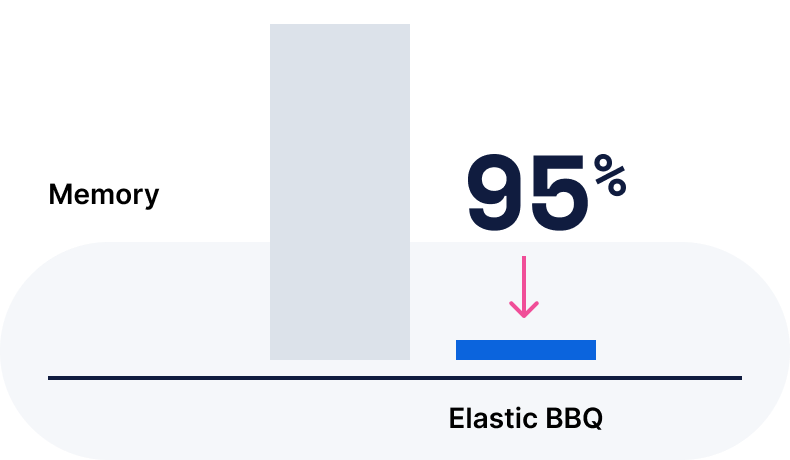
Elasticsearch é o banco de dados vetorial mais baixado do mundo, criado especificamente para ajudar desenvolvedores a oferecer buscas de alta precisão e experiências de IA escaláveis com mais rapidez e custos menores. O Elasticsearch Vector Database cuida das partes difíceis da recuperação híbrida com padrões otimizados, modelos Jina AI nativos e de terceiros e inferência em GPU gerenciada, tudo pronto para uso. Execute buscas vetoriais e por palavra-chave em texto, imagem e dados multimodais em um único índice, sem precisar criar ou manter um pipeline de embedding. Ele já vem pré-ajustado para cargas de trabalho vetoriais, proporcionando alto desempenho, absorvendo picos de tráfego automaticamente e reduzindo a escala quando a demanda diminui. Obtenha os caminhos de segurança, RBAC e recuperação que você espera, para poder criar apps, não infraestrutura.
Posso executar o Elasticsearch como um banco de dados vetorial local ou air-gapped?
Posso executar o Elasticsearch como um banco de dados vetorial local ou air-gapped?
Sim. O Elasticsearch pode ser totalmente implementado localmente — em servidores físicos, em nuvem privada ou em redes completamente air-gapped, sem conectividade externa. Agências governamentais, empresas contratadas pela área de defesa e empresas regulamentadas utilizam o Elastic Cloud Enterprise (ECE) para orquestrar clusters Elasticsearch locais em grande escala, inclusive em ambientes confidenciais e desconectados. Todos os recursos de busca vetorial, busca híbrida e RAG disponíveis no Elastic Cloud também estão disponíveis em implementações locais.