Elasticsearch Vector Database:数分でシッピング、数百億規模へ手頃なコストでスケール
ハイブリッド検索の難しい部分はすでに完了しています。最適化されたデフォルト設定、サードパーティおよびネイティブのJina AIモデル、マネージドGPU推論をすべてすぐに利用できます。インフラの構築ではなく、高速でスケーラブルなAIアプリの構築に専念しましょう。

ベクトルデータベースはどのように活用できるでしょうか。


Elasticsearch Vector Database:開発者が愛する、ベクトルを超えた検索
ギャップや妥協は一切ありません。最適化されたデフォルト。ハイブリッド検索。すべてが連携して機能するように構築されています。
1回の呼び出しですべて完了:数分でゼロからベクトル検索へ
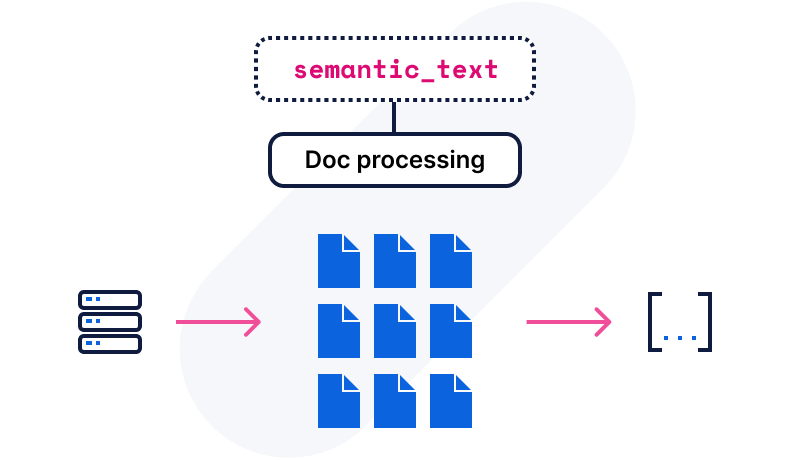
Elasticsearch Vector Databaseの利用を始めましょう。ベクトルワークロード向けのデフォルト設定、ハイブリッド検索、埋め込みの生成または独自の埋め込みの持ち込み(BYO)を選択できる柔軟性を備え、ベクトル検索を最速で導入できます。
コンテンツさえご用意いただければ、あとは当社にお任せください。
from elasticsearch import Elasticsearch

client = Elasticsearch(
   "https://xyz.elastic.cloud:443",
   api_key="..",

)

client.indices.create(
   index="my_semantic_vectors",
   mappings={
       "properties": {
           "content": {"type": "text", "copy_to": "semantic_content"},
           "semantic_content": {"type": "semantic_text"},
       }
   },
)

client.bulk(
   operations=[
       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Yellowstone National Park spans Wyoming, Montana, and Idaho, covering over 2.2 million acres. It is famous for the geyser Old Faithful and sits atop the Yellowstone Caldera, a supervolcano."},

       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Yosemite National Park covers over 750,000 acres in California. A UNESCO World Heritage Site, it is best known for its granite cliffs, waterfalls, and giant sequoia trees."},

       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Rocky Mountain National Park is known for its mountainous terrain, including Longs Peak, the highest in the park. It is a popular destination for hiking, camping, and wildlife viewing."},
   ],
)
from elasticsearch import Elasticsearch

client = Elasticsearch(
   "https://xyz.elastic.cloud:443",
   api_key="..",

)

client.indices.create(
   index="my_semantic_vectors",
   mappings={
       "properties": {
           "content": {"type": "text", "copy_to": "semantic_content"},
           "semantic_content": {"type": "semantic_text"},
       }
   },
)

client.bulk(
   operations=[
       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Yellowstone National Park spans Wyoming, Montana, and Idaho, covering over 2.2 million acres. It is famous for the geyser Old Faithful and sits atop the Yellowstone Caldera, a supervolcano."},

       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Yosemite National Park covers over 750,000 acres in California. A UNESCO World Heritage Site, it is best known for its granite cliffs, waterfalls, and giant sequoia trees."},

       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Rocky Mountain National Park is known for its mountainous terrain, including Longs Peak, the highest in the park. It is a popular destination for hiking, camping, and wildlife viewing."},
   ],
)
Elasticsearchベクトルデータベースで構築


ベクトルDB、そして実際に必要なその他の要素
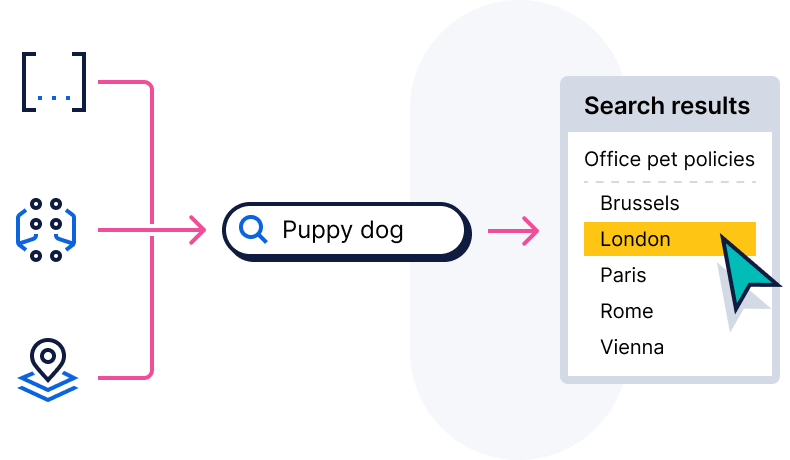
現実世界のベクトル検索には、ベクトル以上のものが必要です。セマンティック検索をフィルタ、セキュリティ、構造化フィールド、BM25ランキングと単一のクエリで組み合わせることができ、つなぎ合わせる必要はありません。

高品質な近傍法
プロンプトからプロダクトまで、チームがElasticsearch Vector Databaseを活用して構築する方法。
お客様事例
FRAIMはElasticsearchを使ってAI時代のナレッジ検索プラットフォームを構築し、テキスト検索とベクトル検索をネイティブに統合することで、検索プラットフォーム全体のコストを50%以上削減し、RAGやAIエージェントの開発を大幅に加速させています。
お客様事例
WP EngineはElasticsearchを使用してWordPressウェブサイトにAIイノベーションをもたらし、ネイティブなGoogle Cloud統合を活用することで、AI機能の開発時間を数週間から数時間に短縮し、ダウンタイムなしで5ミリ秒の検索応答時間を実現しています。
お客様事例

AdobeはElasticを利用して、スケールアップ、複数のユースケースの管理、機械学習機能の活用を実現しています。
数字で見る結果
Elasticsearchベクトルデータベースのパフォーマンスベンチマークと結果。


はじめに:構築のあらゆるステージに対応するリソース
取り込み、解析、インデックス作成
埋め込み
取得
開発ツール
埋め込み
取得
開発ツール
よくあるご質問
ベクトル検索どのようなもので、どのように機能するのですか?
ベクトル検索どのようなもので、どのように機能するのですか?
ベクトルデータベースは、情報をデータオブジェクトの数値表現(ベクトル埋め込みとしても知られている)であるベクトルとして保存します。画像、テキスト、動画、オーディオなどの構造化データ、非構造化データ、半構造化データの膨大なデータセットにわたるマルチモーダル検索のために、ベクトル埋め込みを使用しています。ベクトルデータベースは、ベクトル埋め込みを管理するために構築されているため、データ管理のための総合的なソリューションを提供します。
ベクトル埋め込みとは何ですか?
ベクトル埋め込みとは何ですか?
ベクトル埋め込みは、機械学習モデルを使用してテキストを数字に変換し、ベクトル検索を実行します。データをベクトルに変換することで、埋め込みによりこの空間内にあるアイテム間の類似点の比較、検索、分析が容易になります。
ベクトル検索の利点は何ですか?
ベクトル検索の利点は何ですか?
ベクトルデータベースは、オンプレミス、エアギャップ、ソブリンクラウド環境間でのシームレスなデータ移行を可能にし、ベクトル埋め込み用のストレージを提供することで、大規模な効率化を実現します。
ベクトルデータベースは類似性検索に優れており、関連する項目を簡単に検索できます。これは、レコメンデーションシステム、画像検索、コンテンツディスカバリーにおいて不可欠です。セマンティック検索機能では、単なるキーワードマッチングを超えて、意味と文脈に基づいた結果を提供します。ベクトル埋め込みを格納することで、AIや機械学習アプリケーションをサポートし、自然言語処理(NLP)やレコメンデーションモデルを簡単に展開できます。
Elasticsearchはベクトル検索ですか?
Elasticsearchはベクトル検索ですか?
はい、Elasticsearchは世界で最も広く導入されているオープンソースのベクトルデータベースであり、ベクトル埋め込みを大規模かつ効率的に作成、格納、検索できます。Elasticによるエンタープライズ向けベクトル検索を使用すると、急速に変化するデータでも、クエリ時間を短縮し、最適なパフォーマンスを実現できます。スケーリングに対応するよう構築されており、開発プロセスを簡素化しながら、関連性の高いパーソナライズされた検索結果を提供します。
ベクトル検索としてElasticを選ぶ理由は?
ベクトル検索としてElasticを選ぶ理由は?
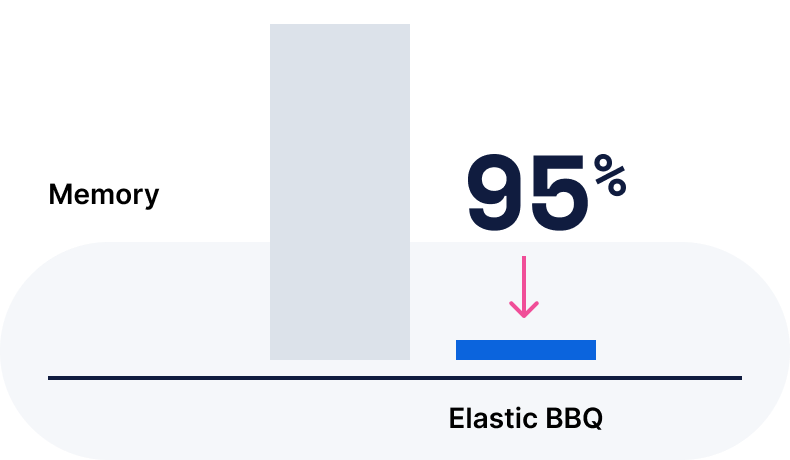
Elasticsearchは世界で最もダウンロードされているベクトルデータベースであり、開発者が高精度の検索とスケーラブルなAI体験をより迅速かつ低コストで提供できるように設計されています。Elasticsearch Vector Databaseは、最適化されたデフォルト設定、ネイティブのJina AIモデルやサードパーティモデル、マネージドGPU推論により、ハイブリッド検索の難しい部分を標準機能ですべて処理します。埋め込みパイプラインを構築・保守することなく、単一のインデックス上でテキスト、画像、マルチモーダルデータにわたるベクトル検索とキーワード検索を実行できます。ベクトルワークロード向けにあらかじめ調整された状態で提供され、高いパフォーマンスを発揮しながらトラフィックスパイクを自動的に吸収し、需要が低下した際にはスケールダウンします。期待通りのセキュリティ、RBAC、リカバリパスを利用できるため、インフラの構築ではなくアプリの開発に専念できます。
Elasticsearchをオンプレミスまたはエアギャップされたベクトルデータベースとして実行できますか?
Elasticsearchをオンプレミスまたはエアギャップされたベクトルデータベースとして実行できますか?
はい。Elasticsearchは、ベアメタル、プライベートクラウド、または外部接続のない完全にエアギャップされたネットワーク上での、完全なオンプレミス展開が可能です。政府機関、防衛請負業者、規制対象企業は、Elastic Cloud Enterprise(ECE)を使用して、機密環境や切断された環境を含む大規模なスケールでオンプレミスのElasticsearchクラスターを管理しています。Elastic Cloudで利用可能なすべてのベクトル検索、ハイブリッド検索、RAG機能はオンプレミス導入でも同様に利用可能です。