
벡터 데이터베이스가 수행해야 하는 기능은 무엇일까요?


Elasticsearch 벡터 데이터베이스: 단순한 벡터 그 이상, 개발자에게 사랑받는 솔루션
어떠한 허점이나 타협도 없습니다. 최적화된 기본 설정. 하이브리드 검색. 모든 것이 완벽하게 조화를 이루도록 설계되었습니다.
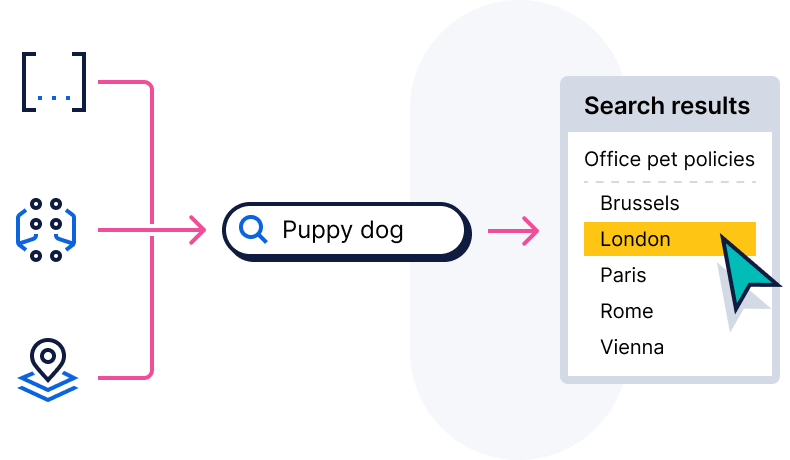
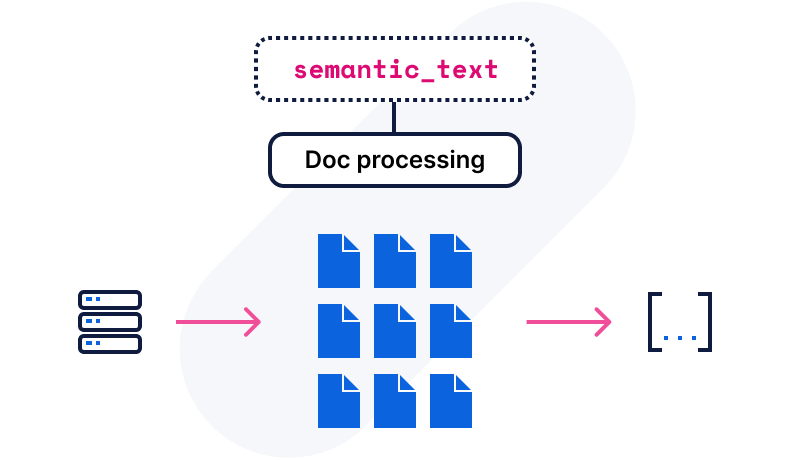
단 한 번의 호출로 충분합니다. 몇 분 만에 시작하는 벡터 검색
Elasticsearch 벡터 데이터베이스를 시작해 보세요. 벡터 워크로드, 하이브리드 검색, 그리고 임베딩 생성 또는 자체 임베딩 가져오기 선택에 대한 기본 설정을 제공하여 벡터 검색을 가장 빠르게 시작할 수 있습니다.
콘텐츠만 가져오세요. 나머지는 저희가 처리해 드리겠습니다.
from elasticsearch import Elasticsearch

client = Elasticsearch(
   "https://xyz.elastic.cloud:443",
   api_key="..",

)

client.indices.create(
   index="my_semantic_vectors",
   mappings={
       "properties": {
           "content": {"type": "text", "copy_to": "semantic_content"},
           "semantic_content": {"type": "semantic_text"},
       }
   },
)

client.bulk(
   operations=[
       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Yellowstone National Park spans Wyoming, Montana, and Idaho, covering over 2.2 million acres. It is famous for the geyser Old Faithful and sits atop the Yellowstone Caldera, a supervolcano."},

       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Yosemite National Park covers over 750,000 acres in California. A UNESCO World Heritage Site, it is best known for its granite cliffs, waterfalls, and giant sequoia trees."},

       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Rocky Mountain National Park is known for its mountainous terrain, including Longs Peak, the highest in the park. It is a popular destination for hiking, camping, and wildlife viewing."},
   ],
)
from elasticsearch import Elasticsearch

client = Elasticsearch(
   "https://xyz.elastic.cloud:443",
   api_key="..",

)

client.indices.create(
   index="my_semantic_vectors",
   mappings={
       "properties": {
           "content": {"type": "text", "copy_to": "semantic_content"},
           "semantic_content": {"type": "semantic_text"},
       }
   },
)

client.bulk(
   operations=[
       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Yellowstone National Park spans Wyoming, Montana, and Idaho, covering over 2.2 million acres. It is famous for the geyser Old Faithful and sits atop the Yellowstone Caldera, a supervolcano."},

       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Yosemite National Park covers over 750,000 acres in California. A UNESCO World Heritage Site, it is best known for its granite cliffs, waterfalls, and giant sequoia trees."},

       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Rocky Mountain National Park is known for its mountainous terrain, including Longs Peak, the highest in the park. It is a popular destination for hiking, camping, and wildlife viewing."},
   ],
)
Elasticsearch 벡터 데이터베이스로 구축


벡터 DB, 그리고 그 외에 실제로 필요한 모든 요소
실제 환경에서의 벡터 검색에는 벡터 이상의 요소가 필요합니다. 별도의 복잡한 통합 과정 없이, 단일 쿼리 내에서 시맨틱 검색을 필터링, 보안, 구조화된 필드, BM25 랭킹과 결합해 보세요.

고품질 유사 항목군
프롬프트에서 제품까지, 팀이 Elasticsearch 벡터 데이터베이스로 구축하는 방식
고객 스포트라이트
FRAIM은 Elasticsearch를 사용하여 AI 시대를 위한 지식 검색 플랫폼을 구축하고, 텍스트 및 벡터 검색을 기본적으로 통합하여 전체 검색 플랫폼 비용을 50% 이상 절감하며, RAG 및 AI 에이전트 개발을 획기적으로 가속화합니다.
고객 스포트라이트
WP Engine은 Elasticsearch를 사용하여 WordPress 웹사이트에 AI 혁신을 제공함으로써 네이티브 Google Cloud 통합을 활용하여 AI 기능 개발 시간을 몇 주에서 몇 시간으로 단축하고 가동 중단 시간 없이 5ms의 검색 응답 시간을 제공합니다.
고객 스포트라이트

Adobe는 Elastic을 통해 여러 사용 사례를 확장하고 관리하며 머신 러닝 기능을 활용합니다.
숫자로 보는 결과
Elasticsearch 벡터 데이터베이스 성능 벤치마크 및 결과


시작하기: 구축의 모든 단계를 위한 리소스
수집, 구문 분석, 색인
임베드
검색
개발 도구
임베드
검색
개발 도구
자주 묻는 질문
벡터 데이터베이스란 무엇이며 어떻게 작동합니까?
벡터 데이터베이스란 무엇이며 어떻게 작동합니까?
벡터 데이터베이스는 정보를 벡터, 즉 벡터 임베딩이라고도 하는 데이터 객체의 수치적 표현으로 저장합니다. 이미지, 텍스트, 비디오, 오디오 등 정형, 비정형, 반정형 데이터로 이루어진 방대한 데이터 세트 전반에서 멀티모달 검색을 위해 벡터 임베딩을 사용합니다. 벡터 데이터베이스는 벡터 임베딩을 관리하도록 구축되었기 때문에 완벽한 데이터 관리 솔루션을 제공합니다.
벡터 임베딩이란 무엇인가요?
벡터 임베딩이란 무엇인가요?
벡터 임베딩은 머신 러닝 모델을 사용하여 텍스트를 숫자로 변환하여 벡터 검색을 수행할 수 있게 합니다. 임베딩은 데이터를 벡터로 변환하여 이 공간에서 항목 간의 유사성을 쉽게 비교, 검색 및 분석할 수 있게 해줍니다.
벡터 데이터베이스의 이점은 무엇입니까?
벡터 데이터베이스의 이점은 무엇입니까?
벡터 데이터베이스는 온프레미스, 에어갭, 독립형 클라우드 환경 간의 원활한 데이터 마이그레이션을 지원하고 벡터 임베딩을 위한 저장 공간을 제공함으로써 상당한 효율성을 제공합니다.
벡터 데이터베이스는 유사성 검색에 탁월하여 관련 항목을 쉽게 찾을 수 있도록 해주며, 이는 추천 시스템, 이미지 검색 및 콘텐츠 검색에 필수적입니다. 시맨틱 검색 기능을 통해 단순한 키워드 매칭을 넘어 의미와 컨텍스트에 기반한 결과를 제공합니다. 벡터 임베딩을 저장함으로써 AI 및 머신 러닝 애플리케이션을 지원하여 자연어 처리(NLP) 및 추천 모델을 더욱 쉽게 배포할 수 있습니다.
Elasticsearch는 벡터 데이터베이스인가요?
Elasticsearch는 벡터 데이터베이스인가요?
예, Elasticsearch는 세계에서 가장 널리 배포된 오픈 소스 벡터 데이터베이스로, 벡터 임베딩을 규모에 맞게 생성, 저장 및 검색하는 효율적인 방법을 제공합니다. Elastic의 엔터프라이즈급 벡터 데이터베이스를 사용하면 빠르게 변화하는 데이터 환경에서도 빠른 쿼리 시간과 최적의 성능을 달성할 수 있습니다. 확장 가능하도록 설계되어 개발 프로세스를 간소화하면서 관련성 높고 개인화된 검색 결과를 제공합니다.
왜 벡터 데이터베이스로 Elastic을 선택해야 하나요?
왜 벡터 데이터베이스로 Elastic을 선택해야 하나요?
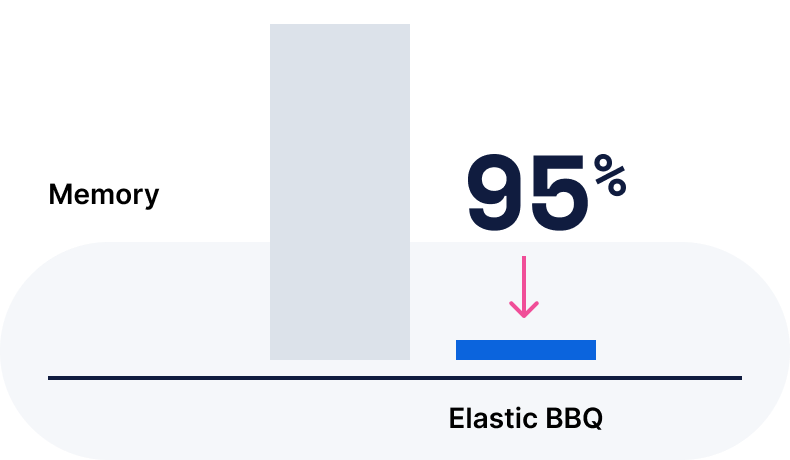
Elasticsearch는 전 세계에서 가장 많이 다운로드된 벡터 데이터베이스로, 개발자가 고정밀 검색과 확장 가능한 AI 환경을 더 빠르고 저렴하게 제공할 수 있도록 특별히 설계되었습니다. Elasticsearch 벡터 데이터베이스는 최적화된 기본 설정, 네이티브 Jina AI 및 서드파티 모델, 관리형 GPU 추론을 통해 하이브리드 검색의 까다로운 복잡성을 대신 해결합니다. 별도의 임베딩 파이프라인을 구축하거나 유지관리할 필요 없이, 단일 인덱스에서 텍스트, 이미지, 멀티모달 데이터 전반에 걸쳐 벡터 검색과 키워드 검색을 모두 수행할 수 있습니다. 벡터 워크로드에 맞춰 사전에 최적화된 상태로 제공되어 고성능을 보장하고 트래픽 급증 시 자동으로 대응하며 수요가 감소하면 규모를 축소합니다. 필요한 보안, RBAC(역할 기반 접근 제어), 복구 기능을 갖추고 있어 인프라 관리가 아닌 애플리케이션 개발에 집중할 수 있습니다.
Elasticsearch를 온프레미스 또는 에어갭 방식의 벡터 데이터베이스로 실행할 수 있나요?
Elasticsearch를 온프레미스 또는 에어갭 방식의 벡터 데이터베이스로 실행할 수 있나요?
예. Elasticsearch는 베어메탈, 프라이빗 클라우드 또는 외부 연결이 없는 완전한 에어갭 네트워크에서 완전히 온프레미스로 배포할 수 있습니다. 정부 기관, 국방 계약자 및 규제 대상 기업에서는 Elastic Cloud Enterprise(ECE)를 사용하여 기밀 환경 및 연결되지 않은 환경을 포함한 온프레미스 Elasticsearch 클러스터를 대규모로 오케스트레이션합니다. Elastic Cloud에서 사용할 수 있는 모든 벡터 검색, 하이브리드 검색 및 RAG 기능은 온프레미스 배포에서도 동일하게 사용할 수 있습니다.