Jina AI検索モデル
取り込みと検索のための最先端モデル
Jina AIモデルは、インジェストから検索まで意味を保持します。計算コストを大幅に抑えながら最先端の精度を実現し、クラウド、オンプレミス、またはElasticsearch上にネイティブにデプロイできます。
文書から回答まで意味を保持するAIモデル
Jina AIは、正確でコスト効率の高い文書の投入、テキストやメディアを対象とした多言語埋め込み、再ランキングを実現する最先端の小型モデルを開発しています。Elasticsearch上でネイティブに動作し、設定は不要です。
コンパクトな設計、正確な結果
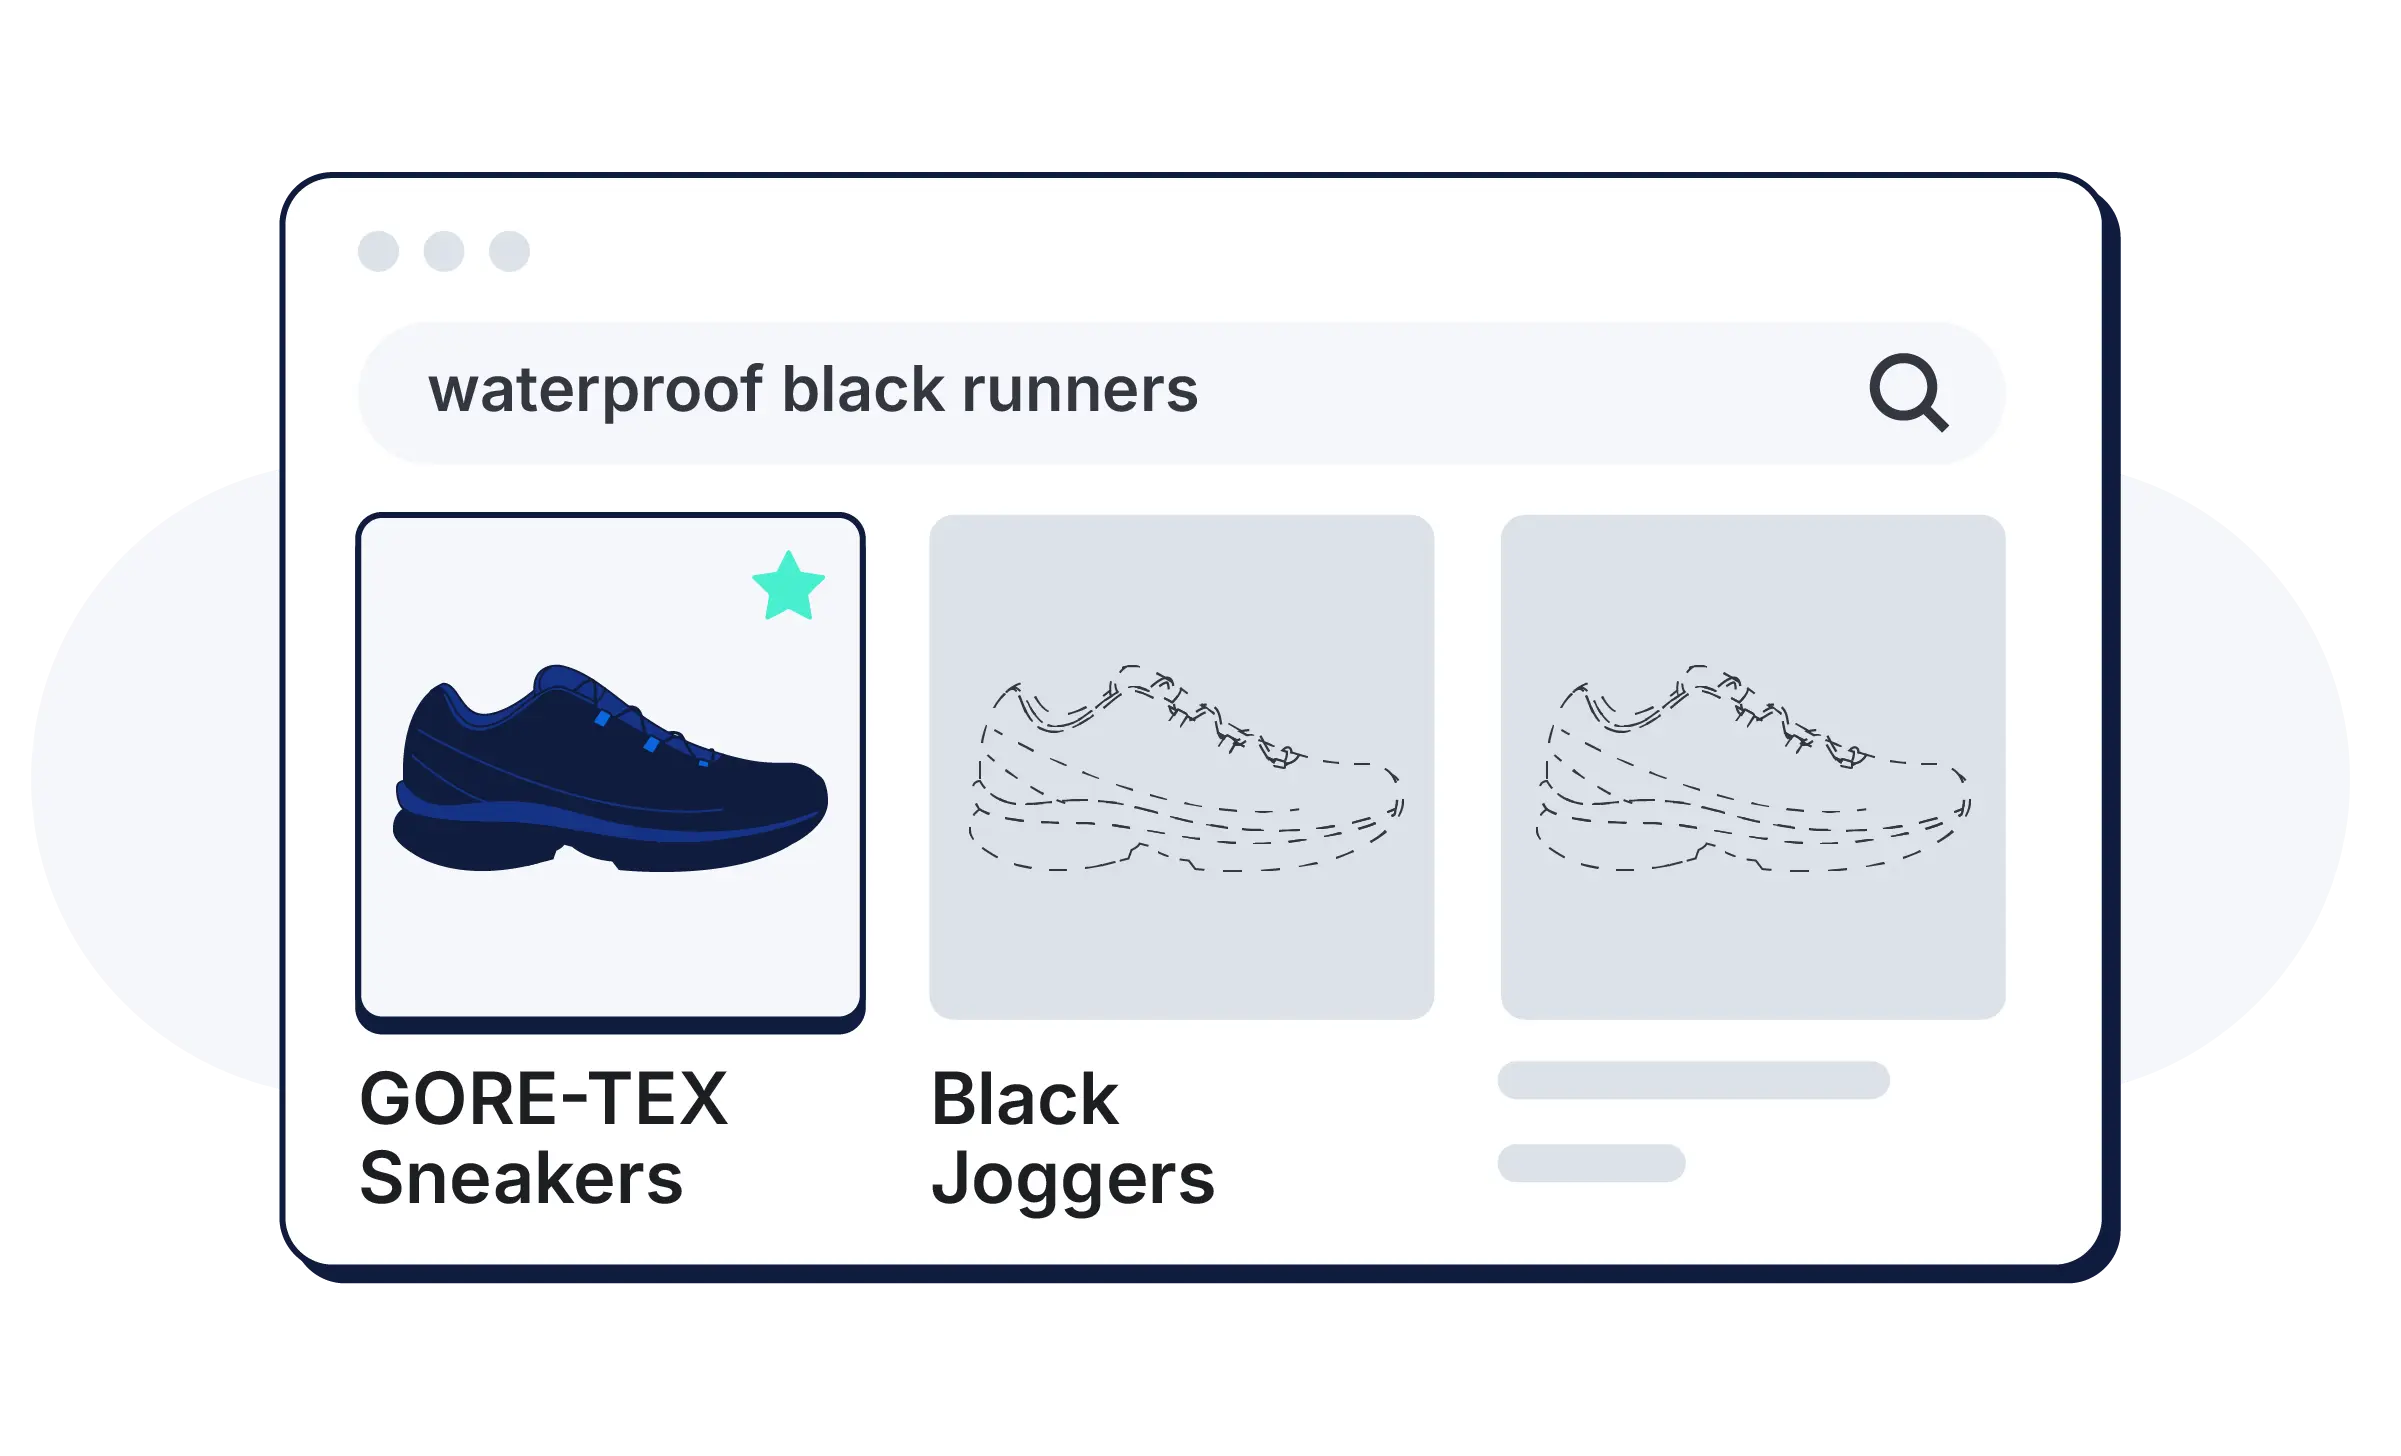
1つのAPIでドキュメントを整然とした構造化データに変換し、高精度な検索結果を実現します。

構築するあらゆる場所でJinaモデルを活用
フルマネージドからセルフホスティングまで、Jinaのモデルはデータの保存場所に合わせて提供されます。最適なアクセスパスをお選びください。
Elasticの調査
オープンソースコミュニティに参加
Jinaのモデルはオープンウェイトで、Hugging Faceで無料で入手でき、毎月数百万回ダウンロードされています。コードベースはGitHubで公開されています。コミュニティは開発者に直接アクセスできます。
よくあるご質問
Jina検索モデルとは何ですか?
Jina検索モデルとは何ですか?
Jinaモデルは、検索用のオープンソースのフロンティアAIモデルです。ベクトル用の埋め込みモデル、精度を高めるためのリランカー、URLやドキュメントからコンテンツを抽出して構造化するためのOCRとリーダーが含まれています。
Jinaモデルを使用するにはAIや機械学習の専門知識が必要ですか?
Jinaモデルを使用するにはAIや機械学習の専門知識が必要ですか?
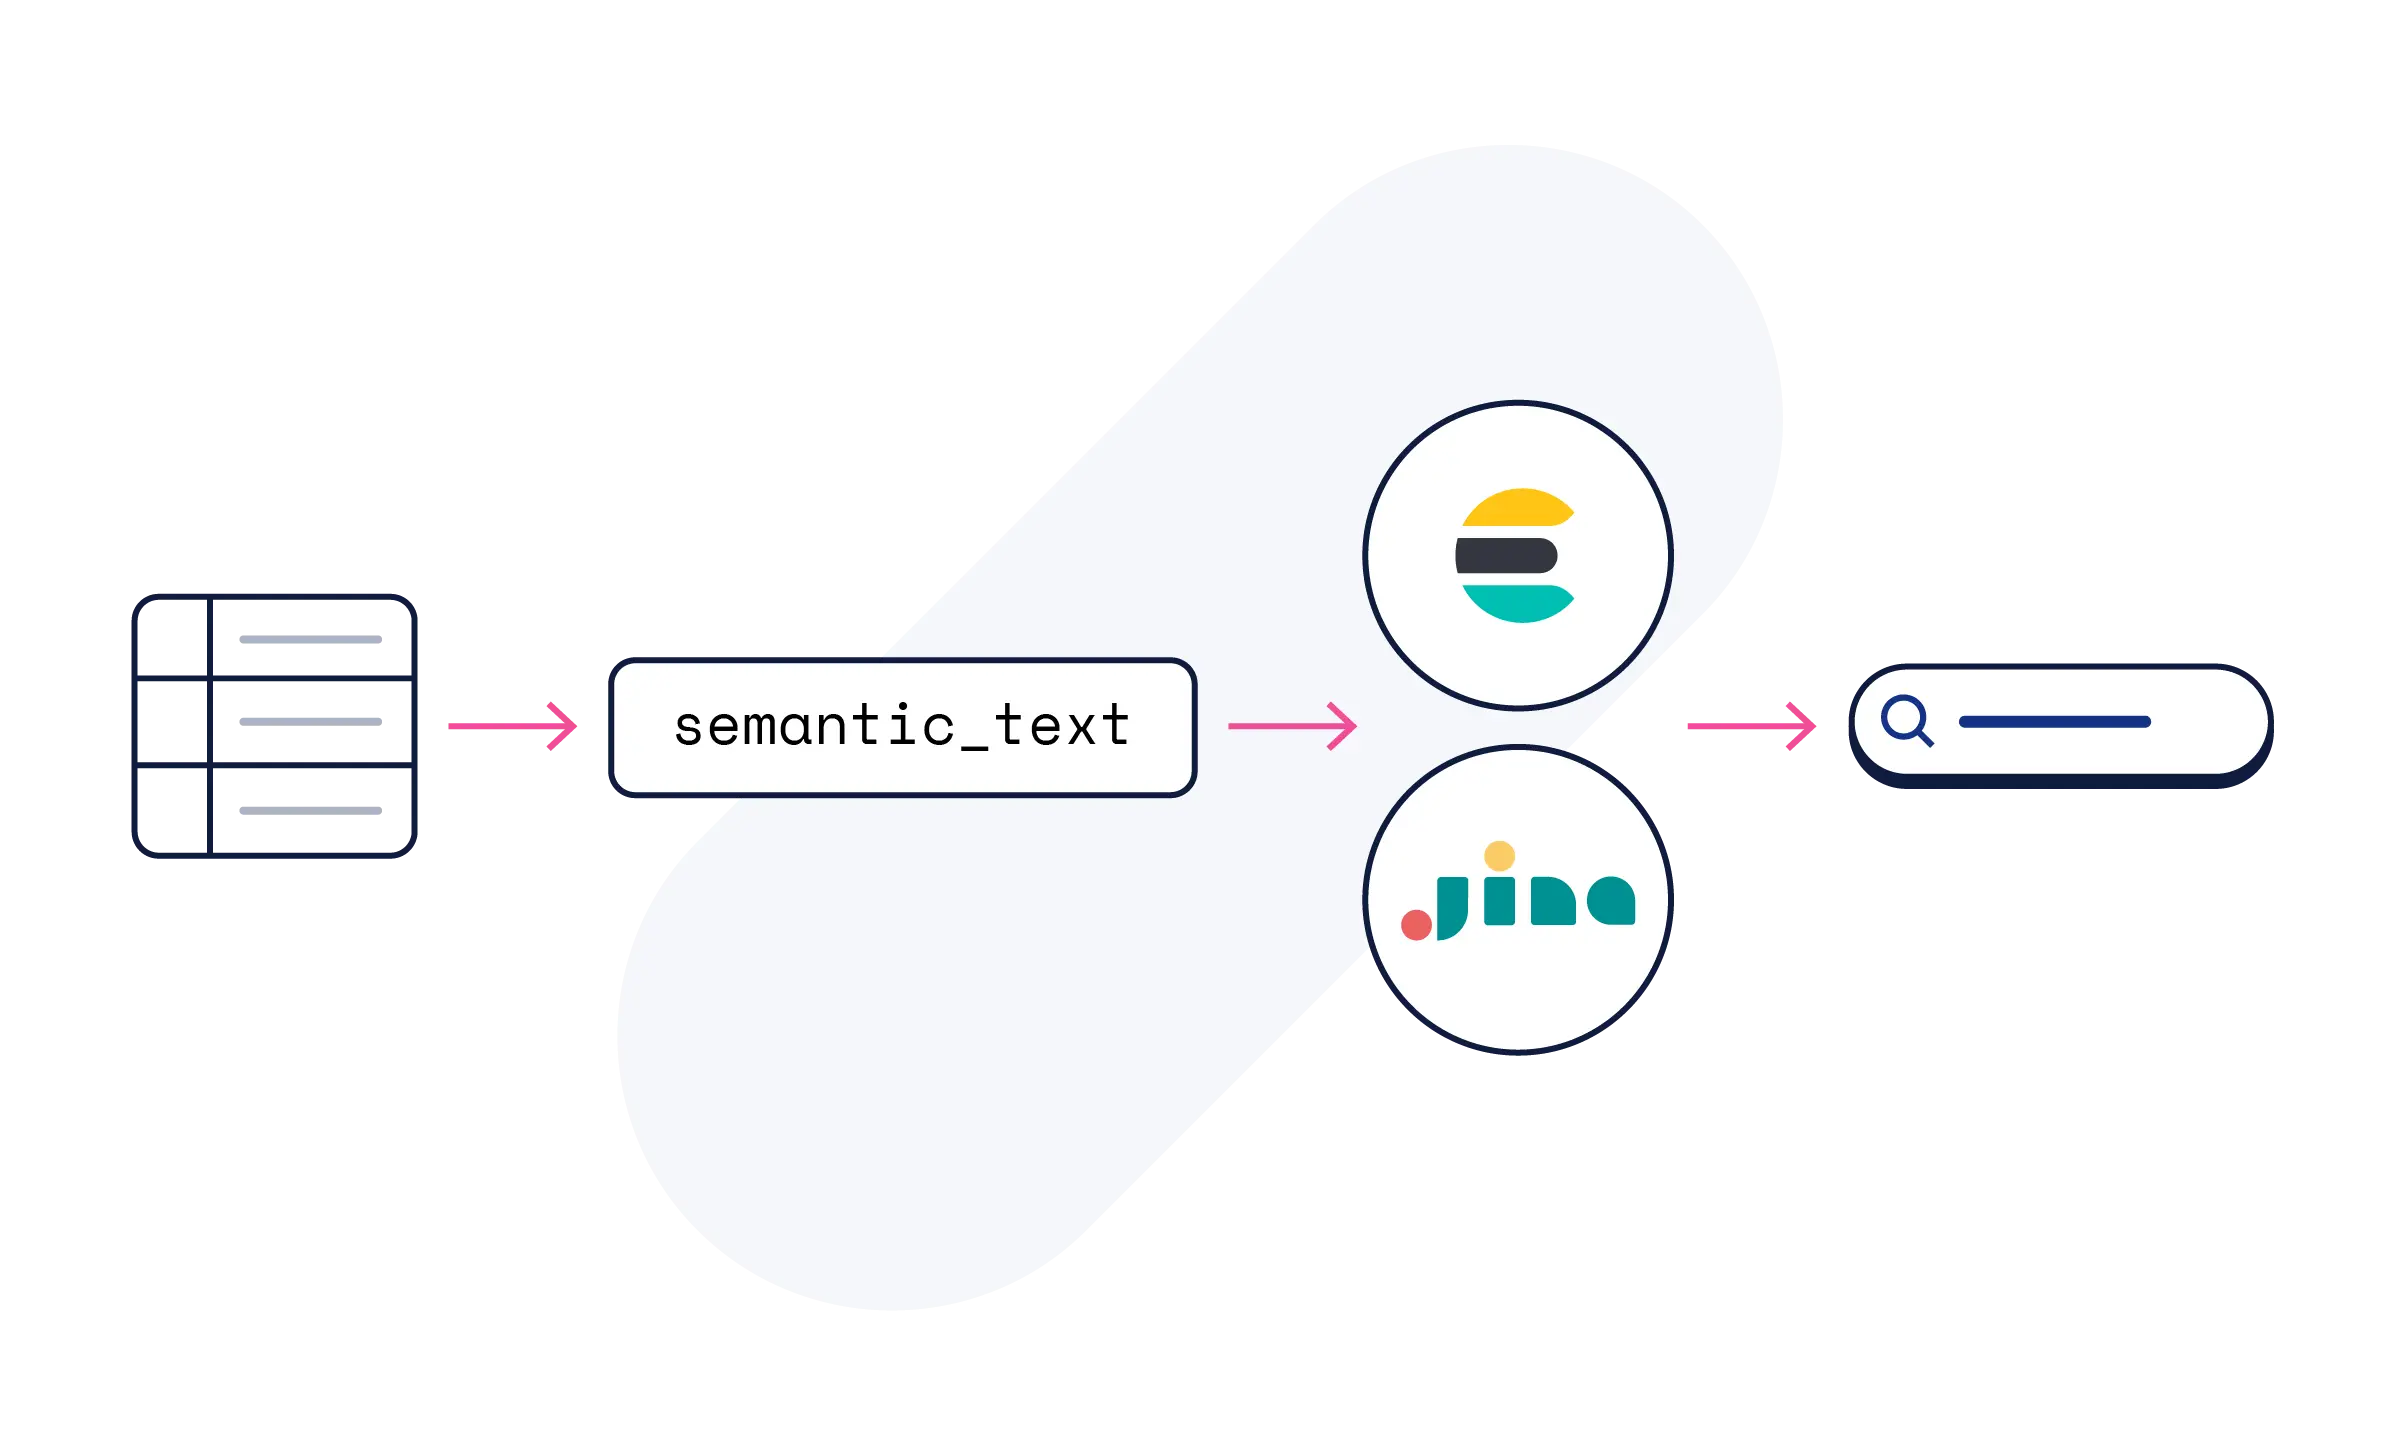
機械学習の専門知識は不要です。JinaモデルはElasticsearchの事前設定済みエンドポイントとして利用可能です。セマンティックフィールドまたはセマンティックテキストフィールドをマッピングするだけで、埋め込みが自動的に行われます。
利用を開始するにはどうすればよいですか?
利用を開始するにはどうすればよいですか?
Jinaのモデルは、すべてのトライアルに含まれるElastic Cloud上のElastic Inference Serviceでご利用いただけます。semanticまたはsemantic_textフィールドを定義することから始めるか、コード例についてはHugging Faceのモデルカードをご覧ください。
現在入手可能なJinaモデルはどれですか?
現在入手可能なJinaモデルはどれですか?
Elastic Inference ServiceでサポートされているJinaモデルについては、「Jinaモデルのドキュメント」で詳しく説明しています。
いくつの言語がサポートされていますか?
いくつの言語がサポートされていますか?
Jina-embeddings-v5-omniとJina-ocr-v1は100以上の言語をサポートしています。ある言語でクエリを実行すると、翻訳パイプラインを必要とせずに、別の言語で書かれた関連コンテンツが見つかります。
ELSERとの関係は?
ELSERとの関係は?
Jinaの埋め込みモデルは、新しいプロジェクトでのデフォルトの選択肢です。ELSERは、使用を選択するお客様へのサポートを引き続き提供します。どちらもElasticsearchのハイブリッド検索フレームワークで利用できます。
これは別の製品ですか?
これは別の製品ですか?
Elastic Inference Service上のJina検索モデルは、従量課金制で、すべてのElastic Cloudユーザーが利用できます。個別のライセンス、サブスクリプション、APIキーは必要ありません。Jinaモデルは、Jina On-Premの一部として個別に購入することもできます。
これはElasticのベクトルデータベースページとどのように関係していますか?
これはElasticのベクトルデータベースページとどのように関係していますか?
ベクトルデータベースのページでは、ベクトルがどのように大規模に格納され、検索されるかを説明します。このページでは、ベクトルを生成してランク付けするAIモデルについて説明します。ストレージ、コンピュート、アプリケーションの3つを合わせてご覧ください。