Jina AI 검색 모델
수집 및 검색을 위한 최첨단 모델
Jina AI 모델은 수집부터 검색까지 의미를 보존합니다. 훨씬 적은 연산 비용으로 최첨단 수준의 정확도를 확보하세요. 자체 클라우드나 온프레미스 환경에 배포하거나 Elasticsearch에서 기본적으로 실행할 수 있습니다.
문서에서 답변까지 의미를 보존하는 AI 모델
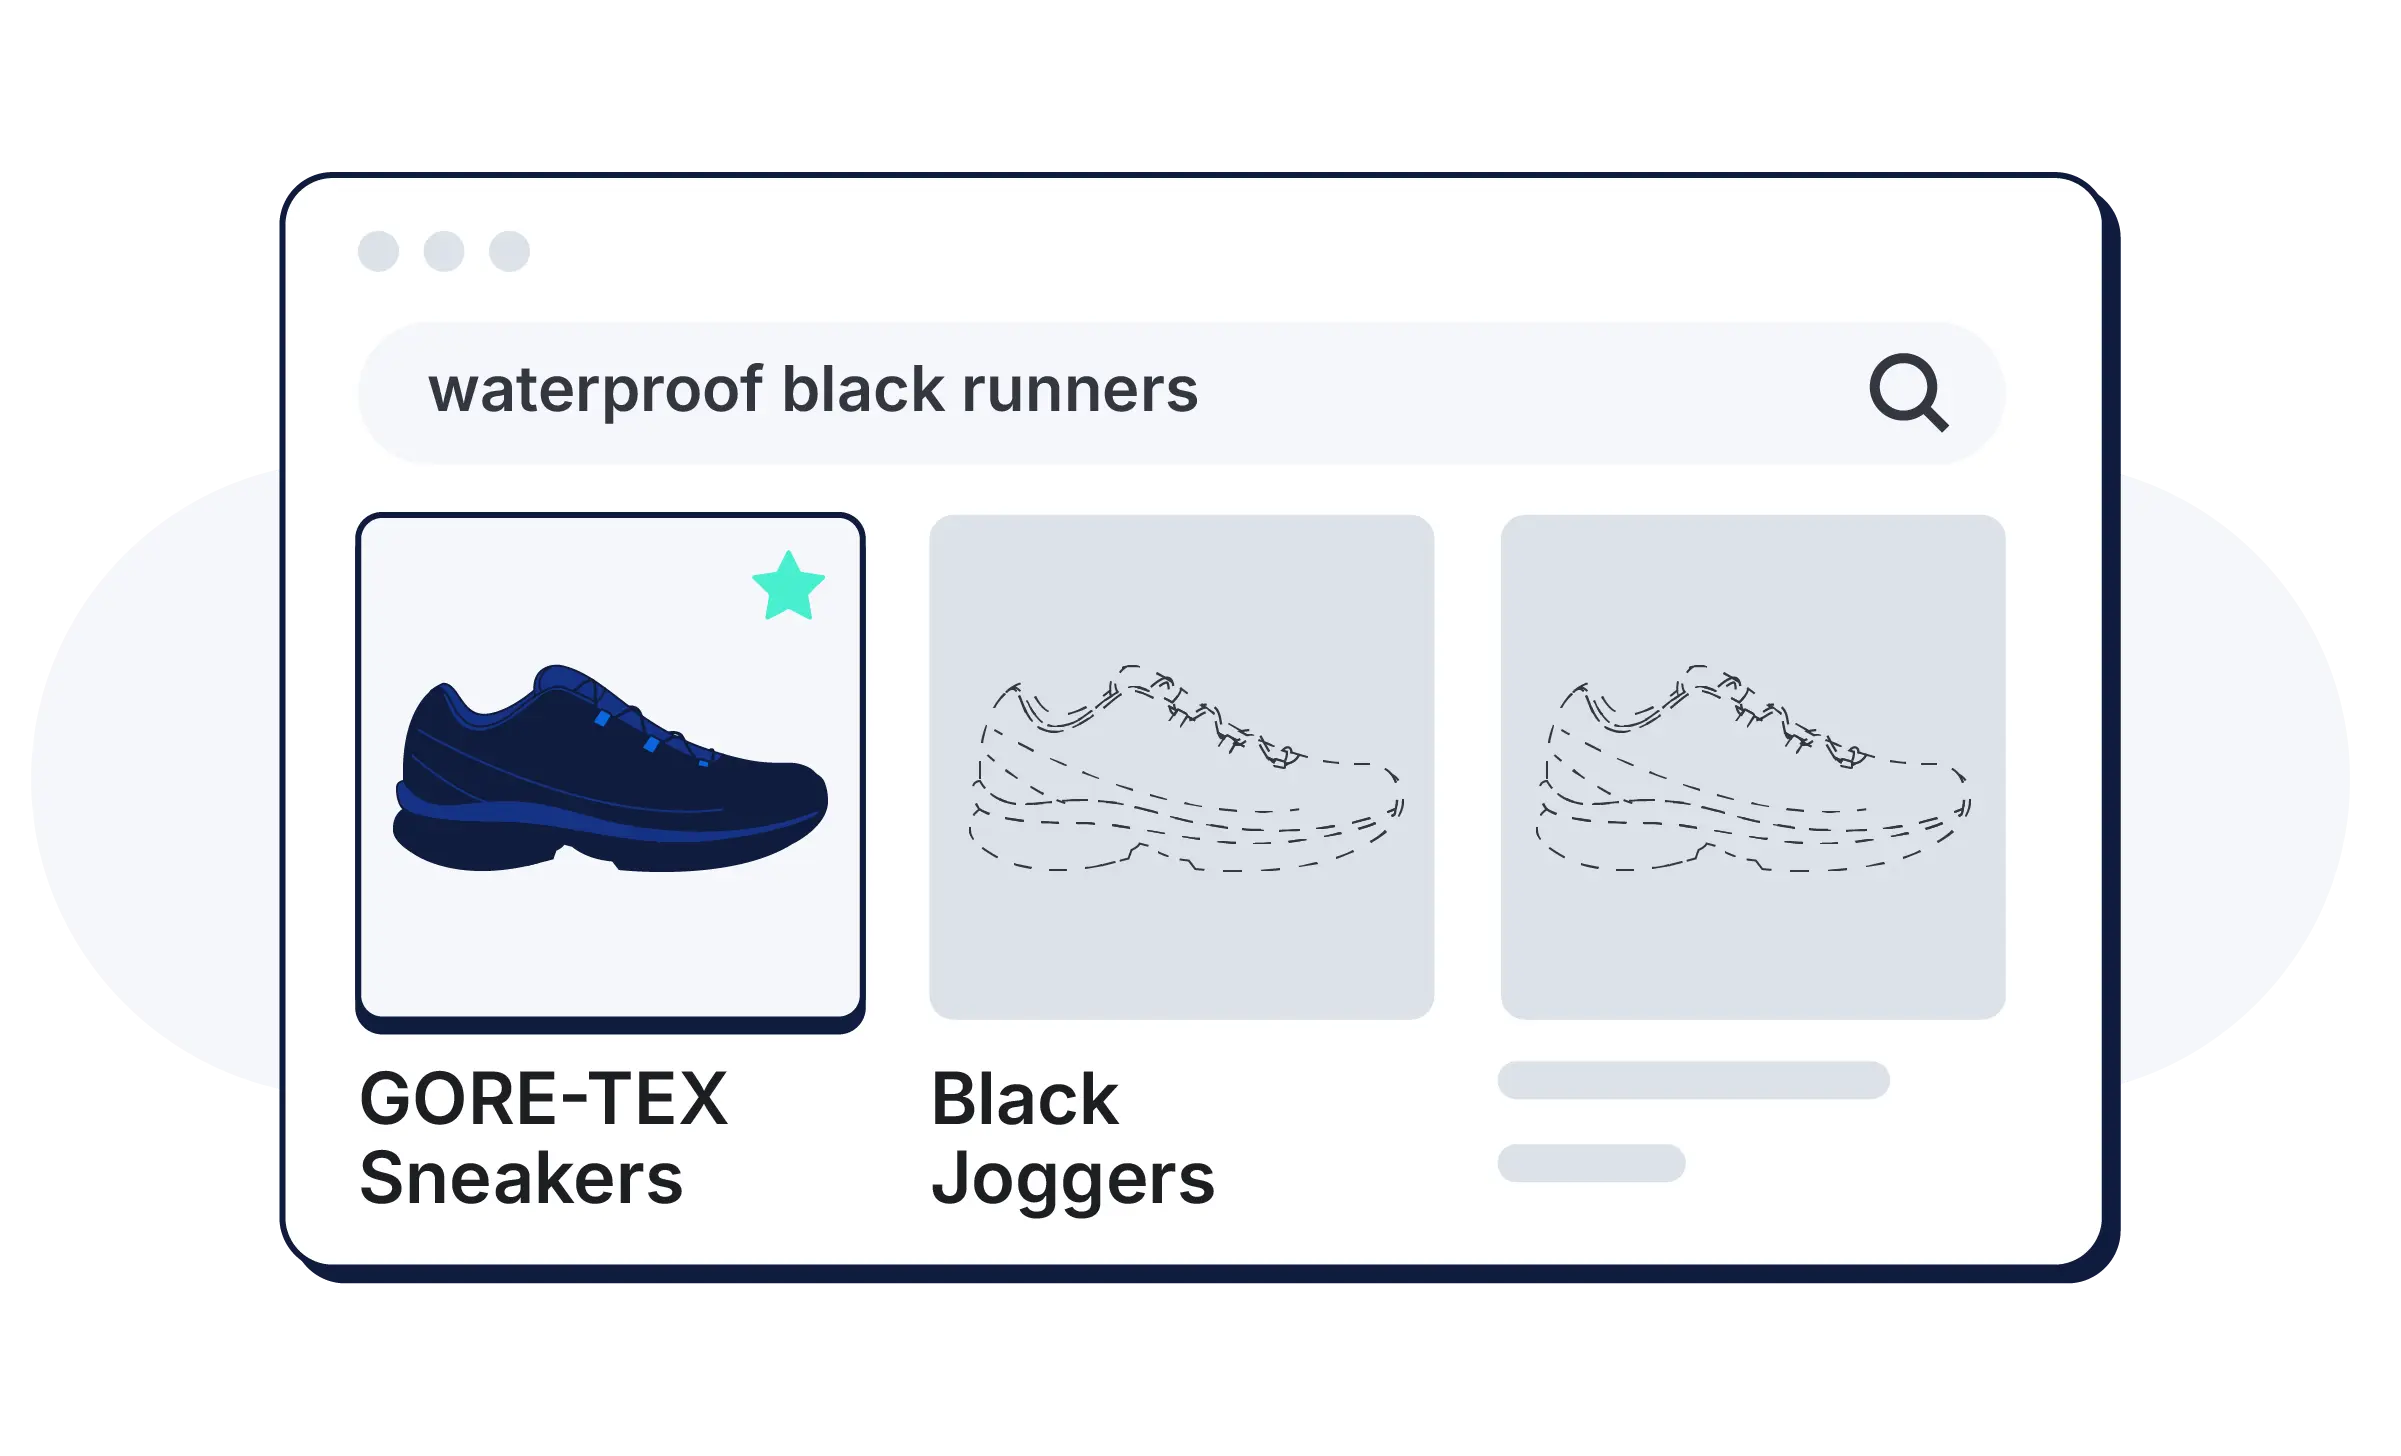
Jina AI는 문서 수집, 텍스트와 미디어 전반의 다국어 임베딩, 재순위화를 정확하고 비용 효율적으로 수행하는 최첨단 소형 모델을 개발합니다. 별도의 설정 없이 Elasticsearch에서 기본적으로 실행됩니다.
컴팩트한 설계, 정확한 결과
하나의 API로 문서를 정제된 정형 데이터와 정확도 높은 검색 결과로 변환하세요.

어떤 개발 환경에서든 가능한 Jina 모델 활용
완전 관리형부터 자체 호스팅까지, 데이터가 있는 곳 어디서나 Jina 모델을 사용할 수 있습니다. 환경에 가장 적합한 액세스 경로를 선택하세요.
우리의 연구
오픈 소스 커뮤니티 참여
Jina 모델은 가중치 공개 모델로 Hugging Face에서 자유롭게 이용할 수 있으며, 매월 수백만 건의 다운로드를 기록하고 있습니다. 코드베이스는 GitHub에서 공개되어 있습니다. 커뮤니티는 개발자와 직접 소통할 수 있습니다.
자주 묻는 질문
Jina 검색 모델이란 무엇인가요?
Jina 검색 모델이란 무엇인가요?
Jina 모델은 검색을 위한 오픈 소스 기반의 최첨단 AI 모델입니다. 여기에는 벡터 임베딩 모델, 정확도 향상을 위한 리랭커, URL 및 문서에서 콘텐츠를 추출하고 구조화하는 리더 등이 포함됩니다.
Jina 모델을 사용하려면 AI나 머신 러닝 전문 지식이 필요한가요?
Jina 모델을 사용하려면 AI나 머신 러닝 전문 지식이 필요한가요?
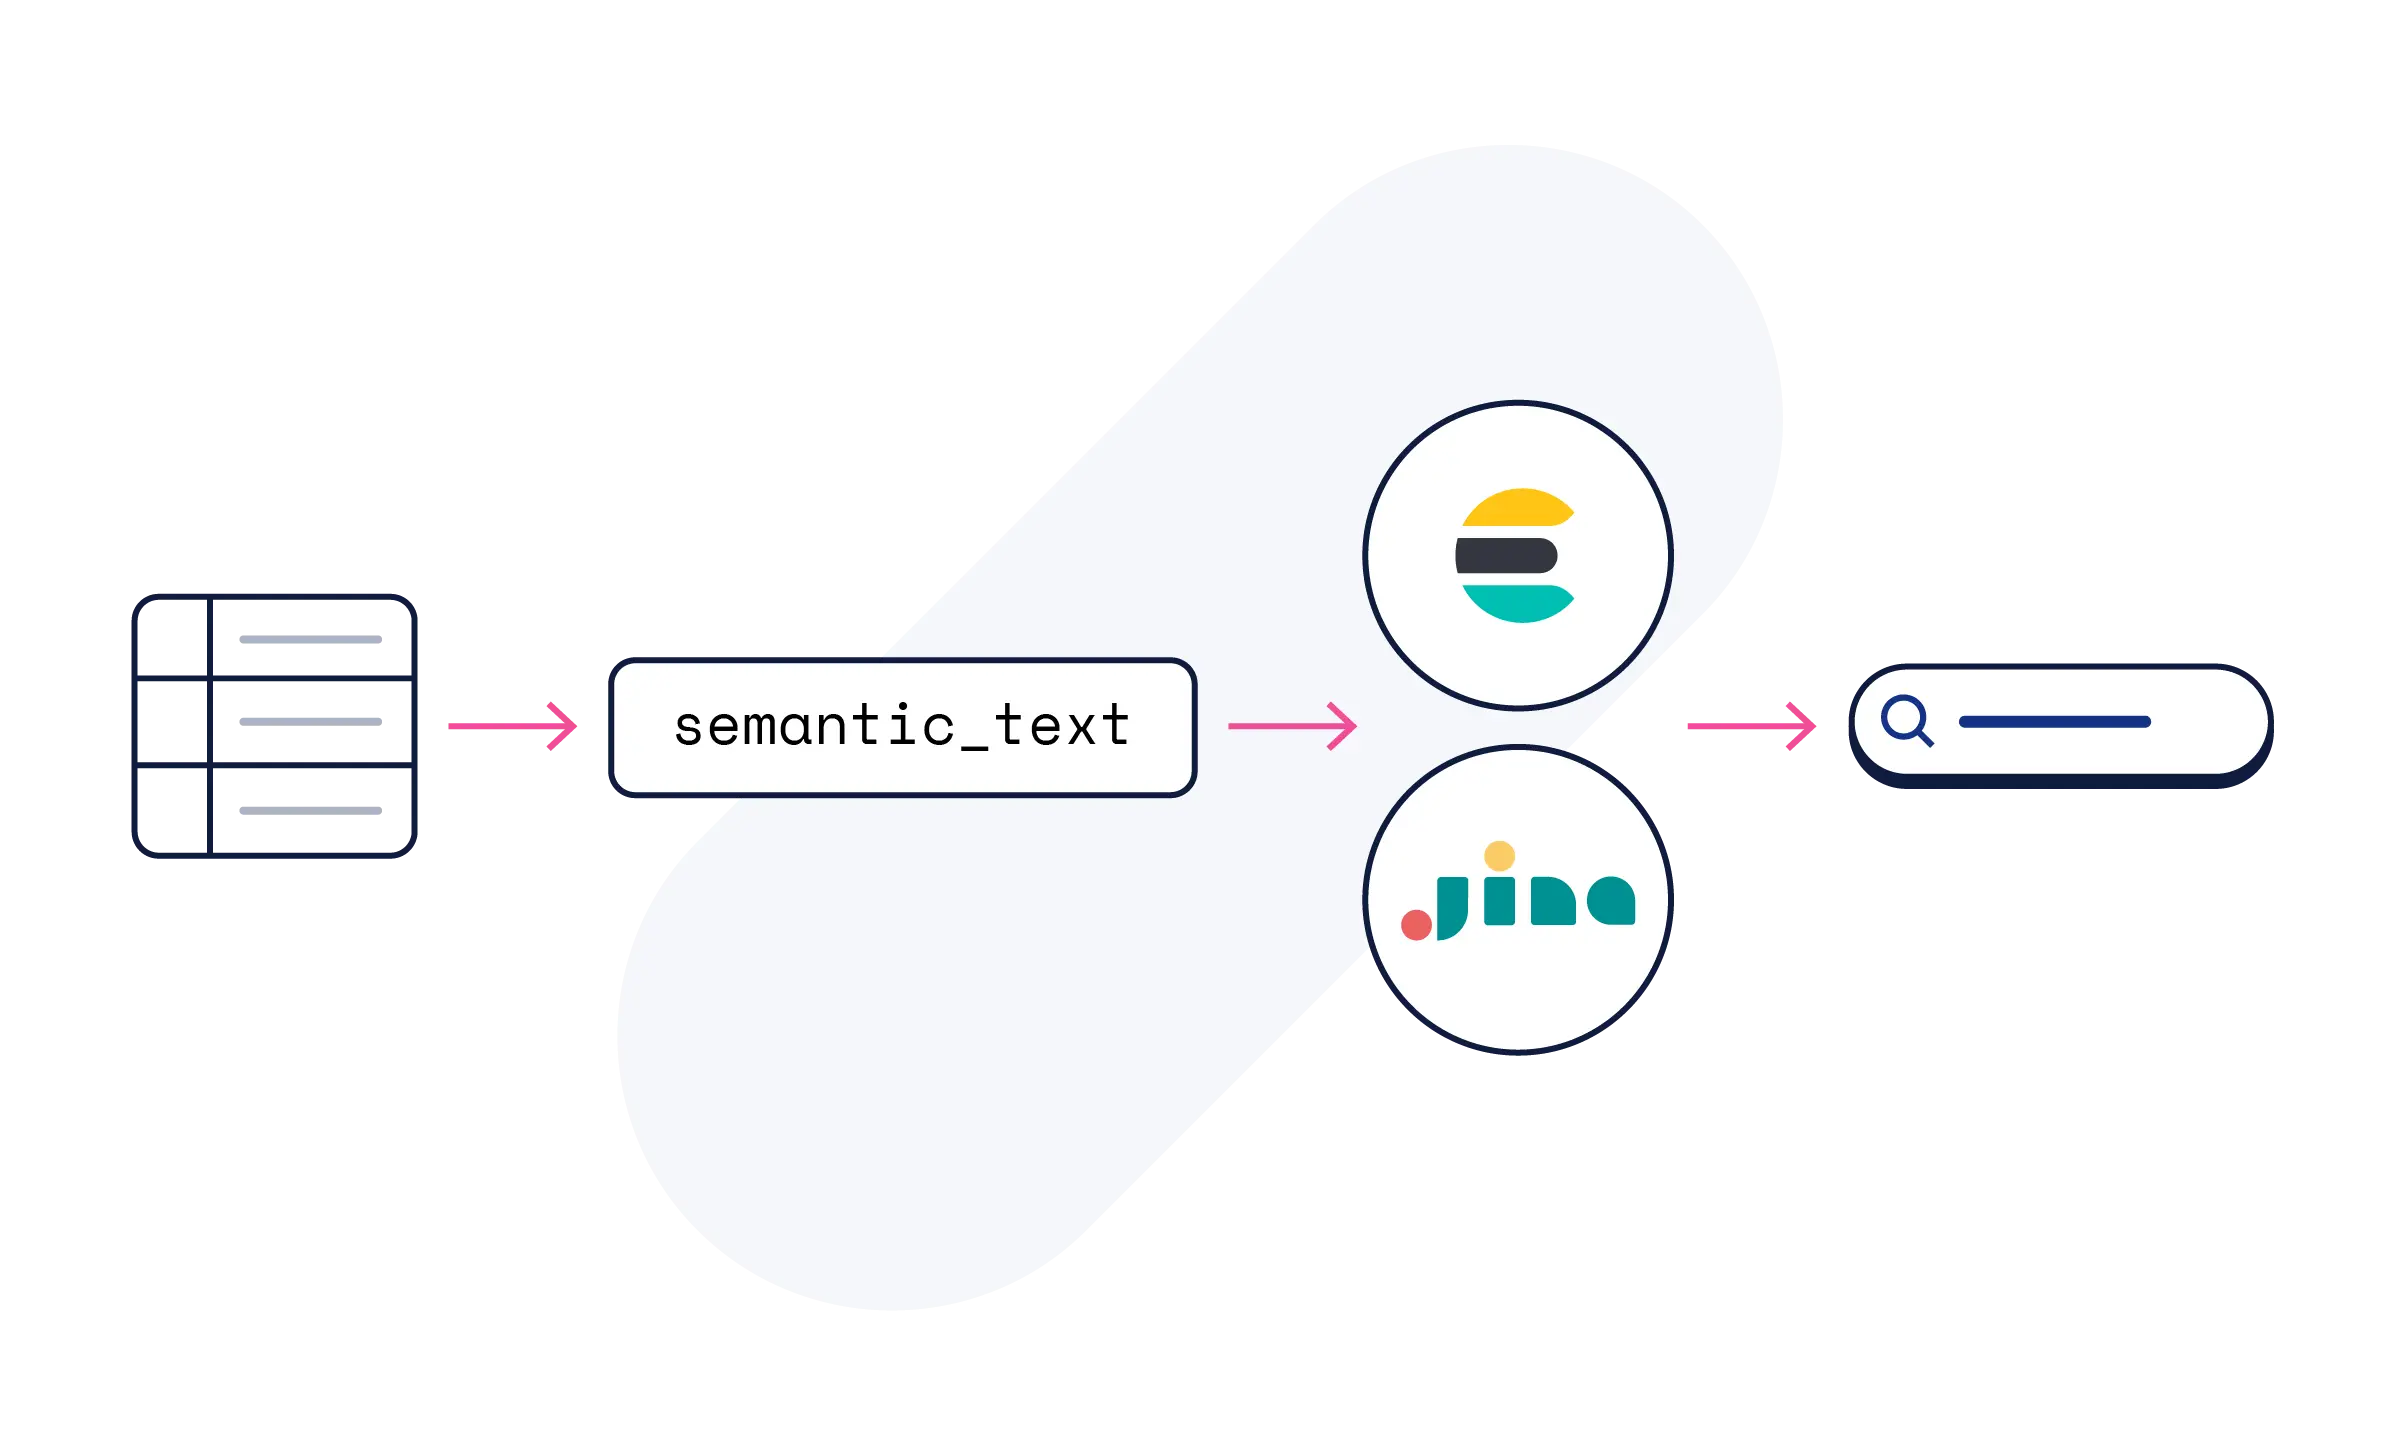
ML 전문 지식은 필요하지 않습니다. Jina 모델은 Elasticsearch에서 사전 구성된 엔드포인트로 제공됩니다. semantic 또는 semantic_text 필드를 매핑하면 임베딩이 자동으로 생성됩니다.
어떻게 시작하나요?
어떻게 시작하나요?
Jina 모델은 모든 체험판에 포함된 Elastic Cloud의 Elastic Inference Service에서 사용할 수 있습니다. 먼저 semantic 또는 semantic_text 필드를 정의해 보거나, Hugging Face의 모델 카드에서 코드 예제를 살펴보세요.
현재 사용 가능한 Jina 모델은 무엇인가요?
현재 사용 가능한 Jina 모델은 무엇인가요?
Elastic Inference Service에서 지원되는 Jina 모델은 Jina 모델 문서에 자세히 설명되어 있습니다.
지원되는 언어는 몇 개입니까?
지원되는 언어는 몇 개입니까?
Jina-embeddings-v5-omni 및 Jina-ocr-v1은 100개 이상의 언어를 지원합니다. 한 언어로 쿼리하면 번역 파이프라인이 없어도 다른 언어로 작성된 관련 콘텐츠를 찾을 수 있습니다.
이것이 ELSER와 어떤 관련이 있습니까?
이것이 ELSER와 어떤 관련이 있습니까?
Jina 임베딩 모델은 신규 프로젝트의 기본 옵션입니다. ELSER를 사용하기로 선택한 고객을 위한 지원도 계속됩니다. 두 모델 모두 Elasticsearch의 하이브리드 검색 프레임워크 내에서 사용할 수 있습니다.
이것은 별도의 제품입니까?
이것은 별도의 제품입니까?
Elastic Inference Service의 Jina 검색 모델은 모든 Elastic Cloud 사용자가 사용량 기반 요금으로 이용할 수 있습니다. 별도의 라이선스, 구독 또는 API 키는 필요하지 않습니다. Jina 모델은 Jina 온프레미스의 일부로 별도 구매할 수 있습니다.
이것이 Elastic의 벡터 데이터베이스 페이지와 어떤 관련이 있습니까?
이것이 Elastic의 벡터 데이터베이스 페이지와 어떤 관련이 있습니까?
벡터 데이터베이스 페이지는 벡터가 대규모로 저장되고 검색되는 방법을 다룹니다. 이 페이지는 벡터를 생성하고 순위를 재지정하는 AI 모델과 저장 공간, 계산, 애플리케이션을 다룹니다.