Modelos de búsqueda de Jina AI
Modelos de vanguardia para ingesta y recuperación
Los modelos Jina AI preservan el significado desde la ingesta a la recuperación. Obtén precisión de punta por una fracción del costo de cómputo en la nube, localmente o de forma nativa en Elasticsearch.
Modelos de IA que preservan el significado, desde los documentos hasta las respuestas
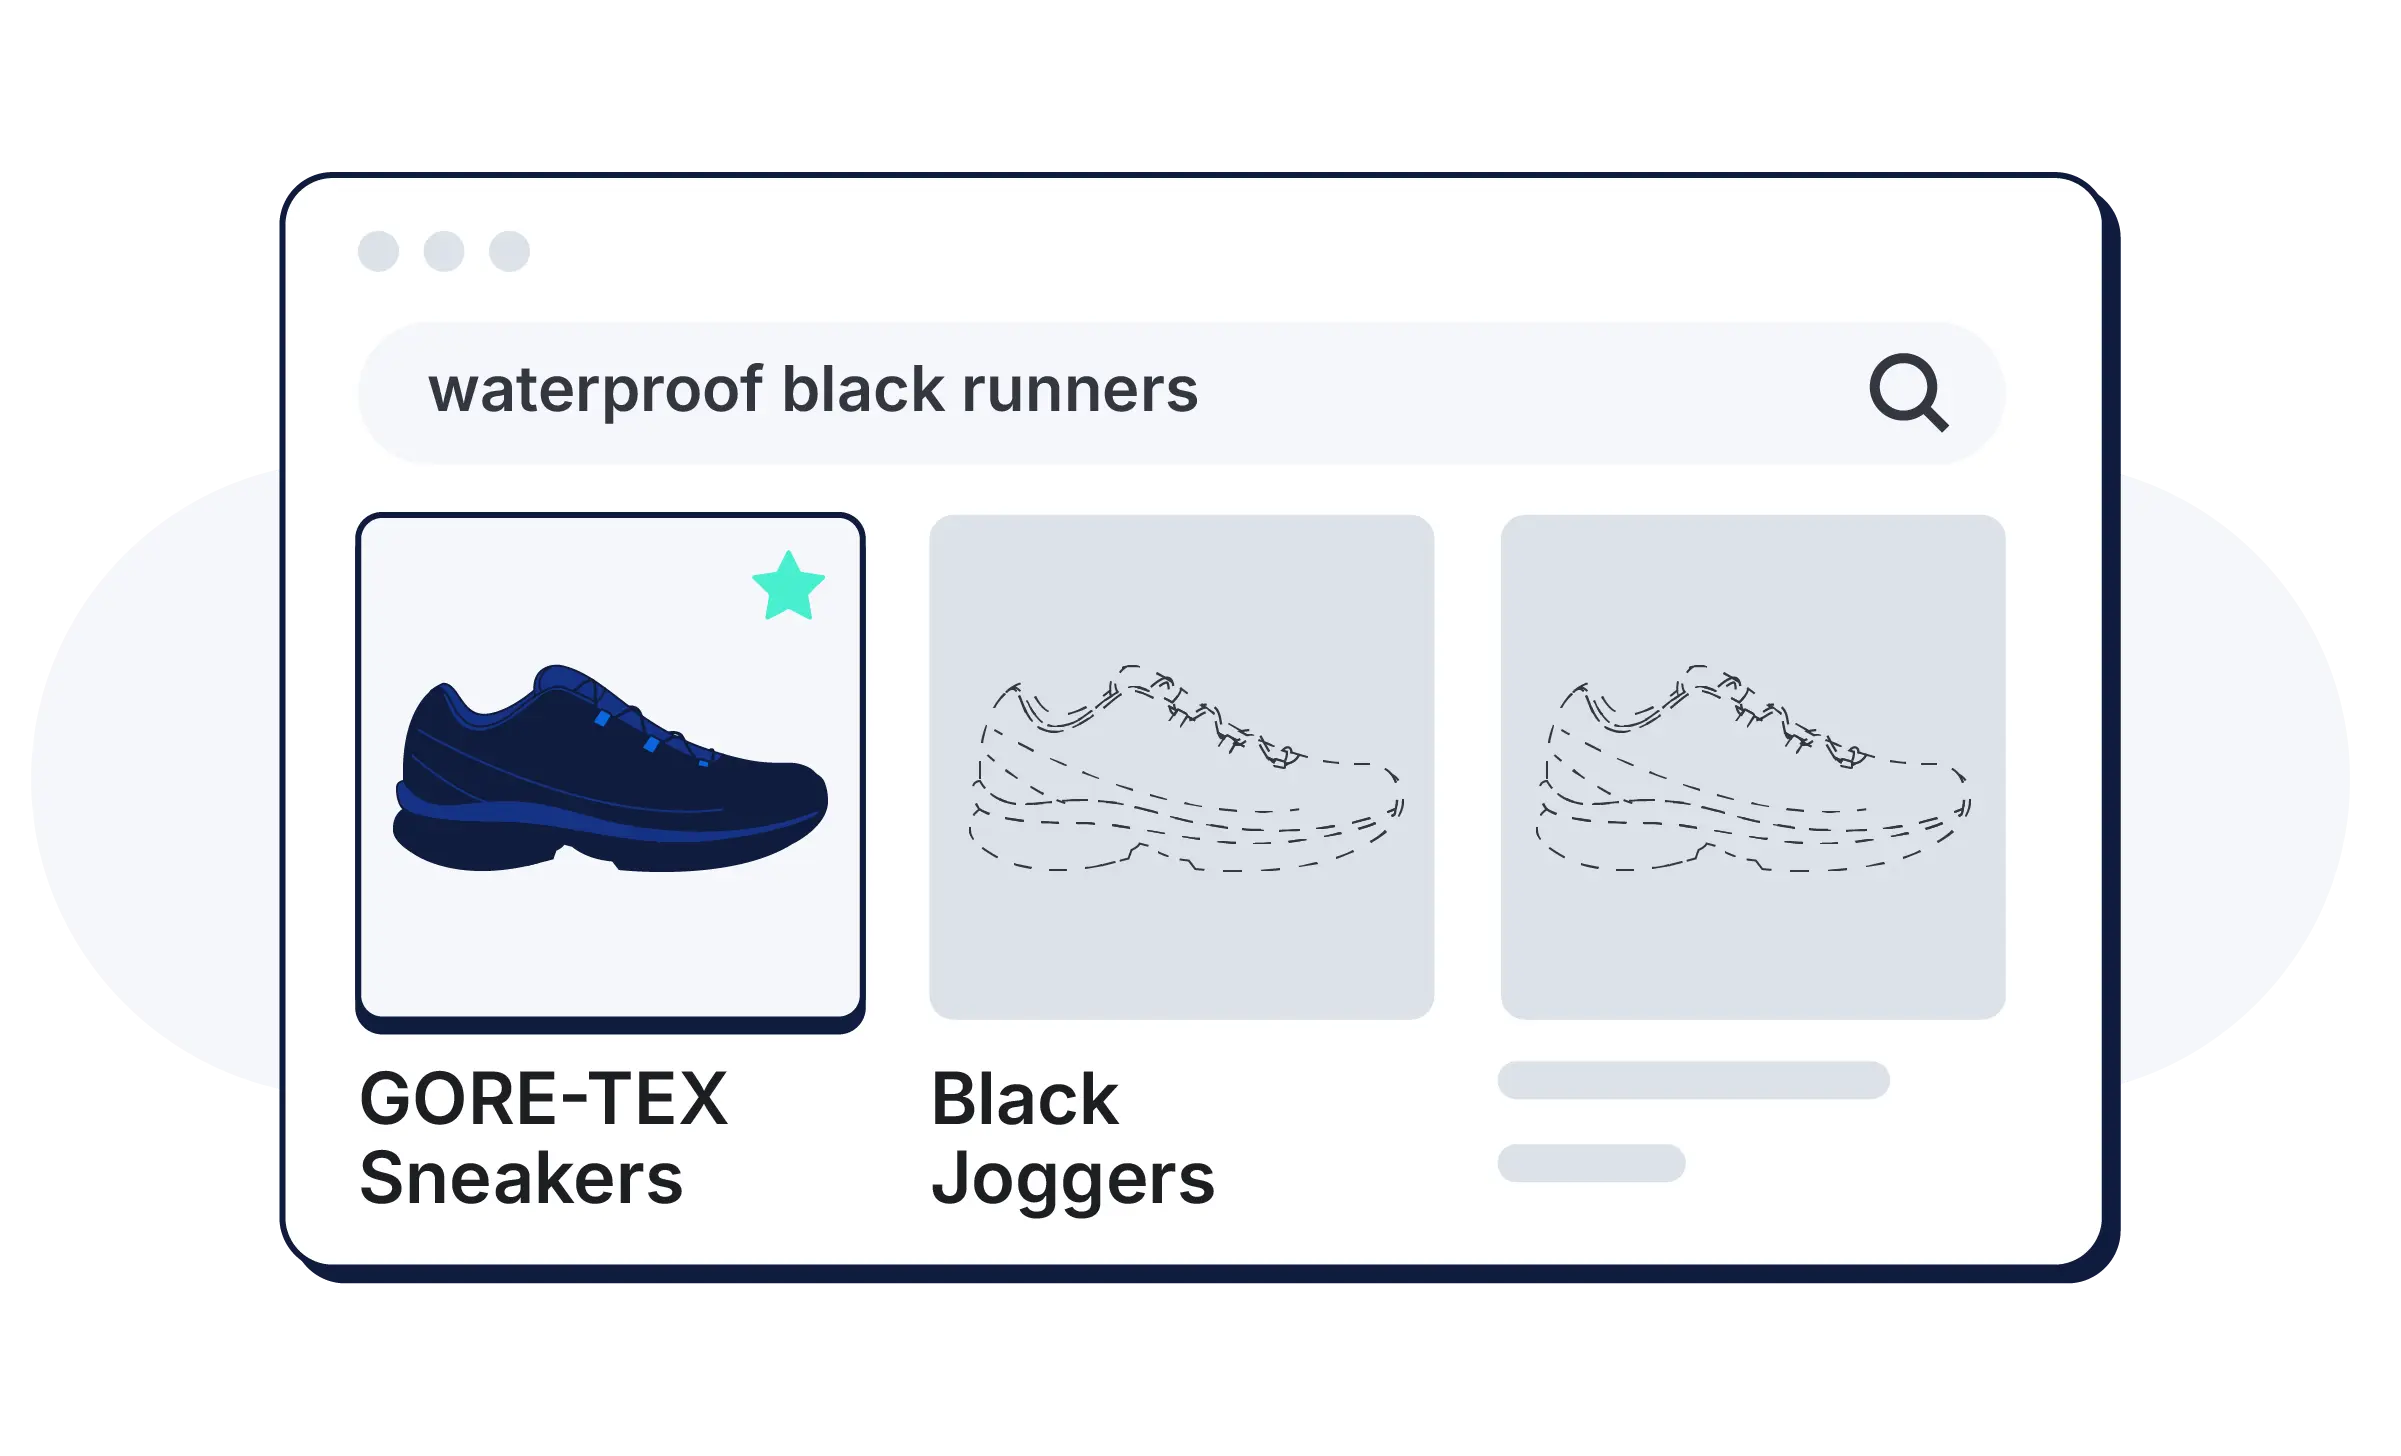
Jina AI desarrolla modelos pequeños de vanguardia para ingerir documentos de forma precisa y rentable, generar incrustaciones multilingües en texto y medios y reclasificar. Se ejecuta de forma nativa en Elasticsearch sin configuración.


De diseño compacto y resultados precisos
Convierte documentos en datos limpios y estructurados, y en resultados de búsqueda de alta precisión, en una sola API.

Utiliza los modelos de Jina para cualquier desarrollo
Tanto los modelos completamente administrados como los autohospedados de Jina se adaptan donde residen tus datos. Elige la ruta de acceso que más te convenga.


Nuestra investigación


Únete a nuestra comunidad de open source
Los modelos de Jina son de código abierto y están disponibles gratuitamente en Hugging Face, con millones de descargas mensuales. El código fuente es público en GitHub. La comunidad tiene acceso directo a nuestros desarrolladores.
Accede a nuestros modelos de incrustaciones, reclasificadores y pequeños modelos de lenguaje para una búsqueda refinada.
Preguntas frecuentes
¿Qué son los modelos de búsqueda de Jina?
¿Qué son los modelos de búsqueda de Jina?
Los modelos de Jina son modelos de IA de vanguardia open source para la recuperación. Incluyen modelos de incrustación para vectores, rerankers para precisión y OCR y lectores para extraer y estructurar contenido de URL y documentos.
¿Necesito conocimientos de IA o machine learning para usar los modelos de Jina?
¿Necesito conocimientos de IA o machine learning para usar los modelos de Jina?
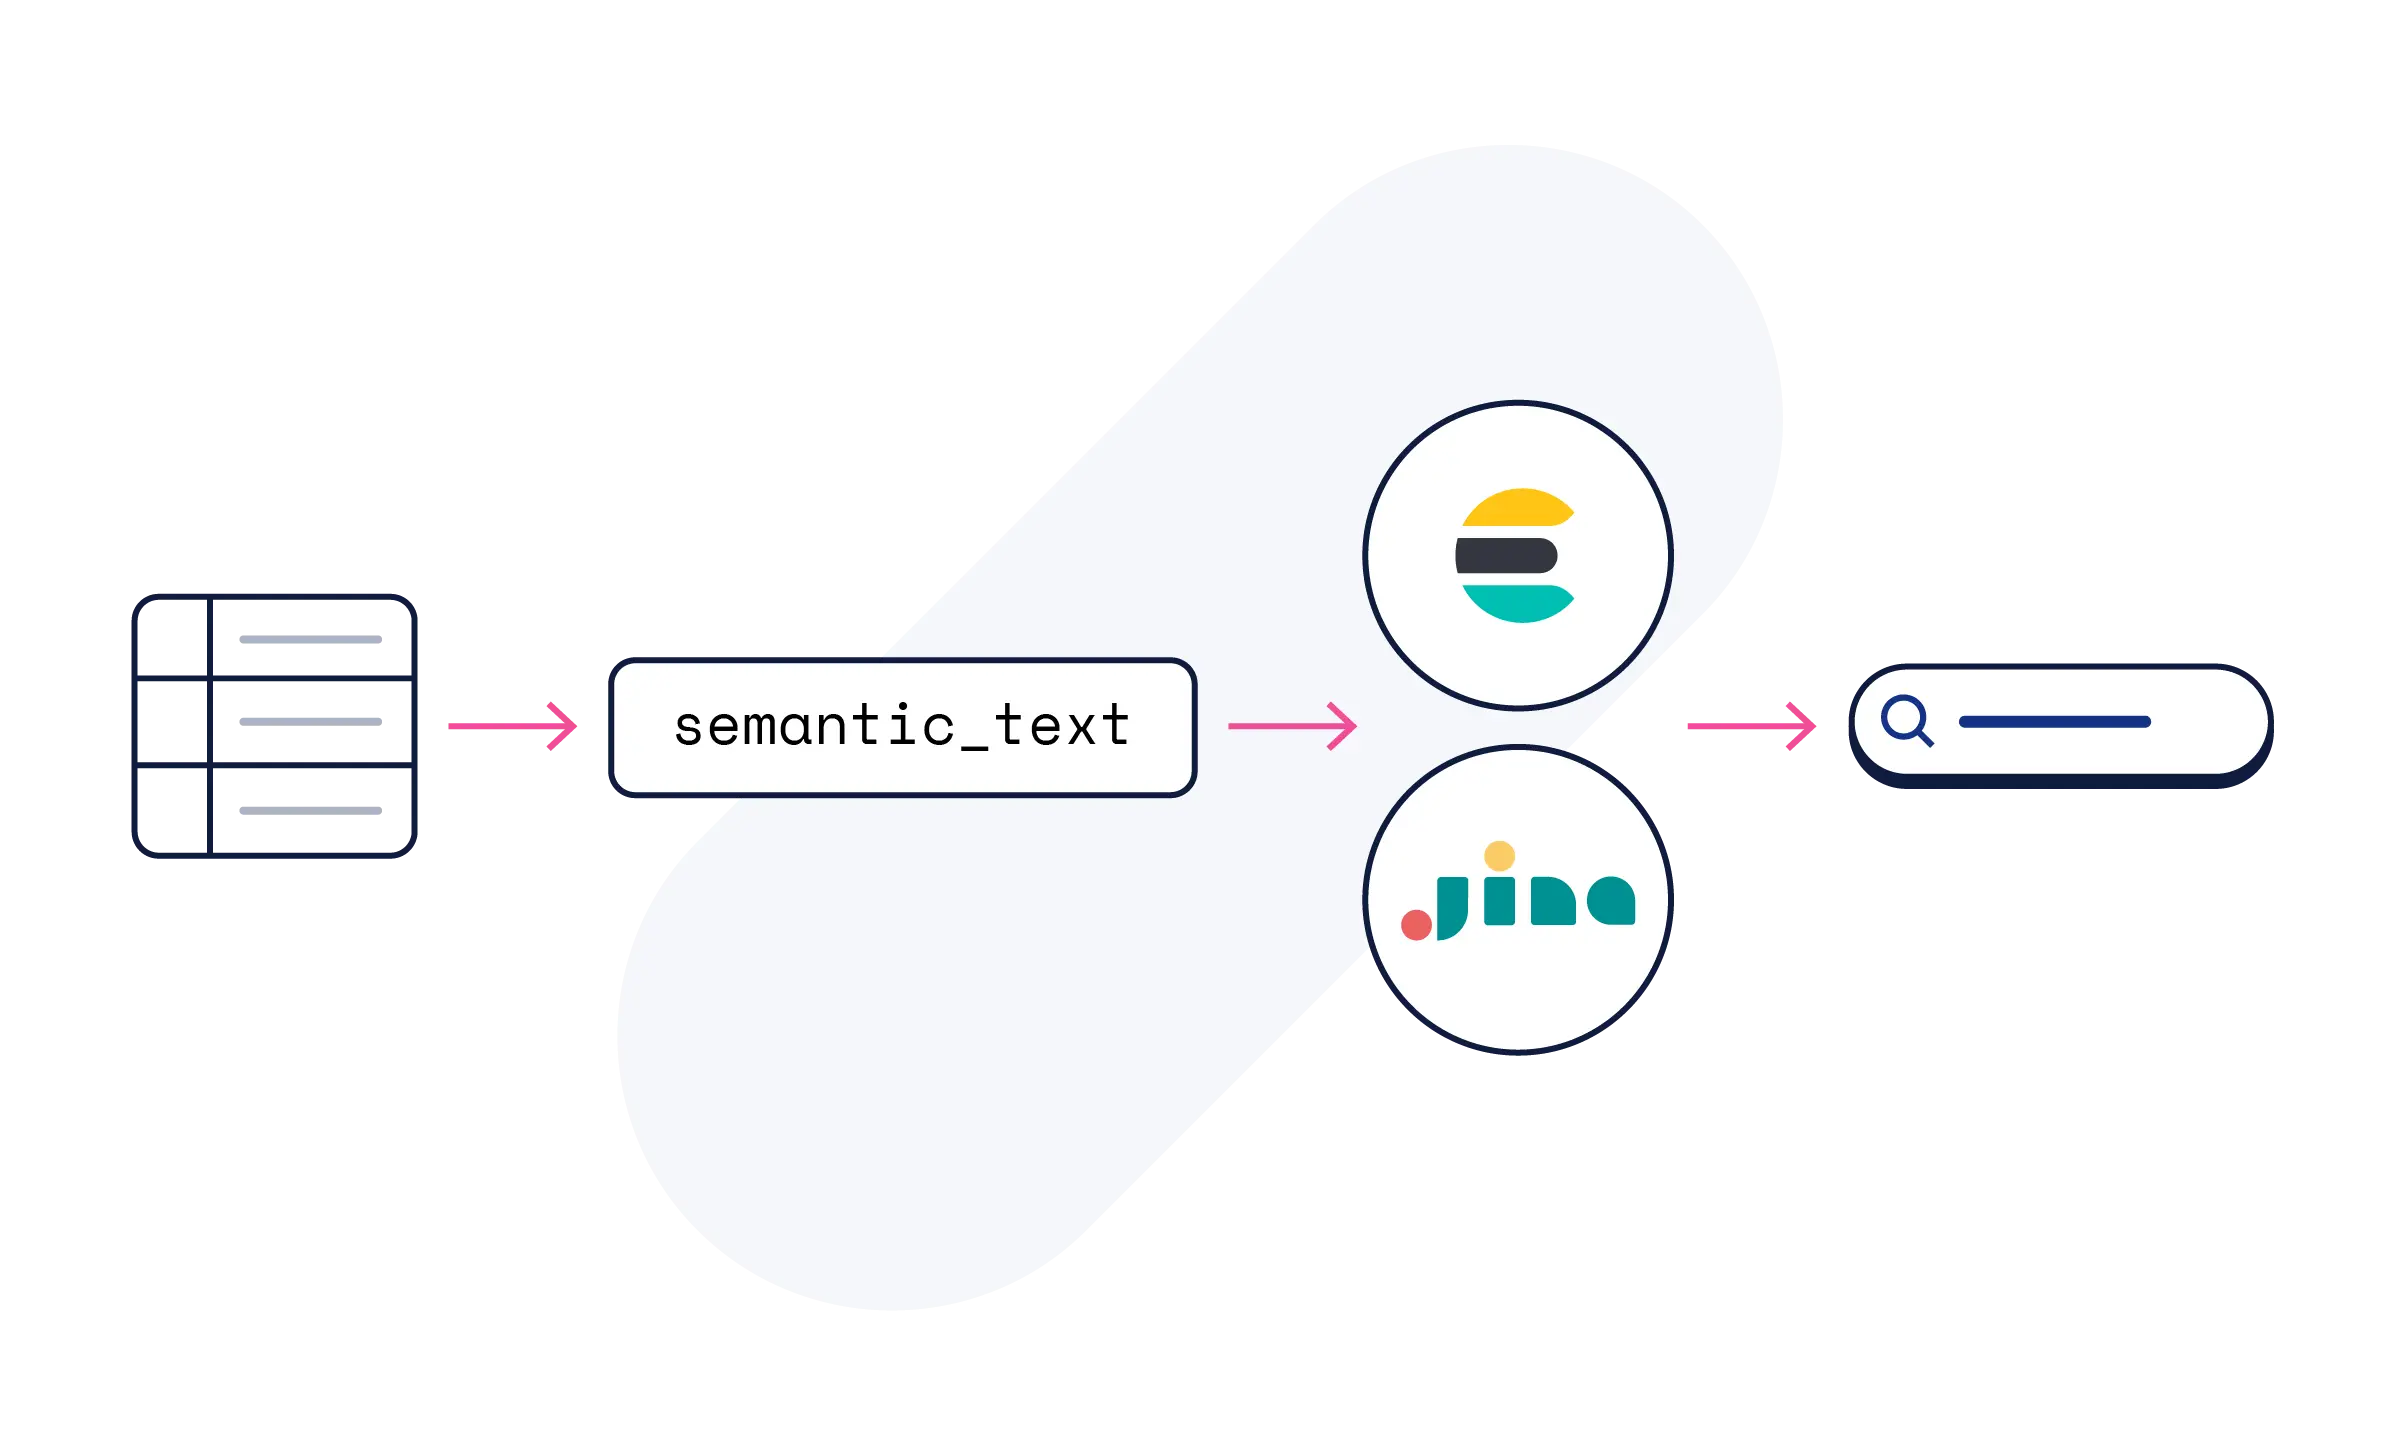
No se requieren conocimientos de ML. Los modelos de Jina están disponibles como endpoints preconfigurados en Elasticsearch. Mapea un campo semantic o semantic_text y la generación de incrustaciones se hace automáticamente.
¿Cómo comienzo?
¿Cómo comienzo?
Los modelos de Jina están disponibles en Elastic Inference Service en Elastic Cloud y se incluyen en todas las pruebas. Comienza por definir un campo semantic o semantic_text, o explora las tarjetas de modelos en Hugging Face para ver ejemplos de código.
¿Qué modelos de Jina están disponibles hoy?
¿Qué modelos de Jina están disponibles hoy?
Los modelos de Jina compatibles con Elastic Inference Service se detallan en nuestra documentación sobre modelos de Jina.
¿Cuántos idiomas son compatibles?
¿Cuántos idiomas son compatibles?
Jina-embeddings-v5-omni y Jina-ocr-v1 admiten más de 100 idiomas. Una búsqueda en un idioma encuentra contenido relevante escrito en otro, sin necesidad de pipelines de traducción.
¿Cómo se relaciona esto con ELSER?
¿Cómo se relaciona esto con ELSER?
Los modelos de incrustación de Jina son la opción predeterminada para los proyectos nuevos. ELSER seguirá teniendo soporte para los clientes que elijan usarlo. Ambos están disponibles dentro del marco de trabajo de búsqueda híbrida de Elasticsearch.
¿Es este un producto independiente?
¿Es este un producto independiente?
Los modelos de búsqueda Jina en Elastic Inference Service están disponibles para todos los usuarios de Elastic Cloud con precios basados en el consumo. No se requiere ninguna licencia, suscripción o clave de API especiales. Los modelos de Jina se pueden comprar por separado como parte de Jina On-Prem.
¿Cómo se relaciona esto con la página de la base de datos vectorial de Elastic?
¿Cómo se relaciona esto con la página de la base de datos vectorial de Elastic?
La página de la base de datos vectorial cubre cómo se almacenan y se realiza la búsqueda de los vectores a escala. Esta página cubre los modelos de IA que los generan y reclasifican. Juntos: almacenamiento, cómputo y aplicación.