Modelos de busca Jina AI
Modelos de ponta para ingestão e recuperação
Os modelos de IA da Jina preservam o significado dos dados da ingestão até a recuperação. Obtenha precisão de ponta com uma fração do custo computacional, com a possibilidade de implantação na sua nuvem, no local ou nativamente no Elasticsearch.
Modelos de IA que preservam o significado de documentos a respostas
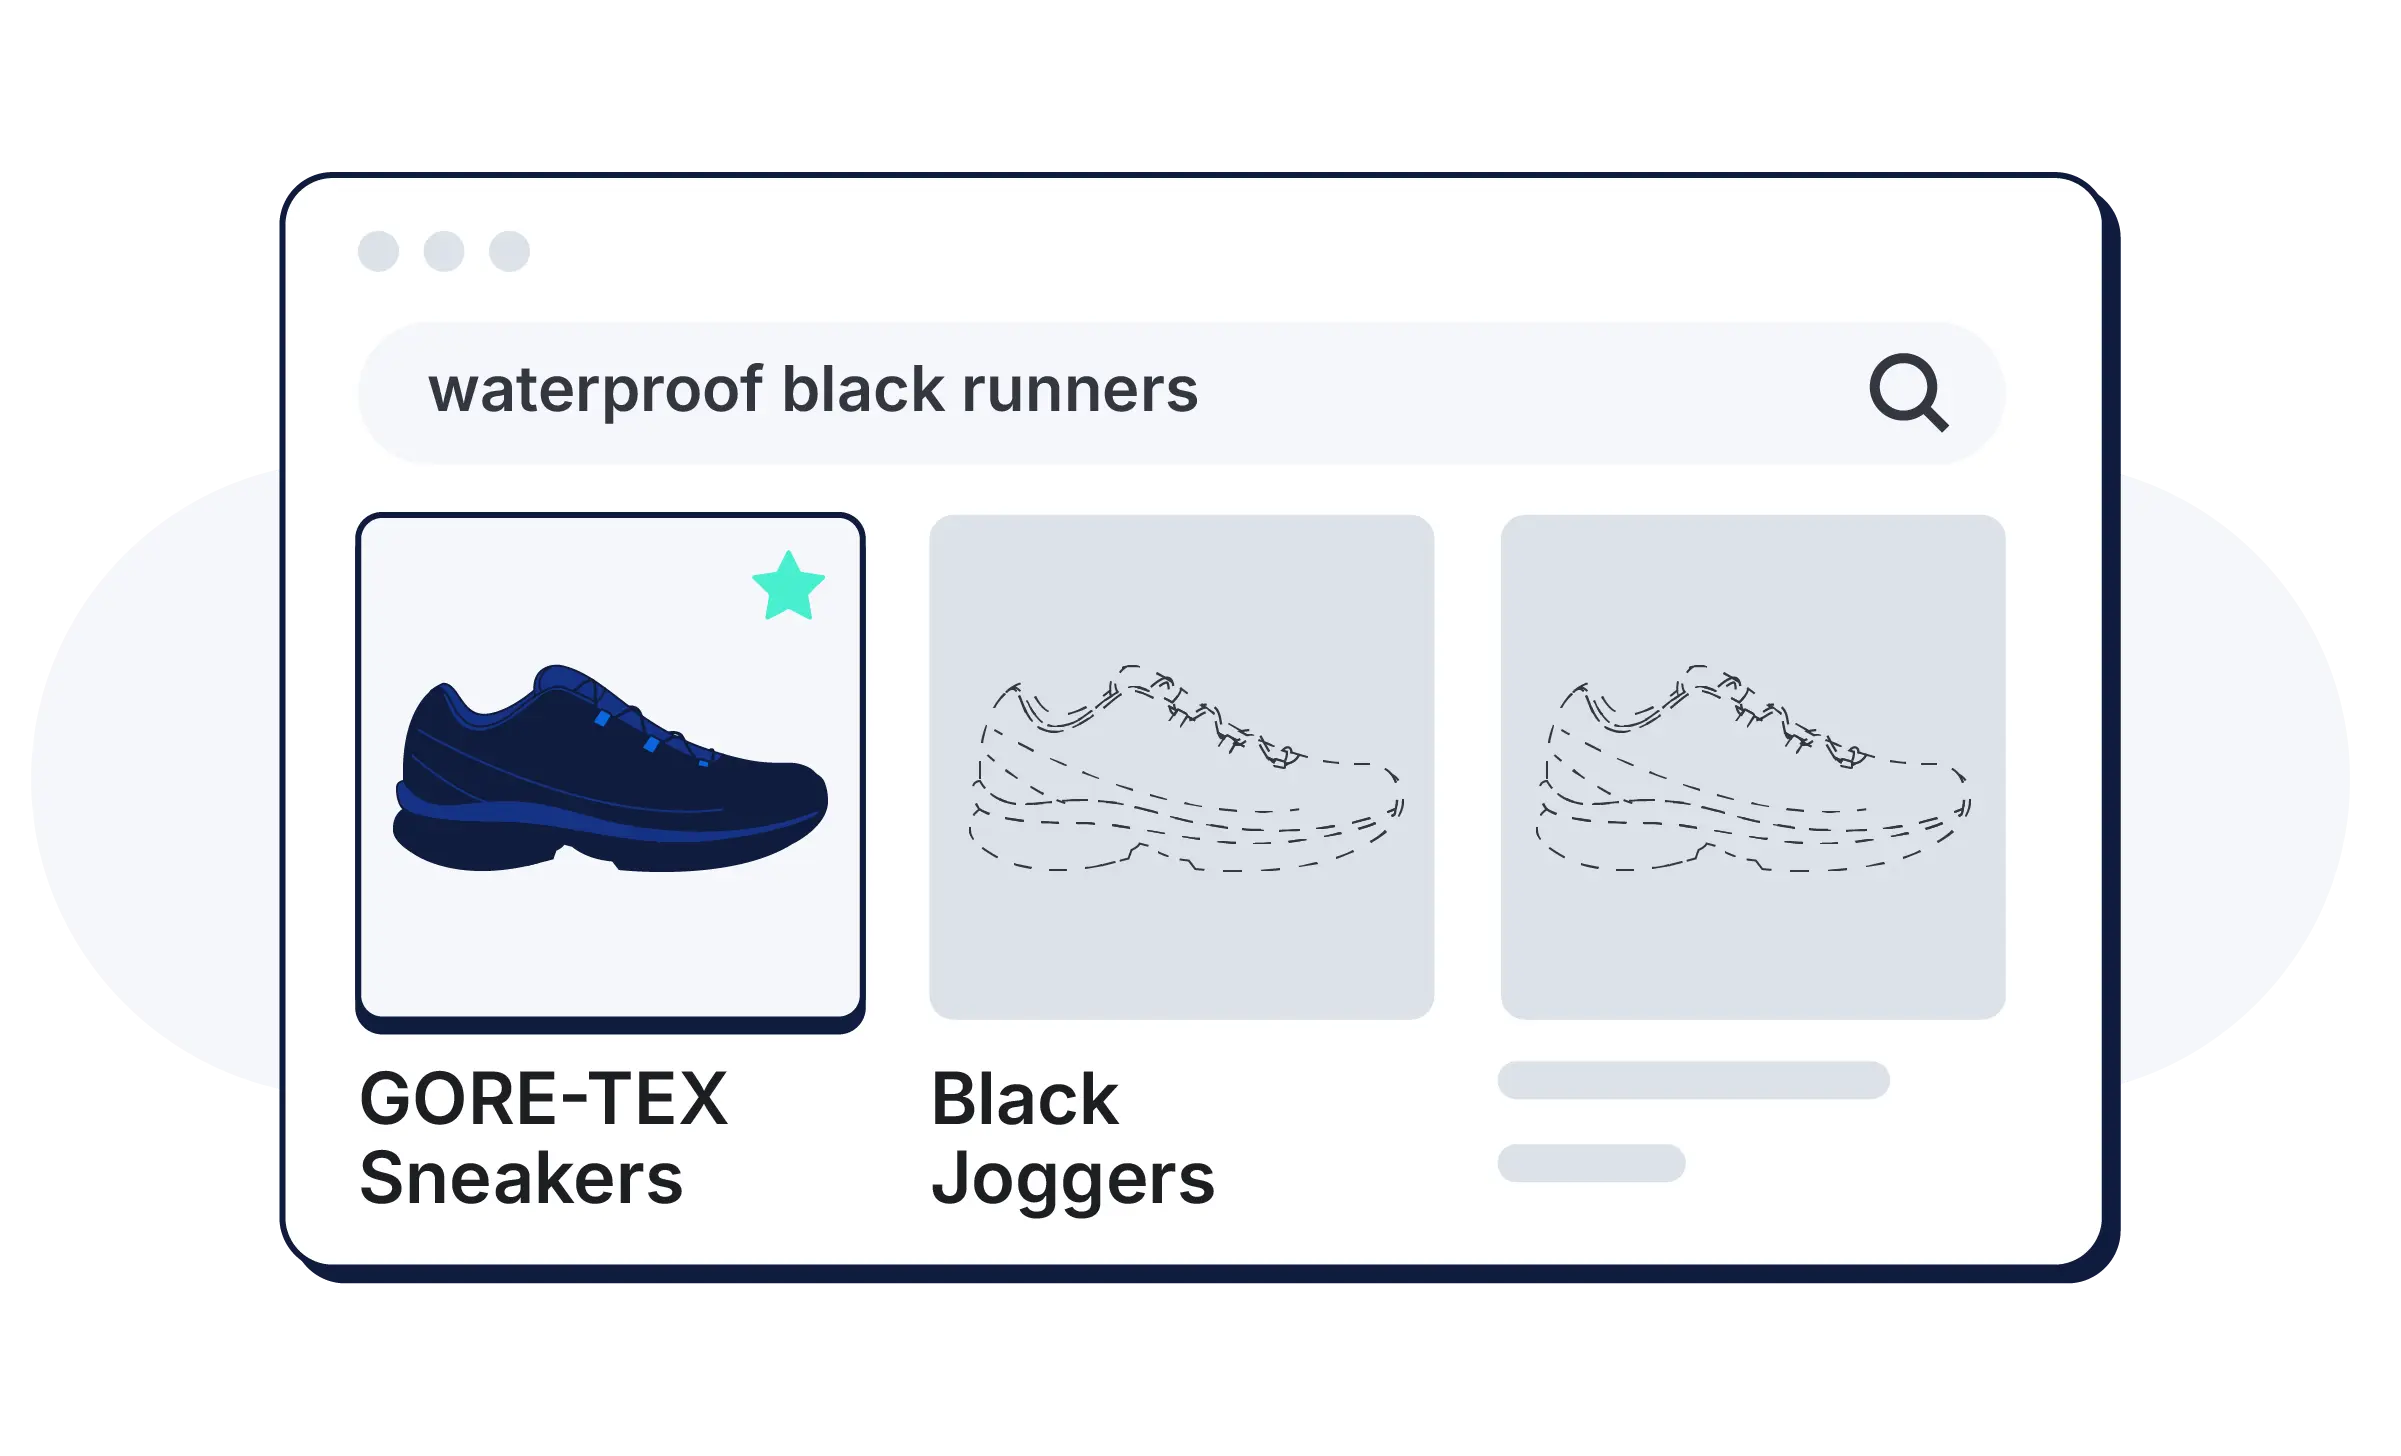
A Jina AI desenvolve modelos pequenos de ponta para ingestão de documentos precisa e econômica, embeddings multilíngues de texto e mídia e reclassificação de resultados. Esses modelos são executados nativamente no Elasticsearch, sem necessidade de configuração.


Compacto por concepção, preciso nos resultados
Transforme documentos em dados limpos e estruturados e resultados de busca de alta precisão, tudo em uma única API.

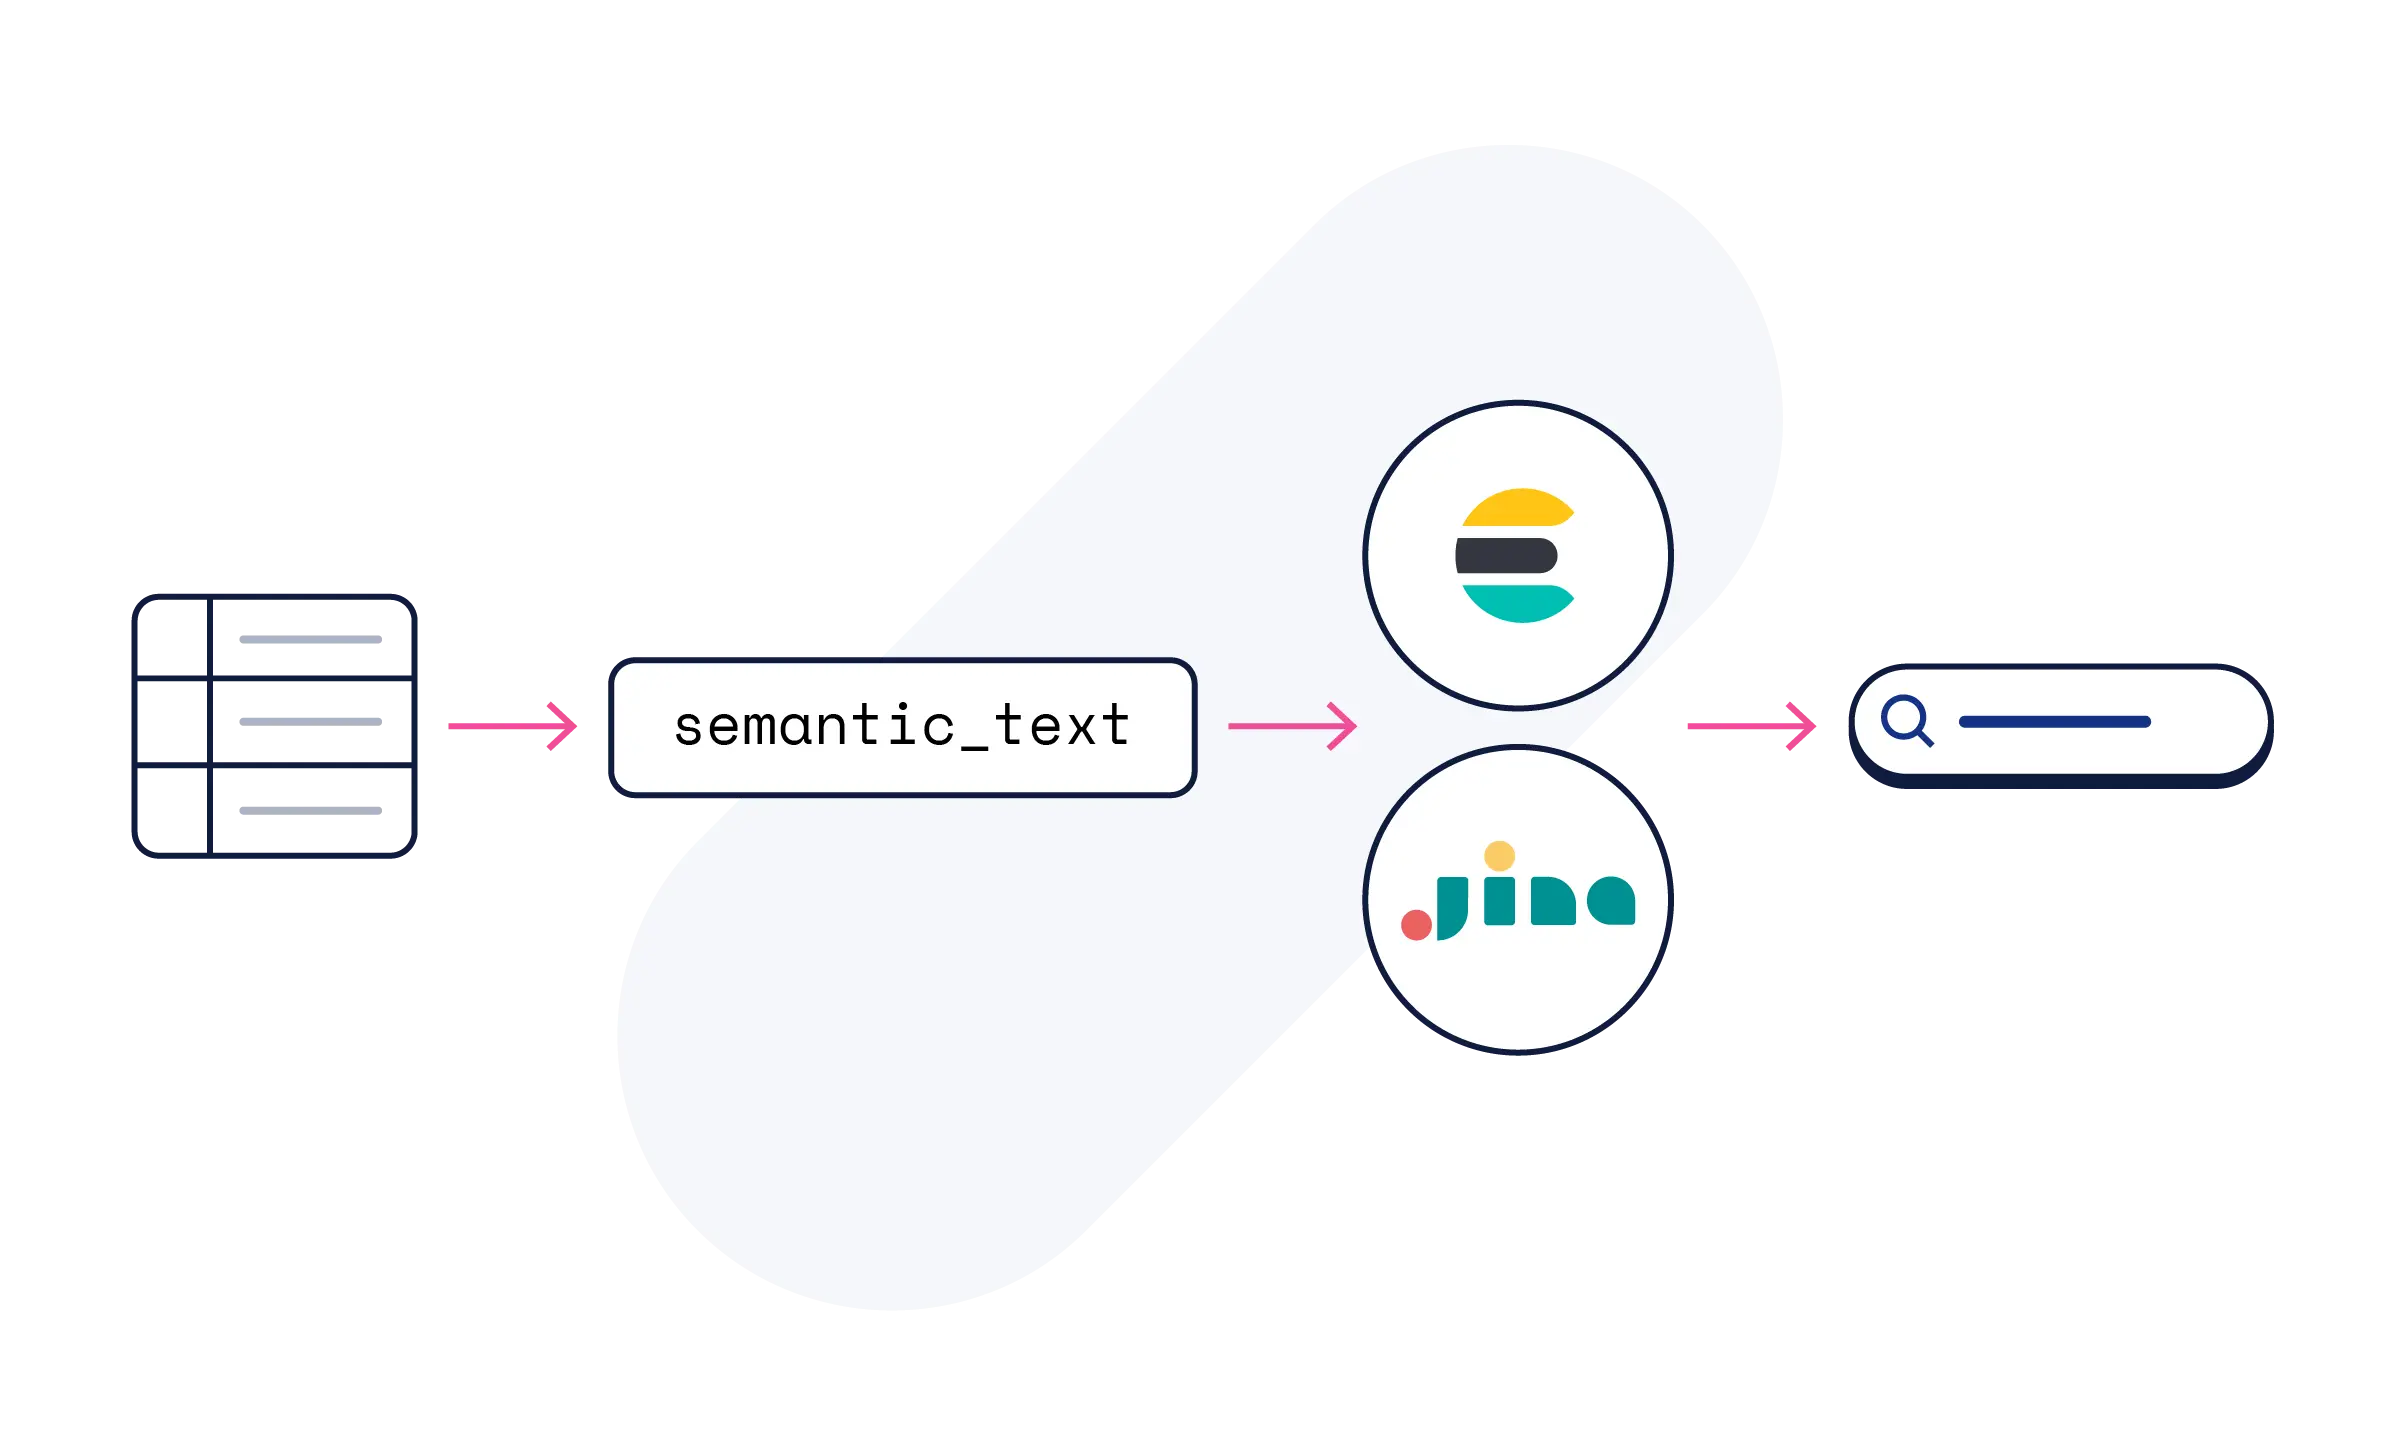
Use modelos Jina onde você já constrói
De totalmente gerenciados a auto-hospedados, os modelos Jina atendem você onde seus dados estão. Escolha um caminho de acesso.


Nossa pesquisa


Faça parte da nossa comunidade open source
Os modelos Jina são de código aberto e estão disponíveis gratuitamente no Hugging Face, com milhões de downloads mensais. O código-fonte é público no GitHub. A comunidade tem acesso direto aos nossos desenvolvedores.
Acesse nossos modelos para embeddings, reclassificadores e pequenos LMs para melhorar a busca.
Perguntas frequentes
O que são os modelos de busca Jina?
O que são os modelos de busca Jina?
Os modelos Jina são modelos de IA de ponta e open source para recuperação de informações. Eles incluem modelos de embedding para vetores, reclassificadores para precisão e OCR e leitores para extrair e estruturar conteúdo de URLs e documentos.
Preciso de experiência em IA ou machine learning para usar os modelos Jina?
Preciso de experiência em IA ou machine learning para usar os modelos Jina?
Não é necessário ter conhecimento especializado em ML. Os modelos Jina estão disponíveis como endpoints pré-configurados no Elasticsearch. Basta mapear um campo semantic ou semantic_text para que a geração de embeddings ocorra automaticamente.
Como começar?
Como começar?
Os modelos Jina estão disponíveis no Elastic Inference Service no Elastic Cloud, e estão incluídos em todas as avaliações gratuitas. Comece definindo um campo semantic ou semantic_text, ou explore as fichas de modelos no Hugging Face para ver exemplos de código.
Quais modelos Jina estão disponíveis hoje?
Quais modelos Jina estão disponíveis hoje?
Os modelos Jina compatíveis com o Elastic Inference Service estão detalhados na nossa documentação sobre modelos Jina.
Quantos idiomas são suportados?
Quantos idiomas são suportados?
Os modelos Jina-embeddings-v5-omni e Jina-ocr-v1 oferecem suporte a mais de 100 idiomas. Uma consulta em um idioma encontra conteúdo relevante escrito em outro, sem a necessidade de pipelines de tradução.
Qual a relação disso com o ELSER?
Qual a relação disso com o ELSER?
Os modelos de embeddings da Jina são a opção padrão para novos projetos. O ELSER continuará recebendo suporte para os clientes que optarem por utilizá-lo. Ambos estão disponíveis no framework de busca híbrida do Elasticsearch.
Este é um produto separado?
Este é um produto separado?
Os modelos de busca da Jina no Elastic Inference Service estão disponíveis para todos os usuários do Elastic Cloud, com preços baseados no consumo. Não é necessário ter uma licença, assinatura ou chave de API separada. Os modelos Jina também podem ser adquiridos separadamente como parte do Jina On-Prem.
Como isso se relaciona com a página do banco de dados vetorial da Elastic?
Como isso se relaciona com a página do banco de dados vetorial da Elastic?
A página sobre o banco de dados vetorial aborda como os vetores são armazenados e pesquisados em grande escala. Esta página aborda os modelos de IA que os geram e reclassificam. Em conjunto: armazenamento, computação e aplicação.