Elasticsearch Vector Database:数分でシッピング、数百億規模へ手頃なコストでスケール
ハイブリッド検索の難しい部分はすでに完了しています。最適化されたデフォルト設定、サードパーティおよびネイティブのJina AIモデル、マネージドGPU推論をすべてすぐに利用できます。インフラの構築ではなく、高速でスケーラブルなAIアプリの構築に専念しましょう。
Search AIの自習型ハンズオン学習を使用して、ベクトル検索をご自身で試してみてください。無料のクラウドトライアルを始めるか、ローカルマシンでElasticを試すことができます。
Elasticsearchは、ベクトルワークロード向けに世界で最も広くデプロイされているプラットフォームの1つであり、GitHub、Docusign、Seismicなど多くの企業のセマンティック検索、Retrieval-Augmented Generation(RAG)、レコメンデーションを支えています。本日、ベクトルベースのアプリケーション向けに最適化された新しいサーバーレス製品、Elasticsearch Vector Databaseを発表します。ドキュメントとクエリをご用意いただければ、埋め込み、インデックスチューニング、インフラは当社が対応します。さらに、低価格で拡張性にも優れています。
新規ユーザーにとって、これは高品質なベクトル検索を最も迅速に開始する方法です。すでにElasticsearchをご利用の場合は、新しいシステムを導入する必要はなく、データが既に存在するプラットフォーム上でベクトル検索を利用できるようになります。Elasticsearch Vector Databaseは、大規模言語モデル(LLM)のグラウンディングから、AIエージェントへの検索機能とメモリの提供、数千億ものベクトルの提供まで、幅広いシナリオをサポートします。わずか数分で新しいプロジェクトを立ち上げ、開始できます。
1つのエンジン、あらゆるベクトルユースケース
Elasticsearch Vector Databaseは、ベクトルを使用してアプリケーションを構築するすべての人向けに設計されています。
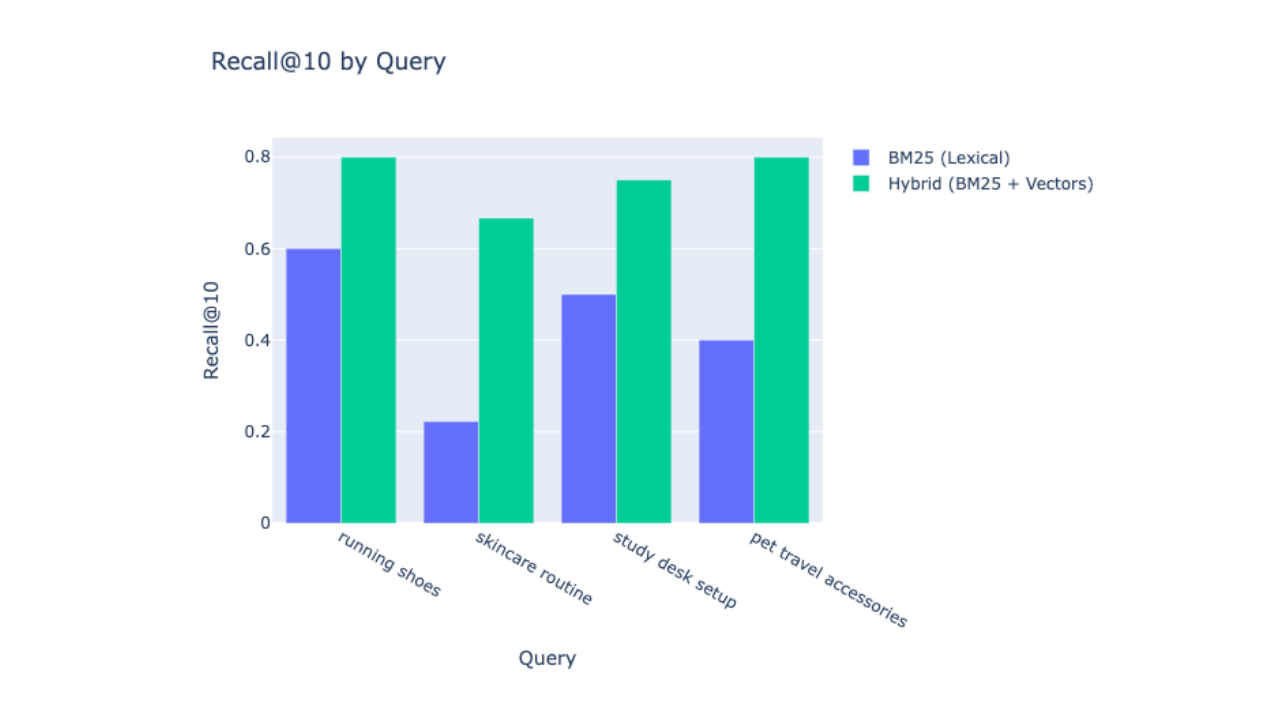
RAG:高密度ベクトル検索と低密度ベクトル検索でLLMに最適なコンテキストを取得するか、ベクトル検索と語彙検索の両方を組み合わせたハイブリッド検索を利用できます。生成結果の質は、検索結果の質に比例して向上します。
AIエージェント:マルチステップのエージェントループで求められる低レイテンシで、ドキュメントや会話記憶に対する高速でフィルタリングされた検索をエージェントに提供します。
セマンティック検索:1つのフィールドタイプとパイプラインコード不要で、キーワードではなく意味に基づいて一致させます。
レコメンデーションと類似性:製品、画像、その他あらゆるコンテンツにわたり、大規模なスケールで最近傍を検索できます。
ベクトルワークロードに必要なすべてを、すぐに使えるよう最適化
ベクトルベースのアプリケーションを構築するには、いくつかの個別の要素を連携させる必要があります。具体的には、埋め込みモデルの設定とホスティング、それらを用いたドキュメントのインデックス作成、ベクトルの効率的な保存、各クエリへの埋め込みモデルの適用、ベクトルストアとの照合、そして最後に、一致したドキュメントの取得です。Elasticsearch Vector Databaseは、追加の設定やセットアップなしで、これらすべてを自動的に処理します。
vectordb_documentインデックスモードを使用したベクトルのインデキシング
ベクトル優先ワークロード専用に設計された新しいインデックス構成であるvectordb_documentインデックスモードはデフォルトで有効になっており、エキスパートが選択するような設定が適用されます。以下が有効化されます。
デフォルトでbfloat16:ベクトルはfloat32の半分のサイズで格納され、再現率への影響はごくわずかで、量子化を適用する前の段階でもディスク使用量をほぼ半分に削減します。
ソースベクトルの除外:Elasticsearchでは、埋め込みはすでに検索に使用されるインデックス構造内に存在します。_sourceに未加工のコピーを重複して保持すると、ストレージを消費し、結果の取得が遅くなるだけです。重複を除外することで、レスポンスが高速化され、格納するデータ量を削減できます。
適切なファイルをキャッシュに事前読み込み:ベクトルクエリが最初にアクセスするデータ構造があらかじめメモリに読み込まれるされるため、1番目の(そして1,000番目の)クエリも超高速で実行されます。
並列マージ:マージによってセグメントがより整理されたベクトル構造に統合され、再現率とレイテンシーの両方が向上します。さらに、これらのマージをマルチスレッドで実行することで、より高速に完了できます。
ベクトルストレージ、圧縮、自動チューニング
ベクトルは自動的に圧縮されます。Better Binary Quantization(BBQ)により、再現率を維持しながらベクトルのメモリ・フットプリントを最大32倍削減できます。さらに、DiskBBQは大規模なワークロードのメモリ要件をさらに削減します。
自動キャリブレーションを有効にすると、各セグメントの量子化がデータに合わせて調整され、データのずれに応じてマージのたびに再調整されます。18種類のデータセットでテストを行った結果、1秒あたりのクエリ数(QPS)は平均16.7%向上し、そのほとんどで再現率も向上しました。
マネージドGPU推論での埋め込み
ネイティブのJina AIの埋め込みモデルとリランカーモデルで埋め込みを生成することも、サードパーティ製モデルを導入することもできます。いずれもElastic Inference Service(EIS)を介したマネージドGPUで実行でき、モデルサーバーを運用する必要はありません。または、ご自身でホストすることも可能です。
semantic_textフィールドタイプは、チャンキングと埋め込み、そしてクエリを自動的に処理し、市場で最もシンプルなセマンティック検索への道を提供します。
ハイブリッド検索とフィルタリングされたベクトル検索
ハイブリッド検索が組み込まれており、単一のクエリで全文検索とベクトル検索を組み合わせることができます。逆順位融合(RRF)やその他の任意のブレンドメカニズムを使用して結果を統合できます。通常、ベクトル検索はハイブリッド検索の中で適切に設定するのが最も難しい部分です。Elasticsearch Vector Databaseを使用すれば、その問題は解決し、ハイブリッドスタック全体の性能が向上します。
フィルタリングされたベクトル検索では、再現率を損なう後処理としてではなく、ベクトル検索自体の一部としてメタデータフィルタを適用できます。
初日からエンタープライズ対応
また、純粋なベクトルデータベースには一般的に備わっていない、ロールベースのアクセス制御(RBAC)、監査ログ、コンプライアンス認定も利用できます。
スケールしても手頃で予測可能
Elasticsearch Vector Databaseは、成長に合わせてコスト効率を維持できるように設計されています。ストレージを線形に保ち、メモリ使用量を低く抑えるBBQおよびDiskBBQ圧縮により、数千億のベクトルに拡張してもコストが急増することはありません。支払う料金は、格納するデータ量、作成するインデックス量、必要な検索容量など、すでに把握している数値に基づいて算出されます。ドキュメント数、ベクトルの次元数、クエリ負荷を見積もれば、プロジェクトを作成する前に料金を算出できます。月末には、請求内容を項目ごとに確認することもできます。不透明な計算ユニットはなく、バックグラウンド処理に対する予期せぬ料金も発生しません。
Elasticsearch Vector Databaseの利用開始方法
サーバーレスベクトルデータベースプロジェクトを作成する
Elastic Cloudで新しいサーバーレスVector Databaseプロジェクトを作成します。データをエンドポイントに向ければ、インデックスの準備は完了です。
semantic_textを使用したインデックスの作成
ベクトルインデックスモードは、ベクトルの構成を処理します。semantic_textを使用すると、マネージドGPU推論上でインデックス設定と同様に埋め込みやチャンキングの設定も自動的に管理されるため、埋め込みパイプラインを構築する必要はありません。
PUT my-vectors
{
"mappings": {
"properties": {
"description": { "type": "semantic_text" }
    }
  }
}
ドキュメントを投入する
テキストをインデックスすると、埋め込みが自動的に生成されます。
POST /my-vectors/_doc
{
  "id": "park_rocky-mountain",
  "title": "Rocky Mountain",
  "description": "Bisected north to south by the Continental Divide, this portion of the Rockies has ecosystems varying from over 150 riparian lakes to montane and subalpine forests to treeless alpine tundra."
}
セマンティック検索クエリを実行する
先ほど作成したセマンティックフィールドをクエリします。
GET /my-vectors/_search
{
  "query": {
    "semantic": {
      "field": "description",
      "query": "a mountain range in the middle of north america"
    }
  }
}
そして、結果が返されます。
{
  "took": 80,
  "hits": {
    "max_score": 0.7792325,
    "hits": [
      {
        "_index": "my-vectors",
        "_score": 0.7792325,
        "_source": {
          "id": "park_rocky-mountain",
          "title": "Rocky Mountain",
          "description": "Bisected north to south by the Continental Divide, ..."
        }
      }
    ]
  }
}セマンティック検索は始まりにすぎません。完全なテキストクエリを実行することも、両方を組み合わせてハイブリッドクエリにすることもできます。独自のベクトルクエリを作成して、完全に制御することもできます。詳しい手順については、ドキュメントのセマンティック検索クイックスタートをご覧ください。
Elasticsearchにおけるベクトル検索の今後
私たちは既に次の改善に取り組んでいます。
より優れたマルチテナント処理:テナントごとにデータを分離する必要がある場合、より少ないコードでより迅速に実現する方法を提供します。
インデックスの自動最適化:できるだけ手をかけずに、「新規作成直後のインデックス」から「完全に最適化済み」へ。
継続的なインフラストラクチャーの改善:Vector Databaseの設定とインフラストラクチャーを継続的に調整することで、常に最高のスループットと最速の対応を得られるようにします。
Elastic Cloud ServerlessでElasticsearchベクトルデータベースをお試しください
本番環境レベルのデフォルト設定がチューニングを行うため、空のプロジェクトから数分でフィルター適用済みのハイブリッドベクトルクエリを作成できます。インフラの構築ではなく、高速でスケーラブルなAIアプリの構築に専念しましょう。
Elastic Cloud Serverlessを開始するか、詳細ドキュメントとAPIリファレンスをご覧ください。
このコンテンツはどれほど役に立ちましたか?