Low-memory benchmarking in DiskBBQ and HNSW BBQ
Benchmarking Elasticsearch latency, indexing speed, and memory usage for DiskBBQ and HNSW BBQ in low-memory environments.
Introducing a new vector storage format: DiskBBQ
Introducing DiskBBQ, an alternative to HNSW, and exploring when and why to use it.
Deploying a multilingual embedding model in Elasticsearch
Learn how to deploy an e5 multilingual embedding model for vector search and cross-lingual retrieval in Elasticsearch.
Using TwelveLabs’ Marengo video embedding model with Amazon Bedrock and Elasticsearch
Creating a small app to search video embeddings from TwelveLabs' Marengo model.
Balancing the scales: Making reciprocal rank fusion (RRF) smarter with weights
Exploring weighted reciprocal rank fusion (RRF) in Elasticsearch and how it works through practical examples.
MCP for intelligent search
Building an intelligent search system by integrating Elastic's intelligent query layer with MCP to enhance the generative efficacy of LLMs.
Vector search filtering: Keep it relevant
Performing vector search to find the most similar results to a query is not enough. Filtering is often needed to narrow down search results. This article explains how filtering works for vector search in Elasticsearch and Apache Lucene.
Lighter by default: Excluding vectors from source
Elasticsearch now excludes vectors from source by default, saving space and improving performance while keeping vectors accessible when needed.
Beyond similar names: How Elasticsearch semantic text exceeds OpenSearch semantic field in simplicity, efficiency, and integration
Comparing Elasticsearch semantic text and OpenSearch semantic field in terms of simplicity, configurability, and efficiency.
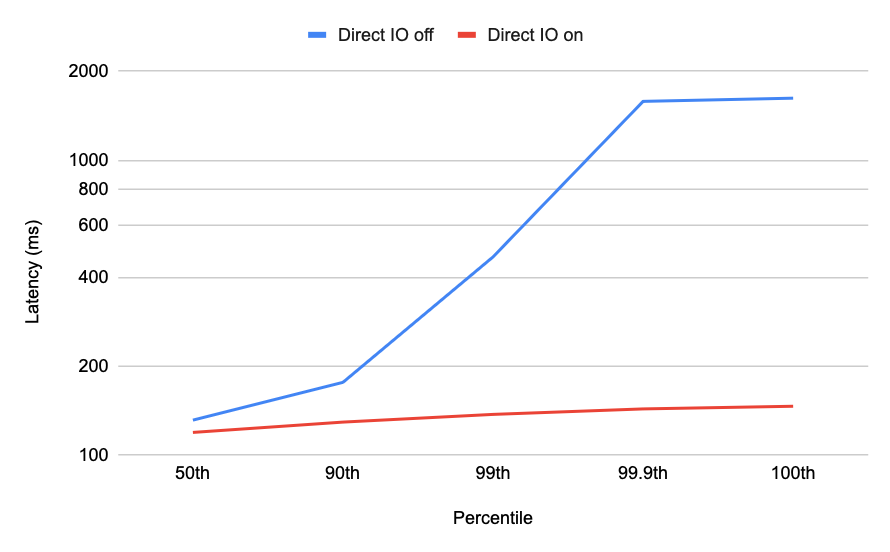
Using Direct IO for vector searches
Using rescoring for kNN vector searches improves search recall, but can increase latency. Learn how to reduce this impact by leveraging direct IO.
Elasticsearch now with BBQ by default & ACORN for filtered vector search
Explore how Elasticsearch's vector search now delivers better results faster, and at a lower cost.
Diversifying search results with Maximum Marginal Relevance
Implementing the Maximum Marginal Relevance (MMR) algorithm with Elasticsearch and Python. This blog includes code examples for vector search reranking.