Elasticsearch-Vektordatenbank: In Minuten bereitstellen, kostengünstig auf Hunderte Milliarden skalieren
Die schwierigen Aspekte des hybriden Abrufs, bereits erledigt. Optimierte Standardeinstellungen, Drittanbieter- und native Jina AI-Modelle sowie verwaltete GPU-Inferenz sind sofort einsatzbereit. Erstellen Sie schnelle, skalierbare KI-Apps, keine Infrastruktur.

Was sollte Ihre Vektordatenbank für Sie tun?


Elasticsearch-Vektordatenbank: Mehr als nur Vektoren, beliebt bei Entwicklern
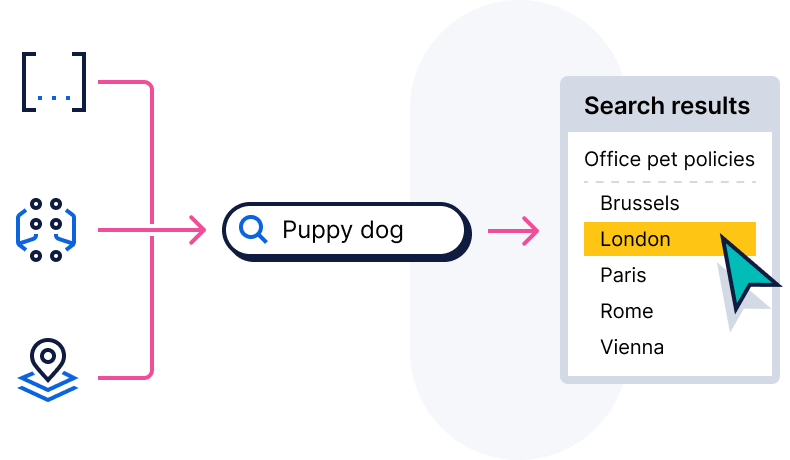
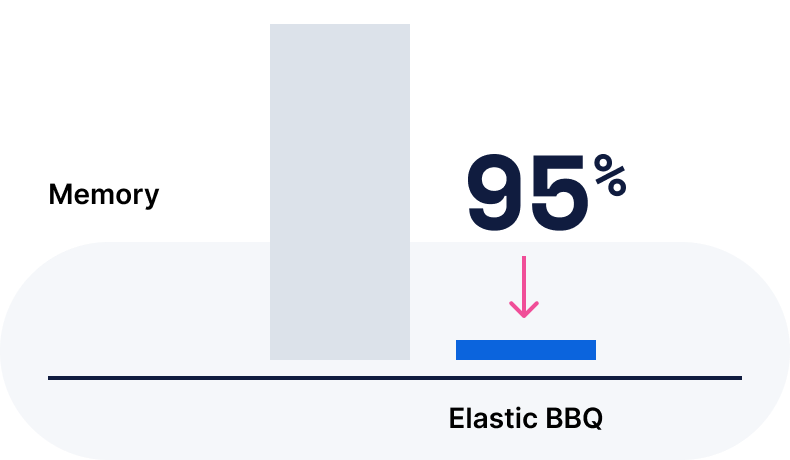
Keine Lücken, keine Kompromisse. Optimierte Standardeinstellungen. Hybrides Retrieval. Alles funktioniert zusammen, weil es so konzipiert wurde.
Ein Aufruf, das ist alles: Von null zur Vektorsuche in Minuten
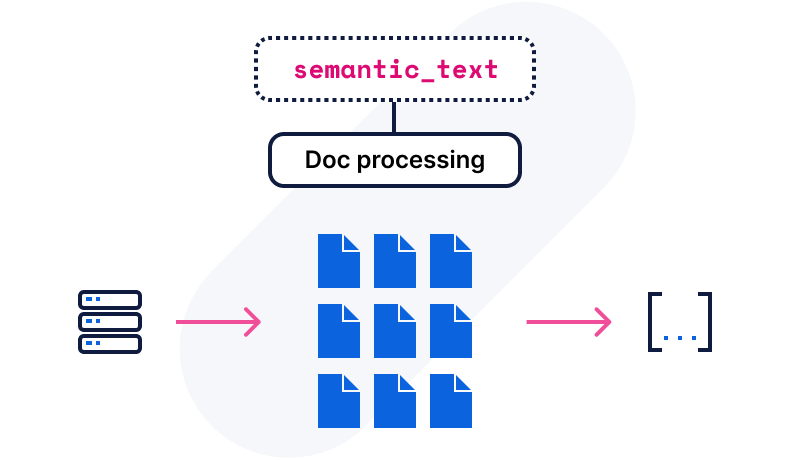
Erste Schritte mit der Elasticsearch-Vektordatenbank. Der schnellste Weg zur Vektorsuche mit Standardeinstellungen für Vektor-Workloads, Hybridsuche und die Möglichkeit, Einbettungen zu generieren oder eigene zu integrieren.
Bringen Sie Ihre Inhalte und überlassen Sie uns den Rest.
from elasticsearch import Elasticsearch

client = Elasticsearch(
   "https://xyz.elastic.cloud:443",
   api_key="..",

)

client.indices.create(
   index="my_semantic_vectors",
   mappings={
       "properties": {
           "content": {"type": "text", "copy_to": "semantic_content"},
           "semantic_content": {"type": "semantic_text"},
       }
   },
)

client.bulk(
   operations=[
       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Yellowstone National Park spans Wyoming, Montana, and Idaho, covering over 2.2 million acres. It is famous for the geyser Old Faithful and sits atop the Yellowstone Caldera, a supervolcano."},

       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Yosemite National Park covers over 750,000 acres in California. A UNESCO World Heritage Site, it is best known for its granite cliffs, waterfalls, and giant sequoia trees."},

       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Rocky Mountain National Park is known for its mountainous terrain, including Longs Peak, the highest in the park. It is a popular destination for hiking, camping, and wildlife viewing."},
   ],
)
from elasticsearch import Elasticsearch

client = Elasticsearch(
   "https://xyz.elastic.cloud:443",
   api_key="..",

)

client.indices.create(
   index="my_semantic_vectors",
   mappings={
       "properties": {
           "content": {"type": "text", "copy_to": "semantic_content"},
           "semantic_content": {"type": "semantic_text"},
       }
   },
)

client.bulk(
   operations=[
       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Yellowstone National Park spans Wyoming, Montana, and Idaho, covering over 2.2 million acres. It is famous for the geyser Old Faithful and sits atop the Yellowstone Caldera, a supervolcano."},

       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Yosemite National Park covers over 750,000 acres in California. A UNESCO World Heritage Site, it is best known for its granite cliffs, waterfalls, and giant sequoia trees."},

       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Rocky Mountain National Park is known for its mountainous terrain, including Longs Peak, the highest in the park. It is a popular destination for hiking, camping, and wildlife viewing."},
   ],
)
Entwickeln mit der Elasticsearch-Vektordatenbank


Vektordatenbank und was Sie sonst noch wirklich brauchen
Die Vektorsuche in der realen Welt benötigt mehr als Vektoren. Kombinieren Sie die semantische Suche mit Filtern, Sicherheit, strukturierten Feldern und BM25-Ranking in einer einzigen Abfrage, ohne dass Zusammenfügen erforderlich ist.

Eine hochwertige Nachbarschaft
Vom Prompt zum Produkt: Wie Teams mit der Elasticsearch-Vektordatenbank entwickeln.
Kunden-Spotlight
FRAIM nutzt Elasticsearch, um eine Wissenssuchplattform für das KI-Zeitalter zu entwickeln, konsolidiert nativ die Text- und Vektorsuche, um die Gesamtkosten für die Suchplattform um mehr als 50 % zu senken und die Entwicklung von RAG- und KI-Agenten erheblich zu beschleunigen.
Kunden-Spotlight
WP Engine nutzt Elasticsearch, um KI-Innovationen für WordPress-Websites bereitzustellen, und nutzt native Google Cloud-Integrationen, um die Entwicklungszeit für KI-Features von Wochen auf Stunden zu verkürzen und Suchreaktionszeiten von 5 ms ohne Betriebsausfallzeiten zu erzielen.
Kunden-Spotlight

Adobe skaliert, verwaltet mehrere Anwendungsfälle und setzt Machine-Learning-Funktionen mit Elastic ein.
Ergebnisse in Zahlen
Performance-Benchmarks und -Ergebnisse der Elasticsearch-Vektordatenbank.


Erste Schritte: Ressourcen für jede Phase der Entwicklung
Ingestieren, parsen und indexieren
Einbetten
Abrufen
Tools für Entwickler:innen
Einbetten
Abrufen
Tools für Entwickler:innen
Häufig gestellte Fragen
Was ist eine Vektordatenbank und wie funktioniert sie?
Was ist eine Vektordatenbank und wie funktioniert sie?
Eine Vektordatenbank speichert Informationen als Vektoren, also als numerische Darstellungen von Datenobjekten, die auch als Vektoreinbettungen bezeichnet werden. Sie verwendet Vektoreinbettungen für die multimodale Suche in einem riesigen Datensatz strukturierter, unstrukturierter und halbstrukturierter Daten, wie Bilder, Text, Videos und Audio. Vektordatenbanken werden zur Verwaltung von Vektoreinbettungen erstellt und bieten daher eine vollständige Lösung zur Datenverwaltung.
Was sind Vektoreinbettungen?
Was sind Vektoreinbettungen?
Vektoreinbettungen verwenden ein Machine-Learning-Modell, um Text in Zahlen zu übersetzen, wodurch Vektorsuchen durchgeführt werden können. Durch die Umwandlung von Daten in Vektoren erleichtern Einbettungen den Vergleich, die Suche und die Analyse von Ähnlichkeiten zwischen Elementen in diesem Bereich.
Was sind die Vorteile einer Vektordatenbank?
Was sind die Vorteile einer Vektordatenbank?
Eine Vektordatenbank bietet Effizienz bei der Skalierung, indem sie eine nahtlose Datenmigration zwischen On-Prem-, Air-Gapped- und souveränen Cloud-Umgebungen ermöglicht und Speicherplatz für Vektoreinbettungen bietet.
Vektordatenbanken eignen sich hervorragend für die Ähnlichkeitssuche. Sie ermöglichen es Ihnen, verwandte Objekte leicht zu finden, was für Empfehlungssysteme, die Bildersuche und die Entdeckung von Inhalten unerlässlich ist. Mit semantischen Suchfunktionen gehen sie über den einfachen Abgleich von Stichwörtern hinaus und liefern Ergebnisse auf Grundlage von Bedeutung und Kontext. Durch die Speicherung von Vektoreinbettungen unterstützen sie KI- und Machine-Learning-Anwendungen und erleichtern so die Bereitstellung von Modellen für Natural Language Processing (NLP) und Empfehlungen.
Ist Elasticsearch eine Vektordatenbank?
Ist Elasticsearch eine Vektordatenbank?
Ja, Elasticsearch ist die weltweit am weitesten verbreitete Open-Source-Vektordatenbank, die Ihnen effiziente Möglichkeiten bietet, Vektoreinbettungen in großem Maßstab zu erstellen, zu speichern und zu suchen. Mit der unternehmenstauglichen Vektordatenbank von Elastic erreichen Sie schnelle Abfragezeiten und optimale Leistung, selbst bei sich schnell ändernden Daten. Sie ist skalierbar, liefert relevante, personalisierte Suchergebnisse und vereinfacht gleichzeitig die Entwicklungsprozesse.
Warum sollten Sie Elastic als Ihre Vektordatenbank wählen?
Warum sollten Sie Elastic als Ihre Vektordatenbank wählen?
Elasticsearch ist die weltweit am häufigsten heruntergeladene Vektordatenbank – speziell dafür entwickelt, Entwickler:innen dabei zu unterstützen, hochpräzise Suchergebnisse und skalierbare KI-Erlebnisse schneller und kostengünstiger bereitzustellen. Die Elasticsearch-Vektordatenbank übernimmt die schwierigen Aspekte des hybriden Abrufs mit optimierten Standardeinstellungen, nativen Jina AI- und Drittanbieter-Modellen sowie verwalteter GPU-Inferenz – alles sofort einsatzbereit. Führen Sie Vektor- und Stichwortsuchen über Text-, Bild- und multimodale Daten hinweg in einem einzigen Index durch, ohne eine Pipeline für die Einbettung erstellen oder pflegen zu müssen. Sie wird für Vektor-Workloads vorkonfiguriert bereitgestellt, liefert eine hohe Performance, fängt Traffic-Spitzen automatisch ab und skaliert bei sinkendem Bedarf zurück. Erhalten Sie die Sicherheit, RBAC und Wiederherstellungspfade, die Sie erwarten, sodass Sie Apps erstellen, keine Infrastruktur.
Kann ich Elasticsearch als On-Prem- oder Air-Gapped-Vektordatenbank ausführen?
Kann ich Elasticsearch als On-Prem- oder Air-Gapped-Vektordatenbank ausführen?
Ja. Elasticsearch lässt sich vollständig On-Prem bereitstellen – auf Bare-Metal-Servern, in einer privaten Cloud oder in vollständig vom Internet abgeschotteten Netzwerken ohne externe Verbindung. Behörden, Rüstungsunternehmen und regulierte Betriebe nutzen Elastic Cloud Enterprise (ECE), um On-Prem-Elasticsearch-Cluster in großer Skalierung zu orchestrieren, auch in geheimen und isolierten Umgebungen. Alle in Elastic Cloud verfügbaren Suchfunktionen für Vektorsuche, Hybridsuche und RAG stehen auch in On-Prem-Deployments zur Verfügung.