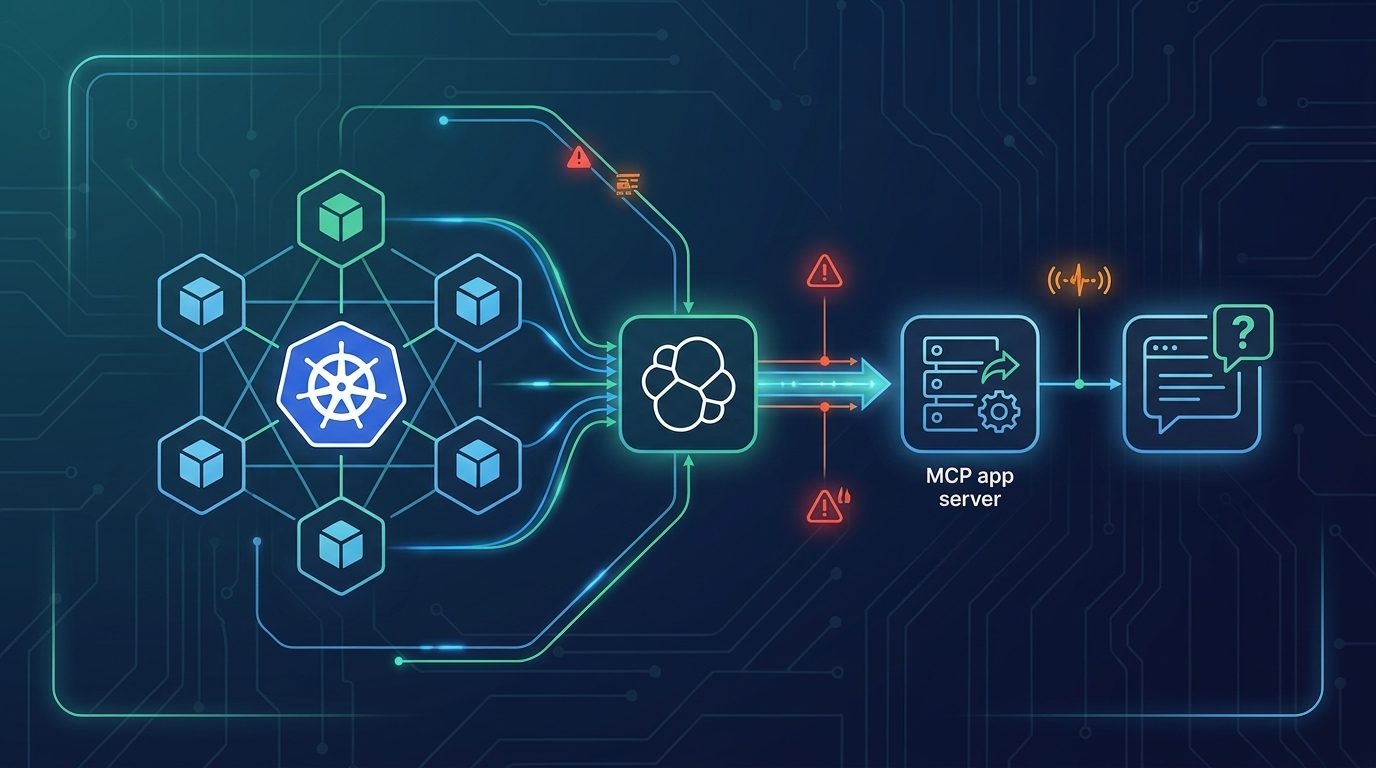
Elasticsearch: Erstklassig bei Protokollen, jetzt auch erstklassig bei Metriken
Elasticsearch ist jetzt auch bei Metriken erstklassig: 30-mal schneller als Prometheus, bis zu 2,5-mal speichereffizienter, 50 % günstiger als Datadog. Erfahren Sie mehr über all die Funktionen, die wir hinzugefügt haben.
Store high-cardinality metrics efficiently with time series data streams, and keep your Prometheus and PromQL workflows along for the ride.
Dig into infrastructure and metrics monitoring. Start a free cloud trial or try Elastic on your local machine now.
In den vergangenen Monaten hat Elastic eine speziell für Zeitreihendaten entwickelte spaltenorientierte Speicher-Engine in Elasticsearch, nativen Prometheus-Ingest und -Speicher sowie PromQL-Support bereitgestellt, und wir haben ein neues Erlebnis zur Erkundung von Metriken, vorgefertigte Infrastruktur-Dashboards, agentische Untersuchungen und einen Migrationspfad von Datadog und Grafana bereitgestellt. Zu den Funktionen gehören jetzt:
-
Elasticsearch ist ein Prometheus-kompatibles Metrik-Backend – Prometheus Remote Write und PromQL funktioniert jetzt nativ in Kibana, keine Übersetzungsschicht erforderlich.
-
Metriken landen in der spaltenorientierten TSDS-Architektur von Elasticsearch und speichern Daten bis zu 2,5 × effizienter als Prometheus sowie 2 × effizienter als ClickHouse.
-
ES|QL-Zeitreihenabfragen werden bis zu 30 × schneller ausgeführt als bei Prometheus bei Gauge-Durchschnittswerten und Counter-Raten, einschließlich Workloads mit hoher Kardinalität.
-
Elastic kostet ungefähr 50 % weniger als Datadog – ohne Klassifizierung benutzerdefinierter Metriken und ohne kardinalitätsbasierte Abrechnung.
-
Grafana kann Elasticsearch direkt über die native Prometheus-API abfragen, wobei Sie Ihre Visualisierungsebene beibehalten, während das Backend ersetzt wird.
-
Kubernetes- und AWS-Überwachung werden mit vorab erstellten Dashboards, Alert-Vorlagen, ML-Anomaliejobs und Inhalten für agentische Untersuchungen bereitgestellt, die direkt beim Ingest bereitstehen. Zusätzlich sind Skills und MCP-Apps verfügbar.
-
Einheitliches Backend für Metriken, Logs und Traces, das agentische Untersuchungen ermöglicht, ohne Kontext über Tools hinweg zusammenzusetzen.
-
Die Erkundung von Metriken in Discover ermöglicht es jedem, sofort mit dem Abfragen und Analysieren von Metriken zu beginnen, ohne dass Abfragesprache-Kenntnisse erforderlich sind.
-
Individuell anpassbare Dashboards lassen sich schnell und flexibel erstellen – Dashboards-as-Code, KI-gestützte Dashboard-Erstellung, Steuerelemente für Variablen und einklappbare Bereiche bedeuten weniger Zeitaufwand für die Erstellung und mehr Zeit für die Untersuchung.
-
Migrationstools zur einfachen Migration von Dashboards und Alerting-Regeln/Monitoren aus Datadog und Grafana.
Elasticsearch-Metriken konkurrieren jetzt in jeder für SREs wichtigen Dimension: Sie können es sich leisten, jede Metrik in voller Auflösung aufzubewahren, sie bis zu 30 x schneller als Prometheus abzufragen, 50 % weniger als bei Datadog zu zahlen, Dashboards und Alerting-Regeln einfach von Grafana oder Datadog zu migrieren und von einem Alert zur Grundursache zu gelangen, ohne Kontext zwischen nicht verbundenen Tools zusammenführen zu müssen. Im weiteren Verlauf dieses Blogposts werden die einzelnen dieser Punkte ausführlich erläutert.
Elasticsearch-Metrik-Performance: 30 × schneller als Prometheus und Mimir
Datadog und Prometheus erzwingen denselben Kompromiss: Daten mit hoher Kardinalität verwerfen oder zusehen, wie die Kosten in die Höhe schnellen. SREs, die Kubernetes, AWS oder eine beliebige Infrastruktur mit hoher Kardinalität verwalten, kennen die genaue Ausprägung dieses Problems. Die Kubernetes-Labels, ephemeren Pod-Daten und feingranularen OTel-Dimensionen, die bei einem Vorfall am wichtigsten sind, müssen als Erstes weichen, wenn die Budgets knapper werden.
Elastic hat den Zeitreihendaten-Speicher und die ES|QL-Compute-Engine zu einer vollständig spaltenorientierten Metriken-Engine umgebaut. Das Hinzufügen eines neuen Kubernetes-Labels, eines neuen AWS-Instanz-Tags oder einer neuen Anwendungsdimension belastet das System nicht; es verursacht weit geringere Kosten als Systeme, die jedes Label indexieren. OTel-, Prometheus- und anwendungsdefinierte Metriken landen alle in voller Auflösung im selben spaltenorientierten Backend – mit Logs, Traces und Metriken in einem einzigen Speicher. Keine Daten verworfen, keine Aufbewahrungsdauer verkürzt.
Elasticsearch speichert Metriken bis zu 2,5-mal effizienter als Prometheus (Ergebnisse können aufgrund von Faktoren wie Kompaktierung abweichen) und 2-mal effizienter als ClickHouse. Die Abfrageleistung über ES|QL ist bis zu 30-mal schneller als Prometheus bei Gauge-Durchschnittswerten und Counter-Raten, einschließlich Workloads mit hoher Kardinalität, bei denen Mitbewerber ins Stocken geraten. Der Architekturbeitrag beschreibt, wie TSDS aufgebaut ist und warum das spaltenbasierte Layout diese Ergebnisse liefert.
| Dimension | vs. Prometheus | vs. Mimir | vs. ClickHouse |
| Abfrageleistung (ES | QL) | Bis zu 30 × schneller | Bis zu 30 × schneller |
| Speichereffizienz | Bis zu 2,5-mal besser | Gleichauf | 2-mal besser |
Der wesentliche architektonische Unterschied besteht darin, dass Elasticsearch-Metriken keinen In-Memory-Zustand pro Zeitreihe pflegen, der mit der Kardinalität skaliert, sodass das Hinzufügen von Tausenden neuer Kubernetes-Pod-Labels oder OTel-Dimensionen den Arbeitsspeicherdruck nicht in die Höhe treibt.
OTel-, Prometheus-native und anwendungsdefinierte Metriken werden alle auf dieselbe Weise in voller Auflösung gespeichert und schnell abgefragt – zur Hälfte der Kosten von Datadog.
Preise für Elastic Observability-Metriken ohne die Gebühren für benutzerdefinierte Metriken von Datadog
Die Kosten für Beobachtbarkeit sind der Grund Nr. 1, warum Teams die Plattform wechseln. Für Datadog-Kunden lässt sich das Problem auf einen einzigen Preismechanismus zurückführen: benutzerdefinierte Metriken. Jeder benutzerdefinierte Wert außerhalb der integrierten Integrationen von Datadog wird als benutzerdefinierte Metrik eingestuft und zu einem höheren Tarif abgerechnet. Dazu gehören auch die Daten mit hoher Kardinalität, die von Kubernetes-, OpenTelemetry- und cloudnativen Workloads standardmäßig generiert werden. Je granularer Ihre Instrumentierung ist, desto schneller summieren sich die Kosten. Teams, die moderne Infrastruktur betreiben, stoßen schnell an diese Grenze, und die Reaktion ist vorhersehbar: Daten verwerfen, Aufbewahrungsfristen verkürzen, den Kontext verlieren, der bei einem Vorfall am wichtigsten ist.
Elasticsearch-Metriken heben diese Klassifizierung auf. Jede Metrik kostet gleich viel – ganz ohne Aufschläge pro Metrik, ohne kardinalitätsbasierte Abrechnung und ohne erzwungene Rollups. Sie behalten jede Metrik in voller Auflösung – ohne Überraschungsrechnung am Monatsende. Und da Elastic nur 50 % der Kosten von Datadog ausmacht, ändert sich das Gespräch mit der Finanzabteilung: Es geht nicht mehr darum, welche Daten Sie verwerfen mussten, um das Budget einzuhalten, sondern darum, was Sie herausgefunden haben, weil Sie alles behalten haben. Das ist auch der Grund, warum die KI-Untersuchung funktioniert. Im Gegensatz zum fragmentierten LGTM-Stack von Grafana ist der Kontext bereits vereinheitlicht, wenn der Alert ausgelöst wird, und muss nicht manuell über voneinander getrennte Tools hinweg zusammengestellt werden.
Native Unterstützung von Prometheus und PromQL in Elasticsearch
Die meisten SRE-Teams betreiben keine saubere Telemetrie-Pipeline mit einheitlichem Format. Prometheus ist tief in Anwendungen, Services, Plattformen und Automatisierungen eingebettet. Die Migration von Metrik-Backends bedeutete in der Vergangenheit das Neuschreiben von Abfragen, das Neuerstellen von Dashboards und die Umschulung von Engineers – Reibungsverluste, die so groß sind, dass Teams lieber auf Plattformen bleiben, aus denen sie herausgewachsen sind, anstatt diesen Prozess zu durchlaufen.
Elasticsearch-Metriken haben den Großteil dieser Reibungspunkte beseitigt. Prometheus-Metriken treffen über Prometheus Remote Write ein und landen ohne semantische Änderungen im selben spaltenorientierten Speicher, wodurch die vollständige Metrikgenauigkeit durchgängig erhalten bleibt. Richten Sie sie auf Elasticsearch statt auf Mimir aus, und die Daten fließen. Keine Übersetzungsebene, keine Änderungen an bestehenden Scrape Configs.
PromQL funktioniert jetzt nativ in Kibana, sodass Entwickler, die mit PromQL arbeiten, ihre Arbeitsweise nicht ändern müssen. Bestehende PromQL-Abfragen, Dashboards und Alert-Regeln werden direkt in Kibana migriert.
PromQL-Abfragen funktionieren unverändert auf Elasticsearch
Wenn Ihr Team bereits PromQL schreibt, muss sich nichts ändern. Diese Abfragen werden unverändert für Elasticsearch als Ihr Backend ausgeführt – einfach kopieren, einfügen und loslegen.
CPU-Auslastungsrate (auf Container-Ebene) Die CPU-Rate pro Sekunde über alle Container hinweg, gruppiert nach Pod. Nützlich, um zu erkennen, welche Pods während eines Vorfalls CPU verbrauchen.
PROMQL sum by (pod) (rate(container_cpu_usage_seconds_total[5m]))
Arbeitsspeicher-Arbeitssatz (Container-Ebene) Derzeit aktiv genutzter Arbeitsspeicher pro Container – der entscheidende Wert für das OOM-Risiko, nicht der gesamte zugewiesene Arbeitsspeicher.
PROMQL sum by (container) (avg_over_time(container_memory_working_set_bytes[5m]))
HTTP-Anforderungsrate (auf Anwendungsebene) Anfragendurchsatz pro Sekunde, gruppiert nach Instanz. Ein standardmäßiges erstes Signal bei der Untersuchung von Latenz- oder Fehlerspitzen.
PROMQL sum by (instance) (rate(http_requests_total[5m]))
Alle drei folgen der standardmäßigen PromQL-Syntax. Wenn Sie Elasticsearch als Ihr Backend verwenden, werden sie ohne Änderungen ausgeführt. Die vollständige Syntaxreferenz und Informationen über den abgedeckten Umfang finden Sie in der PromQL-Support-Dokumentation.
Die native Prometheus-API macht Elasticsearch zu einem vollständig Prometheus-kompatiblen Backend. Jedes Prometheus-kompatible Frontend (einschließlich Grafana) kann Elasticsearch direkt abfragen, sodass Teams, die Grafana als ihre Visualisierungsebene beibehalten und gleichzeitig auf Elasticsearch konsolidieren möchten, genau das tun können, ohne bestehende Dashboards oder Alert-Regeln zu ändern.
Wenn SREs tiefer einsteigen müssen, als PromQL erlaubt, funktioniert ES|QL über Metriken, Logs und Traces hinweg in einer einzigen Schnittstelle. Der Befehl „TS“ übernimmt die Besonderheiten von Zeitreihen: Counter-Raten, Gauge-Durchschnittswerte, Zeitfensterfunktionen und mehrstufige Aggregationen über hochkardinale Dimensionen hinweg. Dieselbe Abfrage, die eine CPU-Counter-Rate abruft, kann mit Logs desselben Hosts verknüpft werden und das Deployment-Ereignis anzeigen, das der Spitze vorausging. Kein Wechsel des Tools, keine neue Abfragesprache. Die Abfragesprache, die Dashboards, die Alert-Regeln, die Visualisierungsebene – all das wird übernommen. Das Einzige, was sich ändert, ist, dass Elasticsearch das einzige Backend ist, das alles antreibt.
Elastic Observability: Dashboards, Alerts und Infrastrukturinhalte out of the box
Bei den meisten Beobachtbarkeit-Anbietern müssen Sie alles von Grund auf neu erstellen. Elastic Observability hat diesen Bedarf in drei Bereichen reduziert:
Erkundung von Metriken in Discover. Die neue Erfahrung bei der Erkundung von Metriken in Elasticsearch ermöglicht es SREs, Metriken auf derselben Schnittstelle zu erkunden, die auch für Logs verwendet wird – kein Tab-Wechsel, keine doppelten Abfragen. Verbinden Sie eine OTel-Pipeline oder Prometheus Scrape Config, öffnen Sie Streams, und jede Metrik im Datenstrom wird sofort als Zeitreihendiagramm dargestellt. Kein Dashboard zu erstellen, keine Abfrage zu schreiben. Hier können Teams Daten validieren, Muster erkennen, anhand einer Live-Ansicht der fließenden Daten Alerts und SLOs erstellen und diese mit Logs, Traces und anderen indexierten Daten in Elasticsearch querverknüpfen.
Dashboards. Kibana-Dashboards verfügen jetzt über einklappbare Panels mit verzögertem Laden, sodass nicht unmittelbar sichtbare Panels erst bei Bedarf Abfragen generieren, sowie über ES|QL-Steuervariablen, mit denen SREs Visualisierungen über Dropdown-Menüs manipulieren können, ohne neue Abfragen zu schreiben. Dashboards-as-code wird ebenfalls bereitgestellt und ermöglicht versionskontrollierte Dashboard-Definitionen, die als Vorlagen verwendet, geteilt und programmatisch umgebungsübergreifend bereitgestellt werden können.
Vorkonfigurierte Infrastrukturinhalte. Elastic wird mit zwei neuen Infrastruktur-OOTB-Erlebnissen bereitgestellt:
- Die neue Kubernetes-Integration wird mit hierarchischen Dashboards, Vorlagen für Alert-Regeln, Jobs zur ML-Anomalieerkennung sowie dem Kontext und den Prompts bereitgestellt, die für eine KI-gestützte Ursachenanalyse erforderlich sind – alles vorkonfiguriert und einsatzbereit, sobald Daten fließen.
- Das AWS-Infrastruktur-Monitoring folgt demselben Muster: OOTB-Inhalte für Kern-AWS-Services werden beim Ingest aktiviert, sodass Teams nicht jedes Mal bei null anfangen müssen, wenn ein neuer Service oder Account online geht. Derselbe Ansatz gilt auch für Datenbanken und andere Kerninfrastruktur – die Plattform wird vorkonfiguriert und nicht als leere Leinwand geliefert.
Agentische Untersuchungen über Ihre Infrastruktur hinweg mit Elastic Observability
Elasticsearch korreliert Metriken, Logs und Traces in einem einzigen Backend, sodass der Untersuchungskontext zusammengestellt ist, bevor ein Engineer benachrichtigt wird.
Der schwierige Teil ist 2 Uhr morgens. Eine RDS-Instanz, die an Verbindungslimits stößt und vorgelagerte Dienste aushungert. Eine Auto-Scaling-Gruppe, die Health-Checks aus einem Grund nicht besteht, der tief in den Anwendungs-Logs verborgen ist. Ein Pod-Neustart, der sich kaskadierend über einen Namespace ausbreitet.
In einem Grafana-LGTM-Stack öffnen Sie drei Tabs, bevor Sie genügend Kontext haben, um eine Hypothese aufzustellen.
In Datadog ist der Kontext einheitlich, aber die KI ist eine Blackbox: kein BYO-LLM, keine Optionen für Datenresidenz.
In Elastic teilen sich Metriken, Logs und Traces ein einziges Backend und ein gemeinsames Schema, sodass der Untersuchungskontext bereits zusammengestellt ist, wenn der Alert ausgelöst wird – keine manuelle Korrelation über Tools hinweg, kein Kontextverlust bei der Übersetzung zwischen Abfragesprachen. Die ML-Anomalieerkennung wird automatisch für Infrastrukturmetriken (Kubernetes, AWS, Datenbanken) ausgeführt, sodass die Untersuchung von einer bewerteten Anomalie mit Kontext dazu ausgeht, was typisch ist, was sich geändert hat und wie schwerwiegend die Abweichung ist, und nicht nur von einer einfachen Schwellenwertüberschreitung.
Wenn ein Alert ausgelöst wird, korreliert der Untersuchungs-Workflow von Elastic Signale, stellt den Kontext zur Ursache zusammen und zeigt empfohlene nächste Schritte an, bevor jemand alarmiert wird. Der Beitrag zur agentischen Kubernetes-Beobachtbarkeit führt durch ein vollständiges End-to-End-Beispiel. Der Leitfaden zur EKS-Fehlerbehebung zeigt, wie Agent Builder und MCP für eine vollständige Ursachenanalyse über EC2, EKS und zugehörige AWS-Services hinweg zusammenarbeiten.
Zusätzlich zur Untersuchung von Problemen in Elastic Observability können Sie Claude, Cursor, VS Code oder Ihr bevorzugtes Tool verwenden, um Probleme mithilfe von MCP-Apps und Agent-Skills von Elastic zu analysieren. Die Observability MCP-App erweitert die Analyse dorthin, wo Ihr Team bereits arbeitet. Wenn Ihr Team Untersuchungen in Claude, Cursor oder VS Code durchführt, werden dieselben Untersuchungsfunktionen (Infrastruktur-Zustands-Rollup, Dienstabhängigkeitsgraph, Anomaliedetails, Schadensradius-Analyse) als interaktive Ansichten direkt in der Konversation gerendert. Weder Grafana noch Datadog bieten dies.
- Observability MCP App – Verbindet Claude, Cursor, VS Code oder jedes MCP-kompatible Tool direkt mit Ihren Elasticsearch-Daten, sodass Infrastrukturzustand, Serviceabhängigkeiten und Anomaliekontext als interaktive Ansichten in der Konversation erscheinen, ohne dass Sie das Tool Ihrer Wahl verlassen müssen. Erfahren Sie, wie es mit Kubernetes funktioniert.
- Agent-Skills – Vorgefertigte Skills für Kubernetes, AWS und andere Kerninfrastruktur ermöglichen jedem Agenten – in Elastic oder Ihrem eigenen –, strukturierte Untersuchungen Ihrer Beobachtbarkeitsdaten ohne individuelles Prompt-Engineering. Fügen Sie sie in Claude, Cursor oder Ihre eigene Agenten-Pipeline ein, und sie funktionieren out of the box. Entdecken Sie die Beobachtbarkeit-Skills oder durchsuchen Sie die Skills-Bibliothek auf GitHub.
Migration von Datadog oder Grafana zu Elastic Observability
Der häufigste Grund, warum SRE-Teams die Beobachtbarkeitsplattform nicht wechseln, ist die Migration. Die Migration von Alert-Regeln aus mehreren Jahren, Hunderten von Dashboards und in Runbooks eingebetteten PromQL-Abfragen ist eine gewaltige operative Aufgabe, und die Kosten für die Pflege paralleler Stacks währenddessen summieren sich von Tag zu Tag.
Die Observability Migration Platform übernimmt die Übersetzung automatisch. Verweisen Sie die CLI oder Claude/Cursor (mit den Agent-Skills von Elastic) auf Ihre Datadog-Organisation oder Grafana-Instanz und das Tool konvertiert unterstützte Dashboards, Alert-Regeln und PromQL-Abfragen in Kibana-native Ausgaben. Mit dem Tool können Sie sehen, was vollständig migriert wurde, was Anpassungen erforderte und was Ihrerseits erforderlich ist, um alles zu migrieren. Sie übertragen das, was Sie bereits erstellt haben.
Auf der Ingest-Seite sorgt Prometheus Remote Write dafür, dass die Pipeline keine Änderungen erfordert. Scrape Configs verweisen auf Elasticsearch anstelle eines anderen Prometheus-kompatiblen Backends, und die Daten landen im selben spaltenorientierten Speicher. Workflows, Abfragen und Alert-Konfigurationen werden ohne Änderungen übernommen. Für Teams, die Grafana während oder nach der Migration als Visualisierungsebene beibehalten möchten, bedeuten die native Prometheus-API und die PromQL-Unterstützung in Kibana, dass der Übergang schrittweise erfolgen kann, anstatt alles auf einmal umzustellen.
Elasticsearch als Backend für Grafana
Für Teams, die noch nicht bereit sind, Grafana zu verlassen, ist das Ersetzen des Backends ein eigenständiger Migrationspfad, und abhängig von Ihrem Workflow gibt es zwei Möglichkeiten, dies zu tun.
Wenn Ihr Team heute Prometheus ausführt, ist die Prometheus-Datenquelle von Grafana der Weg des geringsten Widerstands. Elasticsearch bietet jetzt eine native Prometheus-kompatible API, sodass Sie das vorhandene Prometheus-Plugin von Grafana direkt auf Elasticsearch verweisen können. Keine Sidecars, keine Adapter, keine Pipeline-Änderungen erforderlich. Bestehende PromQL-Dashboards, Alert-Regeln und Variablen-Dropdowns funktionieren ohne Anpassung, einschließlich des Metrics Drilldown-Explorers von Grafana. Fügen Sie Elasticsearch als „remote_write“-Ziel in Ihrer Prometheus-Konfiguration hinzu und tauschen Sie die Datenquellen-URL aus. Das ist für die meisten Teams bereits die gesamte Migration. Sehen Sie sich die End-to-End-Einrichtungsanleitung an.
Für Teams, die noch weiter gehen und Protokolle, Metriken und Traces gemeinsam über einen einzigen Grafana-Abfrage-Editor abfragen möchten, wird das offizielle Grafana-Elasticsearch-Plugin jetzt mit ES|QL-Support bereitgestellt. Dies ermöglicht signalübergreifende Korrelationen direkt in Grafana, wobei Elasticsearch alle drei Datentypen in einem einheitlichen spaltenbasierten Backend verarbeitet. Erfahren Sie, wie Sie es einrichten.
So oder so behalten Sie Grafana bei, ersetzen Mimir und Loki und profitieren darunter vollständig von dem spaltenbasierten Speicher und der Abfrageleistung von Elasticsearch. Jahre operativer Arbeit – bewahrt. Die Migration, die die Teams bisher aufgeschoben haben, wird zu einem Backend-Wechsel.
Was ist GA und was befindet sich in der technischen Vorschau
| Funktionalität | Status |
|---|---|
| Engine für spaltenorientierte Metriken (TSDS) | GA |
| ES | QL-Zeitreihenunterstützung |
| PromQL-Support in Kibana | GA |
| Prometheus Remote Write-Ingest | GA |
| OOTB-Erlebnis für Kubernetes-Infrastruktur | GA |
| OOTB-Erlebnis für AWS-Infrastruktur | Technische Vorschau |
| Observability MCP-App | Technische Vorschau |
| Agent-Skills | Technische Vorschau |
| Observability Migration Platform | Technische Vorschau |
Die einzelnen im Text verlinkten Beiträge behandeln die Besonderheiten von GA im Vergleich zur Vorschau sowie bekannte Einschränkungen.
All das (die Columnar-Metrics-Engine, natives PromQL, agentische Untersuchungen und Migrationstools) läuft über die drei Deployment-Modi von Elastic: serverless, Elastic Cloud und selbstverwaltet. Datadog bietet keine On-Prem-Option; Grafana Cloud beschränkt seine wertvollsten Features auf gehostete Deployments. Mit Elastic entscheiden Sie, wo Ihre Daten gespeichert sind.
Elastic Observability: geringere Kosten ohne Datenverlust
Moderne Cloud-Infrastruktur hat das Beobachtbarkeitsmodell, das auf separaten Tools für separate Signale basiert, zunichtegemacht. Die Kosten sind beträchtlich: doppelte Tool-Rechnungen, manuelle Korrelation während Vorfällen und verworfene Daten, nur um im Budget zu bleiben.
Ein einziges Backend, das jedes Signal effizient speichert, bedeutet, dass Sie alles behalten, was Sie benötigen, ohne die damit üblicherweise verbundenen Kosten. Das ist eine andere Art von Gespräch mit der Finanzabteilung: nicht „Wir mussten Daten verwerfen, um im Budget zu bleiben“, sondern „Das haben wir herausgefunden.“ Die KI bekommt das Gesamtbild, weil es nur ein einziges Bild gibt, und die Plattform bietet genügend vorgefertigte Inhalte, um vom ersten Tag an nützlich zu sein – nicht erst nach wochenlanger Dashboard-Arbeit.
Das ist möglich, weil Elasticsearch anders aufgebaut ist als die Plattformen, die Sie wahrscheinlich ersetzen:
-
Spaltenorientierter Metrikspeicher speichert Metrikdaten hocheffizient im TSDS-Indexmodus.
-
Native Prometheus-Kompatibilität bedeutet, dass bestehende Scrape Configs, PromQL-Abfragen und Dashboards ohne Umschreiben funktionieren.
-
Vereinheitlichte Metriken, Logs und Traces in einem einzigen Backend bedeuten, dass der Untersuchungskontext zum Abfragezeitpunkt zusammengestellt wird und nicht manuell über mehrere Tabs hinweg.
-
Suche und Analytik in derselben Engine — ein invertierter Index für Logs, ein spaltenbasierter Index für Metriken, gemeinsam abgefragt mit ES|QL.
-
Agentische Untersuchungen, die Signale korrelieren, Anomalien aufdecken und Abhilfemaßnahmen vorschlagen, bevor jemand alarmiert wird.
-
Serverlos, Elastic Cloud oder selbstverwaltet – Sie entscheiden, wo Ihre Daten liegen, was Datadog nicht bieten kann.
Das Kostengespräch mit der Finanzabteilung dreht sich um das, was Sie gefunden haben, nicht um das, was Sie ausgegeben haben.
Erste Schritte
Häufig gestellte Fragen
Ist Elasticsearch jetzt eine produktionsreife Metrikplattform?
Ja. Seit Juni 2026 bietet Elasticsearch eine neu entwickelte spaltenorientierte Speicher-Engine, die speziell für Zeitreihendaten konzipiert wurde, nativen Prometheus Remote Write-Ingest, PromQL-Unterstützung in Kibana, ES|QL-Zeitreihenabfragen sowie sofort einsatzbereite Infrastruktur-Dashboards für Kubernetes und AWS. Die spaltenorientierte Metrik-Engine, die ES|QL-Zeitreihenunterstützung, PromQL und der Prometheus-Ingest sind in Elastic Serverless allgemein verfügbar und bald GA in Elastic Cloud Hosted.
Wie schneidet Elasticsearch im Vergleich zu Datadog hinsichtlich der Metrikkosten ab?
Bei vergleichbaren Metrik-Workloads kostet Elastic Observability Serverless deutlich weniger als Datadog – in anschaulichen Beispielen auf Basis veröffentlichter Listenpreise mehr als 50 % weniger und oft fast zwei Drittel weniger. Der Unterschied ist strukturell bedingt: Datadog rechnet primär pro Host ab und berechnet mit zunehmender Instrumentierung zusätzliche Gebühren für benutzerdefinierte Metriken und Container. Der Kostenunterschied ist genau bei den Workloads am größten, bei denen Datadog am meisten abrechnet: Umgebungen mit hoher Kardinalität und dichter Instrumentierung wie Kubernetes und OTel.
Wie schneidet die Metrik-Performance von Elasticsearch im Vergleich zu Prometheus und Grafana Mimir ab?
ES|QL-Abfragen auf Elasticsearch werden bei Gauge-Durchschnitten und Counter-Raten, einschließlich Workloads mit hoher Kardinalität, bis zu 30 × schneller ausgeführt als auf Prometheus und Mimir. Elasticsearch speichert OTel-Metriken mit 3,75 Bytes pro Datenpunkt; bis zu 2,5 × effizienter als Prometheus und 2 × effizienter als ClickHouse.
Können Teams von Datadog oder Grafana zu Elasticsearch migrieren, ohne alles neu aufzubauen?
Ja. Die Observability Migration Platform von Elastic konvertiert Dashboards und Alert-Regeln von Datadog und Grafana und migriert PromQL-Abfragen unverändert nach Kibana. Teams können Grafana auch als Visualisierungsebene beibehalten und gleichzeitig das Backend durch Elasticsearch ersetzen, indem sie die native Prometheus-API und den PromQL-Support in Kibana nutzen.
Was unterscheidet Elasticsearch von Grafana bei der Metrik-Beobachtbarkeit?
Elasticsearch speichert Metriken, Logs und Traces in einem einzigen einheitlichen Backend mit einer Abfragesprache (ES|QL), während der LGTM-Stack von Grafana Metriken (Mimir/Prometheus) und Logs (Loki) auf separate Backends verteilt, die separate Abfragesprachen erfordern. Elasticsearch stellt zudem agentische Untersuchungsfunktionen bereit, darunter KI-Agent, Workflows, MCP-App und Agent-Skills – ein umfassenderes Funktionspaket als Grafana.
Unterstützt Elasticsearch Prometheus und PromQL nativ?
Ja, auf zwei unterschiedliche Arten. Erstens akzeptiert Elasticsearch Prometheus-Metriken über Prometheus Remote Write und macht eine native Prometheus-kompatible API verfügbar, sodass es als Backend für jedes Prometheus-kompatible Frontend – einschließlich Grafana – dienen kann. Zweitens unterstützt Kibana PromQL nativ, sodass bestehende Abfragen, Dashboards und Alert-Regeln direkt in Kibana ohne Übersetzungsschicht oder Anpassungen ausgeführt werden können.
Welche Inhalte für das Infrastruktur-Monitoring werden out of the box mit Elastic Observability bereitgestellt?
Elastic stellt vordefinierte Dashboards, Alert-Vorlagen und ML-Anomalieerkennungsjobs für Hunderte von Infrastrukturintegrationen bereit, die Hosts, Container, Cloud-Dienste, Datenbanken, Netzwerkgeräte und mehr abdecken. Speziell für Kubernetes und AWS umfasst die Plattform zudem Inhalte für agentische Untersuchungen wie Agent-Skills und eine Observability MCP-App, mit der Teams Untersuchungen direkt über Claude, Cursor oder VS Code ausführen können. All dies ist beim Ingest verfügbar, ohne dass eine Konfiguration erforderlich ist.
Wie hilfreich war dieser Inhalt?
Zugehörige Inhalte