ES|QL Joinが登場しました!ついにJoinが使えます!
Elasticsearch 8.18には、ES|QLのLOOKUP JOINコマンドが含まれています。これは、当社初のSQLスタイルのJOINコマンドです。

 Share on Twitter
Twitter

 Share on LinkedIn
リンクトイン

 Share on Facebook
Facebook

 Share by Email
メール

 Print this page
印刷
Elasticsearch 8.18には、最初のSQLスタイルの結合であるES|QLのLOOKUP JOINコマンドが含まれています。現在はテクニカルプレビュー段階で、簡単に更新できるルックアップデータセットによるデータの関連付けとエンリッチメントが可能です。イベントにホストやアセット情報を追加する必要がありますか?問題ありません。どのIPアドレスやURLが脅威情報リストに含まれているかを確認したいですか?もちろんです。ルックアップデータセットを更新してすぐに使用できます。
Lookup JoinはSQLスタイルのLEFT OUTER JOINで、右側には「lookup 」と呼ばれる新しいインデックスモードを使用します。ルックアップインデックスには資産、既知の不良IPなどの脅威情報データ、注文情報、従業員や顧客情報などが含まれ、可能性は無限です。
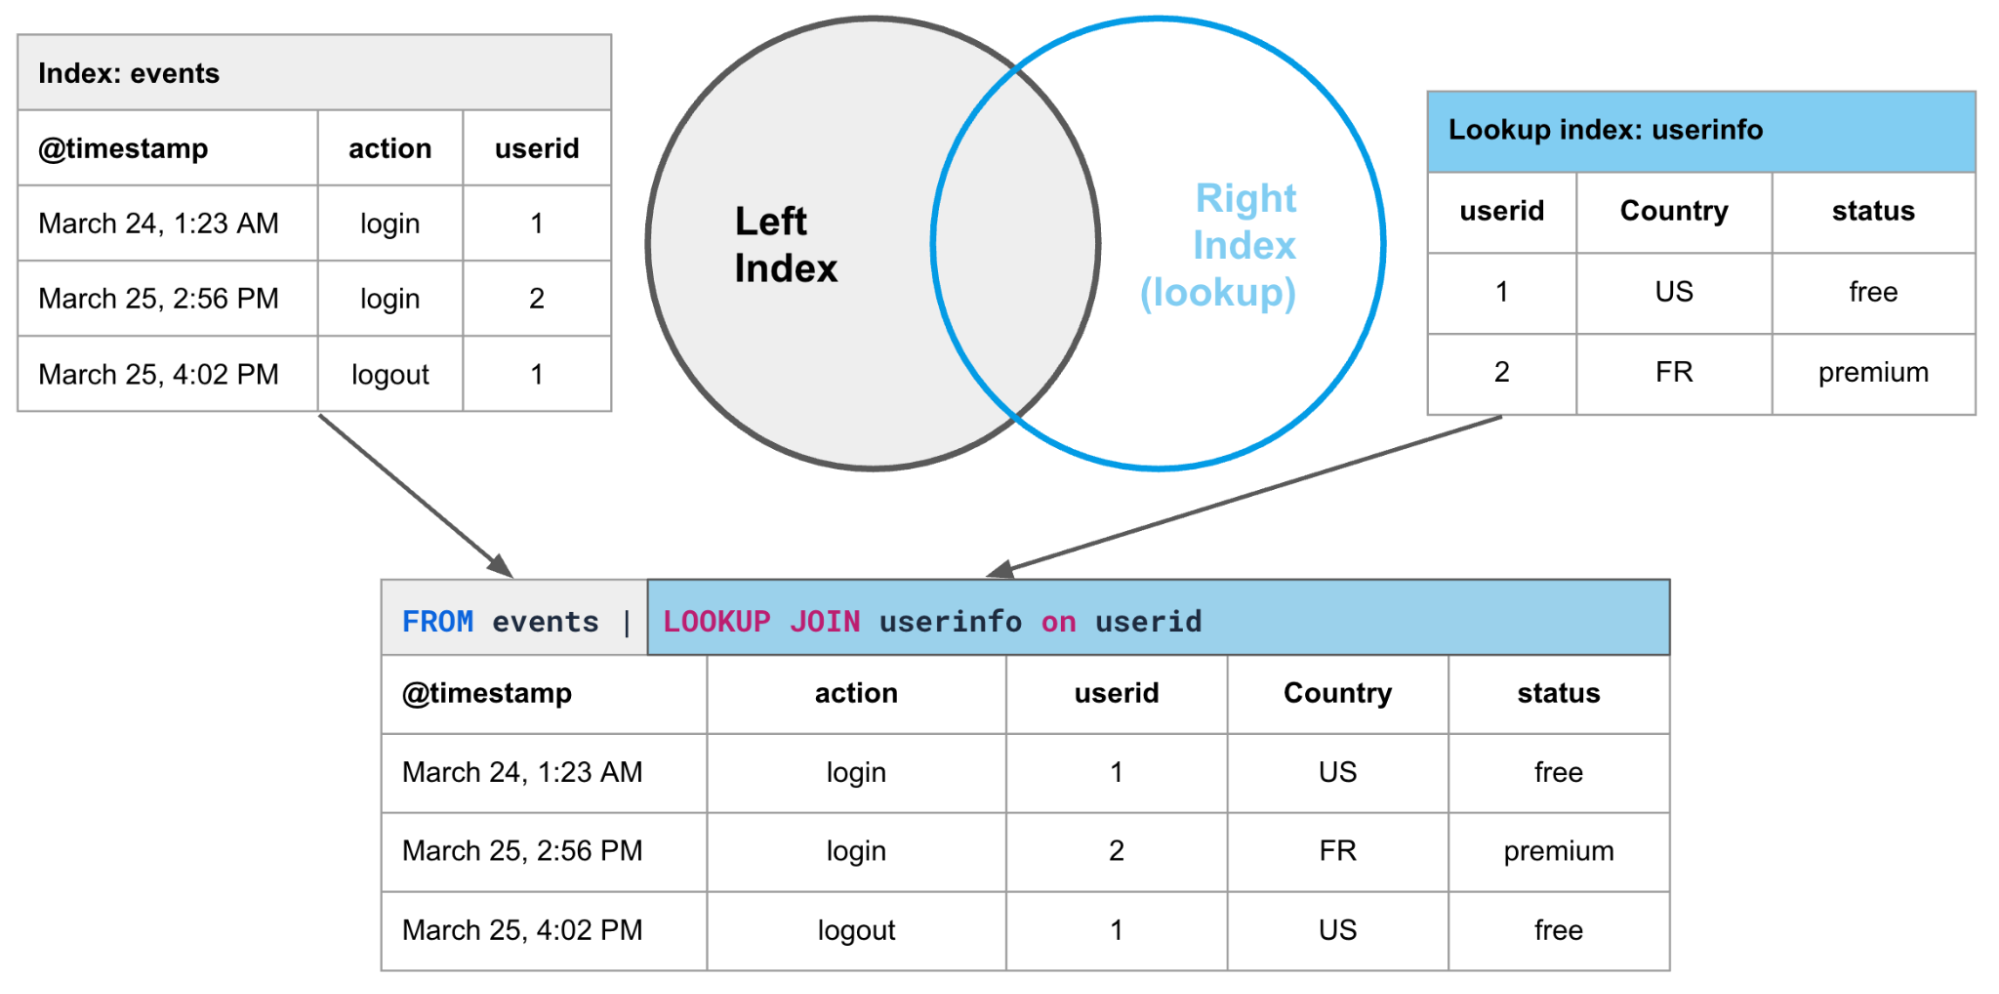
Elasticsearchには当初から結合機能が不足していました。入れ子や_parent、結合フィールドタイプ、エンリッチなど、この不足を補う試みは過去に何度か行われましたが、同じインデックス内のイベントの横かクライアント側の結合に参照データを置くことでデータを非正規化する方法を推奨するのが常套的な解決策となっていました。ただ、この解決策は、データ量が増えたときの拡張性に乏しく、データやユースケースが多岐にわたる場合、効果が限定的となります。そして遂に、結合機能の実現の目処がつきました。その鍵を握るのが「ES|QL」です。これは単なる言語ではなく、新たなコンピューティングエンジンの上に構築され、結合などの高度な機能が実現可能にします。
Lookup Joinを有効にするために、新しいインデックスモード「lookup」を作成しました。ルックアップインデックスは通常のインデックス(mode:standardがデフォルト)に似ており、直接更新可能です。主な違いは、ルックアップインデックスは1つのシャードだけだということです。したがって、1つのシャードに対してはLuceneの上限である20億件の文書に制限されています。この制限は、多くのルックアップ結合ユースケースの「右側」データを保持するには十分すぎるほどです。この制限を設けることで、結合の右側のソースカーディナリティを減らすことにより、完全に分散された結合に伴う問題の一部を回避できます。また、これにより、ルックアップ参照として使用する予定のデータセットがわかるため、将来的に最適化する方法を見つけることができます。
ルックアップインデックスモードを除き、ソースデータに制限はなく、結合を実行するために必要なデータ準備もありません。つまり、参照データセットの追加も、最新状態に保つことも容易だということです。
その一部は、ES|QLのENRICHコマンドですでに可能になっています。ENRICHは、投入パイプラインにおける取り込み時のルックアップや、頻繁に変更されない小規模なデータセット向けに最適化されていたため、便利ではあったものの、理想的とは言えませんでした。Lookup Joinは、Enrichよりも設定と管理が簡単です。
作成すべきエンリッチポリシーなし
ポリシーの実行なし
ルックアップインデックスは書き込み可能
データのコピーが少ない
複数の一致の処理が改善され、Enrichは複数の一致がある場合に複数値フィールドを作成するのに対し、Lookup joinは複数行を作成するためユーザーあたりのバイト数や注文合計など、グループ化や集計などのさらなる分析が容易に
Lookup Joinではマッチフィールドをその場で指定可能
LOOKUP JOIN の活用例をいくつかご紹介します。
セキュリティイベントに脅威インテリジェンスを組み込むことでイベントをさらに充実
現在使用しているホスト群と最新の脅威情報または内部メタデータを比較
IOTの読み取り値を静的または動的メタデータ(製造元、体積単位)と相関
詳しいコンテキストや絞り込みのために、セキュリティイベントをホスト情報と結合
資産の重要度などの事実を追加する(このユーザーは経営幹部であるなど)
ホスト名を持つソースにCrowdStrike AIDを追加
特定のIPアドレスが脅威情報フィードに入っているか確認
イベントに従業員情報を追加
他にも幅広い活用例が考えられます。
使用例
この機能がいかに簡単で強力なものとなる可能性があるか、実例をいくつか交えて見ていきましょう。
SREとしては、次のことが必要になるかもしれません。
IPアドレスやホスト名に基づいてログに環境を追加
従業員情報をログに統合
どのチームがサーバーを所有しているかを調査
LOOKUP JOINを使用する前は、以下の手順が必要でした。
参照データ(環境)をインデックスに格納
そのインデックスに基づいてエンリッチポリシーを定義し、ポリシータイプ、マッチフィールド、エンリッチフィールドを指定
エンリッチポリシーを一度実行してエンリッチインデックスを構築
各参照データセット(従業員、チーム)ごとにこれを反復
データが変わるたびにエンリッチポリシーを実行
LOOKUP JOINでは、参照データをLOOKUPインデックスに入れるだけで、すぐにご利用いただけます!
例えば、ECサイトでエラーが発生しているというアラートが届いたと想像してください。成功の200 HTTP対応コードではないウェブログもあります。環境ごとに分解して、本番環境の顧客が影響を受けているかどうかを確認したいのですが、ログには環境フィールドがありません。それでも問題ありません。環境に対してルックアップ結合を追加すれば良く、例えば、次のようなファイルを使用できます。
clientip,environment
192.168.1.9,QA
192.168.14.2,Dev
192.168.12.3,Prod
…次に、環境ルックアップインデックス(私の場合はenvs_lkpという名前です)に対してLOOKUP JOINを追加します。
FROM kibana_sample_data_logs | WHERE response.keyword != "200"
| LOOKUP JOIN envs_lkp ON clientip
| STATS COUNT(*) by response, environment
製造工程および品質保証(QA)工程にエラーが発生しました。各ウェブサーバーをどのチームが所有しているかのリストと照合することで、誰に連絡すべきかを確認できます。
host,team
www.elastic.co,Web team
artifacts.elastic.co,Delivery team
cdn.elastic-elastic-elastic.org,Cloud team
elastic-elastic-elastic.org,Web teamFROM kibana_sample_data_logs | WHERE response.keyword != "200"
| LOOKUP JOIN teams_lkp ON host
| STATS num = COUNT(*) by host, response.keyword, team
| SORT num DESC
セキュリティアナリストは結合機能が大好きです!次のような用途に使用できます。
既知の不正URLをリクエストしているクライアントIPを特定
資産情報と関連付けてイベントをグループ化し、優先度やリスクを割り当て
Abuse.chのURLhausから悪質なURLのリストをダウンロードし、検索インデックスにアップロードできます。
FROM logs
| LOOKUP JOIN urlhaus_lkp ON url
| WHERE threat IS NOT NULL
| KEEP @timestamp, url.keyword, clientip, threat
ルックアップの作成方法
少なくとも1つのルックアップインデックスがルックアップ結合を使用するために必要です。現在Elasticは、Kibanaでルックアップを簡単かつ便利に作成・更新する方法を考案中です。当面は、ルックアップインデックスをいくつかの方法で作成するところから開始できます — 重要なのは、インデックスモードが「lookup」でなければならないという点です。
インデックス管理を使用してルックアップインデックスを作成します。
Kibanaの左側のナビゲーションペインで、「スタック管理」をクリックし、次に「インデックス管理」をクリックします。右側で 「インデックスを作成」をクリックします。

インデックス名を入力し、インデックスモードのドロップダウンメニューから「ルックアップ」を選択してください。

「作成」をクリックすると、空のルックアップインデックスが作成されます。
APIを使ってルックアップインデックスを作成する
インデックス作成APIを使用してルックアップインデックスを作成します。その際、必ずインデックスモードを指定してください。
PUT mylookupindex
{
 "settings": {
   "index.mode": "lookup"
 }
}MLファイルアップローダーを使用してルックアップインデックスを作成する
Kibanaの左側ナビゲーションペインで[Machine learning](機械学習)をクリックし、[File Data Visualizer]を選択します(またはKibanaの検索バーに「upload」と入力します)。

ファイルを選択するか、ドラッグアンドドロップしてください。これにはCSVが適しています。
「インポート」をクリックした後、インデックスの名前を入力し、「詳細設定」をクリックしてインデックス設定を表示します。ここで、index.mode: lookupを追加する必要があります。

ファイルのアップロードを完了するために、[Import](インポート)をクリックします。インデックスとデータビューが作成されます。
いずれの場合も、ES|QLのルックアップインデックスを参照できるようになりました。
よくある質問への回答
Q: Joinを使わない方がよい場合はいつですか?
Lookup Joinは非常に強力な機能ですが、その分コストがかかります。Joinは高負荷な処理であり、行うたびにクエリの遅延が発生します。Joinが過剰であったり最適でない場合もあります。例えば、多くのクエリで頻繁に結合されるフィールドがある場合は、左側のインデックスに非正規化することを検討してください。取り込み時にエンリッチインジェストプロセッサーやファイルシッパーの設定、Logstashフィルターなどを使用して追加します。この1回のインジェスト処理は、ストレージ使用量のわずかな増加と、より高速なクエリとのトレードオフです。これは、頻繁に変わらない参照値(ユーザーIDのユーザー名)やほとんど変わらない値(ホストの製造元)に最も適しています。
Q: ルックアップを直接クエリできますか?
はい。ルックアップインデックスはほとんど「単なるインデックス」なので、ES|QLでクエリできます。
FROM <lookup_index> | …または、Data viewを作成してください。

Q:Logstashやエージェントからデータを送信できますか?
はい!ただし、ルックアップインデックスはデータストリームではなく、1つのシャードに過ぎませんので、各ルックアップインデックスには最大20億件のドキュメントしか送信できないことにご注意ください。
さっそく活用しましょう
ルックアップ結合が一般公開されるよう、既知の制限事項の一部を取り除く作業を進めています。さらに、ルックアップデータセットの編集体験を最高のものにするよう設計しています。Kibana Discoverで直接ルックアップインデックスを作成して編集したり、CSVファイルをDiscoverにドロップしてインデックスを作成したりできることを想像してみてください。これがそのイメージ図です。

そして、ルックアップ結合はほんの始まりに過ぎません。INNER JOINやサブクエリなど、その他の便利な結合方法も提供したいと考えています。また、ルックアップインデックスだけでなく、あらゆるインデックスに対して結合できるようにしたいと考えています。
使用を開始
それがlookup joinです。Elasticsearch 8.18/9.0でテクニカルプレビューとして利用可能となりました。
準備は整いましたか?Elastic 8.18と9.0はこの最新リリースのすべての新機能を含むマネージドElasticsearch ServiceであるElastic Cloudで利用可能になりました。ES|QLチームを代表して、皆様からのフィードバックをお待ちしております。DiscoverのES|QLエディターの「フィードバックを送信」ボタンをご利用ください。また、Joinに関するダジャレを使わずにこのJoinブログを最後までお届けできました。ご覧いただきありがとうございます。
本記事に記述されているあらゆる機能ないし性能のリリースおよびタイミングは、Elasticの単独裁量に委ねられます。現時点で提供されていないあらゆる機能ないし性能は、すみやかに提供されない可能性、または一切の提供が行われない可能性があります。
シェアする
- Share on Twitter
Twitter
- Share on LinkedIn
リンクトイン
- Share on Facebook
Facebook
- Share by Email
メール
- Print this page
印刷