Stratégie de niveaux de données Elastic : optimisation pour une implémentation résiliente et efficace

 Share on Twitter
Partager sur Twitter

 Share on LinkedIn
Partager sur LinkedIn

 Share on Facebook
Partager sur Facebook

 Share by Email
Partage par e-mail

 Print this page
Imprimer
Chez Elastic, la plupart de nos implémentations clients réussies commencent par un seul cas d'utilisation visant à répondre à des besoins métier spécifiques. Elastic est souvent adopté initialement parce que les développeurs apprécient les fonctionnalités qu'il offre. Cependant, en raison de sa flexibilité et de sa personnalisation, les clients ont tendance à étendre leur adoption pour répondre à divers besoins, tels que le logging et le suivi des performances applicatives, le SIEM et les opérations de sécurité, et même des cas d'utilisation de recherche plus complexes utilisant les données déjà disponibles dans Elastic.
Dans l'environnement informatique actuel, le simple fait de stocker des données (logs, traces, indicateurs et documents) est insuffisant. Les organisations ont besoin d'une solution qui permette à leurs équipes d'accéder à ces données et de les utiliser rapidement et efficacement. L'efficacité est essentielle dans la gestion des données, car chaque bit de données stockées entraîne des coûts de matériel, de licence, de maintenance et de gestion.
Dans ce blog, nous expliquerons comment les organisations disposant de grandes quantités de données peuvent optimiser leur stockage sur différents niveaux afin de réaliser des économies et de tirer davantage de valeur de leurs données.
Le défi : une gestion des données efficace et une scalabilité
Les organisations apprécient Elastic pour sa vitesse, sa scalabilité, sa personnalisation et ses fonctionnalités. C'est pourquoi ils trouvent souvent de nouveaux cas d'utilisation pour Elastic. Cela devient un défi lorsque de grandes quantités de données sont ingérées sans tenir compte de la manière dont elles sont stockées, gérées et utilisées, ce qui peut entraîner des goulots d'étranglement dans la gestion des données. À mesure que le volume de données augmente, leurs configurations actuelles peinent à répondre aux nouveaux besoins, atteignant les limites de leur matériel et de leurs licences.
Si votre organisation rencontre ces problèmes, la solution est plus simple que vous ne l'imaginez.
La solution : une stratégie de données pilotée par l'entreprise
La solution pour surmonter ce défi consiste à définir une stratégie de données qui s'aligne sur vos objectifs commerciaux. Au lieu de collecter et de conserver des données sur la base d'exigences arbitraires, posez-vous les questions suivantes :
Quelles données doivent être collectées pour atteindre un objectif commercial ?
À quelle fréquence ces données sont-elles utilisées ?
Existe-t-il une date d’expiration après laquelle ces données ne sont plus utiles ?
Existe-t-il des exigences de conformité pour ces données ?
Sur la base des réponses aux questions ci-dessus, les organisations peuvent créer une stratégie de données axée sur l'entreprise pour optimiser la manière dont les données sont stockées et utilisées, en maximisant leur investissement existant dans Elastic.
Étude de cas
Pour illustrer les avantages de l'adoption de cette stratégie, explorons l'étude de cas d'un client ayant suivi ce processus.
Ce client traite généralement 5 To de données par jour et gère une moyenne de 250 000 événements par seconde. Cependant, le volume augmente parfois jusqu’à 7 To par jour et 350 000 événements par seconde. L’implémentation Elastic pour ce client visait l’ingestion d’un volume élevé de données de sécurité et à les mettre à la disposition de l’équipe du centre des opérations de sécurité (SOC) afin de rechercher des informations sur les cyberincidents et les enquêtes sur la fraude.
Cette mise en œuvre a été si fructueuse que le client a ajouté de nouveaux cas d'utilisation nécessitant une conservation des données plus longue et des capacités de recherche plus rapides à partir d'un éventail plus large de sources de données. Ils ont ciblé les résultats pour l'entreprise suivants :
Optimisation des logs : En optimisant leurs niveaux de données, les organisations peuvent améliorer leurs pratiques de gestion des logs, en veillant à conserver les bons logs pendant la durée appropriée, tout en améliorant l'efficacité opérationnelle et le respect de la conformité.
Utilisation améliorée des licences : Un stockage hiérarchisé efficace signifie une meilleure utilisation des licences, ce qui permet aux organisations de tirer le meilleur parti de leurs ressources existantes et d'éviter potentiellement des coûts de licence inutiles.
Efficacité commerciale accrue : La capacité à trouver des informations à partir des logs plus efficacement peut conduire à une meilleure efficacité commerciale, permettant une prise de décision plus rapide et une planification stratégique plus éclairée.
Intégration de nouveaux cas d'utilisation : Grâce à des niveaux de données optimisés, les organisations peuvent facilement intégrer de nouveaux cas d'utilisation, étendant ainsi leurs capacités d'analytique de données sans investissements d'infrastructure significatifs.
Stratégie de données claire : Le stockage hiérarchisé optimisé des données contribue à une stratégie de données claire, garantissant que les données sont fiables, facilement accessibles et gérées efficacement, posant ainsi les bases d'une prise de décision basée sur les données.
Niveaux de données
La hiérarchisation des données est un sujet complexe et nuancé qui mérite son propre article de blog pour être approfondi. Toutefois, aux fins de définition d'une stratégie de données, les différents niveaux de données peuvent être simplifiés en trois utilisations principales : ingestion, rechercher et stocker.
Ingestion (niveau hot) : Ingérez les données aussi rapidement que possible avec une latence minimale.
Rechercher (niveaux hot et warm) : Recherchez des données rapidement et traitez de grands ensembles de données.
- Stocker (niveaux cold et frozen) : Stockez les données aussi longtemps que nécessaire et effectuez des recherches ad hoc à faible fréquence.
Croissance et conservation des données
Comprendre l’éventail des exigences en matière de conservation des données est crucial pour la conformité et une gestion efficace des données. Différentes réglementations nécessitent des périodes de conservation variables :
Exigences de conservation SOX : 7 ans
Exigences HIPAA en matière de conservation des données : 6 ans
Exigences de conservation des données PCI DSS : 1 an
Exigences de conservation des données Bâle II : 3–7 ans
Dossiers des employés au titre du RGPD :
Salaires : 3 ans
Dossiers fiscaux : 6 ans
Nom, adresse : 3 ans
- Fair Labor Standards Act : 2 à 3 ans
Architecture précédente vs nouvelle architecture
Architecture précédente
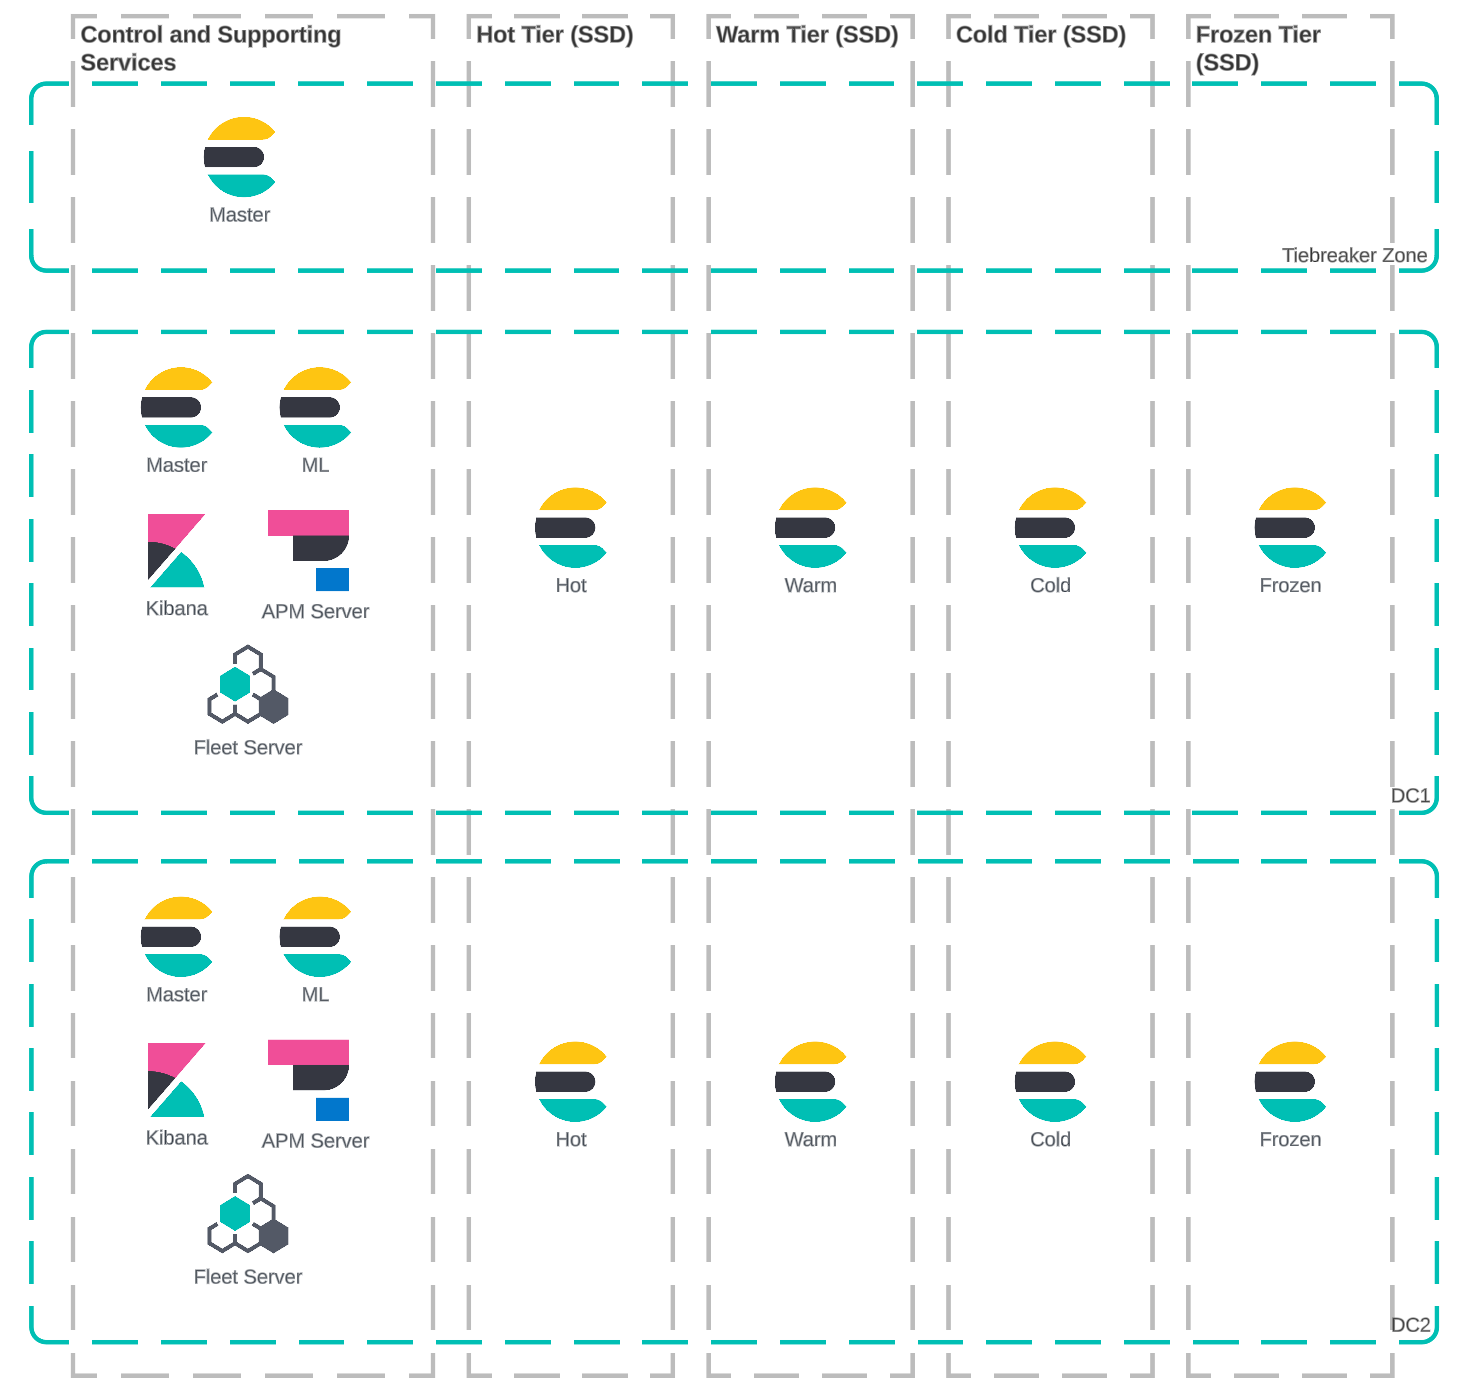
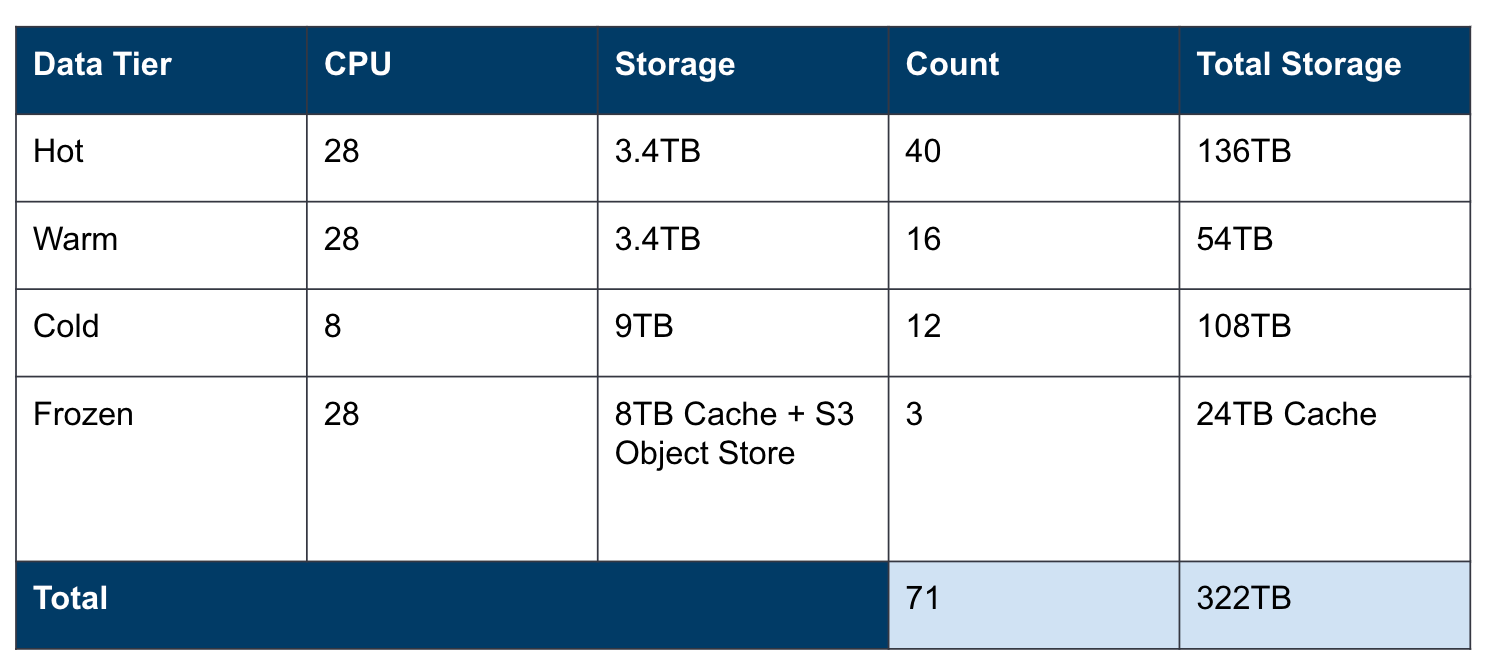
L'architecture précédente comportait deux centres de données avec une implémentation de stockage à quatre niveaux répondant à divers besoins de traitement des données. Cette implémentation nécessitait davantage de matériel, de licences et de frais de gestion opérationnelle.
Le client a conservé tous les logs pendant 90 jours, quelle que soit la manière dont les données étaient utilisées.
7 jours en niveau hot
2 jours warm
10 jours en niveau cold
Jours restants dans le niveau "frozen"
Le client utilisait le même matériel pour les niveaux « hot » et « warm ». Le niveau « warm » était utilisé uniquement pour forcer la fusion des index pour les snapshots interrogeables. Les niveaux « warm » et « cold » étaient très sous-utilisés, tant au niveau du processeur que du stockage. Le niveau « frozen » était restreint, ce qui entraînait une lenteur des recherches historiques.
Nouvelle architecture
Après avoir examiné la manière dont les données ont été utilisées, les conclusions suivantes ont été découvertes :
La majeure partie des données à haut volume n'était recherchée que dans les 24 premières heures suivant l'ingestion.
Au bout de 24 heures, l'utilisation principale des données concernait les enquêtes de sécurité, qui nécessitaient des recherches ad hoc.
Certains index sélectionnés devaient être conservés plus longtemps pour le reporting.
En raison de nouvelles exigences de conformité, les données devaient être conservées jusqu'à un an.
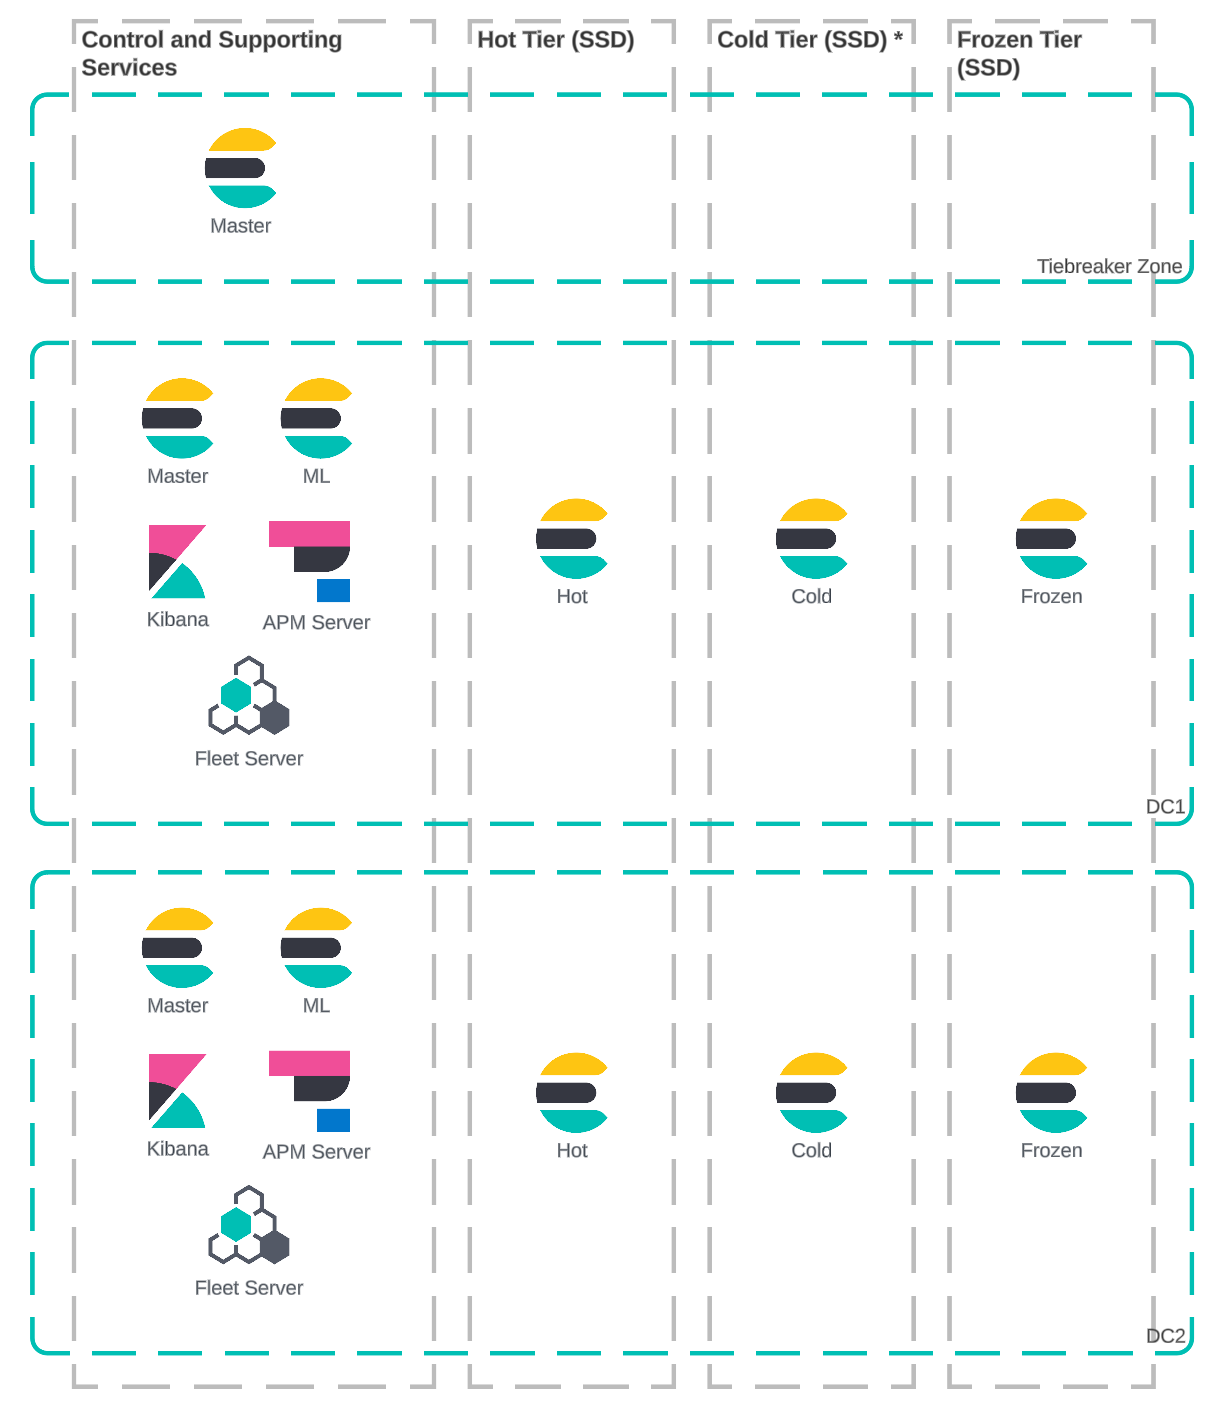
Migrer vers une architecture hot/cold/frozen
Les Node du niveau « hot » disposaient d'une capacité suffisante pour effectuer des activités de fusion forcée, ce qui a permis de supprimer le niveau « warm ».
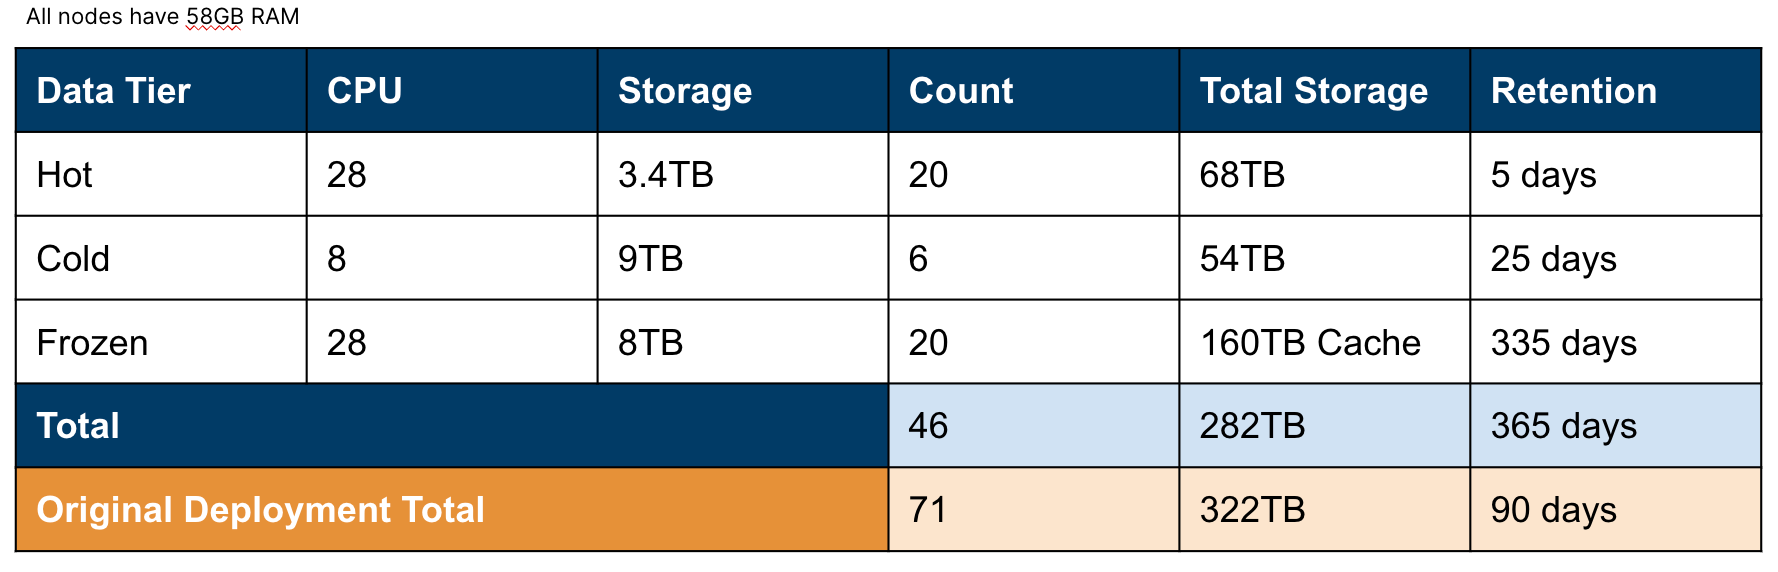
La plupart des données peuvent passer directement du niveau hot au niveau frozen après 36 heures.
Les données nécessitant un stockage local pour des cas d'utilisation de reporting peuvent être conservées dans le niveau cold.
Le niveau « hot » peut également être réduit car il y a moins de données à conserver.
L'extension du niveau frozen augmente la quantité de cache disponible pour les recherches, ce qui améliore les performances de recherche. De plus, cela permet de conserver les données pendant un an au lieu de seulement 90 jours.
Optimisation du stockage
Meilleure densité de stockage : le niveau cold peut exploiter un snapshot interrogeable en tant que réplique. Le niveau frozen stocke toutes les données dans le référentiel de snapshot et met uniquement en cache les résultats des requêtes dans son cache local.
Une réplication moindre des données nécessite moins de Node, ce qui réduit l'utilisation du matériel et des licences.
Tous les niveaux utilisent les mêmes exigences de stockage, ce qui permet de consolider et de réutiliser facilement le matériel.
Les changements ont libéré 20 à 30 Node et licences, qui ont été réutilisés pour créer des cas d'utilisation supplémentaires.
La nouvelle architecture vise à consolider les profils matériels pour les charges de travail de logging et de sécurité, en introduisant potentiellement une troisième zone pour une résilience accrue. Elle se concentre également sur l'optimisation du stockage, notamment une meilleure densité de stockage et une réplication des données réduite, ce qui permet de réduire le nombre de Node requis et d'optimiser l'utilisation des licences. Cette architecture permet la consolidation des profils matériels.
Avantages de la nouvelle architecture
Stratégie de conservation des données améliorée : Une stratégie de hiérarchisation du stockage plus efficace peut conduire à une meilleure conservation des données, ce qui peut s'avérer particulièrement important à des fins de sécurité et de conformité.
Gestion simplifiée de la Platform : La consolidation des profils matériels et la réduction du nombre de Node requis peuvent simplifier la gestion de la Platform, réduisant ainsi les frais opérationnels.
Réduction de l'empreinte matérielle : L'optimisation des ressources de calcul et de la densité de stockage peut conduire à une réduction de l'empreinte matérielle, permettant ainsi d'économiser de l'espace et de l'énergie.
ROI amélioré : En optimisant ses niveaux de stockage, l'organisation peut obtenir un meilleur retour sur investissement et tirer le meilleur parti de son infrastructure existante.
Les avantages de la nouvelle architecture incluent une gestion simplifiée, une meilleure utilisation des licences et du matériel, une conservation des données plus longue et un déploiement plus réduit, ce qui permet des mises à niveau plus rapides et une résilience accrue de l'infrastructure. Cependant, les inconvénients potentiels peuvent inclure une performance de recherche plus lente pour certains cas d'utilisation nécessitant un stockage rapide avec des IOPS élevés, en raison d'un volume de données plus important stocké dans les niveaux frozen.
Mise en œuvre de la stratégie
Une stratégie de données hiérarchisée permet aux entreprises d'optimiser les performances pour les données récentes tout en stockant efficacement de grands volumes de données. En tirant parti de la connaissance de l'allocation des partitions, les entreprises peuvent définir les caractéristiques de chaque niveau et planifier la migration des index en fonction de leur stratégie de données. Cela garantit que les données sont stockées sur le niveau matériel le plus approprié à tout moment, en équilibrant les performances et les considérations de coût.
Exemple de niveaux de stockage et de ratios mémoire
Le rapport mémoire/stockage est un facteur crucial à prendre en compte lors de la planification de la croissance d'Elastic. Voici les quatre niveaux de stockage disponibles pour les clients Elastic :
Niveau « hot » : Optimisé pour les performances d'ingestion et de recherche, utilisant généralement des SSD haute vitesse avec un rapport mémoire/stockage d'environ 1:30
Niveau Warm : Optimisé pour la capacité de stockage, utilisant des SSD ou des HDD avec un ratio mémoire/stockage d’environ 1:160
Niveau cold : Optimisé pour la capacité de stockage en utilisant des snapshots interrogeables comme réplique (bien que le ratio de stockage soit le même que pour le niveau warm, la suppression d'une réplique locale réduit de moitié les besoins en stockage.)
Niveau frozen : Optimisé à des fins d'archivage, utilisant un stockage de snapshots économique avec cache sur disque local pour offrir un ratio mémoire/stockage supérieur à 1:1 000
Analyse des coûts de haut niveau des différentes configurations de stockage
Dans notre analyse, nous avons évalué le coût total de possession (TCO) pour diverses configurations de stockage afin d'optimiser l'implémentation Elastic d'un autre client. Vous trouverez ci-dessous une analyse détaillée de ces configurations et de leurs coûts associés :
Cluster ES auto-géré
1 To d'ingestion quotidienne
Conservation totale 365 jours
| Configuration | Jours de conservation | Nœuds | Coûts liés au matériel | Coût du stockage de snapshots | Coût total (TCO) |
| hot-warm | 7 hot, 358 warm | 4 hot, 60 warm | 44 954 $ | 7 665 $ | 52 619 $ |
| Hot-warm-cold | 7 hot, 90 warm, 268 cold | 4 hot, 15 warm, 23 cold | 28 231 $ | 7 665 $ | 36 795 $ |
| Hot-warm-frozen | 7 hot, 90 warm, 268 frozen | 4 hot, 15 warm, 3 frozen | 17 051 $ | 7 665 $ | 22 204 $ |
| Hot-frozen | 7 hot, 358 frozen | 4 hot, 4 frozen | 6 198 $ | 7 665 $ | 12 066 $ |
Considérations pour la planification de la capacité
Lors de la planification de la capacité de chaque niveau, il est crucial de les dimensionner indépendamment en fonction de leurs besoins spécifiques. Cela implique de comprendre les besoins en stockage et en performance de chaque niveau et de s'assurer qu'ils sont correctement provisionnés. De plus, les organisations doivent prendre en compte les besoins globaux en capacité et la manière dont les différents niveaux interagiront pour garantir une stratégie de stockage équilibrée et efficace.
Conclusions
L'optimisation du stockage par niveaux ne se résume pas à une réduction des coûts ; il s'agit de permettre aux organisations d'évoluer et de s'adapter aux nouveaux défis et opportunités.
En abordant les défis d'optimisation de la Platform à l'aide des principes de stratégie de données, les organisations peuvent faciliter de nouveaux cas d'utilisation, améliorer la fiabilité des données et renforcer leur stratégie globale en matière de données. Consultez notre documentation pour savoir comment votre organisation peut construire une implémentation résiliente et efficace d'Elastic en utilisant le données tiering.
La publication et la date de publication de toute fonctionnalité ou fonction décrite dans le présent article restent à la seule discrétion d'Elastic. Toute fonctionnalité ou fonction qui n'est actuellement pas disponible peut ne pas être livrée à temps ou ne pas être livrée du tout.
Partager
- Share on Twitter
Partager sur Twitter
- Share on LinkedIn
Partager sur LinkedIn
- Share on Facebook
Partager sur Facebook
- Share by Email
Partage par e-mail
- Print this page
Imprimer