ES|QL Joins sind da! Jawohl, Joins!
Elasticsearch 8.18 enthält den ES|QL-Befehl LOOKUP JOIN, unseren ersten JOIN im SQL-Stil.

 Share on Twitter
Auf Twitter teilen

 Share on LinkedIn
Auf LinkedIn teilen

 Share on Facebook
Auf Facebook teilen

 Share by Email
Per E-Mail teilen

 Print this page
Drucken
Elasticsearch 8.18 enthält unser erstes SQL-ähnliches JOIN: ES|QLs LOOKUP-JOIN-Befehl. Es ist jetzt in der Tech-Vorschau verfügbar und ermöglicht Datenkorrelation und -anreicherung mit leicht aktualisierbaren Lookup-Datensätzen. Müssen Sie Host- und Asset-Informationen zu Ihren Events hinzufügen? Kein Problem. Möchten Sie überprüfen, welche IP-Adressen oder URLs auf Bedrohungslisten stehen? Klar! Aktualisieren Sie den Lookup-Datensatz und verwenden Sie ihn sofort? Go for it!
Lookup Join ist ein SQL-ähnliches LEFT OUTER JOIN, das auf einem neuen Indexmodus namens Lookup für die rechte Seite basiert. Der Lookup-Index könnte Vermögenswerte, Bedrohungsdaten wie bekannte unsichere IP-Adressen, Bestellinformationen, Mitarbeiter- oder Kundendaten – es gibt unendlich viele Möglichkeiten.
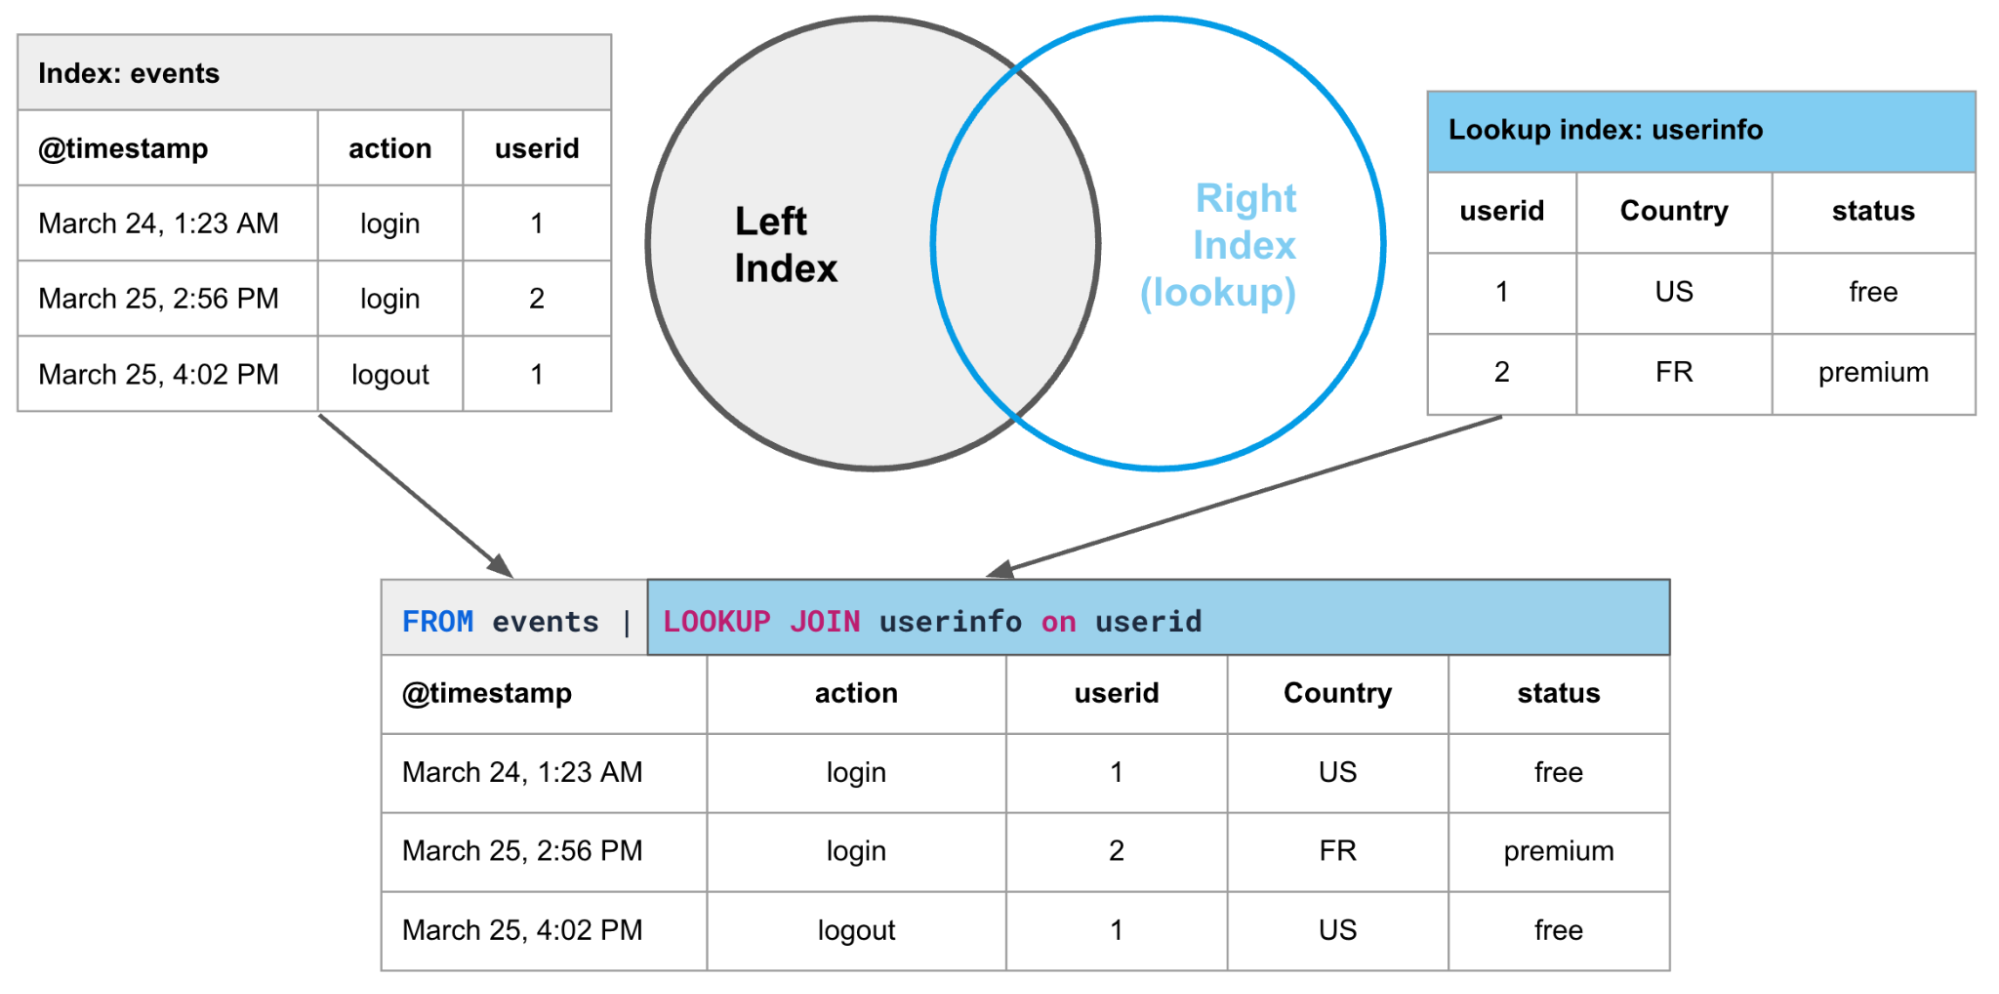
Elasticsearch bot bisher keine Join-Funktionalität, obwohl im Laufe der Zeit einige Ansätze in diese Richtung verfolgt wurden, wie beispielsweise verschachtelte und übergeordnete Join-Feldtypen sowie die Anreicherung von Daten. Üblicherweise wurde die Denormalisierung von Daten durch die Speicherung der Referenzdaten neben den Ereignissen im selben Index oder durch clientseitige Joins gefördert. Diese Lösungen beeinträchtigen jedoch die Skalierbarkeit bei größeren Datenmengen und können bei einer hohen Datenvielfalt und unterschiedlichen Anwendungsfällen einschränkend wirken. Es ist an der Zeit, dass Elasticsearch Joins unterstützt. Und jetzt ist es möglich: ES|QL ist nicht nur eine Sprache – sie basiert auf einer neuen Compute-Engine. Die ES|QL-Engine ermöglicht fortgeschrittene Features wie Joins.
Um Lookup-Joins zu ermöglichen, haben wir einen neuen Indexmodus erstellt: lookup. Ein Lookup-Index ähnelt weitgehend einem regulären Index (mode:standard ist der Standard), d. h. er ist direkt aktualisierbar. Der Hauptunterschied besteht darin, dass ein Lookup-Index nur aus einem Shard besteht. Daher ist er auf 2 Milliarden Dokumente begrenzt – ein Lucene-Limit für einen Shard. Dies sollte für viele Anwendungsfälle von Lookup-Joins mehr als ausreichend sein, um die Daten der „rechten Seite“ zu speichern. Durch diese Begrenzung vermeiden wir einige Probleme, die bei vollständig verteilten Joins auftreten können, indem wir die Kardinalität der Quelldaten auf der rechten Seite des Joins reduzieren. Außerdem erfahren wir so, welche Datensätze Sie als Lookup-Referenzen verwenden möchten, um diese zukünftig zu optimieren.
Abgesehen vom Lookup-Index-Modus gibt es keine Einschränkungen für die Quelldaten und keine Datenvorbereitung, die für einen Join erforderlich ist. Das heißt, es ist einfach, Suchdatensätze hinzuzufügen und sie auf dem neuesten Stand zu halten.
Ein Teil davon war bereits mit dem Kommando ENRICH in ES|QL möglich. ENRICH wurde für Ingest-Zeit-Lookups in Ingest-Pipelines und für kleine Datensätze, die sich nicht oft ändern, optimiert, daher war es zwar praktisch, aber nicht ideal. Lookup Join ist einfacher einzurichten und zu verwalten als ENRICH:
Es müssen keine Anreicherungsrichtlinien erstellt werden
Keine Umsetzung der Richtlinien
Nachschlageindizes sind beschreibbar
Es gibt weniger Kopien der Daten
Bessere Handhabung mehrerer Treffer – während enrich mehrwertige Felder erzeugt, wenn mehrere Treffer vorliegen, erzeugt lookup join mehrere Zeilen. Dadurch wird es einfacher, weitere Analysen wie Gruppierung und Aggregation durchzuführen, beispielsweise die pro Nutzer übertragenen Bytes oder die Bestellsummen.
Lookup Join ermöglicht die spontane Spezifizierung des Match-Felds
Hier sind nur einige Beispiele, wie Sie LOOKUP JOIN verwenden könnten:
Verbinden Sie Sicherheitsereignis mit Bedrohungsdaten, um eine Veranstaltung noch bereichernd zu gestalten.
Meine aktuellen Hosts im Vergleich zu den neuesten Bedrohungsinformationen oder internen Metadaten abfragen
Korrelieren Sie IOT-Messungen mit statischen oder dynamischen Metadaten (Hersteller, Volumeneinheit)
Sicherheitsereignisse mit Hostinformationen verknüpfen, um mehr Kontext und Filtermöglichkeiten zu erhalten.
Fügen Sie einige Fakten hinzu, wie z. B. die Kritikalität der Anlage (dieser Nutzer ist eine Führungskraft).
Fügen Sie CrowdStrike-A.I.D.s zu einer Quelle hinzu, die Hostnamen enthält.
Prüfen Sie, ob bestimmte IP-Adressen in Bedrohungsdatenfeeds enthalten sind.
Mitarbeiterinformationen zu Veranstaltungen hinzufügen
Die Möglichkeiten sind endlos.
Beispielverwendung
Schauen wir uns einige reale Beispiele an, um zu sehen, wie einfach und mächtig das sein kann.
Als SRE müssen Sie möglicherweise:
Füge den Protokollen eine Umgebung basierend auf der IP-Adresse oder dem Hostnamen hinzu.
Mitarbeiterinformationen mit Protokollen verknüpfen
Finde heraus, welches Team einen Server besitzt
Vor LOOKUP JOIN mussten Sie Folgendes tun:
Fügen Sie Ihre Referenzdaten (Umgebungen) in einen Index ein
Definieren Sie eine Anreicherungsrichtlinie basierend auf diesem Index und geben Sie dabei den Richtlinientyp, das Übereinstimmungsfeld und die Anreicherungsfelder an.
Führen Sie die Anreicherungsrichtlinie einmal aus, um den Anreicherungsindex zu erstellen.
Wiederholen Sie dies für jeden Referenzdatensatz (Mitarbeiter, Teams).
Anreicherungsrichtlinie ausführen, sobald sich die Daten ändern
Mit LOOKUP JOIN fügen Sie einfach die Referenzdaten in einen LOOKUP-Index ein und schon kann es losgehen!
Stellen Sie sich vor, Sie erhalten eine Benachrichtigung, dass bei einigen Nutzern Fehler auf Ihrer E-Commerce-Website auftreten. Sie finden Weblogs, in denen die Antwort nicht dem HTTP-Antwortcode 200 für Erfolg entspricht. Man möchte diese nach Umgebung aufschlüsseln, um zu sehen, ob Produktionskunden betroffen sind, aber die Logs haben kein Umgebungsfeld. Das ist in Ordnung – fügen Sie einfach einen Lookup-Join für die Umgebung hinzu, beispielsweise mithilfe einer Datei wie dieser:
clientip,environment
192.168.1.9,QA
192.168.14.2,Dev
192.168.12.3,Prod
…Fügen Sie nun den LOOKUP JOIN auf dem Umgebungs-Lookup-Index hinzu (meiner heißt envs_lkp):
FROM kibana_sample_data_logs | WHERE response.keyword != "200"
| LOOKUP JOIN envs_lkp ON clientip
| STATS COUNT(*) by response, environment
Es gibt Fehler in der Produktion und der Qualitätssicherung. Wir können eine Liste der Teams, denen die einzelnen Webserver gehören, einsehen, um herauszufinden, wen wir kontaktieren sollten:
host,team
www.elastic.co,Web team
artifacts.elastic.co,Delivery team
cdn.elastic-elastic-elastic.org,Cloud team
elastic-elastic-elastic.org,Web teamFROM kibana_sample_data_logs | WHERE response.keyword != "200"
| LOOKUP JOIN teams_lkp ON host
| STATS num = COUNT(*) by host, response.keyword, team
| SORT num DESC
Security-Analysten lieben ihre Joins! Vielleicht wollen sie:
Identifizieren Sie Client-IPs, die bekannte fehlerhafte URLs anfordern
Informationen mit den Anlagen korrelieren, um Ereignisse zu gruppieren und Prioritäten oder Risiken zuzuweisen.
Sie könnten eine Liste schädlicher URLs von URLhaus auf Abuse.ch herunterladen und in einen Suchindex hochladen.
FROM logs
| LOOKUP JOIN urlhaus_lkp ON url
| WHERE threat IS NOT NULL
| KEEP @timestamp, url.keyword, clientip, threat
So erstellen Sie Suchvorgänge
Sie benötigen mindestens einen Lookup-Index, um Lookup-Join zu verwenden. Wir arbeiten an Möglichkeiten, das Erstellen und Aktualisieren von Lookups in Kibana zu vereinfachen. Bis dahin können Sie auf verschiedene Arten einen Lookup-Index erstellen – wichtig ist dabei, dass der Indexmodus auf „Lookup“ eingestellt ist.
Suchindex mithilfe der Indexverwaltung erstellen
Klicken Sie im linken Navigationsbereich von Kibana auf Stack Management, und anschließend „Indexverwaltung“. Klicken Sie auf der rechten Seite auf „Index erstellen“.

Geben Sie einen Indexnamen an und wählen Sie im Dropdown-Menü „Indexmodus“ die Option „Nachschlagen“ aus:

Klicken Sie auf Erstellen, um einen leeren Lookup-Index zu erstellen.
Nachschlageindex über APIs erstellen
Erstellen Sie einen Lookup-Index mit der Create-Index-API – achten Sie nur darauf, den Indexmodus einzubeziehen:
PUT mylookupindex
{
 "settings": {
   "index.mode": "lookup"
 }
}Lookup-Index mit dem ML-Datei-Uploader erstellen
Im linken Navigationsfenster von Kibana auf Machine Learning und dann auf File Data Visualizer (oder geben Sie „hochladen" in Kibanas Suchleiste ein).

Wählen Sie Ihre Datei aus oder ziehen Sie sie per Drag-and-Drop – CSV eignet sich dafür gut.
Nachdem Sie auf „Importieren“geklickt haben, geben Sie einen Namen für den Index ein und klicken Sie auf „Erweitert“, um die Indexeinstellungen anzuzeigen. Hier sollten Sie die Option „index.mode: lookup“ hinzufügen.

Schließen Sie den Datei-Upload ab, indem Sie auf Importklicken. Ein Index und eine Data view werden erstellt.
In allen Fällen können Sie jetzt den Lookup-Index in Ihren ES|QL-Anfragen referenzieren.
Antworten auf häufig gestellte Fragen
Q: Wann sollte ich keine Joins verwenden?
Lookup-Join ist wirklich mächtig, aber mit großer Kraft … Nun, Sie wissen schon. Joins können eine teure Operation sein, und jeder Join fügt Ihrer Abfrage etwas Latenz hinzu. Es kann trotzdem Szenarien geben, in denen ein Join übertrieben oder nicht die beste Option ist. Wenn es zum Beispiel ein Feld gibt, das Sie sehr häufig in viele Abfragen einbinden, sollten Sie in Erwägung ziehen, es in den linken Index zu denormalisieren. Fügen Sie es zur Ingest-Zeit mit einem Enrich-Ingest-Prozessor, File-Übermittler-Konfiguration, verwenden Sie einen Logstash-Filter usw. Diese einmalige Eingabeverarbeitung ist ein Kompromiss für eine leichte Erhöhung der Speichernutzung zugunsten schnellerer Abfragen. Dies wäre am besten für Referenzwerte anwendbar, die sich nicht häufig ändern (der Nutzername einer Nutzer-ID) oder nie ändern (der Hersteller eines Hosts).
Q: Kann ich eine Abfrage direkt abfragen?
Ja! Ein Lookup-Index ist meist „nur ein Index“, sodass man ihn mit ES|QL abfragen kann.
FROM <lookup_index> | …Oder erstellen Sie eine Data View.

F: Kann ich Daten von Logstash oder Agent senden?
Ja! Denken Sie nur daran, dass ein Lookup-Index kein Datenstream ist, und es nur ein Shard ist, sodass Sie „nur“ bis zu 2 Milliarden Dokumente an jeden Lookup-Index senden können.
Was kommt als Nächstes?
Wir arbeiten daran, einige bekannte Einschränkungen zu beseitigen, damit der Lookup-Join allgemein verfügbar werden kann. Darüber hinaus entwickeln wir ein erstklassiges Bearbeitungserlebnis für die Nachschlagedatensätze. Stellen Sie sich vor, Sie könnten Lookup-Indizes direkt in Kibana Discover erstellen und bearbeiten oder eine CSV-Datei auf Discover ablegen, um den Index zu füllen. Hier ist ein Entwurf, wie das aussehen könnte:

Und Lookup-Joins sind erst der Anfang. Wir möchten weitere nützliche Join-Typen anbieten, wie z. B. INNER Joins oder Unterabfragen, und auch das Verknüpfen mit beliebigen Indizes ermöglichen (nicht nur mit Nachschlageindizes).
Erste Schritte
Das ist also lookup join, verfügbar in Elasticsearch 8.18/9.0 als technische Vorschau.
Bereit loszulegen? Elastic 8.18 und 9.0 sind jetzt verfügbar auf Elastic Cloud – dem gehosteten Elasticsearch Service mit allen neuen Features dieser aktuellen Version. Das ES|QL-Team freut sich auf Ihr Feedback. Nutzen Sie dazu einfachdie Schaltfläche „Feedback senden“ im ES|QL-Editor in Discover. Und übrigens: Wir haben es tatsächlich geschafft, diesen Blogbeitrag ganz ohne Wortspiele mit dem Begriff „Joins“ zu schreiben … vielen Dank fürs Lesen!
Die Entscheidung über die Veröffentlichung der in diesem Blogeintrag beschriebenen Leistungsmerkmale und Features sowie deren Zeitpunkt liegt allein bei Elastic. Es ist möglich, dass noch nicht verfügbare Leistungsmerkmale oder Features nicht rechtzeitig oder überhaupt nicht veröffentlicht werden.
Teilen
- Share on Twitter
Auf Twitter teilen
- Share on LinkedIn
Auf LinkedIn teilen
- Share on Facebook
Auf Facebook teilen
- Share by Email
Per E-Mail teilen
- Print this page
Drucken