Reduzierung von Fehlalarmen mit automatisierten SIEM-Untersuchungen von Elastic und Tines

 Share on Twitter
Auf Twitter teilen

 Share on LinkedIn
Auf LinkedIn teilen

 Share on Facebook
Auf Facebook teilen

 Share by Email
Per E-Mail teilen

 Print this page
Drucken
Eines der größten Probleme beim SIEM-Management, mit denen SOC-Teams konfrontiert sind, ist, dass sie oft von Fehlalarmen überwältigt werden, was zu Ermüdung bei den Analysten und zu Sichtbarkeitslücken führt. Darüber hinaus ist eine der größten Herausforderungen im Sicherheitsbereich die Erkennung kompromittierter SaaS-Zugriffstoken, ohne das Problem der Fehlalarme zu verschärfen.
Bei Elastic geht das InfoSec-Team beide Probleme an, indem es SIEM-Alarmuntersuchungen mit Tools wie Tines automatisiert. Dieser Blogbeitrag beschreibt, wie wir unsere Workflows optimiert, Fehlalarme reduziert und unsere Analyst:innen in die Lage versetzt haben, sich auf echte Bedrohungen zu konzentrieren.
Automatisierung der ersten Untersuchung von SIEM-Warnungen
In einem früheren Blogbeitrag haben wir darüber geschrieben, wie das Elastic InfoSec-Team Regelpakete erstellt hat, die Nutzer and Entity Behavior Analytics (UEBA) erkennen. Als wir diese Alarmpakete um weitere Datenquellen erweiterten, stellten wir fest, dass wir SOC-Analysten mit einer hohen Anzahl falsch-positiver Ergebnisse überlasteten, die durch anomale, aber harmlose Aktivitäten verursacht wurden – zum Beispiel API-Token-Aktivitäten, die nur einmal pro Monat oder von einem bekannten Scanner aus auftraten. Dies führte zu dem Problem, dass wir entscheiden mussten, ob wir eine Erkennungsregel erstellen, die aufgrund falsch-positiver Ergebnisse zu viele Alarme auslösen könnte, oder ob wir eine Sichtbarkeitslücke in Kauf nehmen, weil diese Erkennung fehlt. Eine ungenaue Erkennung mit vielen falsch-positiven Ergebnissen schafft aufgrund der Ermüdung der Analysten ihre eigene Art von Sichtbarkeitslücke. Doch dieses Problem stieß einen neuen Gedanken an: Was wäre, wenn wir die erste Untersuchung eines Alarms automatisieren könnten, indem wir bekannte falsch-positive Ergebnisse schließen und diejenigen eskalieren, die wir nicht schließen können?
Wir haben festgestellt, dass wir für viele unserer SaaS-Anbieter- und UEBA-Erkennungsregeln die Regel schließen können, wenn die Aktivität von einem vertrauenswürdigen Gerät stammt, wie z. B. einer unserer verwalteten Workstations. Die erste Aktion im Playbook zur Untersuchung besteht in vielen Fällen darin, eine Information aus dem ursprünglichen Alert zu verwenden, wie z. B. die source.ip, und dann andere Indexmuster in Elasticsearch nach dieser source.ip abzufragen. Wenn die Abfrage Ergebnisse liefert, kann der Alert als False Positive geschlossen werden. Wenn Sie beispielsweise einen UEBA-Alert für AWS-Secret-Key-Aktivitäten sehen, würden wir die folgende Gruppe von Abfragen ausführen, um den Alert zu prüfen und festzustellen, ob die Aktivität von einem vertrauenswürdigen Gerät stammt:
Gibt es Proxy-Logs, die zeigen, dass sich der Elastic Agent erfolgreich von einer Workstation oder einem Server mit dieser source.ip mit unserem Fleet Server verbindet?
Gehört diese source.ip zum öffentlichen IP-Bereich einer der AWS-, Google Cloud Platform- oder Azure-Netzwerkzonen, die wir verwalten und kontrollieren?
Gehört die source.ip zu einer autorisierten Anwendung eines Drittanbieters wie Okta, Terraform, Tines, Qualys oder Snyk?
Gab es in den letzten 2 Stunden erfolgreiche FIDO2-Single Sign-On-Authentifizierungen von dieser source.ip?
Wenn eine dieser nachfolgenden Elasticsearch-Abfragen Ergebnisse liefert, können wir davon ausgehen, dass diese AWS-API-Schlüsselaktivität wahrscheinlich autorisiert ist, und wir können den Alert schließen. Wenn alle diese Abfragen null Ergebnisse liefern, halten wir die Aktivität für verdächtig und eskalieren sie zur weiteren Untersuchung an ein Mitglied des SOC-Teams. Alle oben genannten Elasticsearch-Abfragen können mit der _search API durchgeführt werden, und wir können die Signals API verwenden, um die Alerts zu schließen und zu taggen, was uns die Automatisierung des gesamten Prozesses ermöglicht.
Durch das Senden unserer SIEM-Erkennungen von Elastic an ein Security Orchestration, Automation and Response (SOAR) -System unter Verwendung der Alert Actions -Feature können wir unser SOAR nutzen, um diese Untersuchungsabfragen automatisch für jeden zutreffenden Alert auszuführen. Basierend auf den Ergebnissen der Abfragen können wir den Alert automatisch schließen oder an einen Analysten eskalieren.
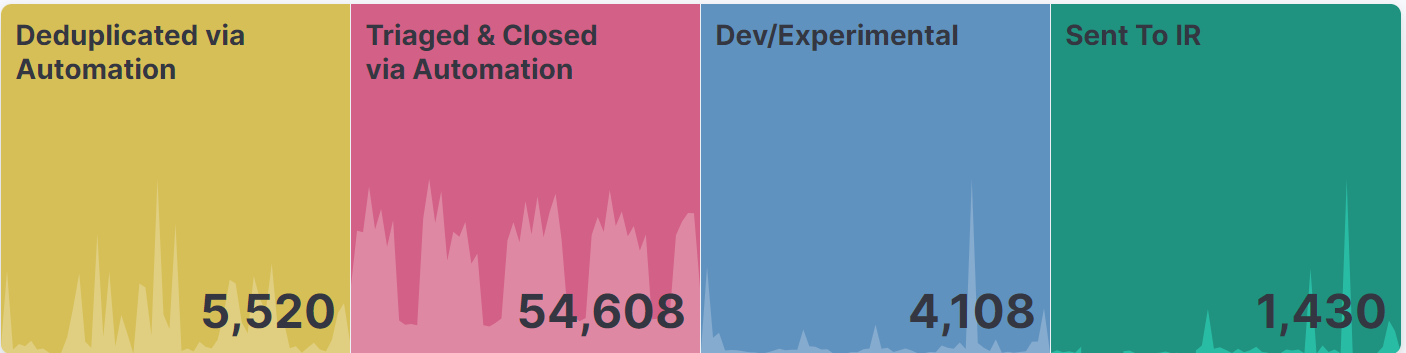
Diese automatisierte Triage-Funktion ermöglicht es uns, ganze Klassen von Erkennungen zu erstellen, die normalerweise viel zu laut wären, um sie ohne eine drastische Erhöhung der Anzahl an SOC-Personal zu untersuchen. Unser automatisierter Workflow triagiert und schließt derzeit über 3.000 Alarme pro Tag ohne menschliches Eingreifen. Ein erfahrener Analyst würde über 15 Minuten pro Alarm benötigen, um diese auf die gleiche Weise zu triagieren. Wenn wir dieselben Erkennungen ohne diese Automatisierung durchführen wollten, bräuchten wir zusätzlich 94 Vollzeitmitarbeiter. Dieses Diagramm zeigt unsere Zahlen für die letzten 30 Tage der Alarme in unserem SIEM:
Dieser automatisierte Triage-Workflow könnte mit benutzerdefinierten Skripten erstellt werden, aber dieser Blog zeigt Ihnen, wie Sie diese Automatisierung mit Tines aufbauen. Wir haben uns für diesen Weg entschieden, da das InfoSec-Team von Elastic ihn nutzt und er schlichtweg einfacher ist als Skripting. Wir haben festgestellt, dass Tines es einfach macht, Automatisierungen zu erstellen und zu ändern, ohne ein dediziertes Entwicklungsteam zu benötigen.
Senden der Warnungen an ein beliebiges SOAR
Wie oben erwähnt, besteht der erste Schritt darin, den Alarm-Inhalt aus Elastic Security in Ihre bevorzugte SOAR-Lösung zu übertragen. Hierfür verwenden wir das Feature Alert Actions in Elastic Security, das bei jeder Alarmauslösung eine benutzerdefinierte Aktion ausführt.
Bei der Konfiguration einer Erkennungsregel gibt es die Option, eine Regelaktion hinzuzufügen. Von hier aus können Sie den gewünschten Connectortyp auswählen.
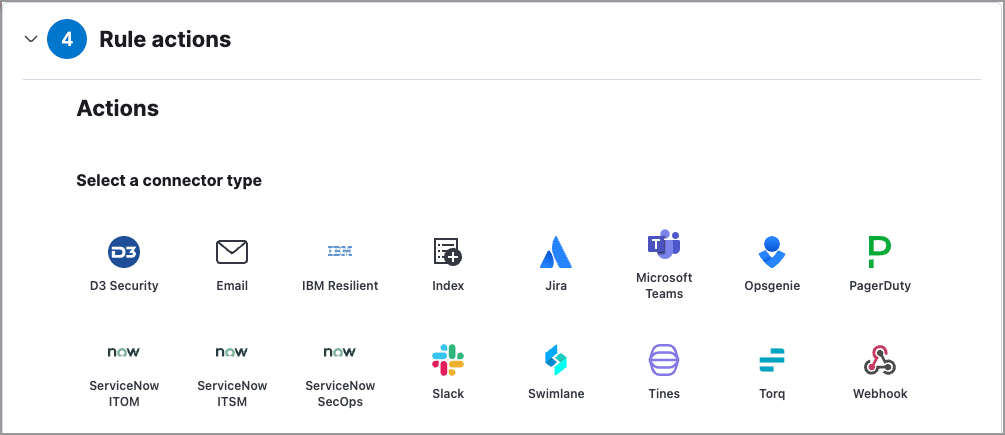
Der einfachste Weg, Ihre Alerts an Tines zu senden, ist die Konfiguration und Nutzung des integrierten Tines-Connectors in Elastic, der Ihre Alerts zur Verarbeitung an eine Tines-Story sendet.
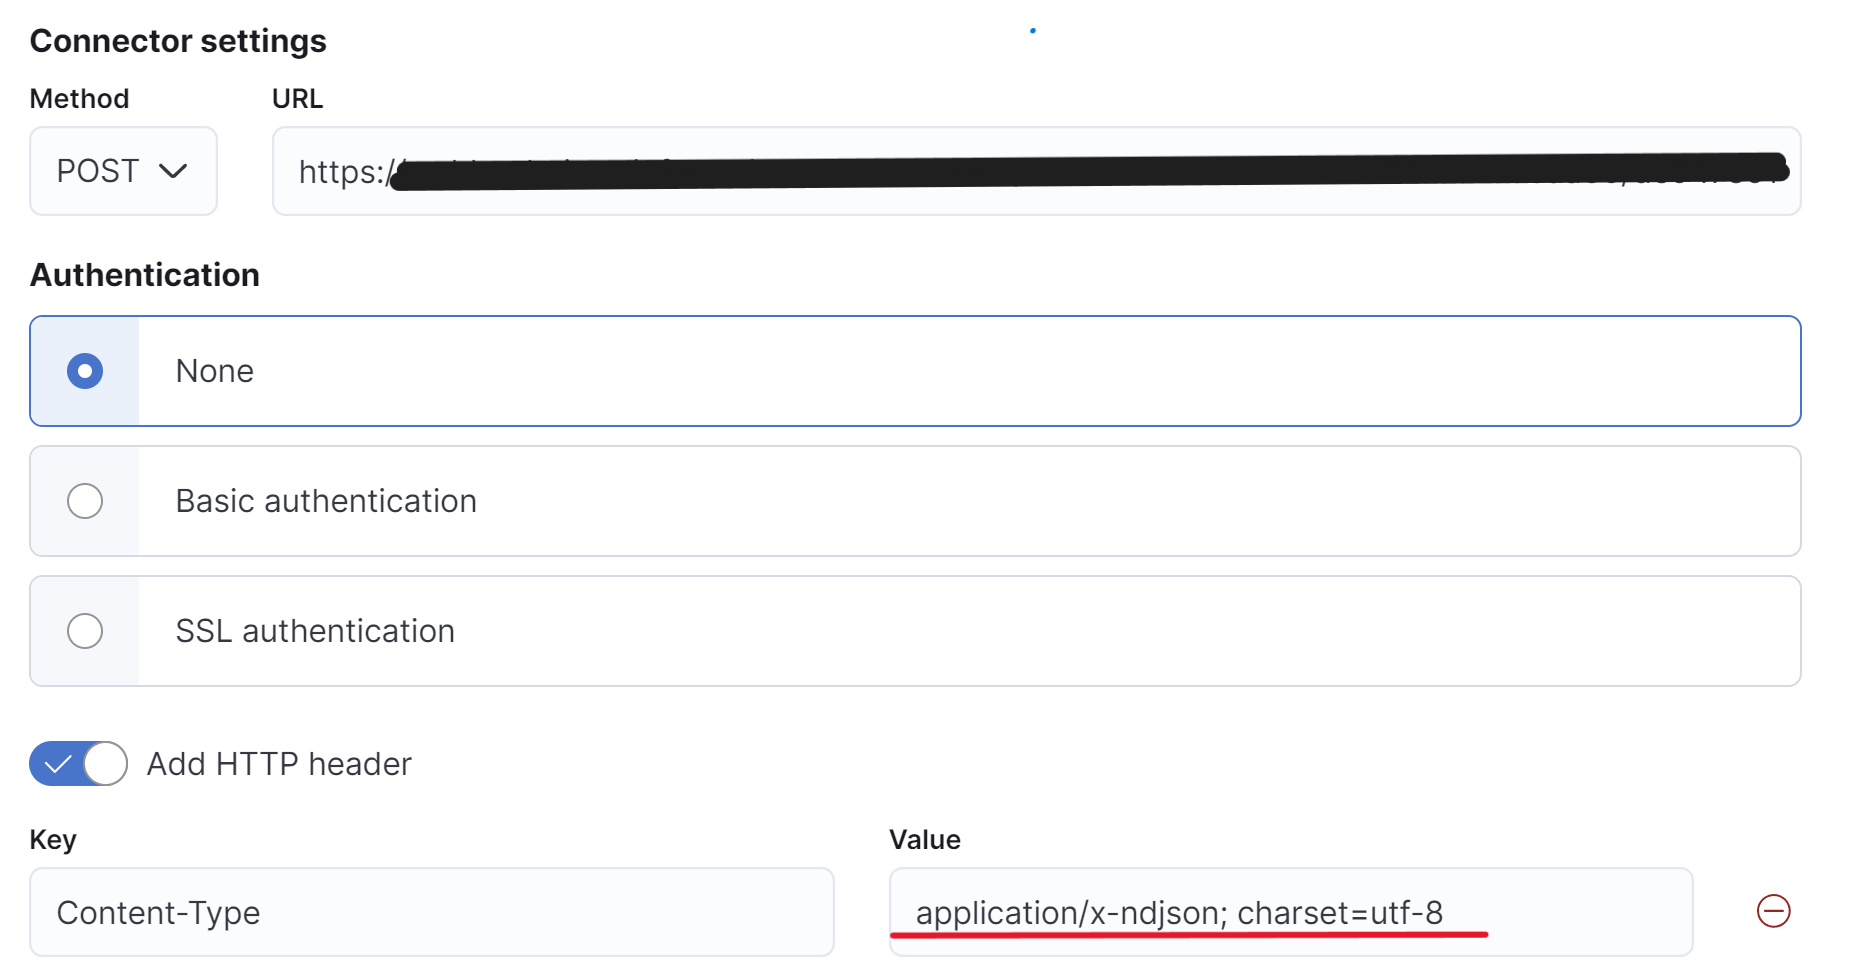
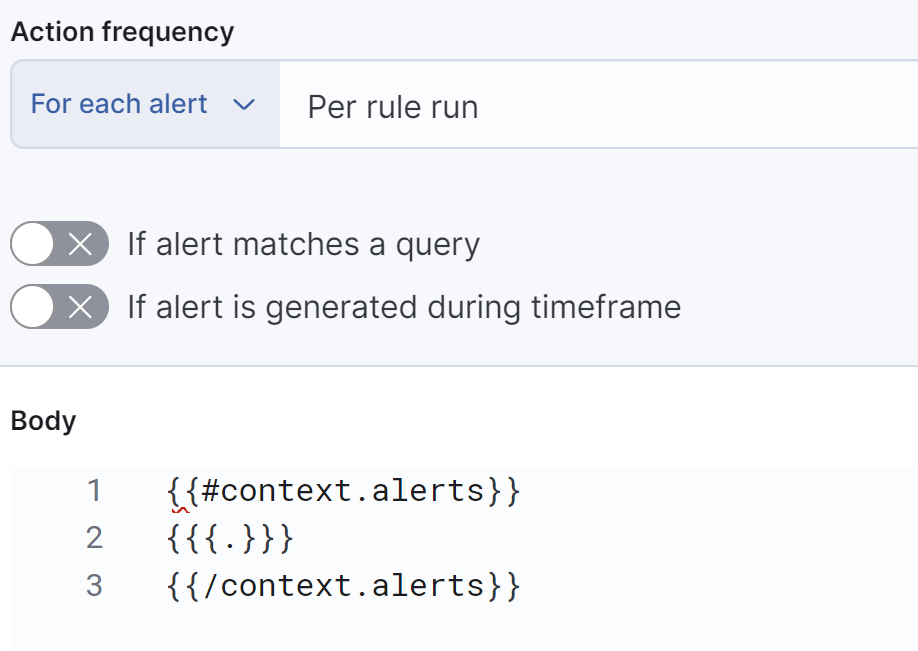
Die andere Option ist die Verwendung des Webhook -Connectors, der sehr flexibel ist, da er es Ihnen ermöglicht, einen Teil des Alerts oder den gesamten Inhalt des Alerts im ndjson-Format an einen empfangenden Webhook zu senden. Wir verwenden Tines intern bei Elastic, seit es den Tines-Connector noch gar nicht gab, daher nutzen die meisten unserer Automatisierungen weiterhin den Webhook-Connector. Sie können die Alerts einzeln an den Webhook senden oder alle zusammen in einem einzigen ndjson. Wenn Sie benutzerdefinierte Skripte verwenden, können Sie diesen Connector nutzen, um die Alerts zu empfangen und zu verarbeiten; er funktioniert auch mit der Tines-Webhook-Aktion. Um den vollständigen Inhalt des Alerts an einen Webhook zu senden, müssen Sie einen Webhook-Connector so konfigurieren, dass er eine POST-Aktion verwendet, bei der der Content-Type auf application/x-ndjson; charset=utf-8 gesetzt ist.
Wählen Sie beim Hinzufügen der Aktionen zu Ihren Regeln den konfigurierten Webhook-Connector aus und verwenden Sie die folgende Mustache-Syntax in Ihrer Konfiguration, um den vollständigen Alarm als ndjson an den Webhook zu senden.
Verwendung von Tags zur Steuerung der Automatisierung
Beim Aufbau dieser Automatisierungen begannen wir damit, für jeden Alert individuell einen benutzerdefinierten Automatisierungspfad zu erstellen, stellten jedoch sehr schnell fest, dass dies nicht skaliert. Unsere solutions bestand stattdessen darin, benutzerdefinierte Tags in unseren Erkennungsregeln zu verwenden, um die Regel an den entsprechenden Triage-Pfad weiterzuleiten. Wir senden den vollständigen Alert an Tines, der die Tags als Array im Feld signal.rule.tags enthält. Wir haben uns für die Namenskonvention Triage:{option} entschieden, um zu beschreiben, welche automatisierten Prüfungen für eine Regel durchgeführt werden. Erkennungsregeln können mehrere verschiedene Tags haben.
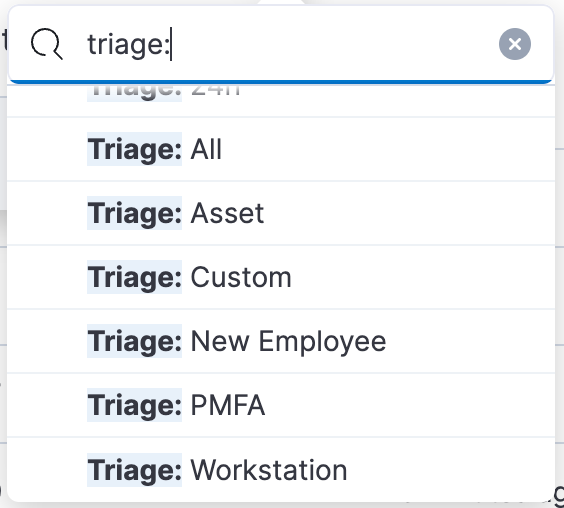
Hier ist eine Beschreibung der automatisierten Triage-Tags, die wir verwenden:
Triage: Alle leitet den Alarm durch die automatisierten Triage-Pfade für Assets, PMFA und Workstations. Wenn eine der Abfragen „true“ zurückgibt, wird der Alarm geschlossen. Wenn keine der Abfragen „true“ zurückgibt, wird der Alarm eskaliert.
Triage: Asset überprüft verschiedene Indexmuster, um festzustellen, ob die Quell-IP von einem Asset stammt, das Elastic besitzt oder in irgendeiner Weise verwaltet. Dies umfasst unsere interne Asset-Datenbank, die wir in Elastic speichern, interne Netzwerkzonen, unsere öffentlichen Elastic Cloud-IPs, CI/CD-Systeme sowie den öffentlichen IP-Adressraum autorisierter Drittsysteme wie Okta oder Tines.
Triage: PMFA prüft unsere Okta-Audit-Logs auf eine erfolgreiche Authentifizierung mittels phishing-resistenter MFA, wie z. B. einem Passkey unter Verwendung von Okta Verify oder Windows Hello. Wir verwenden die Okta-Integration, um unsere Okta-Audit-Logs zu erfassen.
Triage: Workstation überprüft unsere Nginx-Proxy-Logs auf erfolgreiche Verbindungen von Elastic Defend zu unserem Fleet-Server von der IP-Adresse aus. Elastic ist ein verteiltes Unternehmen und Mitarbeiter können von überall auf der Welt arbeiten, aber ihre Elastic Defend-Agenten verbinden sich regelmäßig, sodass wir normalerweise sehen können, dass die verwaltete Workstation eines Elastic-Mitarbeiters von derselben IP aus verbunden war, die den Alert generiert hat.
Triage: New Employee überprüft unsere Asset-Datenbank, die einen täglichen Bericht aller aus unserem HR-System exportierten Mitarbeiter enthält, um festzustellen, ob es sich bei dem Nutzer um einen neuen Mitarbeiter handelt. Dies ist wichtig für bestimmte Kategorien von Erkennungsregeln wie Slack UEBA, die normalerweise ausgelöst werden, wenn ein neuer Mitarbeiter seine Konten konfiguriert, aber selten bei bestehenden Mitarbeitern anschlagen.
Triage: 1h weist Tines an, die Alarm-Triage für 1 Stunde zu pausieren, bevor die restlichen Triage-Aktionen durchgeführt werden. Dies kann nützlich sein für Ereignisse wie die Konfiguration einer brandneuen Workstation durch einen Nutzer, bei denen der Alarm geschlossen werden kann, wenn die Workstation ordnungsgemäß registriert und bei unseren Endpoint-Management-Systemen angemeldet ist, die Elastic Defend installieren.
Triage: 24h weist Tines an, die Alarmtriage für volle 24 Stunden vor der Verarbeitung zu pausieren. Dies kann für einige Triage-Pfade erforderlich sein, bei denen die Daten nur täglich aktualisiert werden, wie etwa bei Teilen unserer Asset-Datenbank, die ein tägliches Inventar aller Computer, Nutzer und Cloud-Konten erfassen.
Triage: Benutzerdefiniert ist für alle benutzerdefinierten Triage-Pfade gedacht, die für einen Alarm erforderlich sein könnten. Ein gutes Beispiel hierfür ist ein Szenario, in dem wir einem Drittanbieter wie Okta einen hochprivilegierten API-Schlüssel zur Verfügung gestellt haben, der zum Erstellen oder Deaktivieren von Konten in Azure verwendet wird, und wir alarmiert werden möchten, wenn dieses API-Token jemals von einer IP-Adresse verwendet wird, die nicht zu Okta gehört. Dieser Alarm und die automatisierte Triage ermöglichen uns das Prinzip „Vertrauen, aber überprüfen“, falls der Speicher unseres API-Schlüssels durch Okta kompromittiert wird und außerhalb der IP-Bereiche von Okta verwendet wird.
Bausteine für die Automatisierung
Da wir nun den vollständigen Alert als JSON an unser SOAR senden, können wir ihn durch unseren Triage-Pfad und dann an andere Quellen wie Slack oder PagerDuty weiterleiten. In Tines gibt es sieben verschiedene Arten von Aktionen, die zum Erstellen Ihrer Storys verwendet werden können:
Die Webhook- Aktion gibt Ereignisse aus, die sie über Webhooks (HTTP-Callbacks) empfängt. Dies ist die primäre Methode zum Senden von Ereignissen an eine Story in Tines.
Die Aktion „E-Mail senden“ versendet E-Mails an die in den Aktionsoptionen angegebenen Empfänger.
Die Aktion „E-Mail empfangen“, früher als IMAP-Aktion bekannt, löst Ereignisse aus, wenn sie neue E-Mails auf einem IMAP-Server erkennt oder wenn E-Mails an eine eindeutig generierte E-Mail-Adresse gesendet werden.
Aktion zur Ereignistransformation verfügt über mehrere Modi, die den Inhalt empfangener Ereignisse ändern. Diese Aktionen sind äußerst flexibel und leistungsstark.
Die Aktion HTTP Request sendet HTTP-Anforderungen unter Verwendung verschiedener Methoden an eine angegebene URL.
Die Trigger- Aktion vergleicht den Inhalt eines Feldes aus einem eingehenden Ereignis mit vordefinierten Regeln. Wenn die Regeln übereinstimmen, wird ein Ereignis-Emit ausgelöst. Dies kann als „Wenn-Dann“-Logikaktion betrachtet werden.
Die Aktion „Send to Story“ sendet Ereignisse an eine andere Tines-Story (die Sub-Story). Nachdem die Sub-Story ihre Aktion abgeschlossen hat, gibt die Aktion „Send to Story“ ein Ereignis aus. Aktionen vom Typ „Send to Story“ ähneln Funktionen oder Bibliotheken im Code, bei denen Aktionen an mehreren Stellen wiederverwendet werden sollen.
Mithilfe dieser Aktionen können wir Automatisierungen erstellen, die uns monatlich Tausende von Arbeitsstunden einsparen.
Beispiel für einen vereinfachten automatisierten Triage-Workflow:
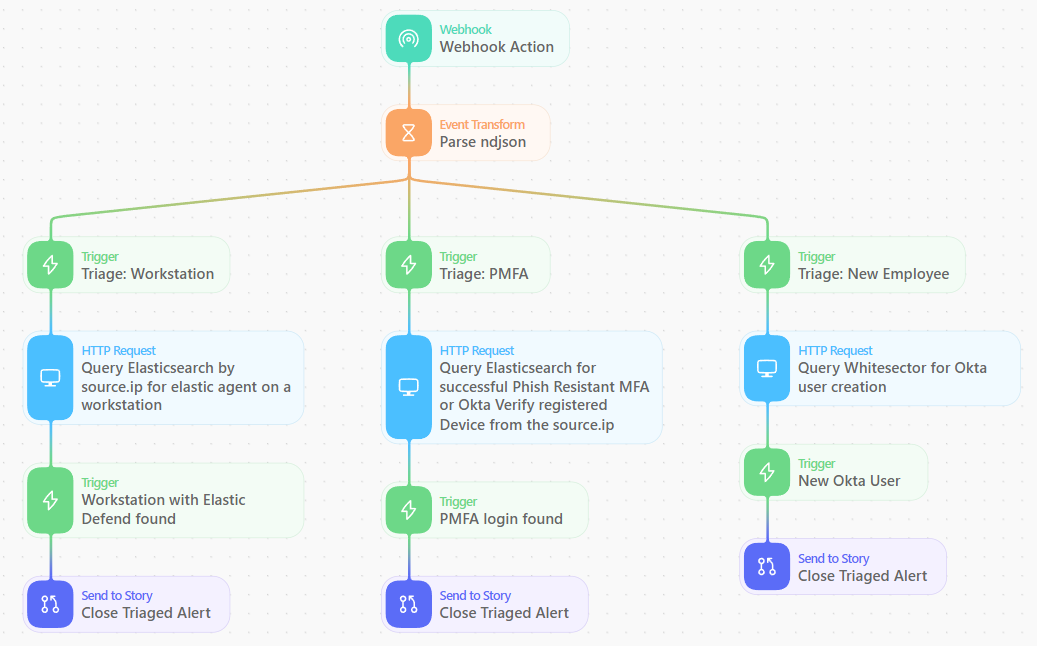
In dieser Automatisierungsgeschichte verarbeiten wir neue Alerts, sobald sie im Webhook eingehen, verwenden eine Event-Transform-Aktion, um das ndjson in ein Objekt zu parsen, auf das wir leichter verweisen können, und verwenden dann Trigger-Aktionen, um zu bestimmen, welche Triage-Pfade der Alert durchlaufen soll.
Die meisten HTTP-Anfrageaktionen sind Abfragen an die Elasticsearch- _search -API. In diesen Folgeabfragen verwenden wir Felder aus dem ursprünglichen Alert, wie z. B. source.ip oder user.email, um die Alerts zu priorisieren.
Tines bietet Hunderte von vorgefertigten Aktionstemplates, darunter mehrere für die Interaktion mit Elasticsearch. Sie können das Template „Query an Elasticsearch index for all records“ verwenden und dann das Payload ändern, um Ihre Abfrage unter Verwendung der Quell-IP aus dem Alert hinzuzufügen. Da die meisten Abfragen nach irgendwelchen Ereignissen von einer bestimmten source.ip suchen, empfehle ich, die Option „size“: 1 zu Ihren Abfragen hinzuzufügen, um die Geschwindigkeit und Leistung zu verbessern. Dies gibt ein Ergebnis zurück, falls Elasticsearch innerhalb der letzten 4 Stunden einen Treffer für die source.ip findet.
{
  "size": 1,
  "query": {
    "bool": {
      "must": [],
      "filter": [
        {
          "bool": {
            "should": [
              {
                "match_phrase": {
                  "source.ip": "<<extract_source_ip.source_ip>>"
                }
              }
            ]
          }
        },
        {
          "range": {
            "@timestamp": {
              "format": "strict_date_optional_time",
              "gte": "now-4h",
              "lte": "now"
            }
          }
        }
      ],
      "should": [],
      "must_not": []
    }
  }
}Nach jeder Abfrageaktion folgt eine Trigger-Aktion, um zu prüfen, ob Ergebnisse gefunden wurden. Wenn die Anzahl der Treffer größer als null ist, verwenden wir die Signals API, um den Alert zu schließen. Wenn null Ergebnisse vorliegen, setzen wir die Verarbeitung fort und gehen zur nächsten Aktion über. Wenn alle Aktionen null Ergebnisse zurückgeben, senden wir den Alert an Slack, um die Analysten zur Untersuchung zu benachrichtigen.
Dies sind die Beispiel-Einstellungen für eine Trigger-Aktion, die auf Ergebnisse einer Abfrage prüft:
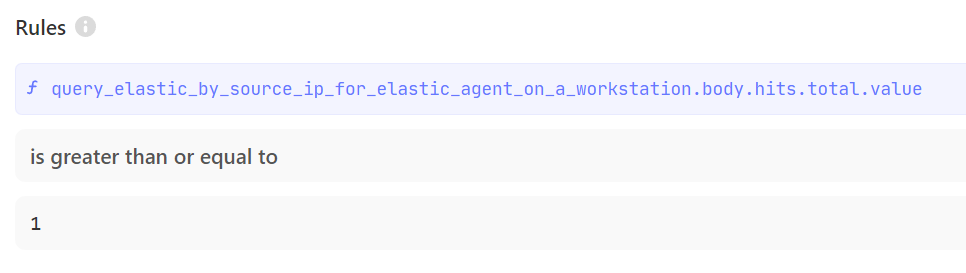
Indem wir die Logik verwenden, eine Elasticsearch-abfrage auszuführen und dann den Alert zu schließen, wenn es Ergebnisse gibt, können wir mehrere dieser Aktionen miteinander verketten, um umfassende Stories zu erstellen, die Alerts von bekannten guten IP-Adressen schließen.
Beispiel für die Triage verwalteter Workstations
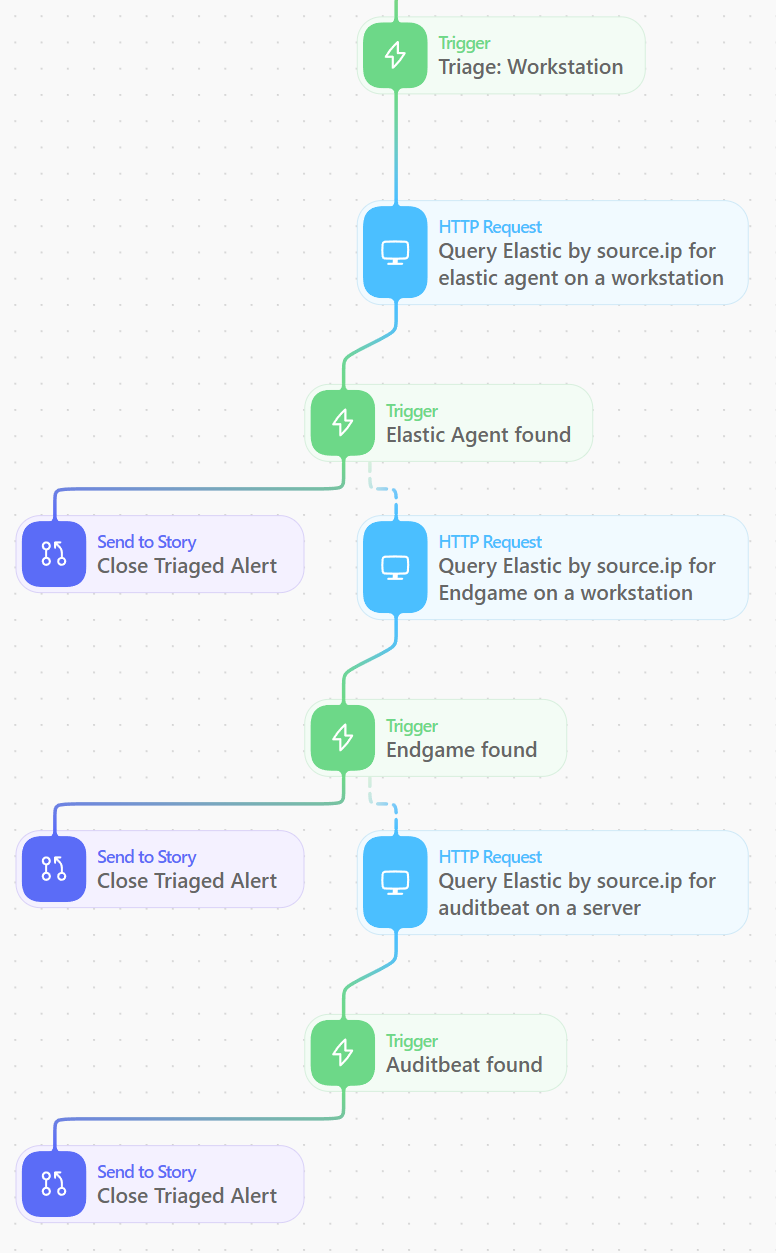
Im folgenden Beispiel-Story-Branch schließen wir jeden Alert, der von einer Workstation oder einem Server stammt, den wir verwalten. Elastic ist ein global verteiltes Unternehmen und die Mehrheit unserer Mitarbeiter arbeitet von zu Hause aus. Daher haben wir keine Möglichkeit vorherzusagen, von welcher IP-Adresse aus sie eine Verbindung zum Internet herstellen werden, und in vielen Fällen kann sich ihre öffentliche IP-Adresse mehrmals täglich ändern. Unsere Lösung, um die öffentlichen IPs dieser Workstations zuverlässig zu finden, während sie sich weltweit bewegen, besteht darin, den Elastic Agent auf den nginx-Proxys bereitzustellen, die vor unserer InfoSec-Infrastruktur sitzen.
Mithilfe dieser Daten können wir nun erfolgreiche Verbindungen über den Proxy identifizieren, der Elastic Agent-, Auditbeat- oder Endgame-Datenverkehr an unsere Cluster sendet. Auf allen unseren Cloud-Serversystemen sind Auditbeat oder Elastic Agent installiert. Daher erkennen diese Abfragen auch die öffentlichen IP-Adressen unserer Serversysteme, die regelmäßig geheime Schlüssel zum Ausführen von CI/CD- und DevOps-Pipelines verwenden.
Nachfolgend sehen Sie den Pfad in der Tines-Story, den wir verwenden, um eine verwaltete Workstation oder einen Server anhand einer Quell-IP zu überprüfen. Die gestrichelten Linien von den Trigger-Aktionen stellen den Pfad dar, den die Story durchläuft, wenn eine Trigger-Aktion nicht „true“ zurückgibt.
Der Alert „Schließen“ Senden an Story
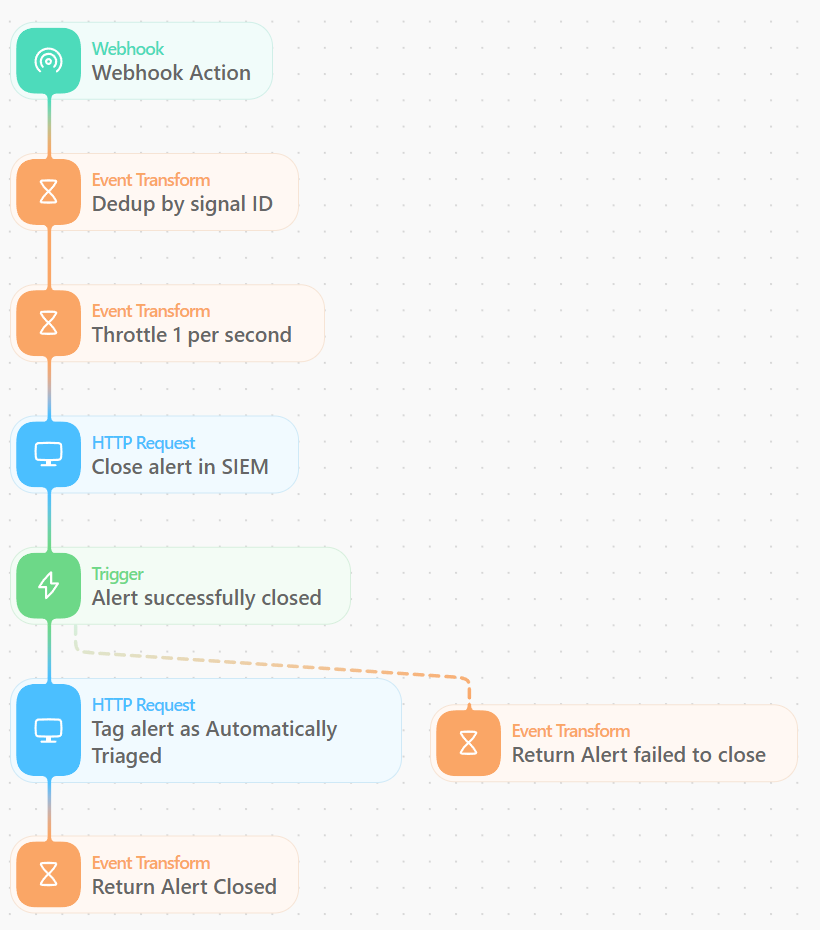
Sie haben vielleicht bemerkt, dass wir jedes Mal, wenn wir den Alert schließen möchten, eine „Send to Story“-Aktion in Tines verwenden. Diese Aktion sendet die von uns ausgewählten Felder über einen Webhook an eine neue Story in Tines, wo wir den Alert anschließend schließen und mit einem Tag versehen. Durch die Verwendung einer „Send to Story“-Aktion bleibt unsere Haupt-Story einfacher zu pflegen. Zudem können wir zusätzliche Funktionen hinzufügen, wie etwa die Deduplizierung anhand der Signal-ID, damit wir nicht versuchen, denselben Alert zweimal aus zwei verschiedenen Triage-Zweigen zu schließen, sowie eine Drosselungsaktion, um die API nicht zu überlasten, falls viele Alerts gleichzeitig eingehen.
Wir verwenden außerdem die Signals API, um die Regel-Tags zu aktualisieren, was für Metriken und die Nachverfolgung des Status von Alerts nützlich sein kann. Alle Alerts, die wir mit unserem automatisierten Triage-Workflow schließen, werden zudem als Automated Triage markiert, sodass wir die Anzahl der triagierten Alerts pro Monat nachverfolgen und in der SIEM-Benutzeroberfläche leicht erkennen können, ob ein Alert durch die Automatisierung oder durch einen Analysten geschlossen wurde.
Eskalation offener Warnmeldungen an Slack
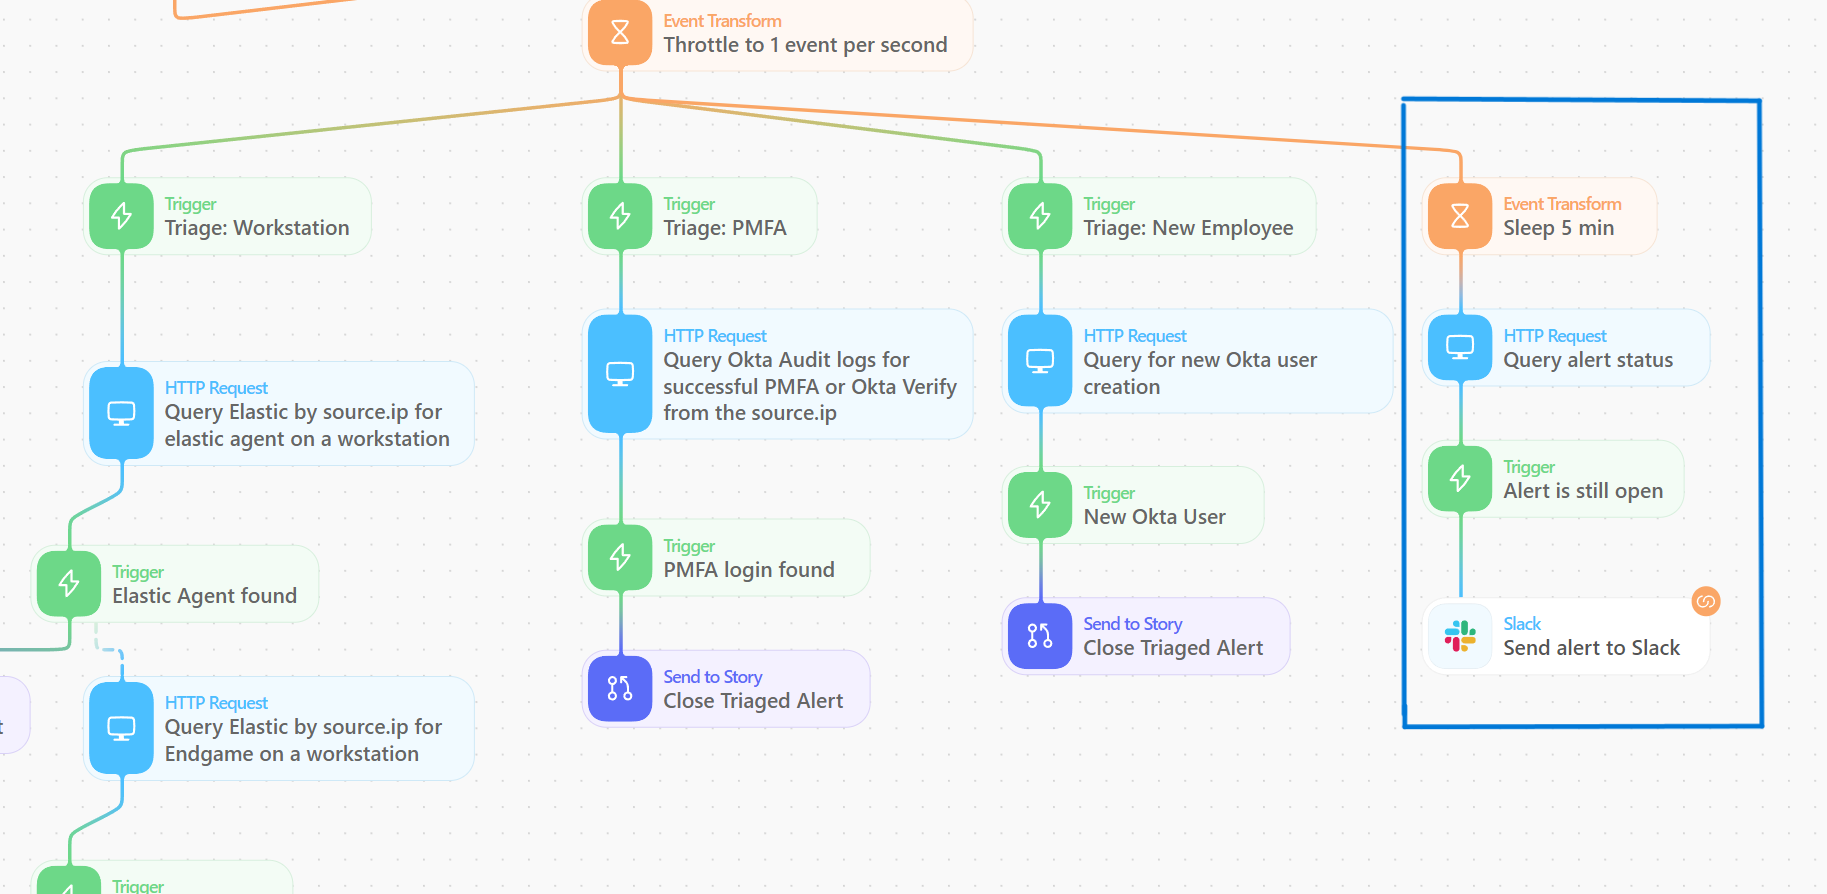
Da wir die Warnmeldungen parallel durch die verschiedenen automatisierten Triage-Pfade senden, leiten wir die Story auch auf einen Pfad, bei dem wir die Verarbeitung für 5 Minuten pausieren. Diese 5-minütige Pause gibt den anderen Zweigen Zeit, abzuschließen und alle Warnmeldungen zu schließen, die von einer vertrauenswürdigen Quell-IP stammen. Nach der 5-minütigen Pause senden wir eine Anfrage an die Signals-Such-API, um zu prüfen, ob die Warnmeldung noch offen ist. Wenn die Warnmeldung noch offen ist, senden wir eine Nachricht an unseren Slack-Channel für Warnmeldungen, um die SOC-Analysten darüber zu informieren, dass eine Warnmeldung nicht automatisch triagiert wurde.
Wenn Sie dieser Story weitere Funktionen hinzufügen möchten, macht es Tines einfach, einen weiteren Zweig zur Story zu erstellen, um zusätzliche Möglichkeiten hinzuzufügen. Wenn Sie beispielsweise ein SLA haben, das erfordert, dass Sie kritische oder hochgradig schwerwiegende Alerts innerhalb eines bestimmten Zeitraums bestätigen, könnten Sie eine Logik hinzufügen, die eine Stunde wartet und dann prüft, ob der Alert im Elastic SIEM bestätigt wurde. Wenn der Alert noch offen ist und niemandem zugewiesen wurde, können Sie ihn eskalieren, indem Sie einen Alert an PagerDuty oder eine zweite Slack-Nachricht an ein anderes Team senden.
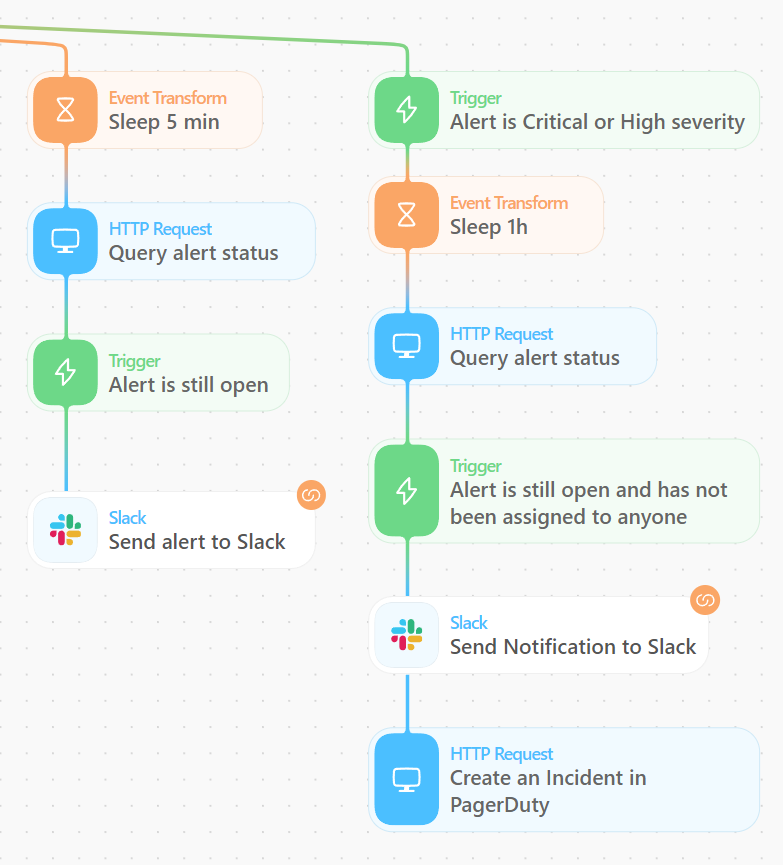
Tines enthält auch Vorlagen für die Arbeit mit Tickets in Elastic Security – mit ein paar zusätzlichen Aktionen in diesem Branch könnten Sie ein neues Ticket öffnen, es dem Analysten in Rufbereitschaft zuweisen und die Alert-Details zum Ticket hinzufügen.
Herausforderungen, denen wir begegnet sind
Nichts im Bereich Sicherheit ist perfekt, und für jede Sicherheitskontrolle gibt es Möglichkeiten für Bedrohungsakteure, diese zu umgehen. Aber nur weil etwas nicht perfekt ist, bedeutet das nicht, dass es die Mühe nicht wert ist. Eine der offensichtlichen Schwächen ist, dass diese Alerts bei Insider-Bedrohungen nur begrenzt wirksam sind. Wenn ein Bedrohungsakteur über eine kompromittierte Workstation, einen Server oder eine VPN-Verbindung des Unternehmens agiert, kann er von einer als sicher bekannten IP-Adresse kommen, und bei Regeln mit automatisierten Triage-Workflows würden Alerts automatisch geschlossen werden.
Dafür habe ich zwei Argumente: Erstens ist es ohne diese Automatisierung unmöglich, die meisten dieser Erkennungen ohne Hunderte zusätzlicher Mitarbeiter bereitzustellen. Trotz ihrer Schwächen bieten diese automatisierten Erkennungen eine bessere Transparenz als ohne. Die priorisierten Alarme können für das Threat Hunting verwendet und in Erkennungen einbezogen werden, die bei mehreren unterschiedlichen Erkennungsregeln für einen Host oder Nutzer Alarm schlagen, sodass sie dennoch einen Mehrwert bieten.
Zweitens: Wenn wir Bedrohungsakteure dazu zwingen können, ihre Taktik zu ändern – etwa indem wir sie dazu zwingen, eine unserer Workstations oder einen unserer Server zu kompromittieren und von dort aus weiterzugehen –, erhöht das die Chancen auf eine Erkennung drastisch. Unsere Workstations und Server sind umfassend mit Elastic Defend ausgestattet und verfügen über mehr als tausend Erkennungsregeln. Wir haben festgestellt, dass Bedrohungsakteure meistens, wenn sie SaaS-Anmeldeinformationen oder ein geheimes API-Token kompromittieren, die Verbindung zum Dienst direkt von ihrer eigenen Infrastruktur aus herstellen und nicht über einen kompromittierten Host.
Die andere große Herausforderung beim Aufbau dieser Erkennungen ist Shadow IT sowie alle Verbindungen und Vertrauensstellungen mit Drittanbietern in einem modernen IT-System. Shadow IT ist ein Begriff, der beschreibt, wenn ein Team im Unternehmen eigene IT-Systeme einrichtet, ohne alle ordnungsgemäßen Kanäle zu durchlaufen, um die Systeme zum Bestandsverzeichnis hinzuzufügen und Elastic Agent oder Auditbeat zu installieren.
Wenn Sie diese Triage-Workflows erstellen und definieren, was eine „bekannte gute IP“ ist, werden Sie zwangsläufig auch feststellen, dass API-Token auf autorisierte Weise von IP-Adressen verwendet werden, die nicht zu Ihrem Unternehmen gehören. Diese Token werden normalerweise für verschiedene Automatisierungen von Drittanbietern wie GitHub Actions oder durch Scan-Anwendungen wie Qualys oder Snyk verwendet. Das Aufspüren dieser Elemente und das Erstellen der Ausnahmen kann Zeit in Anspruch nehmen, ist aber auch sehr wertvoll, wenn Sie Schatten-IT identifizieren und entfernen.
In einigen Fällen veröffentlichen Drittanbieter wie Okta, GitHub oder Elastic Cloud ihre öffentlichen IP-Bereiche, sodass Sie zusätzliche Prüfungen erstellen können, um Aktivitäten von diesen IPs herauszufiltern. Wenn Sie einen Tines-Cloud-Mandanten verwenden, können Sie die aktuelle öffentliche IP-Adresse Ihres Mandanten unter https://<tenant-domain>/info abrufen.
Beispiel-Erkennungen
Diese Automatisierungen begannen ursprünglich als Lösung für eine einzelne Erkennungsregel, aber wir haben festgestellt, dass sie für viele verschiedene Szenarien äußerst wertvoll sind. Bei vielen Ihrer Erkennungsregeln können Sie sich fragen: „Wenn dieser Alert durch eine IP-Adresse ausgelöst wird, von der wir bestätigt haben, dass sie uns gehört, würde unser SOC den Alert schließen?“ Wir haben festgestellt, dass dies für die meisten verhaltensbasierten Erkennungsregeln für Dienste von Drittanbietern zutrifft, was sie zu guten Kandidaten für eine automatisierte Triage macht.
Hier ist eine Liste einiger Erkennungen, für die wir die erste Triage automatisieren, um Ihnen einige Ideen für Erkennungen zu geben, die Sie mit diesem Workflow erstellen können. Einige dieser Erkennungen sind benutzerdefinierte Erkennungen, die für die Zusammenarbeit mit diesem automatisierten Triage-Workflow entwickelt wurden, aber viele davon sind bestehende Erkennungen, denen wir Triage-Tags hinzugefügt haben, um einige falsch-positive Ergebnisse zu eliminieren.
Okta-Authentifizierung mit hohem Risiko
Okta-Support-Aktivität von einer Nicht-Okta-IP
Okta-API-Aktivität von einer neuen IP
Okta UEBA: mehrere verschiedene Warnmeldungen für dieselbe E-Mail-Adresse und IP-Adresse
Okta: mehrere E-Mail-Adressen mit einem einzigen dt-Hash erkannt
Erfolgreiche Okta-Nutzeranmeldung ohne phishing-resistente MFA
Okta-Authentifizierung durch MFA-befreites Konto von einer neuen IP-Adresse
Hohe Anzahl von Versuchen zum Zurücksetzen oder Entsperren von Okta-Nutzerpasswörtern
Mehrere Okta-Nutzerauthentifizierungsereignisse mit demselben Device-Token-Hash hinter einem Proxy
Okta-Nutzersitzungen, die von verschiedenen geografischen Standorten aus gestartet wurden
Slack UEBA: mehrere verschiedene Alerts für einen Slack-Nutzer
Google Cloud Platform Portal-Anmeldung von einer neuen IP-Adresse
Google Cloud Platform IAM-Aktivität von einer neuen IP-Adresse
Buildkite-Webaktivität von einer neuen IP-Adresse
Buildkite-API-Aktivität von einer neuen IP-Adresse
GitHub: Mehrfacher UEBA-Alert für ein GitHub PAT
GitHub: Anstieg bei Nutzern, die private Repos klonen
Hashicorp Vault: Mehrere UEBA-Warnmeldungen für einen Vault-Nutzer
Azure Active Directory-Authentifizierung mit hohem Risiko
Azure-Portal-Anmeldung von einer neuen IP-Adresse
Azure Active Directory PowerShell-Anmeldung von einer neuen IP-Adresse
Azure Active Directory-Gerätecode-Authentifizierung
Erfolgreiche Anmeldung bei Azure Active Directory ohne MFA
AWS-IAM-Aktivität von einer neuen IP-Adresse
AWS Key UEBA: mehrere verschiedene Alerts für einen AWS-Key
AWS-Nutzer UEBA: Mehrere verschiedene Warnmeldungen für ein AWS-Konto
Authentifizierung an der AWS-Konsole von einer neuen IP-Adresse
Versuche, ein Microsoft 365-Nutzerkonto per Brute Force anzugreifen
O365-Fehler bei übermäßig vielen Single Sign-On-Anmeldungen
Spitzenwert bei erfolgreichen Anmeldeereignissen von einer Quellen-IP
Ein neues Schutzniveau erreichen
In diesem Blogbeitrag habe ich Ihnen gezeigt, wie das InfoSec-Team von Elastic Tines nutzt, um die erste Triage vieler unserer Alerts zu automatisieren. Diese Automatisierung ermöglicht uns eine deutlich bessere Transparenz bei gleichzeitiger Steigerung der Effizienz und erlaubt es uns, unsere Zeit für die Untersuchung der tatsächlichen Bedrohungen aufzuwenden. Mit Tines konnten wir in den letzten 30 Tagen über 50.000 Alerts vollständig untersuchen und schließen. Jeder dieser Alerts wurde gründlich untersucht und innerhalb von Sekunden nach der Auslösung geschlossen. Ohne dies wäre es unmöglich, das gleiche Schutzniveau in unserem Netzwerk zu erreichen.
Wenn Sie dies selbst ausprobieren möchten, können Sie dies kostenlos mit einer 14-tägigen Testversion von Elastic Cloud und der dauerhaft kostenlosen Community Edition von Tines tun, um zu sehen, wie leistungsfähig diese Workflows für Sie sein können.
Die Entscheidung über die Veröffentlichung der in diesem Blogeintrag beschriebenen Leistungsmerkmale und Features sowie deren Zeitpunkt liegt allein bei Elastic. Es ist möglich, dass noch nicht verfügbare Leistungsmerkmale oder Features nicht rechtzeitig oder überhaupt nicht veröffentlicht werden.
Teilen
- Share on Twitter
Auf Twitter teilen
- Share on LinkedIn
Auf LinkedIn teilen
- Share on Facebook
Auf Facebook teilen
- Share by Email
Per E-Mail teilen
- Print this page
Drucken