Elastic auf Elastic: ein umfassender Einblick in unsere SIEM-Architektur
Elastic auf Elastic
Das Elastic Infosec-Team für Erkennungen und Analytik ist für die Entwicklung, Feinabstimmung und Pflege der Sicherheitserkennungen verantwortlich, die zum Schutz aller Elastic-Systeme verwendet werden. Bei Elastic nennen wir uns Customer Zero (Kunde Null) und wir bemühen uns, stets die neuesten Versionen unserer Produkte zu verwenden.
In dieser Reihe von Blogbeiträgen geben wir einen Überblick über unsere Architektur, darüber, welche Daten wir an unsere Cluster senden, wie und warum wir Cross Cluster Search (CCS) mit den Anwendungen Security und Machine Learning (ML) verwenden und wie wir diese Warnmeldungen optimieren, verwalten und Analysten darüber benachrichtigen.
Überblick über die Elastic-Infosec-Umgebung
Viele Cybersicherheitsprodukte und Sicherheitskontrollen sind darauf ausgelegt, ein traditionelles „Unternehmensnetzwerk“ mit Workstations und Servern in einem lokalen Netzwerk zu unterstützen, das durch eine Firewall geschützt ist. Wenn ein Alarm ausgelöst wird und Sie forensische Untersuchungen auf einem Host durchführen müssen, gehen Sie persönlich ins System, um den Speicher auszulesen und ein Abbild der Festplatte zu erstellen. Bei Elastic sind wir bewusst kein „traditionelles“ Unternehmen, daher muss das Infosec-Team innovativ und flexibel sein, um Elastic zu schützen, ohne zu versuchen, das Unternehmen „im Namen der Sicherheit“ in ein Schema zu pressen. Glücklicherweise ist der Elastic Stack die perfekte Lösung dafür.
Elastic ist ein weltweit tätiges Unternehmen, das von Grund auf dezentral organisiert ist und Kunden sowie Mitarbeiter in über 80 Ländern auf der ganzen Welt hat. Die meisten unserer Mitarbeiter arbeiten zu 100 % remote und erledigen ihre tägliche Arbeit auf einem Elastic-eigenen Laptop, der über nicht vertrauenswürdige Netzwerke auf der ganzen Welt mit dem Internet verbunden ist. Als Open-Source-Unternehmen ist unser Quellcode auf GitHub verfügbar, und unsere Continuous-Integration- und Software-Build-Systeme sind cloudbasiert und für Mitwirkende öffentlich sichtbar. Für die erfolgreiche Überwachung und forensische Untersuchung dieses modernen, verteilten Unternehmensnetzwerks müssen die richtigen Informationen erfasst werden und den Analysten vollständig an einem zentralen Ort zur Verfügung stehen.
Zusätzlich zu unseren Workstations und Unternehmenssystemen überwachen und schützen wir Elastic Cloud. Elastic Cloud stellt Elastic-SaaS-Dienste bereit, die derzeit auf mehr als 37.000 Elastic-Clustern in über 40 Cloud-Regionen laufen, die in AWS, GCP, Azure und IBM gehostet werden. Elastic Cloud ist eine separate Umgebung mit erweiterten Berechtigungen, die vom Cloud-Team verwaltet wird, aber das Elastic Infosec-Team ist auch dort für das Erstellen, Überwachen und Reagieren auf Warnmeldungen verantwortlich.
Die Elastic Infosec-Infrastruktur, genauer betrachtet
Das Security-Engineering-Team (SecEng) von Infosec entwickelt und pflegt unsere Sammlung von Clustern mithilfe von Elastic Cloud auf Kubernetes und Helm, um Infrastruktur bereitzustellen und auf dem neuesten Stand zu bleiben. SecEng verwaltet sieben verschiedene Cluster; sechs „Daten“-Cluster mit unterschiedlichen Rollen und einen siebten „Search-Head“-Cluster als unser Sicherheitsinformations- und Ereignismanagement (SIEM), der mithilfe von CCS die Daten in allen anderen Clustern abfragt und Warnmeldungen dazu auslöst. Wir verwenden die neuesten Stack-Versionen und Release-Kandidaten mit realen Daten, sodass Stack-Entwickler regelmäßig unsere Cluster nutzen, um Probleme zu finden und zu beheben und den Elastic Stack für unsere Kunden zu verbessern.
Der Schlüssel dazu, eine Organisation erfolgreich überwachen und schützen zu können, besteht darin, die richtigen Daten zu erfassen und sie an einem zentralen Ort durchsuchbar zu machen. Für Infosec gibt es keine einzelne Datenquelle, die alles enthält, was Sie benötigen. Eine häufige Herausforderung für viele Organisationen besteht darin, dass sie zwar die richtigen Datentypen protokollieren und speichern, die einzelnen Datentypen jedoch jeweils an einem eigenen, separaten Ort gespeichert werden. Manchmal müssen die Daten aufgrund unterschiedlicher Sensibilitäts- oder Datenschutzstufen getrennt bleiben; häufig werden die Datenquellen von unterschiedlichen Teams betrieben und gepflegt, und manchmal liegt es an den Kosten für die Übertragung der Daten an einen zentralen Ort. Dank der Leistungsfähigkeit von CCS können wir die Daten in separaten Clustern speichern und dennoch über eine einzige Kibana-Schnittstelle nach diesen Daten suchen und Warnmeldungen dazu auslösen, sodass Analysten ein vollständiges Bild erhalten.
Wenn alle Informationen an einem einzigen Ort sichtbar sind, können die Analysten ihre Umgebungen für Erkennung, Threat Intel und Incident-Response innerhalb des Elastic Stack aufbauen. Wenn wir eine Warnmeldung untersuchen, können wir in der Security-App Timelines verwenden, um eine Warnmeldung zu untersuchen, indem wir jeden Index nach einem Wert abfragen. Zusätzlich zu den Timelines in der Security-App verwenden wir auch mehrere benutzerdefinierte „Investigation“-Dashboards, um uns benötigte Informationen aus all den verschiedenen Indizes schnell anzeigen zu lassen.
Szenario für eine kritische Warnmeldung
Stellen Sie sich ein Szenario vor, in dem wir eine kritische Warnmeldung erhalten, derzufolge das Okta-Konto eines Mitarbeiters möglicherweise kompromittiert wurde. Wir können außerdem sehen, dass es im letzten Monat einige Verhaltenswarnmeldungen mit geringem Risiko für den Arbeitsplatzrechner dieses Nutzers gab, die zunächst als Fehlalarme abgetan wurden, nun aber erneut geprüft werden müssen. Wir können das Dashboard zur Nutzeruntersuchung verwenden, um anhand der E-Mail-Adresse dieses Nutzers zu suchen und schnell dessen gesamte Okta-Authentifizierungsaktivitäten, alle über Okta Single Sign On aufgerufenen Apps, alle Google-Drive-Dateien, auf die zugegriffen oder die geändert wurden, die GitHub-Aktivitäten in diesem Zeitraum sowie alle o365-Dateien zu überprüfen, auf die während des Zeitraums zugegriffen wurde, in dem das Konto möglicherweise kompromittiert war. Ein Dashboard-Panel zeigt das JAMF-Systeminventar zum Arbeitslaptop, der diesem Nutzer ausgehändigt wurde, sowie die Kontaktinformationen des Nutzers an.
Mithilfe der Systeminformationen können wir zum Dashboard „Host Investigation“ wechseln, um alle Aktivitäten auf diesem System zu sehen und festzustellen, ob auch dieses oder nur das Okta-Konto kompromittiert wurde. Dass zum Zeitpunkt der Warnmeldungen kein Nutzer angemeldet war, zeigt uns, dass das System möglicherweise kompromittiert ist und isoliert werden muss. Die Okta-Ereignisse enthalten die IP-Adresse, die für die Anmeldung verwendet wurde; wir können auch nach dieser IP suchen, um festzustellen, ob sie zu diesem Zeitpunkt in einem unserer anderen Datensätze wie den Cloud-Diensten vorkam.
Untersuchungen wie diese können äußerst zeitaufwendig sein, wenn Ihnen nicht alle Ereignisse an einem zentralen Ort zur Verfügung stehen. Ohne eine zentralisierte Erfassung Ihrer Ereignisse müssen Sie sich bei den Administrationskonsolen der einzelnen gehosteten Dienste anmelden, um die Logs in deren Umgebung zu überprüfen.
Cross-Cluster-Suche ist ein echter Gewinn
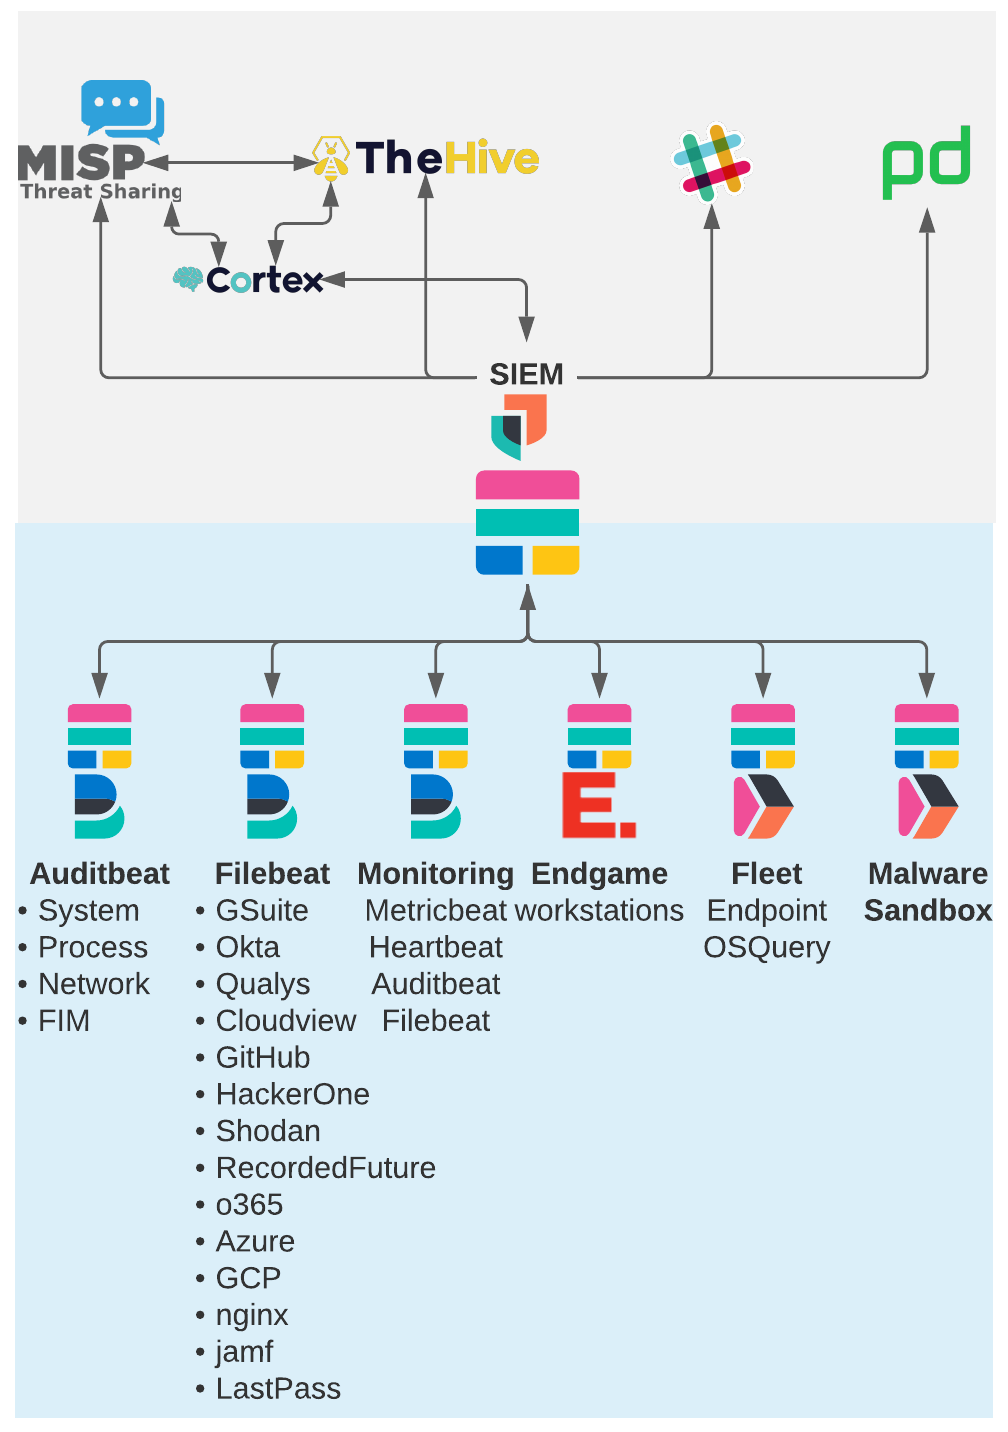
Der ursprüngliche Grund, aus dem wir uns für CCS entschieden, war, dass wir bereits Cluster mit den Daten hatten, aber alle unsere Daten von einem einzigen Cluster aus durchsuchbar machen wollten, um die Verwaltung von Watchern, Dashboards, Machine-Learning-Jobs und Regeln der Erkennungs-Engine zu vereinfachen. Anstatt alle Daten in einen einzelnen Cluster zu migrieren, entschieden wir uns für CCS. Vor CCS mussten wir all diese Objekte und Konfigurationen in mehreren Clustern pflegen, wobei sich die Arbeit oft über die Cluster hinweg wiederholte.
Wenn wir eine Warnmeldung untersuchten, mussten wir zuvor mehrere Browser-Tabs öffnen, um die verschiedenen Datenquellen zum Ereignis anzuzeigen. Jetzt können wir beim Untersuchen einer Warnmeldung in der Security-App ein Ticket und eine Timeline erstellen, die alle mit dem Ticket zusammenhängenden Ereignisse enthält. Wenn wir beispielsweise eine Warnmeldung zu ungewöhnlichen Aktivitäten auf einem Server in den Auditbeat-Daten sehen und das Ereignis eine IP-Adresse enthält, können wir in einer Timeline über alle Indizes hinweg nach dieser IP-Adresse suchen und schnell feststellen, ob sie bei einem unserer anderen Dienste wie den Nginx-Proxy-Daten, Okta, GitHub, Cloudanbieter-Protokollen, Endgame-Workstation-Ereignissen oder anderen aufgetreten ist. Dank ECS haben die Felder in allen Indexmustern ein einheitliches Format, sodass eine Abfrage nach source.ip Dokumente aus jedem Index mit einem Treffer zurückgibt.
Zusätzlich zu diesen ursprünglichen Gründen haben wir viele weitere Vorteile dieses Setups festgestellt. Nachfolgend sind einige der vielen Vorteile aufgeführt, die wir bei der Verwendung von Cross Cluster Search für die Sicherheit festgestellt haben.
- Das Speichern verschiedener Datentypen in separaten Clustern bedeutet, dass wir keinen einzelnen Ausfallpunkt für all unsere Daten haben. Beim Upgrade eines Clusters stehen alle anderen Cluster zur Verfügung.
- Wir können Entwicklern Zugriff auf einen bestimmten Datencluster gewähren, damit sie Tests durchführen und Probleme beheben können, ohne ihnen Zugriff auf alle von Infosec verwendeten Daten zu gewähren.
- Daten aus Observability- und APM-Clustern sind für Sicherheitsanalysten während einer Untersuchung oft sehr hilfreich. Anstatt alle Daten zu duplizieren, können wir die Remote-Cluster zu unserer CCS-Konfiguration hinzufügen.
- Analysten können erweiterte Berechtigungen erhalten, um Warnmeldungen und Indizes im SIEM-Cluster zu erstellen und zu verwalten, während sie nur Lesezugriff auf die Originaldaten im Remote-Cluster haben. Dadurch erhalten Analysten in Kibana umfassende Möglichkeiten, während die Integrität der Originaldaten für Audit- und regulatorische Zwecke geschützt wird.
- Das Upgrade des primären „Search-Head“-Elastic-Clusters auf eine neue Version verschafft Ihnen Zugriff auf alle neuen Kibana-Features, auch wenn die anderen Cluster noch nicht aktualisiert wurden. Dies nimmt dem frühzeitigen und häufigen Upgrade Ihres produktiven SIEM viel Stress, da Sie so die neuesten Features testen können, ohne einen Ausfall der Cluster zu riskieren, die die eigentlichen Daten enthalten.
- Ab Version 7.13 müssen Fleet-Nutzer über Superuser-Berechtigungen auf dem Cluster verfügen. Wir können die Anzahl der Fleet-Administratoren im Fleet-Cluster sehr gering halten und gleichzeitig allen anderen Nutzern Lesezugriff auf die vom Fleet-Cluster erfassten Ereignisse gewähren.
Customer Zero – Fortsetzung
In diesem Beitrag haben wir einen Überblick darüber gegeben, wie das Infosec-Team von Elastic die zahlreichen Funktionen des Elastic Stack nutzt, um Daten aus vielen verschiedenen Datenquellen zu sammeln und Analysten einen hervorragenden Einblick in sicherheitsrelevante Ereignisse zu bieten.
Schauen Sie unbedingt wieder vorbei, wenn unser zweiter Teil dieser Reihe erscheint. Darin geht es um die Arten durchsuchbarer Daten im Elastic SIEM und darum, wie Sie Ihren Teams helfen können, ihre Arbeit zu vereinfachen und effizienter zu gestalten.