Elastic-Strategie für Daten-Tiering: Optimierung für eine resiliente und effiziente Implementierung

 Share on Twitter
Auf Twitter teilen

 Share on LinkedIn
Auf LinkedIn teilen

 Share on Facebook
Auf Facebook teilen

 Share by Email
Per E-Mail teilen

 Print this page
Drucken
Bei Elastic beginnen die meisten unserer erfolgreichen Kundenimplementierungen mit einem einzelnen Anwendungsfall, der auf die Erfüllung spezifischer Geschäftsanforderungen abzielt. Elastic wird oft zunächst eingeführt, weil Entwickler die gebotenen Features schätzen. Aufgrund der Flexibilität und Anpassbarkeit weiten Kunden ihre Nutzung jedoch häufig aus, um verschiedene Anforderungen zu erfüllen, wie etwa logging und Monitoring der Anwendungsleistung (meist: APM) monitoring, SIEM und Security Operations sowie noch komplexere Suchanwendungsfälle, bei denen die bereits in Elastic verfügbaren Daten genutzt werden.
In der heutigen IT-Umgebung reicht es nicht mehr aus, Daten (Logs, Traces, Metriken und Dokumente) lediglich zu speichern. Unternehmen benötigen eine Lösung, die es ihren Teams ermöglicht, schnell und effektiv auf diese Daten zuzugreifen und sie zu nutzen. Effizienz ist bei der Datenverwaltung der Schlüssel, da jedes Bit an gespeicherten Daten Kosten für Hardware, Lizenzierung, Wartung und Verwaltung verursacht.
In diesem Blog erläutern wir, wie Unternehmen mit großen Datenmengen optimieren können, wie sie Daten über verschiedene Tiers hinweg speichern, um Kosten zu sparen und einen größeren Nutzen aus ihren Daten zu ziehen.
Die Herausforderung: Effiziente Datenverwaltung und Skalierbarkeit
Unternehmen schätzen Elastic für seine Geschwindigkeit, Skalierbarkeit, Konfigurierbarkeit und Funktionalität. Aus diesem Grund finden sie häufig neue Anwendungsfälle für Elastic. Dies wird zu einer Herausforderung, wenn große Datenmengen ingestiert werden, ohne zu berücksichtigen, wie die Daten gespeichert, verwaltet und genutzt werden, was zu Engpässen bei der Datenverwaltung führen kann. Mit wachsenden Datenmengen haben aktuelle Setups Schwierigkeiten, neue Anforderungen zu bewältigen, und stoßen an die Grenzen ihrer Hardware und Lizenzen.
Wenn Ihr Unternehmen mit diesen Problemen konfrontiert ist, ist die Lösung einfacher zu bewältigen, als Sie vielleicht erwarten.
Die Lösung: Eine geschäftsorientierte Datenstrategie
Die Lösung für diese Herausforderung besteht darin, eine Datenstrategie zu definieren, die auf Ihre Geschäftsziele abgestimmt ist. Anstatt Daten auf der Grundlage willkürlicher Anforderungen zu erfassen und zu speichern, stellen Sie sich die folgenden Fragen:
Welche Daten müssen erfasst werden, um ein Geschäftsziel zu erreichen?
Wie oft werden diese Daten verwendet?
Gibt es ein Ablaufdatum, nach dem diese Daten nicht mehr wertvoll sind?
Gibt es Compliance-Anforderungen für diese Daten?
Basierend auf den Antworten auf die oben genannten Fragen können Unternehmen eine geschäftsorientierte Datenstrategie erstellen, um die Art und Weise der Datenspeicherung und -nutzung zu optimieren und ihre bestehenden Investitionen in Elastic zu maximieren.
Fallstudie
Um die Vorteile der Einführung dieser Strategie aufzuzeigen, betrachten wir ein Ticket eines Kunden, der diesen Prozess durchlaufen hat.
Dieser Kunde verarbeitet typischerweise 5 TB Daten pro Tag und bewältigt durchschnittlich 250.000 Ereignisse pro Sekunde. Gelegentlich steigt das Volumen jedoch auf 7 TB pro Tag und 350.000 Ereignisse pro Sekunde. Die Elastic-Implementierung für diesen Kunden konzentrierte sich darauf, ein hohes Volumen an Sicherheitsdaten zu ingestieren und sie dem Team des Sicherheit Operations Center (SOC) zur Verfügung zu stellen, damit dieses nach Informationen zu Cyber-Incidents und Betrugsuntersuchungen suchen kann.
Diese Implementierung war so erfolgreich, dass der Kunde neue Anwendungsfälle hinzufügte, die eine längere Datenaufbewahrung und schnellere Suchfunktionen für eine größere Bandbreite an Datenquellen erforderten. Sie zielten auf die folgenden Geschäftsergebnisse ab:
Log-Optimierung: Durch die Optimierung ihrer Datenebenen können Unternehmen ihre Log-Verwaltung verbessern. So stellen sie sicher, dass die richtigen Logs für die richtige Dauer aufbewahrt werden, was die Betriebseffizienz steigert und die Einhaltung von Compliance-Anforderungen unterstützt.
Verbesserte Lizenznutzung: Effizientes Speicher-Tiering bedeutet eine bessere Lizenznutzung, wodurch Unternehmen ihre vorhandenen Ressourcen optimal nutzen und potenziell unnötige Lizenzkosten vermeiden können.
Verbesserte geschäftliche Effizienz: Die Fähigkeit, effizienter Einblicke aus Logs zu gewinnen, kann zu einer verbesserten geschäftlichen Effizienz führen, was eine schnellere Entscheidungsfindung und eine fundiertere strategische Planung ermöglicht.
Onboarding neuer Anwendungsfälle: Mit optimierten Daten-Tiers können Unternehmen problemlos neue Anwendungsfälle integrieren und ihre Datenanalytik-Funktionen ohne nennenswerte Investitionen in die Infrastruktur erweitern.
Klare Datenstrategie: Optimiertes Daten-Tiering trägt zu einer klaren Datenstrategie bei und stellt sicher, dass Daten zuverlässig, leicht zugänglich und effektiv verwaltet werden, was den Grundstein für datengestützte Entscheidungsfindungen legt.
Datenschichtung
Data-Tiering ist ein komplexes und nuanciertes Thema, das einen eigenen Blogbeitrag verdient. Für die Definition einer Datenstrategie lassen sich die verschiedenen Daten-Tiers jedoch auf drei Hauptanwendungsbereiche vereinfachen: Ingest, Suchen und Speichern.
Ingest (Hot Tier): Ingest Daten so schnell wie möglich mit minimaler Latenz.
Suchen (Hot- und Warm-Tier): Suchen Sie Daten schnell und verarbeiten Sie große Datensätze.
- Speichern (Tier für „kalte“ und „eingefrorene“ Daten): Speichern Sie Daten so lange wie erforderlich und führen Sie Ad-hoc-Suchen mit geringer Häufigkeit durch.
Datenwachstum und Datenspeicherung
Das Verständnis der verschiedenen Anforderungen an die Datenaufbewahrung ist entscheidend für die Compliance und eine effiziente Datenverwaltung. Unterschiedliche Vorschriften erfordern variierende Aufbewahrungsfristen:
SOX-Aufbewahrungsanforderungen: 7 Jahre
Anforderungen an die HIPAA-Datenspeicherung: 6 Jahre
Anforderungen an die PCI-DDS-Datenspeicherung: 1 Jahr
Basel II-Anforderungen an die Datenaufbewahrung: 3–7 Jahre
DSGVO-Mitarbeiter-Einträge:
Löhne: 3 Jahre
Steuereinträge: 6 Jahre
Name, Adresse: 3 Jahre
- Fair Labor Standards Act: 2–3 Jahre
Bisherige vs. neue Architektur
Frühere Architektur
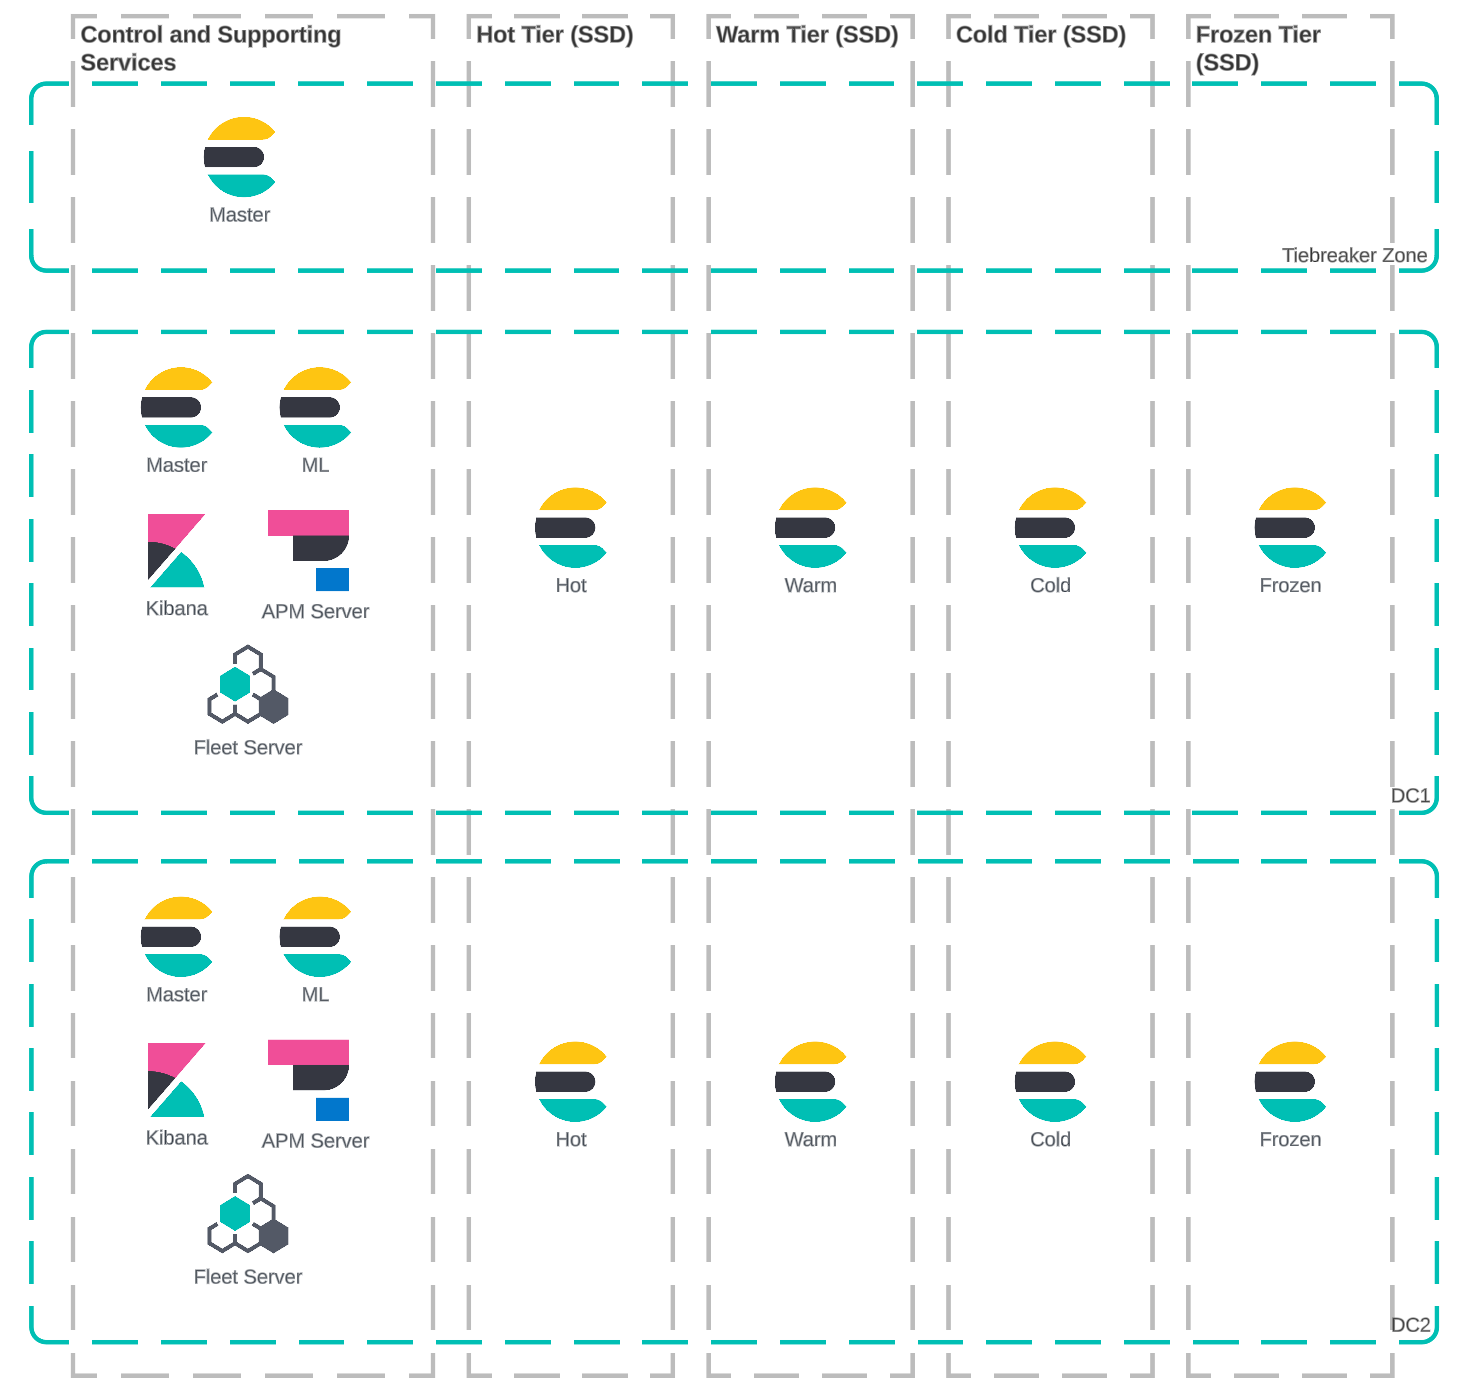
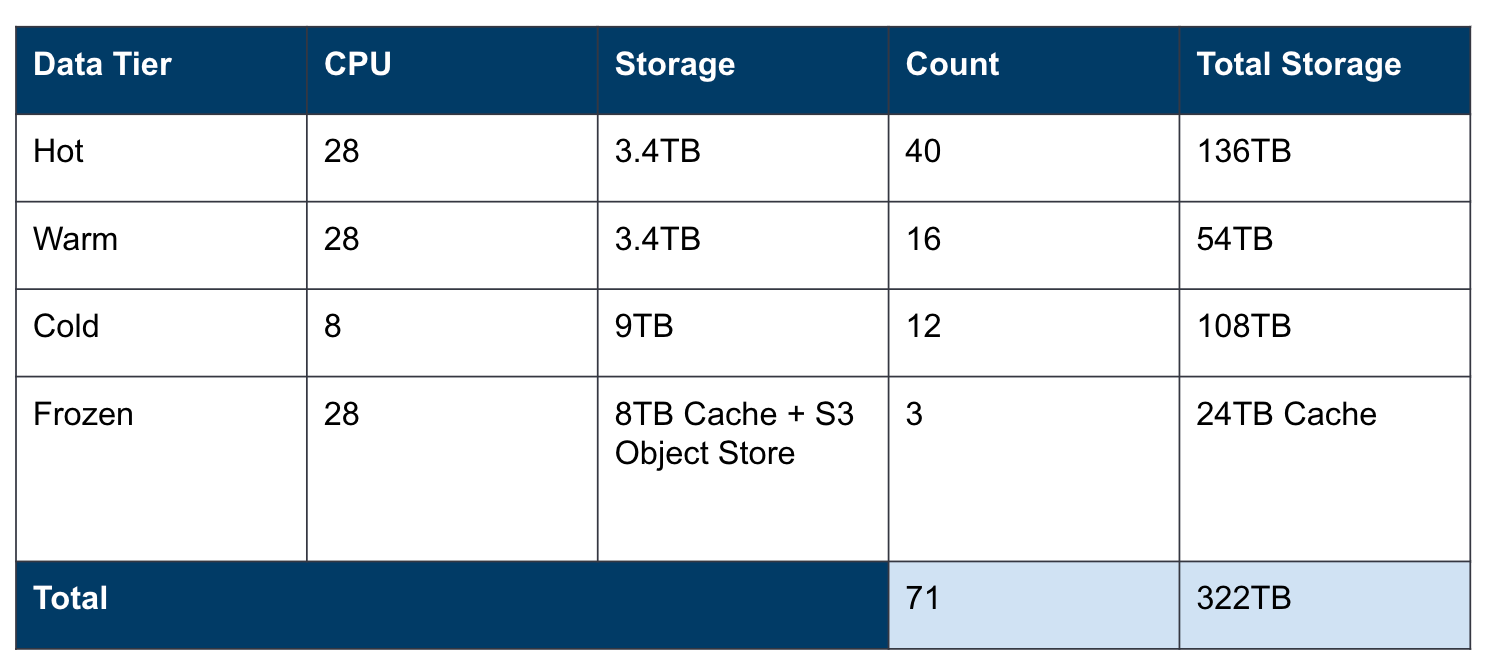
Die frühere Architektur verfügte über zwei Datenzentren mit einer vierstufigen Speicherimplementierung, die verschiedene Anforderungen an die Datenverarbeitung abdeckte. Diese Implementierung erforderte mehr Hardware, Lizenzen und einen höheren operativen Verwaltungsaufwand.
Der Kunde bewahrte alle Logdaten 90 Tage lang auf, unabhängig davon, wie die Daten verwendet wurden.
7 Tage heiß
2 Tage warm
10 Tage kalt
Verbleibende Tage in „Eingefroren“
Der Kunde hatte in beiden Tiers, „heiß“ und „warm“, dieselbe Hardware. Die warme Ebene wurde ausschließlich für das Force-Merging von Indizes für durchsuchbare Snapshots verwendet. Die warmen und kalten Ebenen waren sowohl bei der CPU als auch beim Speicher stark unterausgelastet. Die eingefrorene Ebene war zu klein, was zu langsamen historischen Suchvorgängen führte.
Neue Architektur
Nach der Überprüfung, wie die Daten genutzt wurden, wurden die folgenden Erkenntnisse gewonnen:
Die meisten Daten mit hohem Volumen wurden nur in den ersten 24 Stunden nach der Ingestion durchsucht.
Nach 24 Stunden wurden die Daten hauptsächlich für Security-Untersuchungen verwendet, die Ad-hoc-Suchen erforderten.
Einige ausgewählte Indizes mussten für die Berichterstattung länger aufbewahrt werden.
Aufgrund neuer Compliance-Anforderungen mussten Daten bis zu einem Jahr lang aufbewahrt werden.
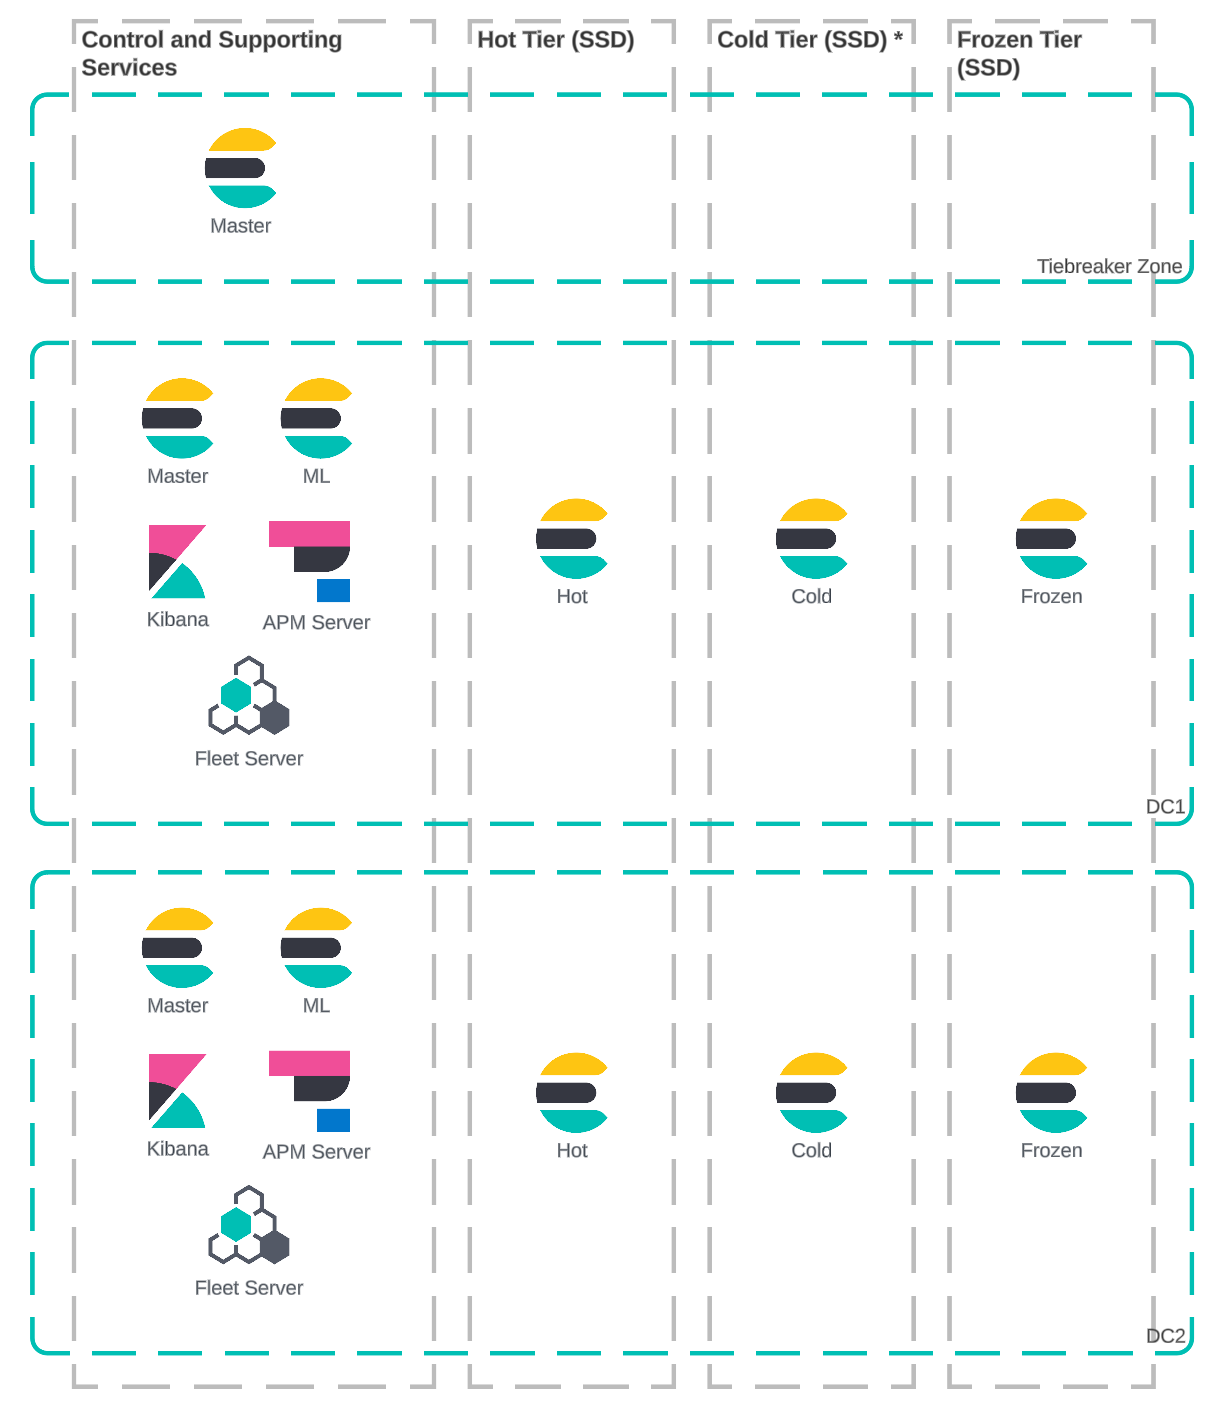
Migration auf eine Heiß-Kalt-Eingefroren-Architektur
Die Nodes im Tier für „heiße“ Daten verfügten über ausreichende Kapazität, um Force-Merging-Aktivitäten durchzuführen, wodurch das Tier für „warme“ Daten entfernt werden konnte.
Der Großteil der Daten kann nach 36 Stunden direkt vom Hot-Tier in den Frozen-Tier übergehen.
Daten, die für Berichterstattungs-Anwendungsfälle lokalen Speicher erfordern, können in der kalten Tier aufbewahrt werden.
Die „heiße“ Ebene kann ebenfalls verkleinert werden, da weniger Daten aufbewahrt werden müssen.
Die Erweiterung der Tier für „eingefrorene“ Daten erhöht den für Suchen verfügbaren Cache und verbessert so die Suchleistung. Darüber hinaus ermöglicht es, Daten ein Jahr lang anstatt nur 90 Tage aufzubewahren.
Speicheroptimierung
Bessere Speicherdichte: Die kalte Tier kann einen Durchsuchbarer Snapshot als Replikat nutzen. Die Tier für „eingefrorene“ Daten speichert alle Daten im Snapshot-Repository und speichert nur Abfrageergebnisse im lokalen Cache.
Weniger Datenreplikation erfordert weniger Nodes, was die Hardware- und Lizenzauslastung reduziert.
Alle Tiers nutzen dieselben Speicheranforderungen, wodurch Hardware einfach konsolidiert und wiederverwendet werden kann.
Durch die Änderungen wurden 20–30 Nodes und Lizenzen frei, die für den Aufbau weiterer Anwendungsfälle wiederverwendet wurden.
Die neue Architektur zielt darauf ab, Hardware-Profile für Logging- und Sicherheit-Workloads zu konsolidieren, und führt möglicherweise eine dritte Zone für erhöhte Resilienz ein. Der Fokus liegt zudem auf der Speicheroptimierung, einschließlich besserer Speicherdichte und reduzierter Datenreplikation, was zu einem geringeren Bedarf an Nodes und einer optimierten Lizenznutzung führt. Diese Architektur ermöglicht die Konsolidierung von Hardware-Profilen.
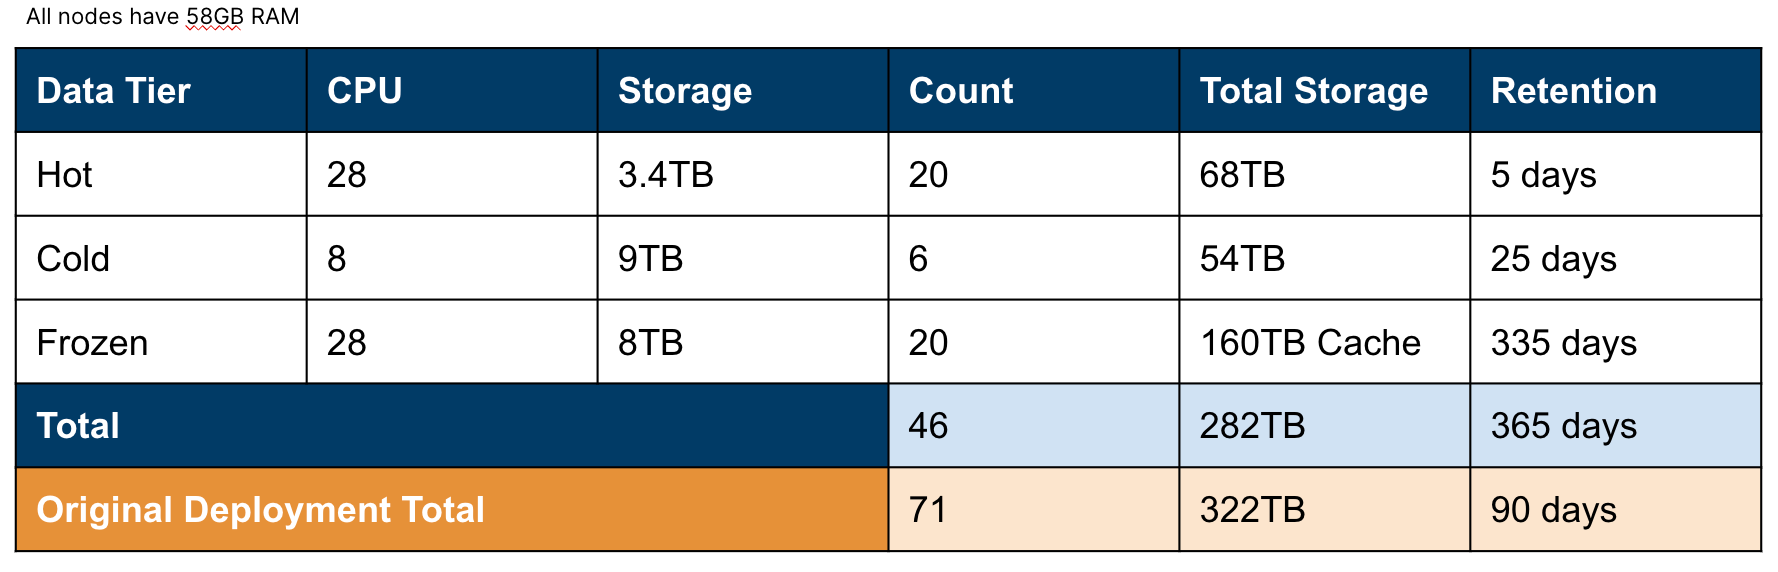
Vorteile der Architekturüberarbeitung
Verbesserte Strategie zur Datenaufbewahrung: Eine effizientere Strategie für Speicher-Tiering kann zu einer besseren Datenaufbewahrung führen, was besonders für Sicherheits- und Compliance-Zwecke wichtig sein kann.
Vereinfachte Plattformverwaltung: Die Konsolidierung von Hardwareprofilen und die Reduzierung der erforderlichen Nodes können die Plattformverwaltung vereinfachen und den operativen Aufwand verringern.
Reduzierter Hardware-Footprint: Die Optimierung von Rechenressourcen und Speicherdichte kann zu einem reduzierten Hardware-Footprint führen, wodurch Platz und Energie gespart werden.
Verbesserter ROI: Durch die Optimierung der Speicher-Tiers kann das Unternehmen eine bessere Kapitalrendite erzielen und seine vorhandene Infrastruktur optimal nutzen.
Zu den Vorteilen der neuen Architektur gehören eine einfachere Verwaltung, eine bessere Auslastung von Lizenzen und Hardware, eine längere Datenaufbewahrung sowie ein kleineres Deployment, was zu schnelleren Upgrades und einer höheren Resilienz der Infrastruktur führt. Zu den potenziellen Nachteilen kann jedoch eine langsamere Suchperformance bei bestimmten Anwendungsfällen gehören, die schnellen Speicher mit hohen IOPS erfordern, da mehr Daten in den Tiers für „eingefrorene“ Daten gespeichert werden.
Implementierung der Strategie
Eine mehrstufige Datenstrategie ermöglicht es Unternehmen, die Leistung für aktuelle Daten zu optimieren und gleichzeitig große Datenmengen effizient zu speichern. Durch die Nutzung der Shard-Allokations-Awareness können Unternehmen die Merkmale jeder Ebene definieren und die Migration von Indizes gemäß der Datenstrategie planen. Dies stellt sicher, dass Daten jederzeit auf der am besten geeigneten Hardware-Ebene gespeichert werden, wodurch ein Gleichgewicht zwischen Leistung und Kostenüberlegungen hergestellt wird.
Beispiele für Speicher-Tiers und Arbeitsspeicherverhältnisse
Das Verhältnis von Arbeitsspeicher zu Speicher ist ein entscheidender Faktor bei der Planung des Elastic-Wachstums. Nachfolgend finden Sie die vier Speicherstufen, die Elastic-Kunden zur Verfügung stehen:
Hot-Tier: Optimiert für Ingestion- und Suchleistung, typischerweise unter Verwendung von Hochgeschwindigkeits-SSDs mit einem Verhältnis von Arbeitsspeicher zu Speicher von etwa 1:30
Warm-Tier: Optimiert für Speicherkapazität, unter Verwendung von SSDs oder HDDs mit einem Verhältnis von Arbeitsspeicher zu Speicher von etwa 1:160
Cold-Tier: Optimiert für Speicherkapazität unter Verwendung eines durchsuchbaren Snapshots als Replikat (Obwohl das Speicherverhältnis dem des Warm-Tiers entspricht, halbiert der Wegfall eines lokalen Replikats den Speicherbedarf.)
Frozen-Tier: Optimiert für Archivierungszwecke, unter Verwendung von kostengünstigem Snapshot-Speicher mit lokalem Festplatten-Cache, um ein Verhältnis von Arbeitsspeicher zu Speicher von über 1:1.000 zu erzielen
Übergeordnete Kostenanalyse verschiedener Speicherkonfigurationen
In unserer Analyse haben wir die Gesamtbetriebskosten (TCO) für verschiedene Speicherkonfigurationen bewertet, um die Elastic-Implementierung eines anderen Kunden zu optimieren. Nachfolgend finden Sie eine detaillierte Aufschlüsselung dieser Konfigurationen und der damit verbundenen Kosten:
Selbstverwalteter ES-Cluster
1 TB tägliche Ingestion
Gesamte Aufbewahrungszeit 365 Tage
| Konfiguration | Aufbewahrungsdauer (Tage) | Knoten | Hardwarekosten | Kosten für Snapshot-Speicher | Gesamtbetriebskosten (TCO) |
| heiß-warm | 7 heiß, 358 warm | 4 „heiß“, 60 „warm“ | 44.954 $ | 7.665 $ | 52.619 $ |
| Heiß-Warm-Kalt | 7 „heiß“, 90 „warm“, 268 „kalt“ | 4 „heiß“, 15 „warm“, 23 „kalt“ | 28.231 $ | 7.665 $ | 36.795 $ |
| Heiß-Warm-Frozen | 7 heiß, 90 warm, 268 eingefroren | 4 „heiß“, 15 „warm“, 3 „eingefroren“ | 17.051 $ | 7.665 $ | 22.204 $ |
| Heiß-Eingefroren | 7 „heiß“, 358 „eingefroren“ | 4 „heiß“, 4 „eingefroren“ | 6.198 $ | 7.665 $ | 12.066 $ |
Überlegungen zur Kapazitätsplanung
Bei der Kapazitätsplanung für jede Tier ist es entscheidend, diese unabhängig voneinander basierend auf ihren spezifischen Anforderungen zu dimensionieren. Dies erfordert ein Verständnis der Speicher- und Performance-Anforderungen jeder Tier und die Sicherstellung, dass diese angemessen bereitgestellt werden. Darüber hinaus müssen Unternehmen die gesamten Kapazitätsanforderungen berücksichtigen und prüfen, wie die verschiedenen Tiers interagieren, um eine ausgewogene und effiziente Speicherstrategie sicherzustellen.
Fazit
Bei der Optimierung des Speicher-Tiering geht es nicht nur um Kosteneinsparungen; es geht darum, Unternehmen in die Lage zu versetzen, sich weiterzuentwickeln und sich an neue Herausforderungen und Chancen anzupassen.
Durch die Herangehensweise an Herausforderungen bei der Platformoptimierung mithilfe der Datenstrategieprinzipien können Unternehmen neue Anwendungsfälle ermöglichen, die Datenzuverlässigkeit verbessern und ihre allgemeine Datenstrategie optimieren. Lesen Sie unsere Dokumentation, um zu erfahren, wie Ihr Unternehmen eine belastbare und effiziente Implementierung von Elastic mithilfe von Daten Tiering aufbauen kann.
Die Entscheidung über die Veröffentlichung der in diesem Blogeintrag beschriebenen Leistungsmerkmale und Features sowie deren Zeitpunkt liegt allein bei Elastic. Es ist möglich, dass noch nicht verfügbare Leistungsmerkmale oder Features nicht rechtzeitig oder überhaupt nicht veröffentlicht werden.
Teilen
- Share on Twitter
Auf Twitter teilen
- Share on LinkedIn
Auf LinkedIn teilen
- Share on Facebook
Auf Facebook teilen
- Share by Email
Per E-Mail teilen
- Print this page
Drucken