Estratégia de hierarquização de dados Elastic: otimizando para uma implementação resiliente e eficiente

 Share on Twitter
Compartilhar no Twitter

 Share on LinkedIn
Compartilhar no LinkedIn

 Share on Facebook
Compartilhar no Facebook

 Share by Email
Compartilhar por e-mail

 Print this page
Imprimir
Na Elastic, a maioria das nossas implementações de sucesso de clientes começa com um único caso de uso voltado para atender a requisitos de negócios específicos. A Elastic é frequentemente adotada inicialmente porque os desenvolvedores apreciam os recursos que ela oferece. No entanto, devido à sua flexibilidade e capacidade de customização, os clientes tendem a expandir sua adoção para atender a várias necessidades, como logging e monitoramento de performance de aplicação, SIEM e operações de segurança, e até casos de uso de buscar mais complexos utilizando os dados já disponíveis na Elastic.
No ambiente de TI atual, apenas armazenar dados (logs, traces, métricas e documentos) é insuficiente. As organizações precisam de uma solutions que permita que suas equipes acessem e utilizem esses dados de forma rápida e eficaz. A eficiência é fundamental no gerenciamento de dados, já que cada bit de dados armazenado gera custos de hardware, licenciamento, manutenção e gerenciamento.
Neste blog, detalharemos como organizações com grandes volumes de dados podem otimizar a forma como eles são armazenados em diferentes níveis para obter economia de custos e extrair mais valor de seus dados.
O desafio: gerenciamento de dados eficiente e com escalabilidade
As organizações adoram o Elastic por sua velocidade, escalabilidade, customizabilidade e funcionalidade. Por causa disso, eles frequentemente encontram novos casos de uso para o Elastic. Isso se torna um desafio quando grandes quantidades de dados são ingeridas sem considerar como os dados são armazenados, gerenciados e usados, o que pode levar a gargalos no gerenciamento de dados. À medida que os dados crescem, suas configurações atuais lutam para lidar com novas necessidades, atingindo os limites de seu hardware e licenças.
Se sua organização está enfrentando esses problemas, a solutions é mais gerenciável do que você imagina.
A solução: uma estratégia de dados orientada aos negócios
A maneira de superar esse desafio é definindo uma estratégia de dados que esteja alinhada aos seus objetivos de negócio. Em vez de coletar e reter dados com base em requisitos arbitrários, pergunte-se o seguinte:
Quais dados precisam ser coletados para impulsionar um objetivo de negócios?
Com que frequência esses dados são usados?
Existe uma data de validade após a qual estes dados deixam de ser valiosos?
Existem requisitos de conformidade para esses dados?
Com base nas respostas às perguntas acima, as organizações podem criar uma estratégia de dados orientada aos negócios para otimizar a forma como os dados são armazenados e utilizados, maximizando seu investimento existente na Elastic.
Estudo de caso
Para demonstrar os benefícios da adoção desta estratégia, vamos explorar um estudo de caso de um cliente que passou por este processo.
Este cliente normalmente processa 5 TB de dados por dia e lida com uma média de 250.000 eventos por segundo. No entanto, às vezes o volume aumenta para 7 TB por dia e 350.000 eventos por segundo. A implementação da Elastic para este cliente concentrou-se na ingestão de um alto volume de dados de segurança e em disponibilizá-los para a equipe do centro de operações de segurança (SOC) para buscar informações sobre incidentes cibernéticos e investigações de fraude.
Esta implementação foi tão bem-sucedida que o cliente adicionou novos casos de uso que exigiam maior retenção de dados e capacidades de buscar mais rápidas a partir de uma gama mais ampla de fontes de dados. Eles visaram os seguintes resultados de negócios:
Otimização de log: Ao otimizar suas camadas de dados, as organizações podem aprimorar suas práticas de gerenciamento de logs, garantindo que retenham os logs certos pelo tempo certo, melhorando a eficiência operacional e a adesão à conformidade.
Melhor utilização de licença: O armazenamento em camadas eficiente significa uma melhor utilização de licença, permitindo que as organizações aproveitem ao máximo seus recursos existentes e potencialmente evitem custos de licenciamento desnecessários.
Eficiência de negócios aprimorada: A capacidade de encontrar insights a partir de logs de forma mais eficiente pode levar a uma melhor eficiência de negócios, permitindo uma tomada de decisão mais rápida e um planejamento estratégico mais informado.
Onboarding de novos casos de uso: Com camadas de dados otimizadas, as organizações podem facilmente fazer o onboarding de novos casos de uso, expandindo suas capacidades de analítica de dados sem investimentos significativos em infraestrutura.
Estratégia de dados clara: A hierarquização otimizada de dados contribui para uma estratégia de dados clara, garantindo que os dados sejam confiáveis, facilmente acessíveis e governados de forma eficaz, estabelecendo a base para a tomada de decisões orientada por dados.
Hierarquização de dados
Camadas de dados é um tópico complexo e cheio de nuances que merece seu próprio blog para ser detalhado. No entanto, para fins de definição de uma estratégia de dados, as diferentes camadas de dados podem ser simplificadas em três usos principais: ingestão, buscar e armazenar.
Ingestão (hot tier): Faça a ingestão de dados o mais rápido possível com latência mínima.
Buscar (camadas hot e warm): Pesquise dados rapidamente e processe grandes conjuntos de dados.
- Armazenar (camada cold e frozen): Armazene dados pelo tempo necessário e execute buscas ad-hoc de baixa frequência.
Crescimento e retenção de dados
Entender a variedade de requisitos de retenção de dados é crucial para a conformidade e o gerenciamento de dados eficiente. Diferentes regulamentações exigem períodos de retenção variados:
Requisitos de retenção SOX: 7 anos
Requisitos de retenção de dados da HIPAA: 6 anos
Requisitos de retenção de dados PCI DDS: 1 ano
Requisitos de retenção de dados de Basileia II: 3–7 anos
Registros de funcionários da GDPR:
Salários: 3 anos
Registros fiscais: 6 anos
Nome, endereço: 3 anos
- Fair Labor Standards Act: 2–3 anos
Arquitetura anterior x nova arquitetura
Arquitetura anterior
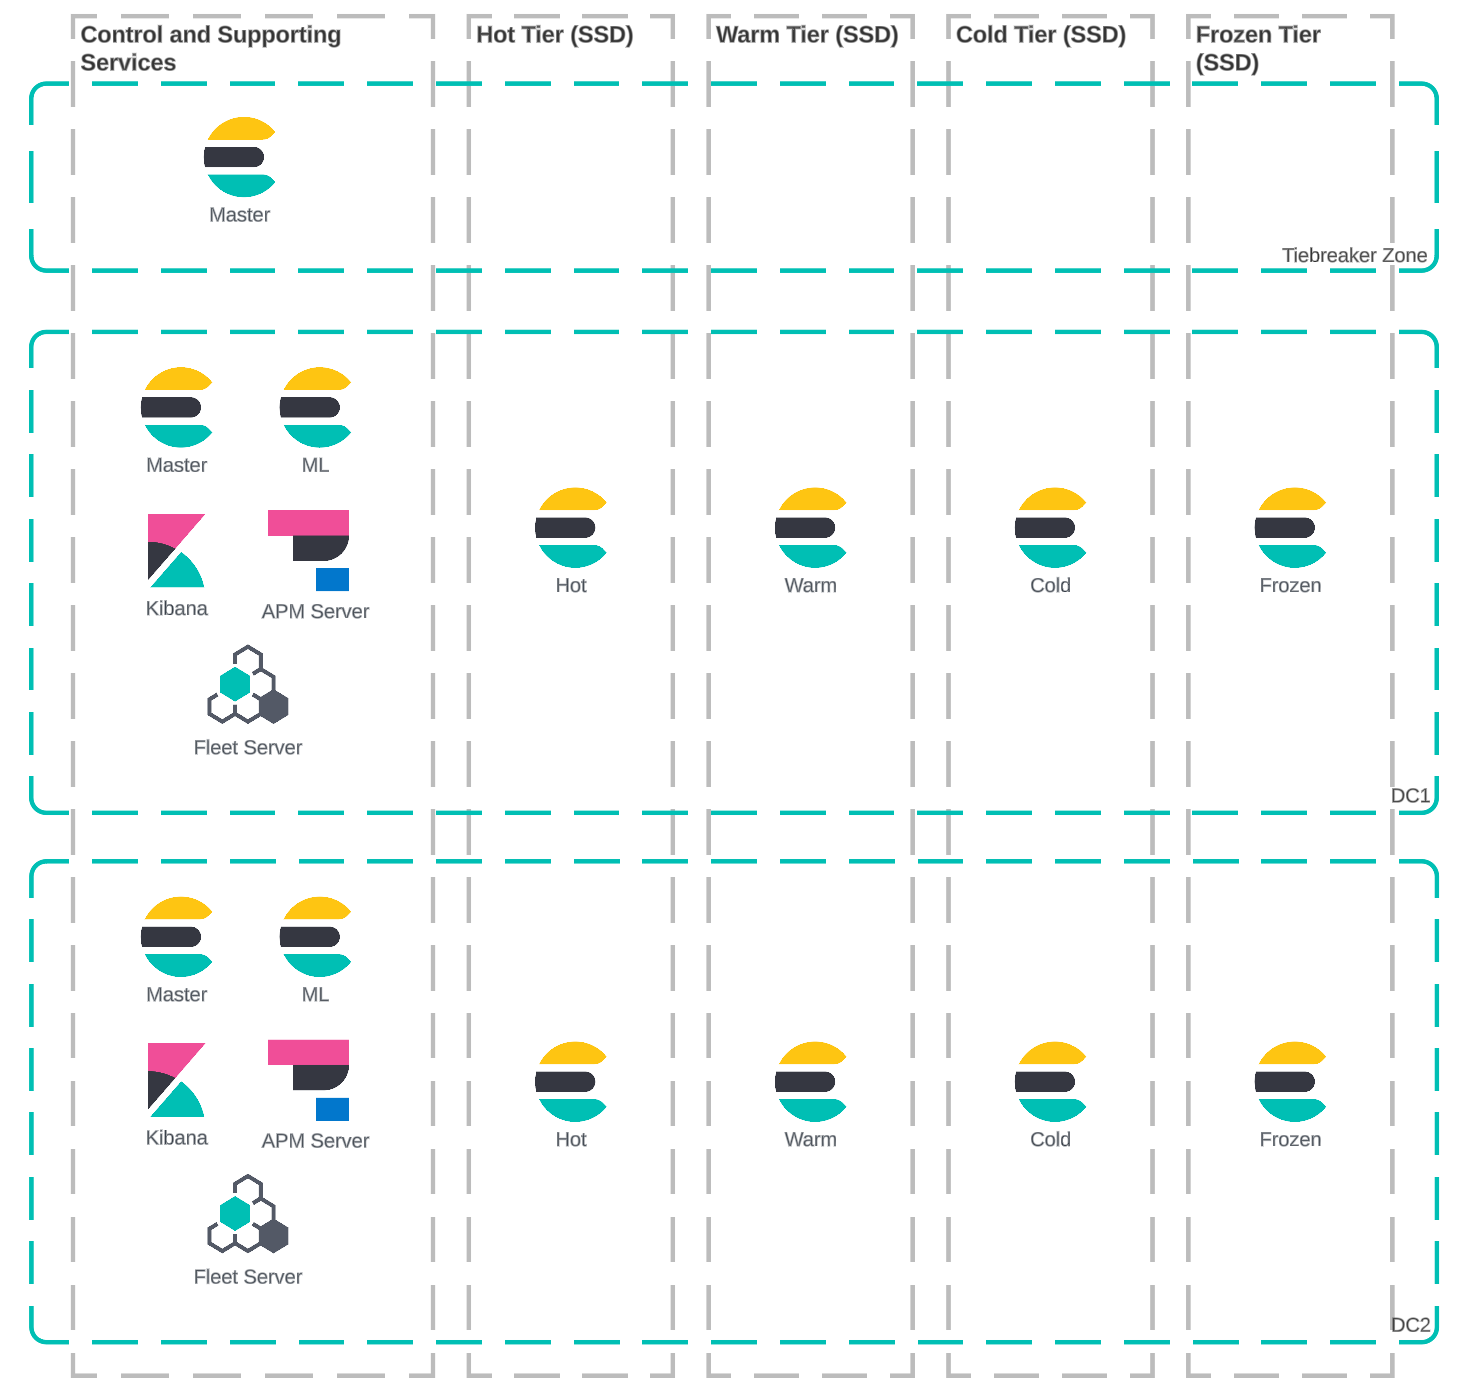
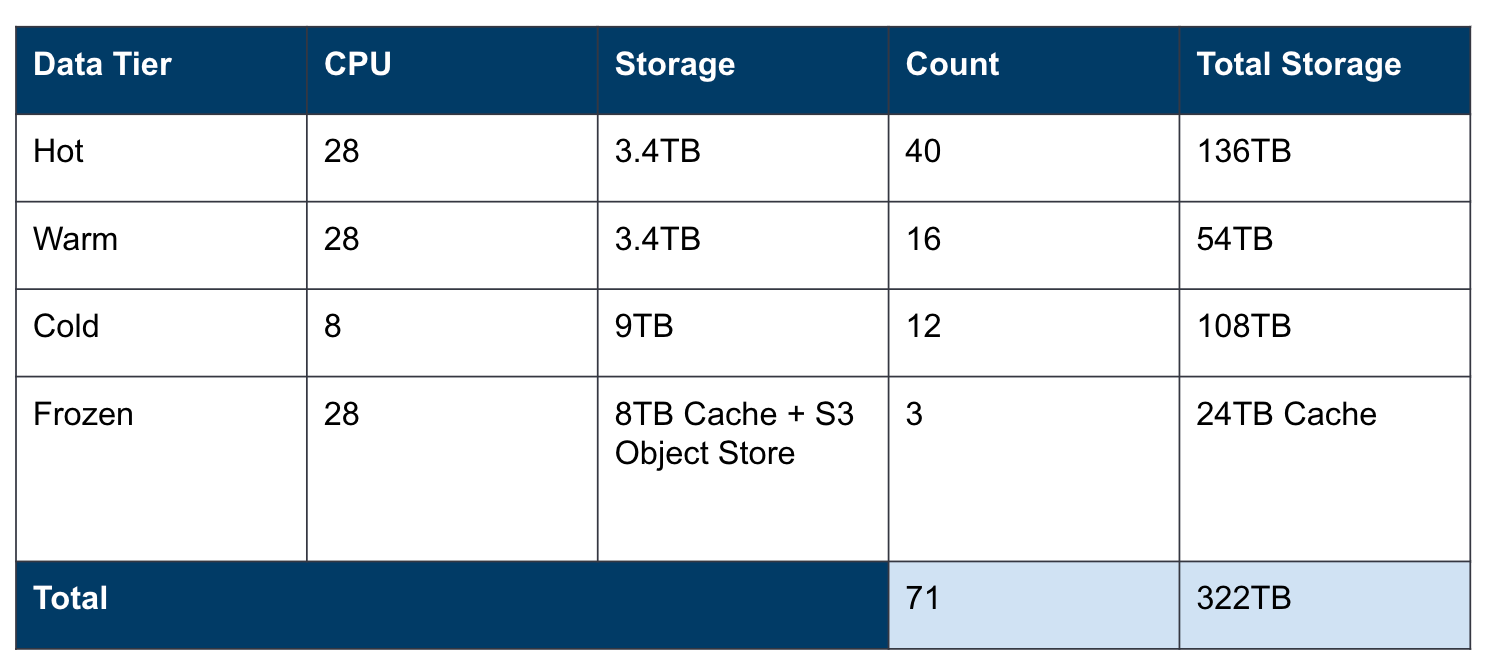
A arquitetura anterior tinha dois centros de dados com uma implementação de armazenamento de quatro camadas que atendia a várias necessidades de tratamento de dados. Essa implementação exigia mais hardware, licenças e sobrecarga na gestão operacional.
O cliente reteve todos os logs por 90 dias, independentemente de como os dados foram usados.
7 dias hot
2 dias quente
10 dias cold
Dias restantes no frozen
O cliente tinha o mesmo hardware nas camadas hot e warm. A camada warm era usada puramente para forçar a mesclagem de índices para snapshots buscáveis. As camadas warm e cold estavam muito subutilizadas tanto em CPU quanto em armazenamento. A camada frozen era limitada, resultando em buscas históricas lentas.
Nova arquitetura
Após revisar como os dados foram utilizados, as seguintes descobertas foram feitas:
A maior parte dos dados de alto volume só foi pesquisada nas primeiras 24 horas após a ingestão.
Após 24 horas, o uso principal dos dados foi para investigações de segurança, que exigiram pesquisas ad-hoc.
Alguns índices selecionados precisaram ser retidos por mais tempo para relatório.
Devido a novos requisitos de conformidade, os dados precisaram ser retidos por até um ano.
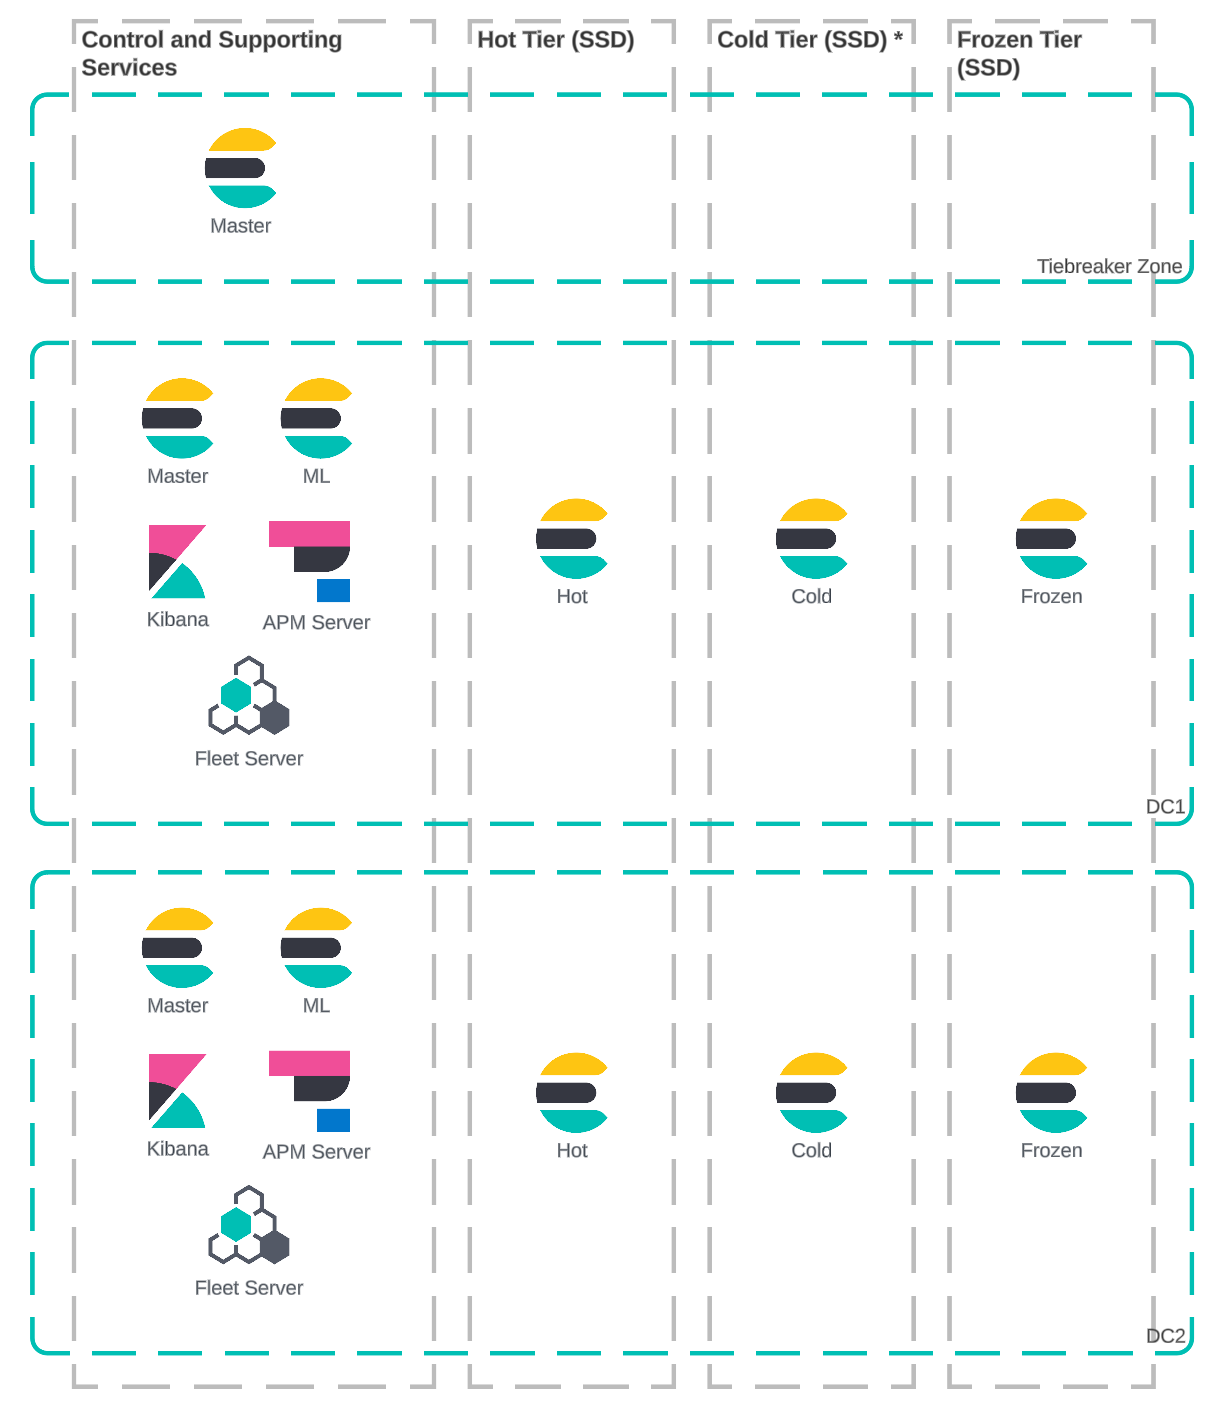
Migrar para arquitetura hot/cold/frozen
Os Node da camada hot tinham capacidade suficiente para realizar atividades de force merging, permitindo que a camada warm fosse removida.
A maior parte dos dados pode fazer a transição da camada hot diretamente para a camada frozen após 36 horas.
Dados que exigem armazenamento local para casos de uso de relatório podem ser mantidos na camada cold.
A camada hot também pode ser reduzida porque há menos dados que precisam ser retidos.
Expandir a camada frozen aumenta a quantidade de cache disponível para buscas, melhorando o desempenho da busca. Além disso, permite que os dados sejam mantidos por um ano em vez de apenas 90 dias.
Otimização de armazenamento
Melhor densidade de armazenamento: a camada cold pode aproveitar um snapshot pesquisável como uma réplica. A camada frozen armazena todos os dados no repositório de snapshot e apenas armazena em cache os resultados da consulta em seu cache local.
Menos replicação de dados requer menos Node, reduzindo a utilização de hardware e licenças.
Todas as camadas utilizam os mesmos requisitos de armazenamento, permitindo que o hardware seja consolidado e reutilizado facilmente.
As alterações liberaram 20–30 Node e licenças, que foram reutilizados para criar casos de uso adicionais.
A nova arquitetura visa consolidar perfis de hardware para cargas de trabalho de logging e segurança, potencialmente introduzindo uma terceira zona para maior resiliência. Ele também se concentra na otimização de armazenamento, incluindo melhor densidade de armazenamento e replicação de dados reduzida, resultando em menos Node necessários e utilização otimizada de licenças. Essa arquitetura permite a consolidação de perfis de hardware.
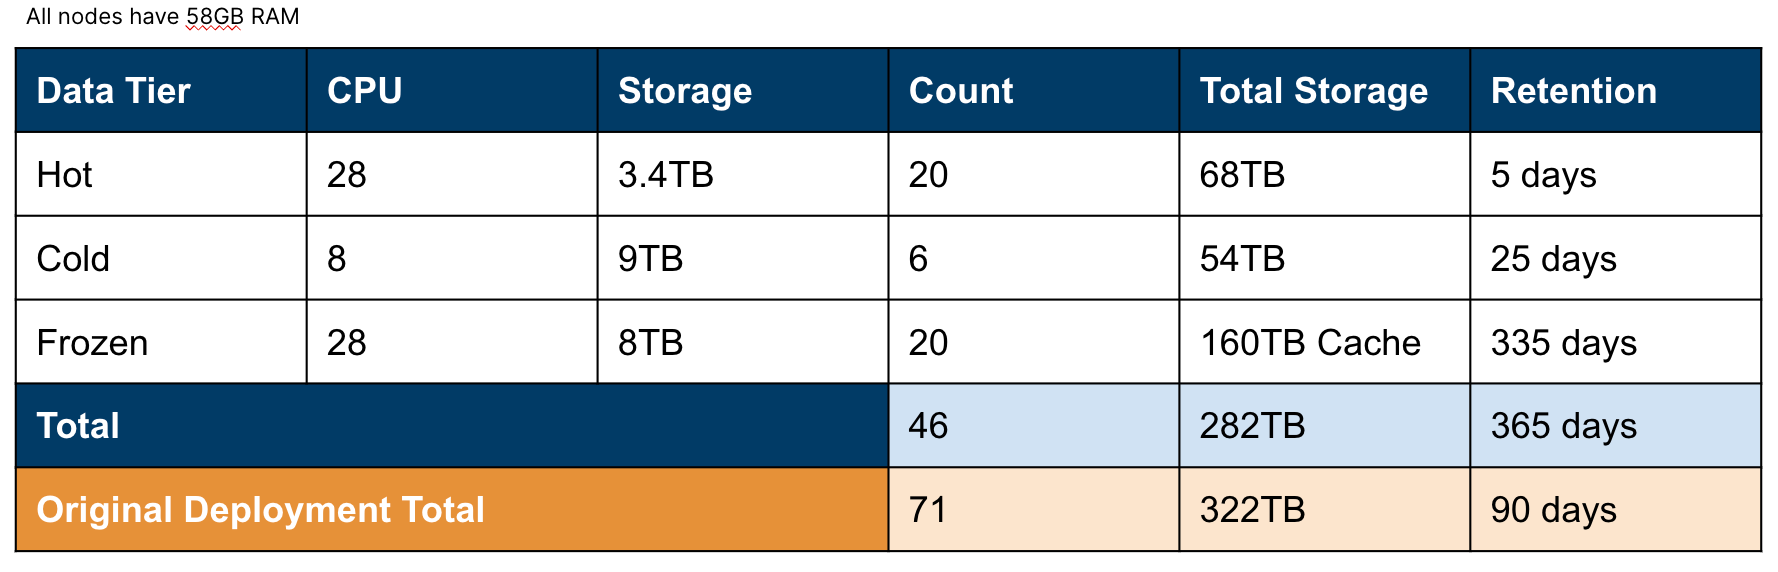
Benefícios da rearquitetura
Estratégia de retenção de dados aprimorada: Uma estratégia de hierarquização de armazenamento mais eficiente pode levar a uma melhor retenção de dados, o que pode ser particularmente importante para fins de segurança e conformidade.
Gerenciamento de Platform simplificado: Consolidar perfis de hardware e reduzir o número de Node necessários pode simplificar o gerenciamento da Platform, reduzindo a sobrecarga operacional.
Pegada de hardware reduzida: A otimização de recursos computacionais e densidade de armazenamento pode levar a uma pegada de hardware reduzida, economizando espaço e energia.
ROI aprimorado: Ao otimizar suas camadas de armazenamento, a organização pode obter um melhor retorno sobre o investimento, aproveitando ao máximo sua infraestrutura existente.
As vantagens da nova arquitetura incluem gerenciamento mais simples, melhor utilização de licenças e hardware, retenção de dados mais longa e implantação menor, levando a upgrades mais rápidos e maior resiliência da infraestrutura. No entanto, possíveis desvantagens podem incluir um desempenho de busca mais lento para certos casos de uso que exigem armazenamento rápido com alto IOPS, devido a mais dados serem armazenados em camadas frozen.
Implementando a estratégia
Uma estratégia de dados em camadas permite que as organizações otimizem o desempenho para dados recentes enquanto armazenam grandes volumes de dados de forma eficiente. Ao aproveitar a consciência de alocação de shard, as organizações podem definir as características de cada camada e agendar a migração de índices de acordo com a estratégia de dados. Isso garante que os dados sejam armazenados na camada de hardware mais apropriada a qualquer momento, equilibrando considerações de desempenho e custo.
Exemplos de camadas de armazenamento e proporções de memória
A relação memória-armazenamento é uma consideração crucial ao planejar o crescimento do Elastic. Abaixo estão as quatro camadas de armazenamento disponíveis para os clientes Elastic:
Camada ativa: Otimizada para desempenho de ingestão e buscar, normalmente usando SSDs de alta velocidade com uma proporção de memória para armazenamento de cerca de 1:30
Warm tier: Otimizado para capacidade de armazenamento, utilizando SSD ou HDDs com uma proporção de memória para armazenamento de aproximadamente 1:160
Camada cold: Otimizada para capacidade de armazenamento usando um snapshot pesquisável como réplica (Embora a proporção de armazenamento seja a mesma da camada warm, a remoção de uma réplica local reduz pela metade os requisitos de armazenamento.)
Camada frozen: Otimizada para fins de arquivamento, empregando armazenamento de snapshot barato com cache de disco local para fornecer uma proporção de memória para armazenamento superior a 1:1.000
Análise de custo de alto nível de diferentes configurações de armazenamento
Em nossa análise, avaliamos o custo total de propriedade (TCO) para várias configurações de armazenamento a fim de otimizar a implementação do Elastic de outro cliente. Abaixo, uma análise detalhada dessas configurações e seus custos associados:
Cluster do ES autogerenciado
1 TB de ingestão diária
Retenção total de 365 dias
| Configuração | Dias de retenção | Nós | Custo de hardware | Custo de armazenamento de snapshot | Custo total (TCO) |
| hot-warm | 7 hot, 358 warm | 4 hot, 60 warm | $ 44.954 | $ 7.665 | $ 52.619 |
| Hot-warm-cold | 7 hot, 90 warm, 268 cold | 4 hot, 15 warm, 23 cold | R$ 28.231 | $ 7.665 | $ 36.795 |
| Hot-warm-frozen | 7 hot, 90 warm, 268 frozen | 4 hot, 15 warm, 3 frozen | $ 17.051 | $ 7.665 | $ 22.204 |
| Hot-frozen | 7 hot, 358 frozen | 4 hot, 4 frozen | $ 6.198 | $ 7.665 | $ 12.066 |
Considerações para o planejamento de capacidade
Ao planejar a capacidade para cada camada, é crucial dimensioná-las de forma independente com base em seus requisitos específicos. Isso envolve entender as necessidades de armazenamento e desempenho de cada camada e garantir que elas sejam adequadamente provisionadas. Além disso, as organizações devem considerar os requisitos gerais de capacidade e como as diferentes camadas interagirão para garantir uma estratégia de armazenamento equilibrada e eficiente.
Conclusão
Otimizar a hierarquização de armazenamento não se trata apenas de economizar custos; trata-se de permitir que as organizações evoluam e se adaptem a novos desafios e oportunidades.
Ao abordar os desafios de otimização da Platform usando os princípios de estratégia de dados, as organizações podem facilitar novos casos de uso, melhorar a confiabilidade dos dados e aprimorar sua estratégia geral de dados. Confira nossa documentação para saber como sua organização pode criar uma implementação resiliente e eficiente do Elastic usando camadas de dados.
O lançamento e o tempo de amadurecimento de todos os recursos ou funcionalidades descritos neste artigo permanecem a exclusivo critério da Elastic. Os recursos ou funcionalidades não disponíveis no momento poderão não ser entregues ou não chegarem no prazo previsto.
Compartilhar
- Share on Twitter
Compartilhar no Twitter
- Share on LinkedIn
Compartilhar no LinkedIn
- Share on Facebook
Compartilhar no Facebook
- Share by Email
Compartilhar por e-mail
- Print this page
Imprimir