Moteur de contexte Elastic
Un contexte complet et toujours à jour
Elastic Context Engine* se connecte à toutes les sources de données d'entreprise pour créer des agents précis : synchronisez le contexte à chaque interaction ou selon un calendrier défini, effectuez des pré-calculs pour accélérer la recherche dans plusieurs sources et améliorez continuellement la précision.
* Expérimental
Lisez notre blog pour découvrir comment sélectionner et gérer le contexte en continu.
Lire l'articleConsultez notre documentation pour en savoir plus sur Context Engine et débuter.
Voir la documentationQue fait un moteur de contexte pour les agents ?
Pré-calculer le contexte pour réduire le nombre de jetons d’entrée, diminuer la latence, et améliorer la qualité des réponses. L’utilisation de Context Engine par les agents du support technique a permis de réduire les coûts de 55 % et la latence de 40 %.
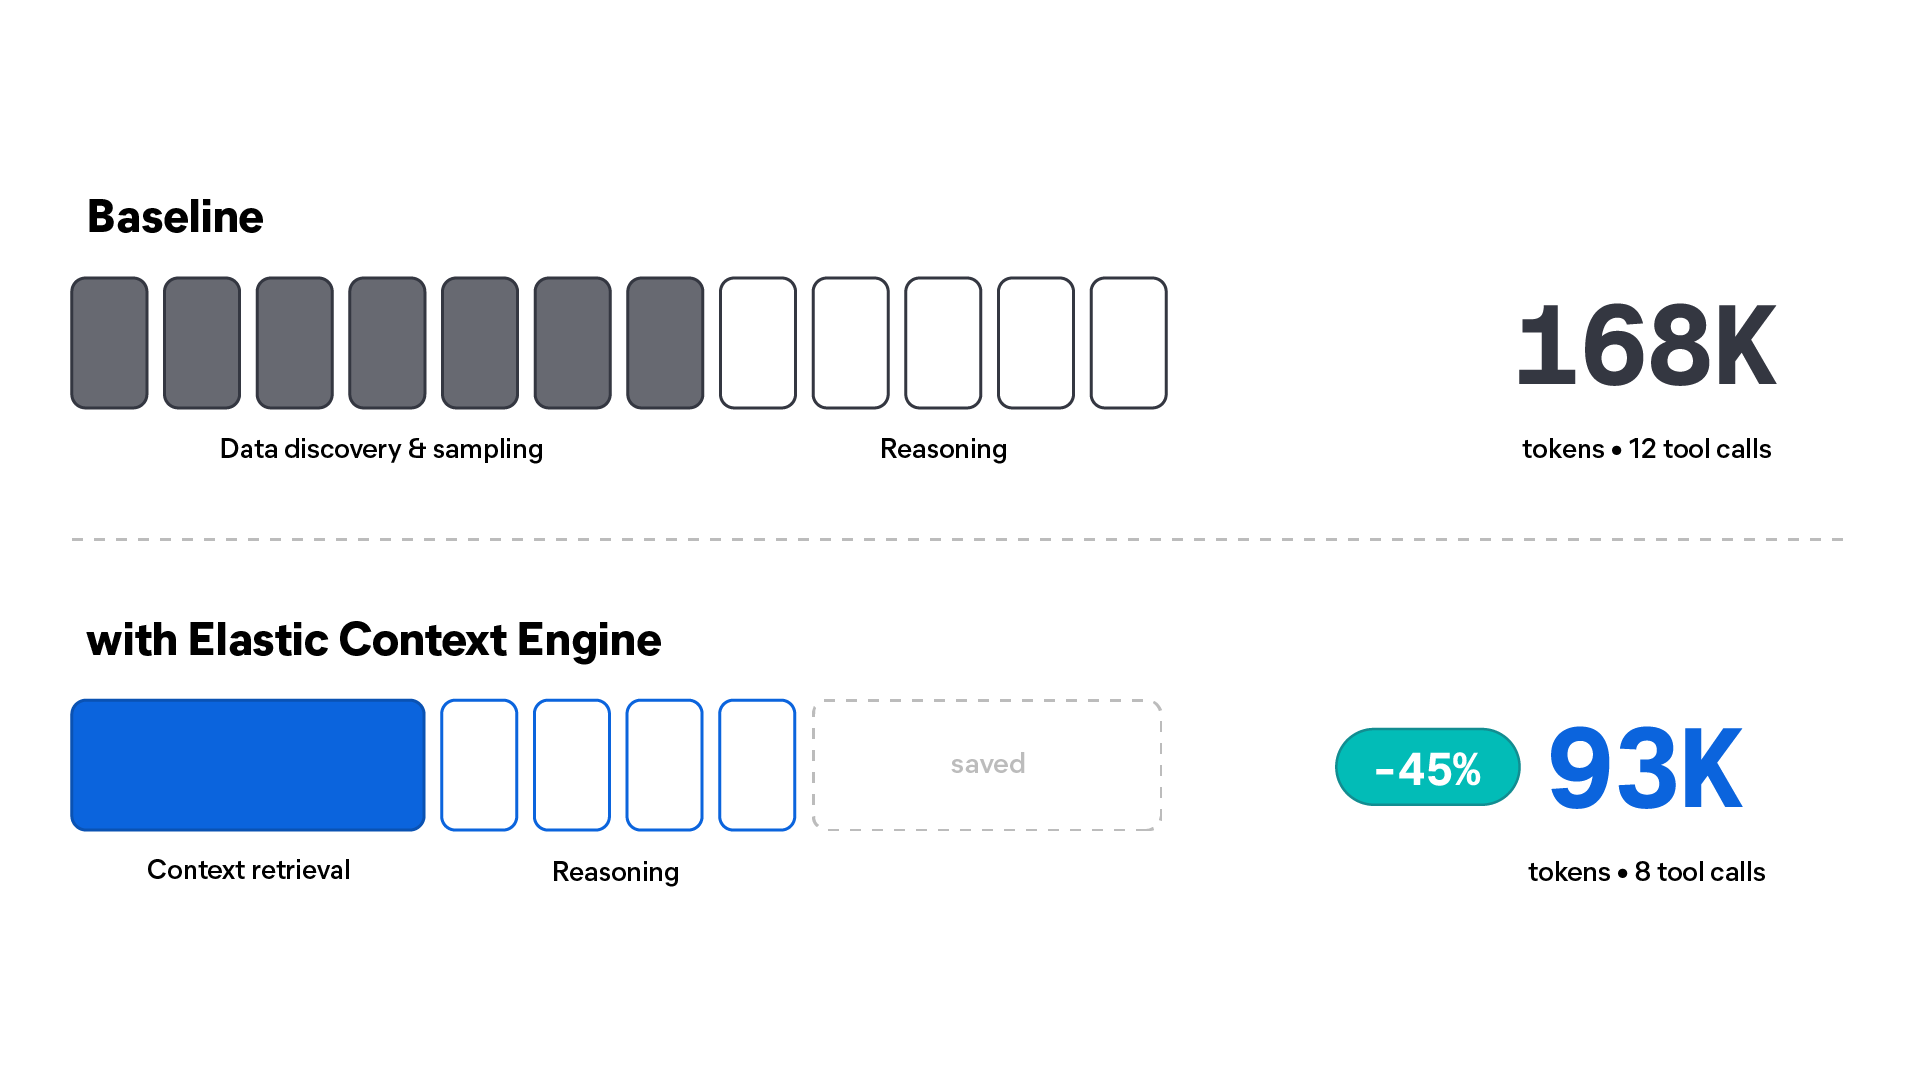
AVANTAGES
Rendez n’importe quel agent efficace
Veillez à ce que le contexte de vos agents soit constamment complet, à jour, efficace, et mesurable.


Fonctionnement
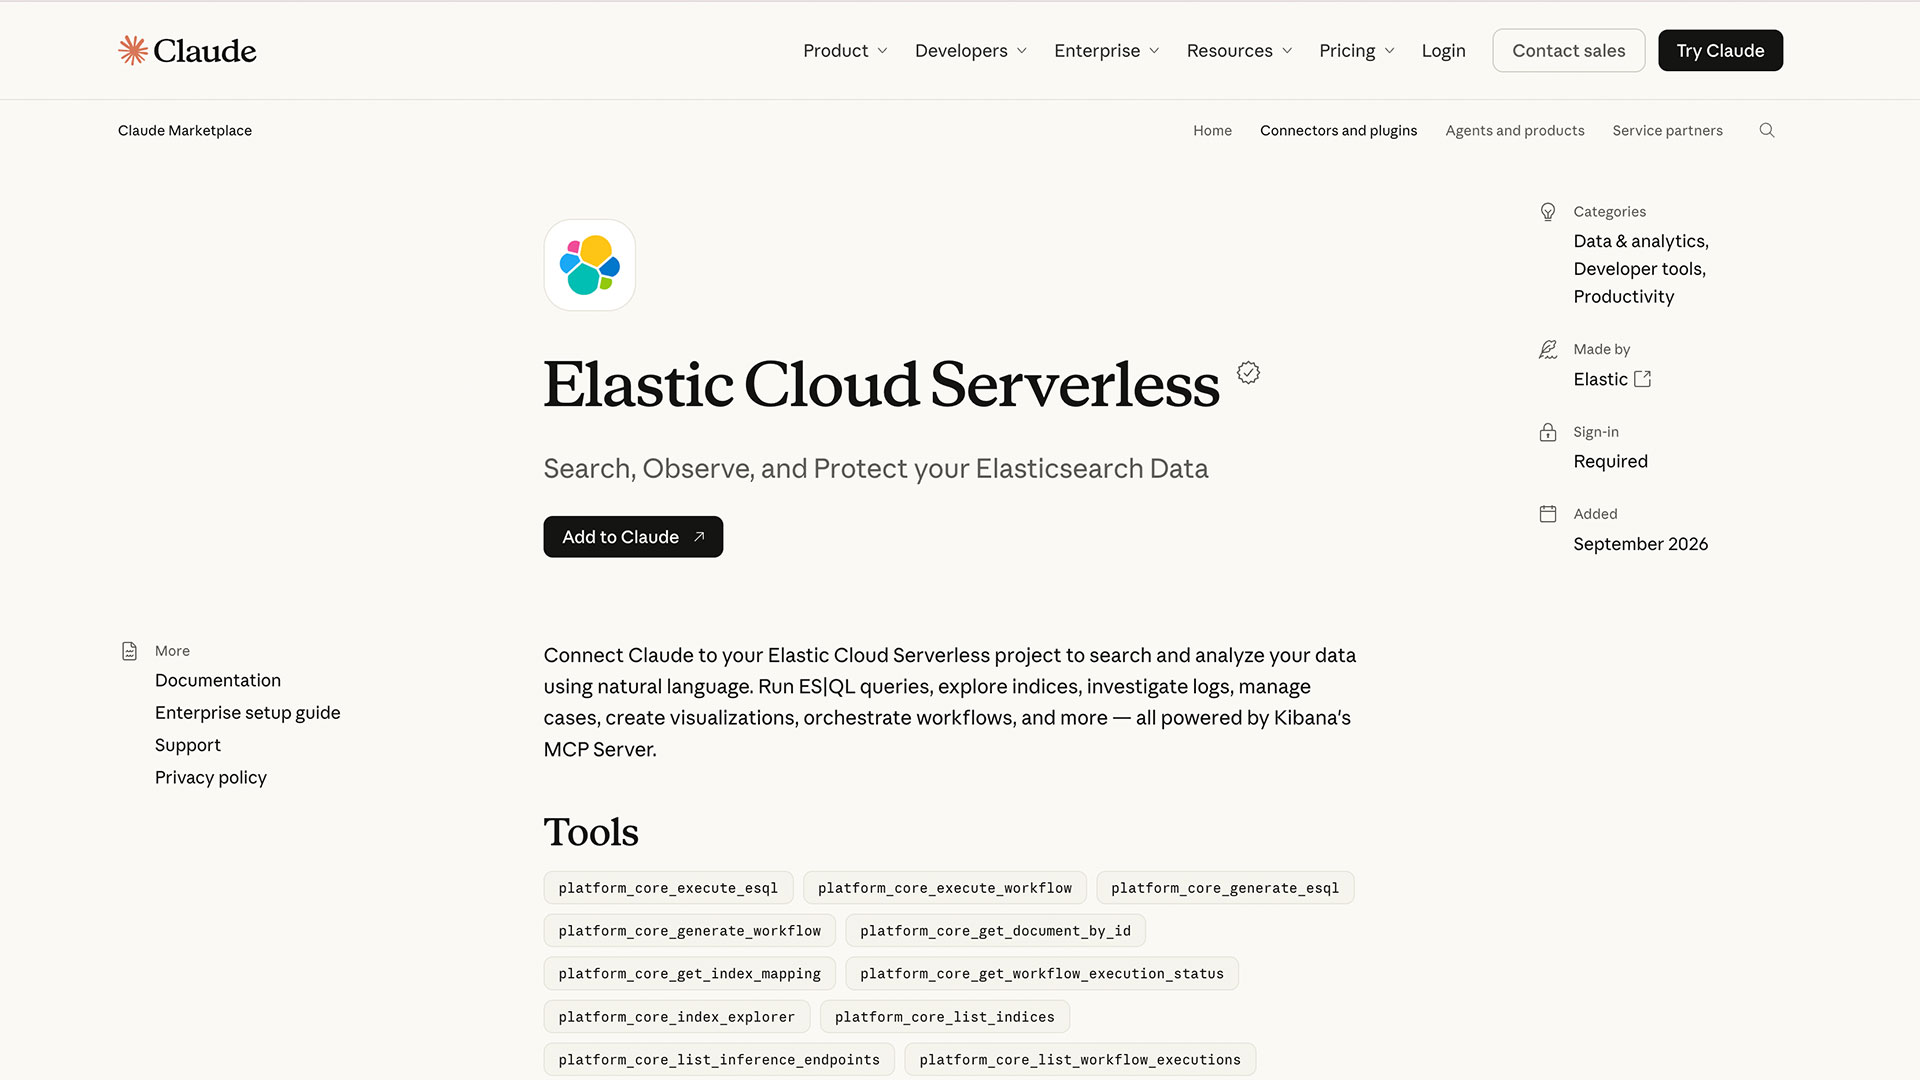
Connectez vos données d'entreprise, utilisez Elastic Workflows pour en extraire des Knowledge Indicators structurés et mettez ce contexte à la disposition de tous vos agents.
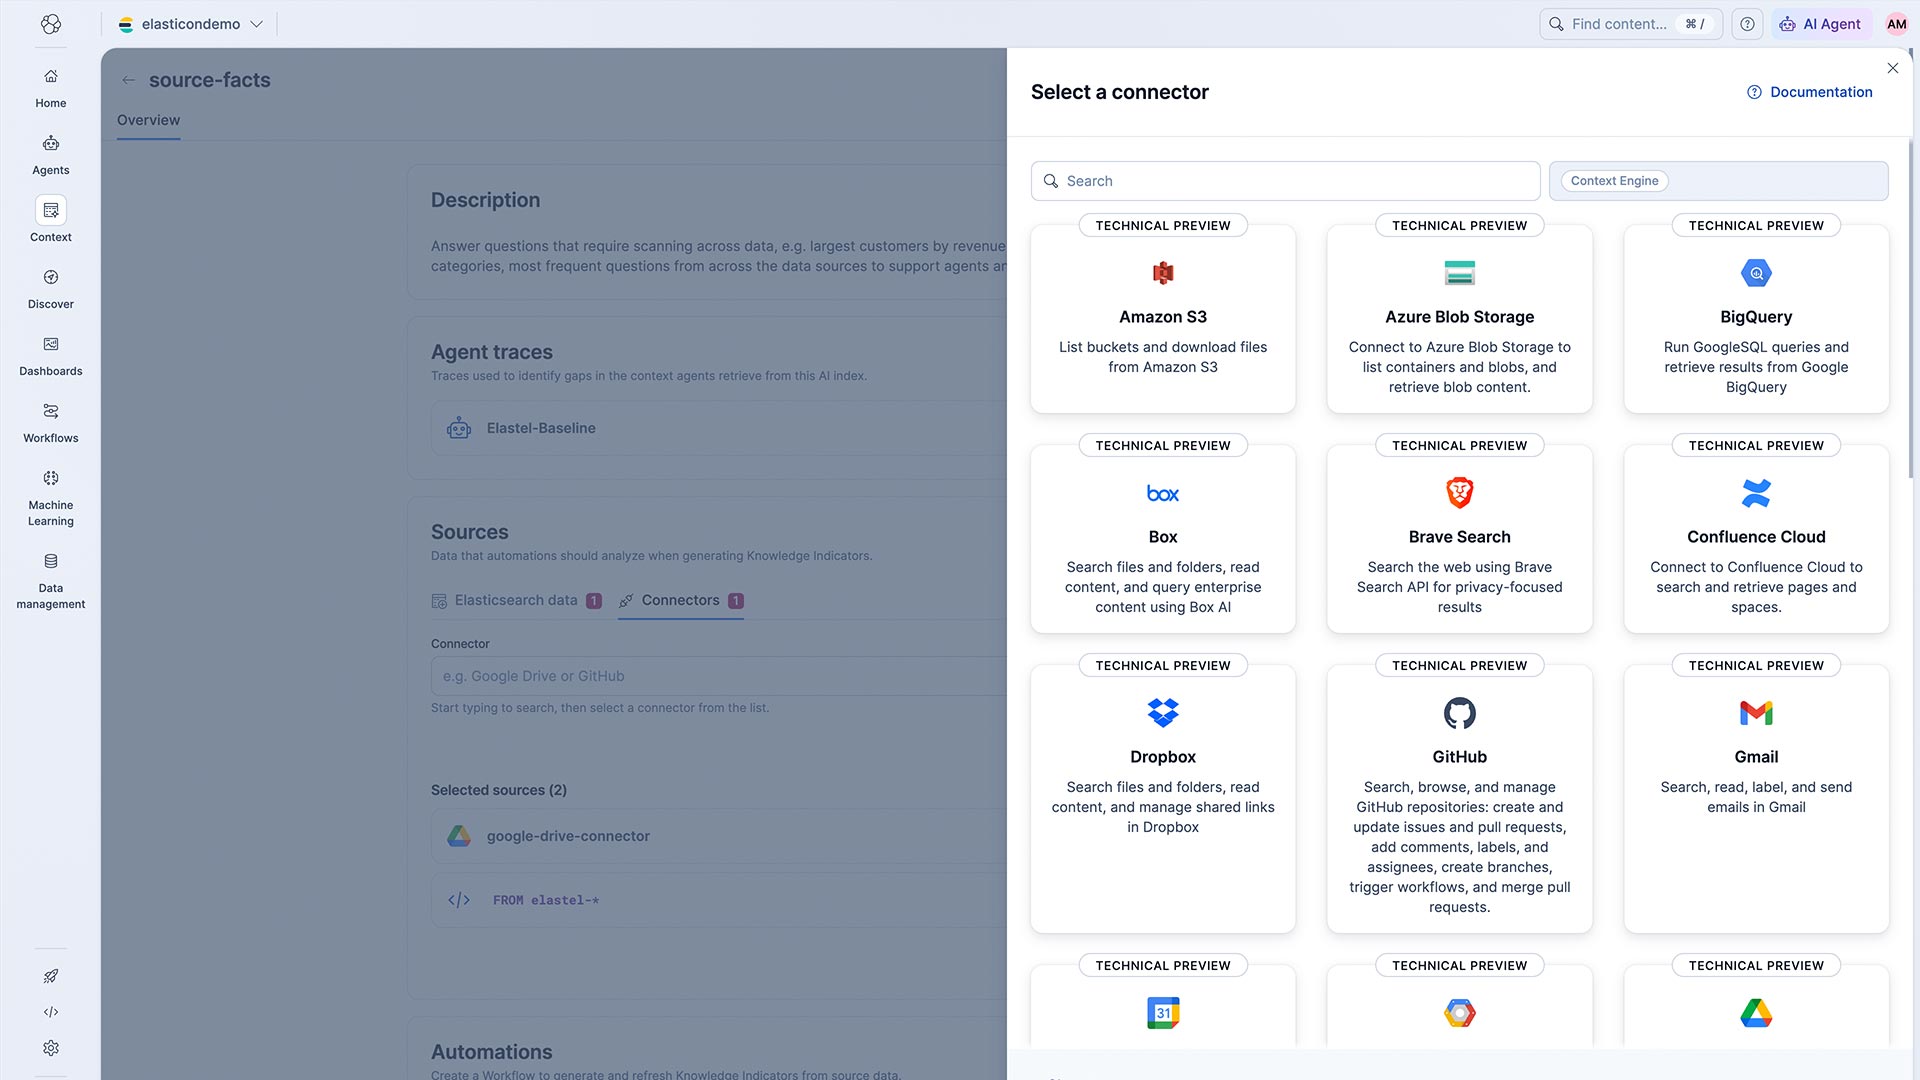
Connecter
Donnez à vos agents accès au contexte issu des index Elasticsearch, de sources de données externes via les connecteurs Kibana ou de requêtes ES|QL.
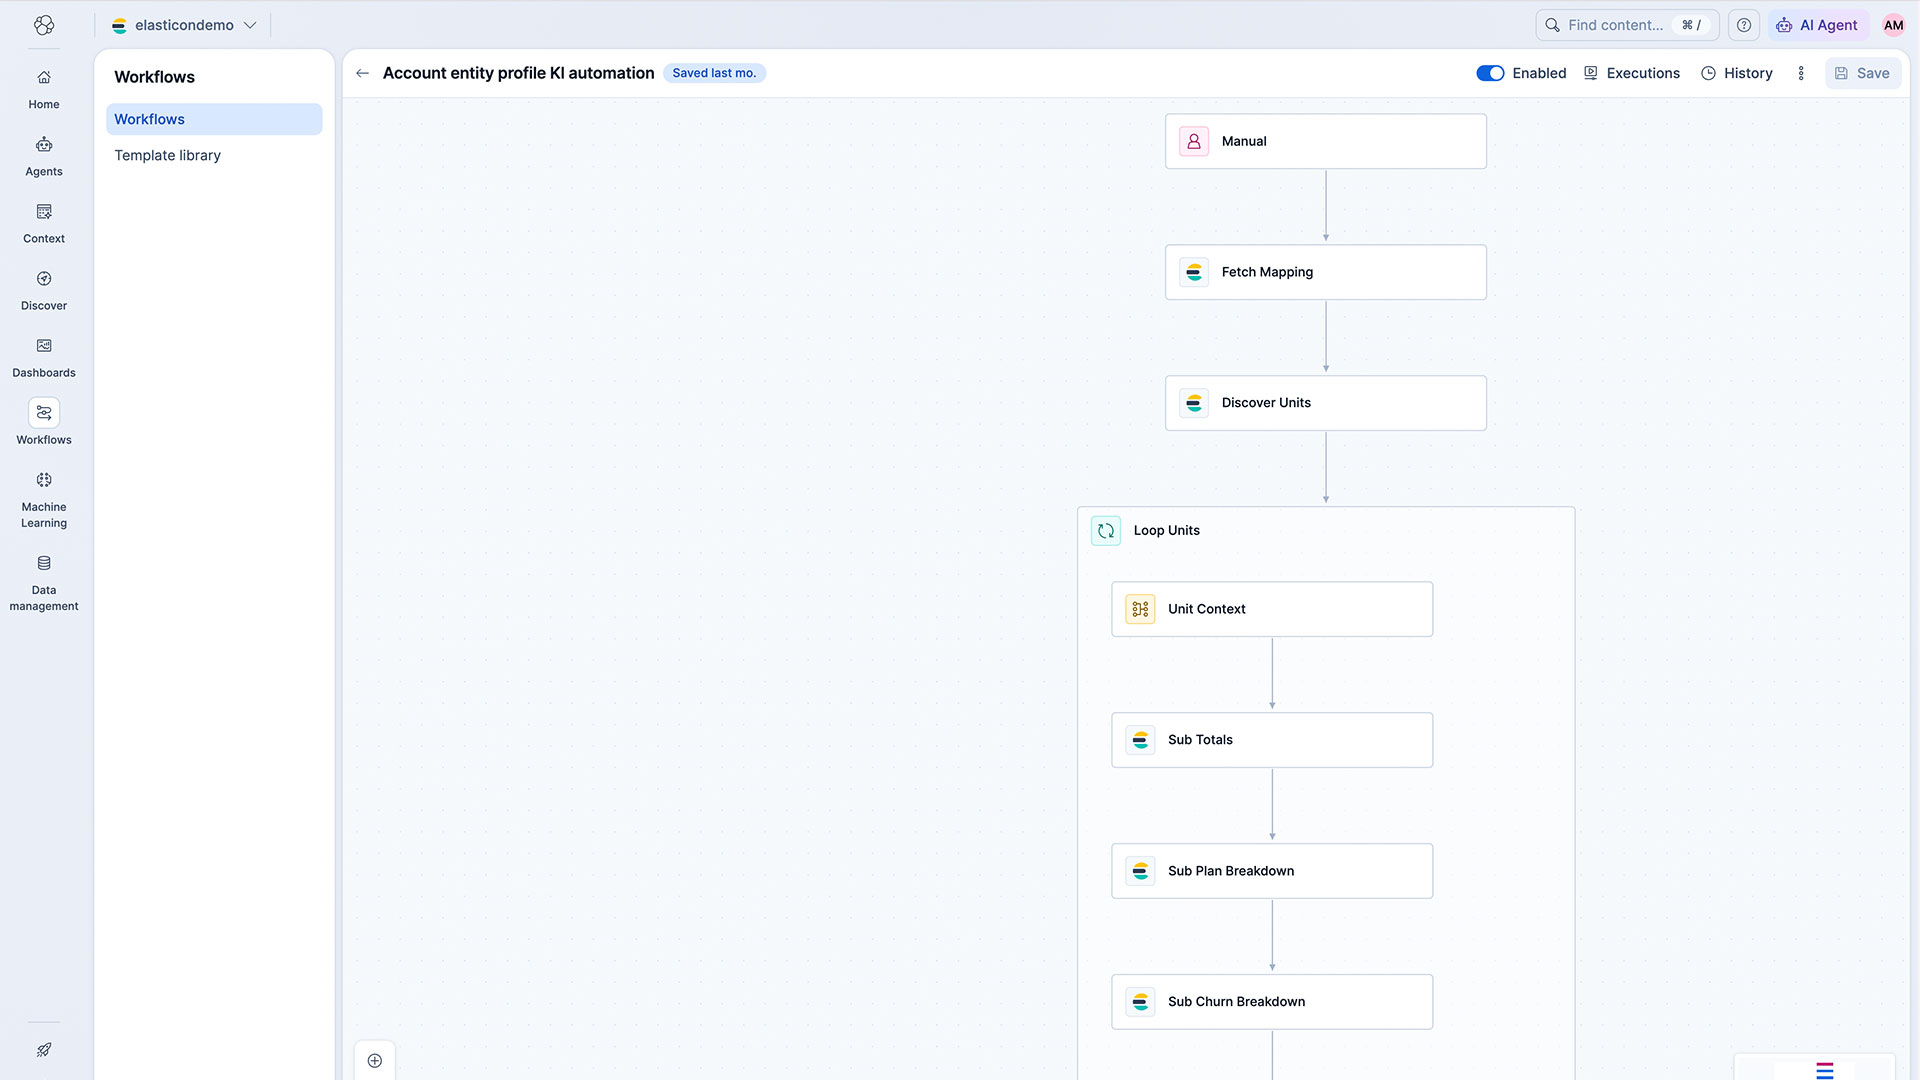
Assembler
Créez des automatisations qui génèrent des Knowledge Indicators pour extraire la sémantique des données, les descriptions, les relations et les informations factuelles, puis les stocker dans un index d'IA.
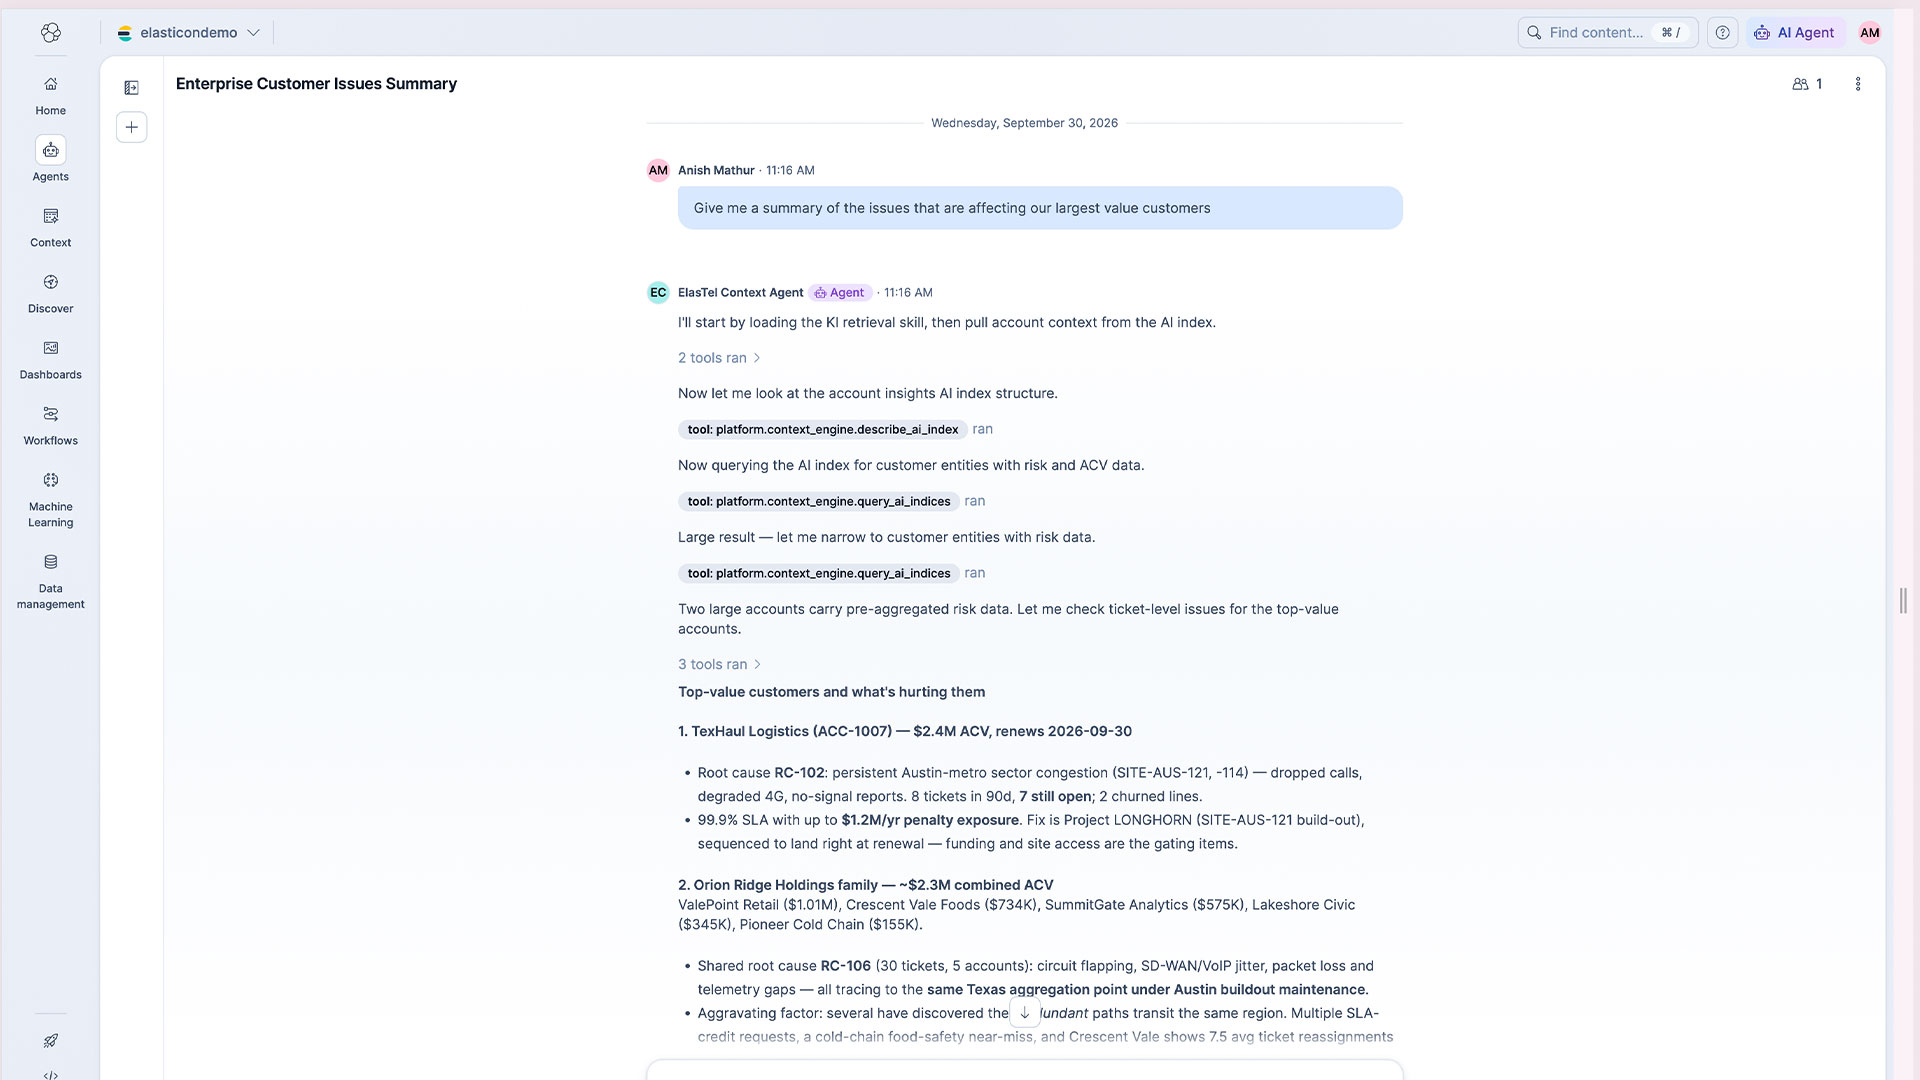
Récupérer
Exploitez ES|QL composable pour récupérer le contexte le plus pertinent au moment de l’inférence.
Observe et améliorez
Utilisez les évaluations et les traces pour suivre les réponses des agents et améliorer le contexte.
Intégrer
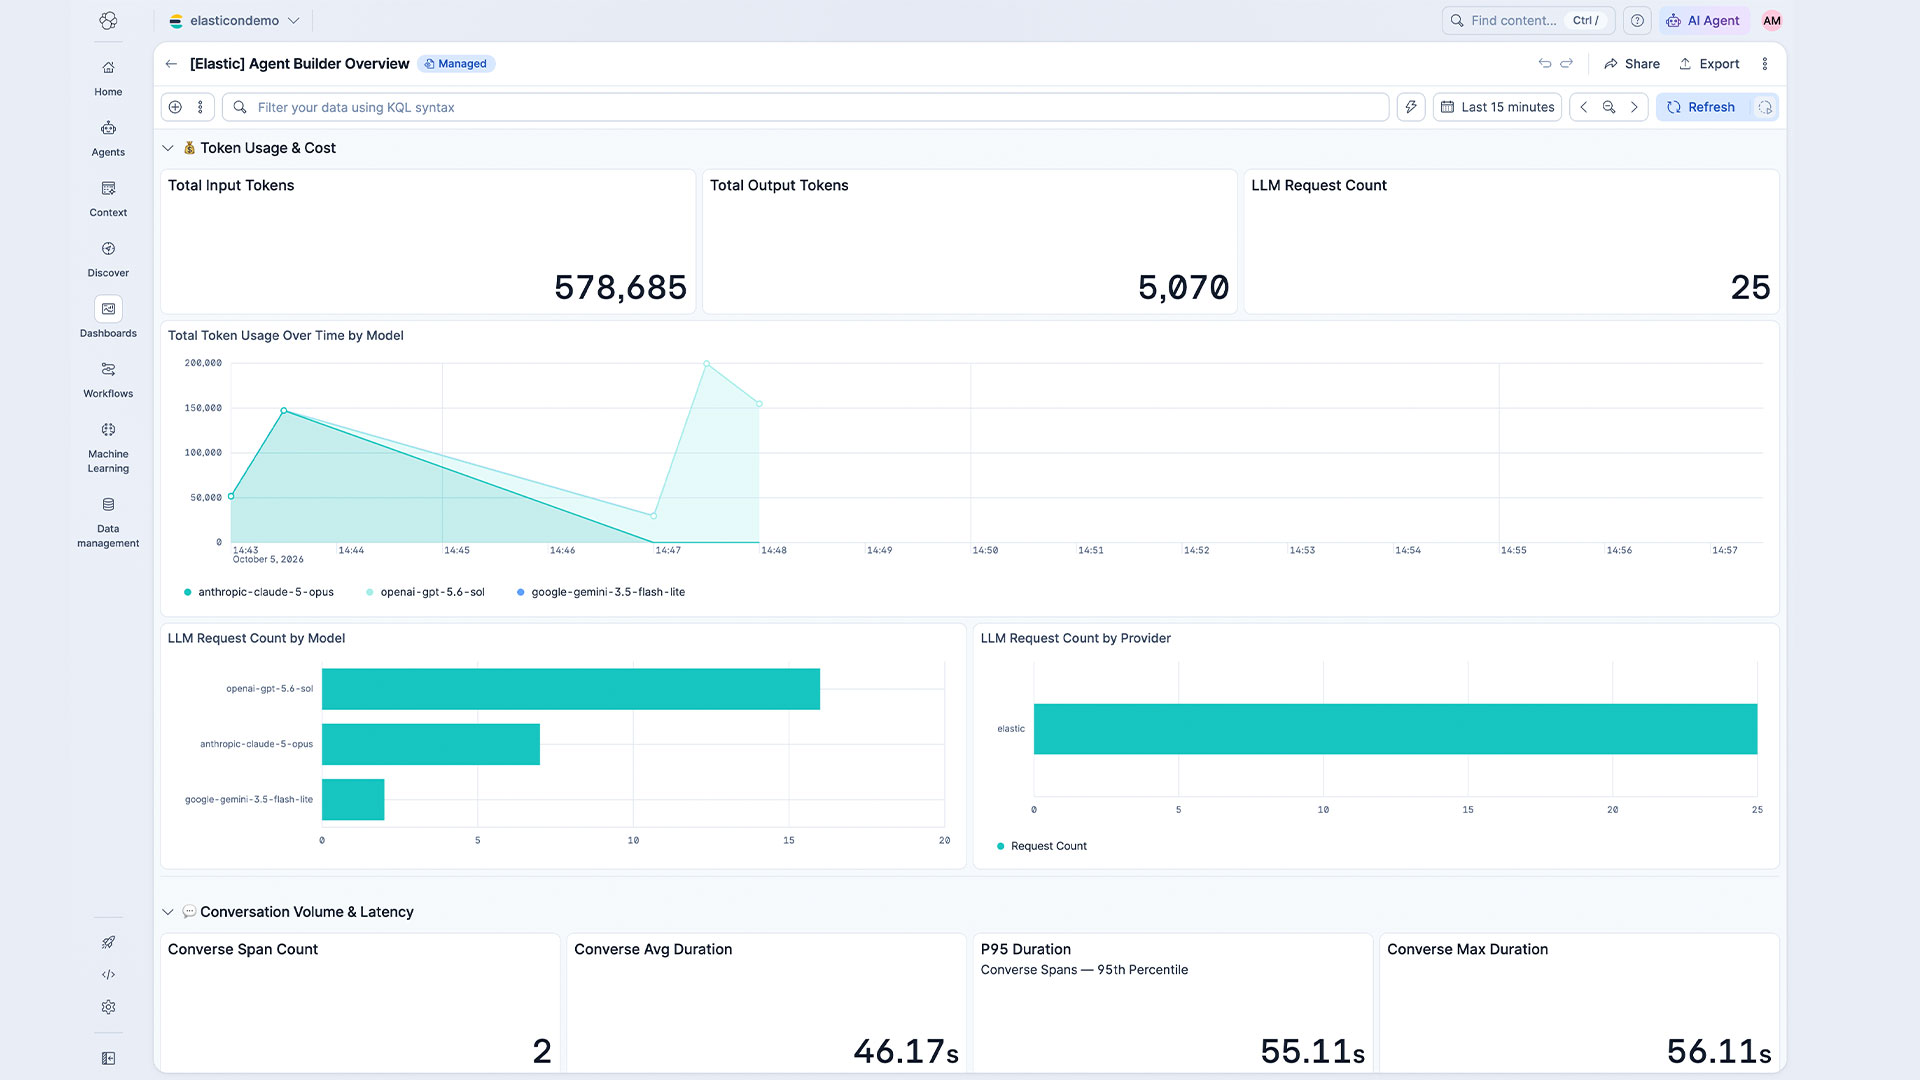
Fournissez du contexte aux agents internes et tiers grâce à des plugins permettant d'intégrer différents environnements d'exécution d'agents, notamment Claude Code, Codex, LangChain Deep Agents, les agents gérés par Claude, AWS AgentCore, Gemini Agent Platform et bien d'autres.
Architecture
Des automatisations extraient en amont les Knowledge Indicators et les stockent dans un index d'IA. Ainsi, n'importe quel agent peut récupérer le contexte pertinent à l'aide d'une simple requête ES|QL.
Types de contexte
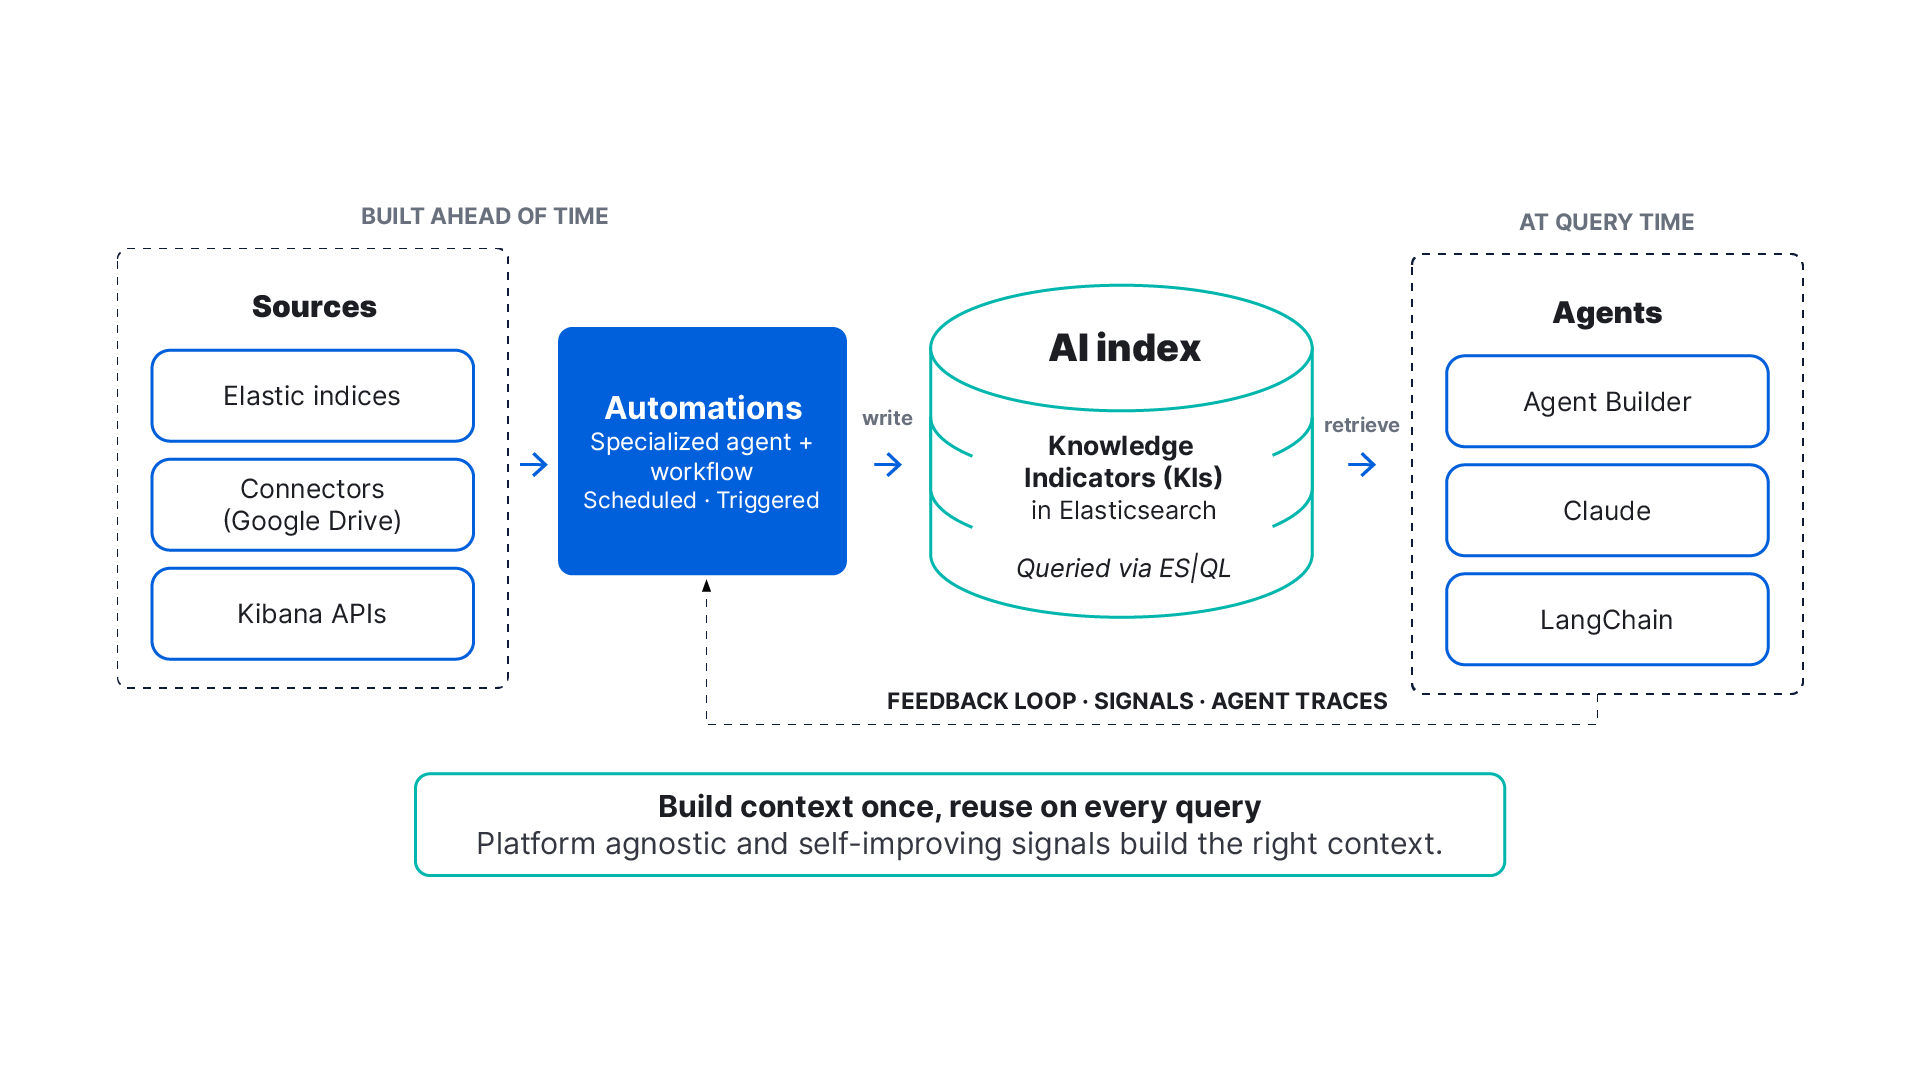
Créez différents types de Knowledge Indicators à partir de données brutes.
Métadonnées sémantiques issues des sources
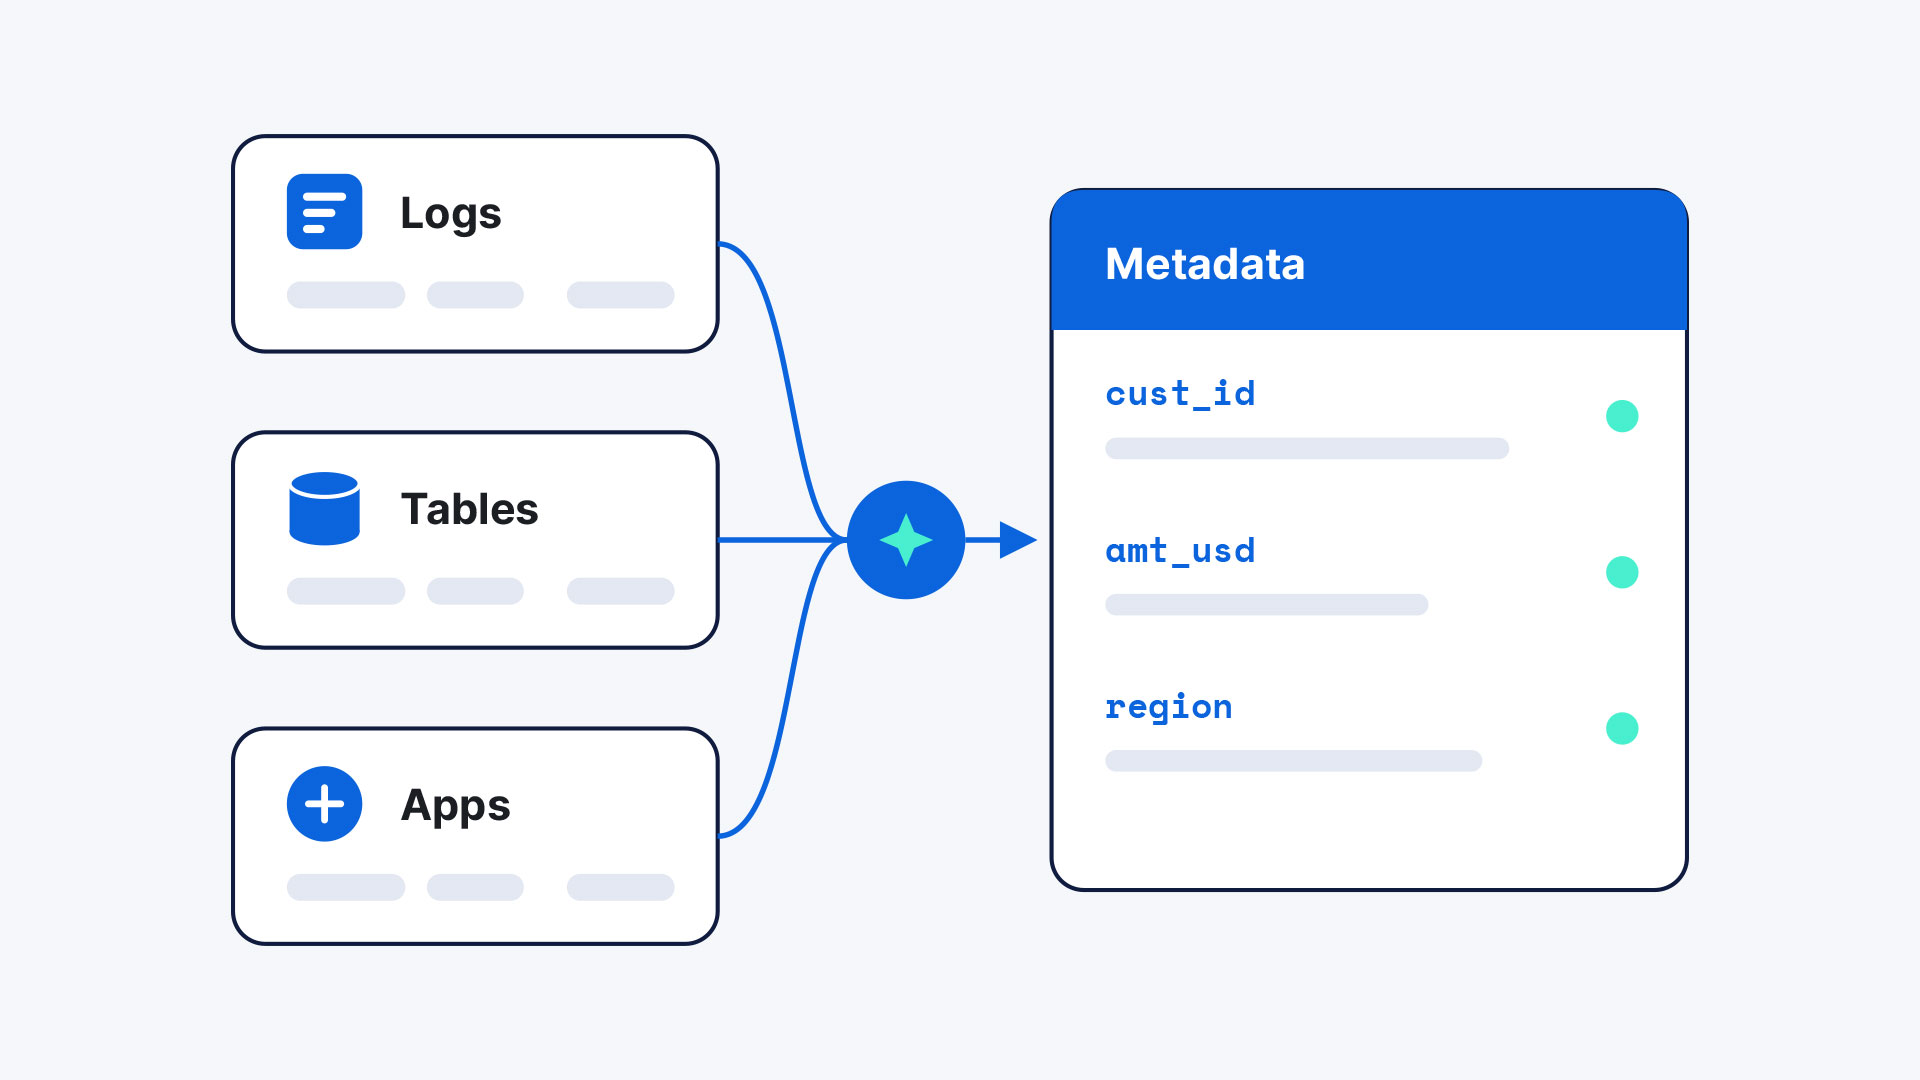
Établissez des profils des sources de données, avec des descriptions de leur objectif, de leurs champs, de la distribution et des caractéristiques des données, afin d’indiquer comment les interroger et quand les utiliser.
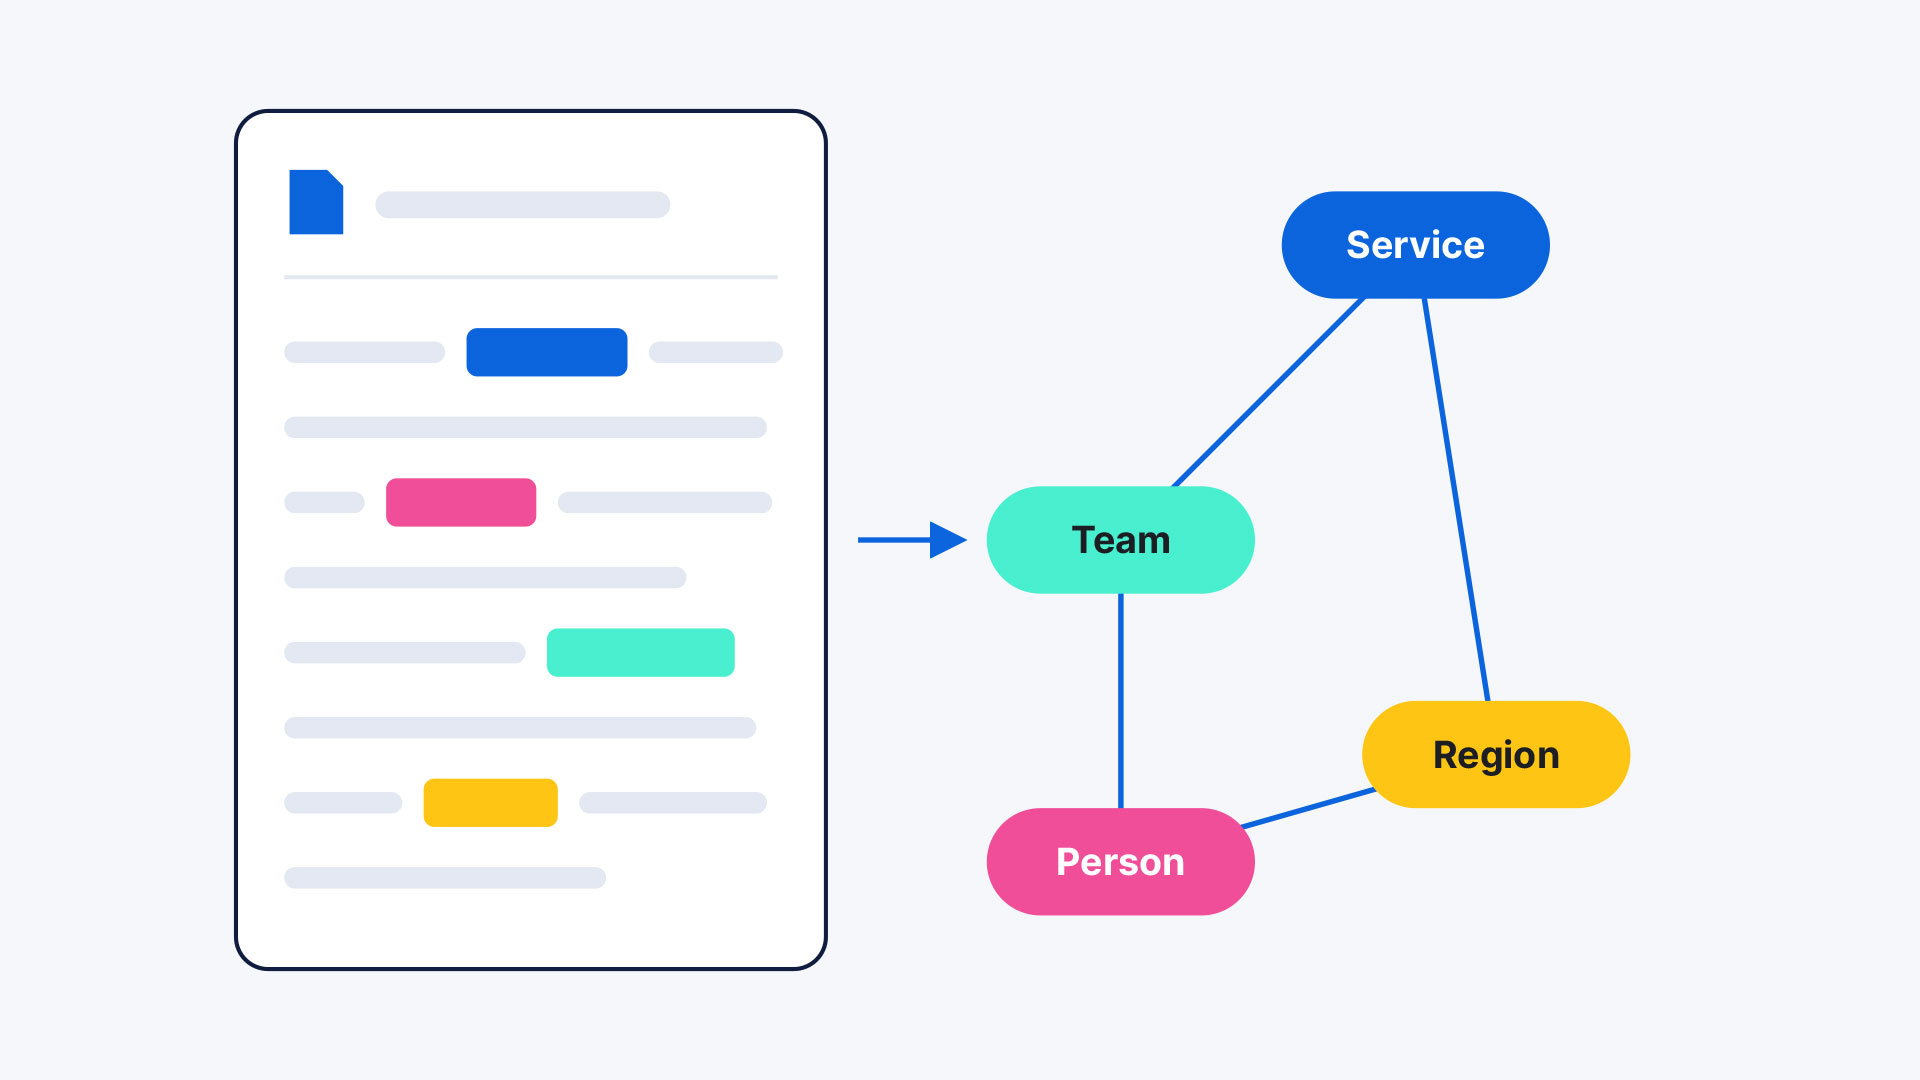
Entités et relations issues de documents
Extrayez des entités telles que des comptes, des contacts, des projets, des objectifs métier, des systèmes, et des services, et stockez-les avec leurs relations sémantiques afin de guider le raisonnement de l’agent.
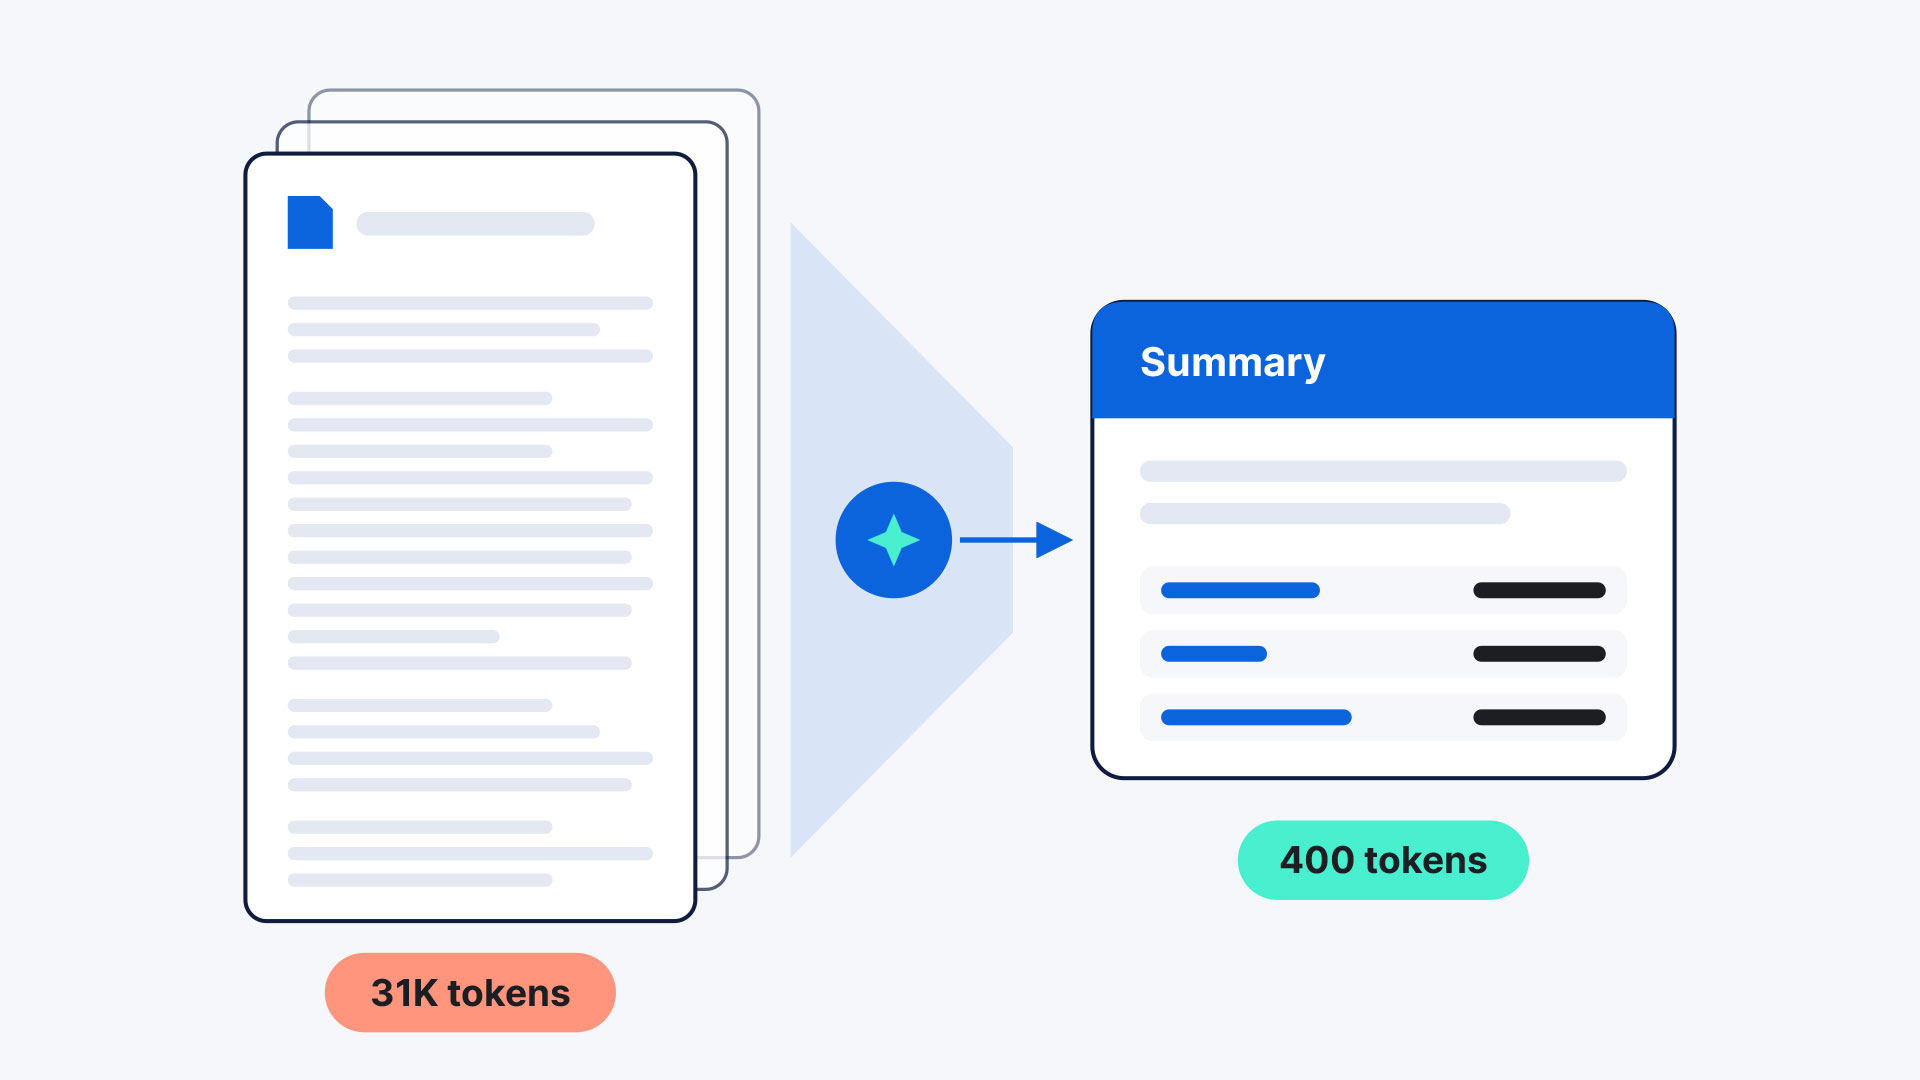
Faits et résumés de documents
Résumez les documents volumineux et complexes et extrayez-en les faits essentiels afin de réduire les lectures de documents coûteuses.
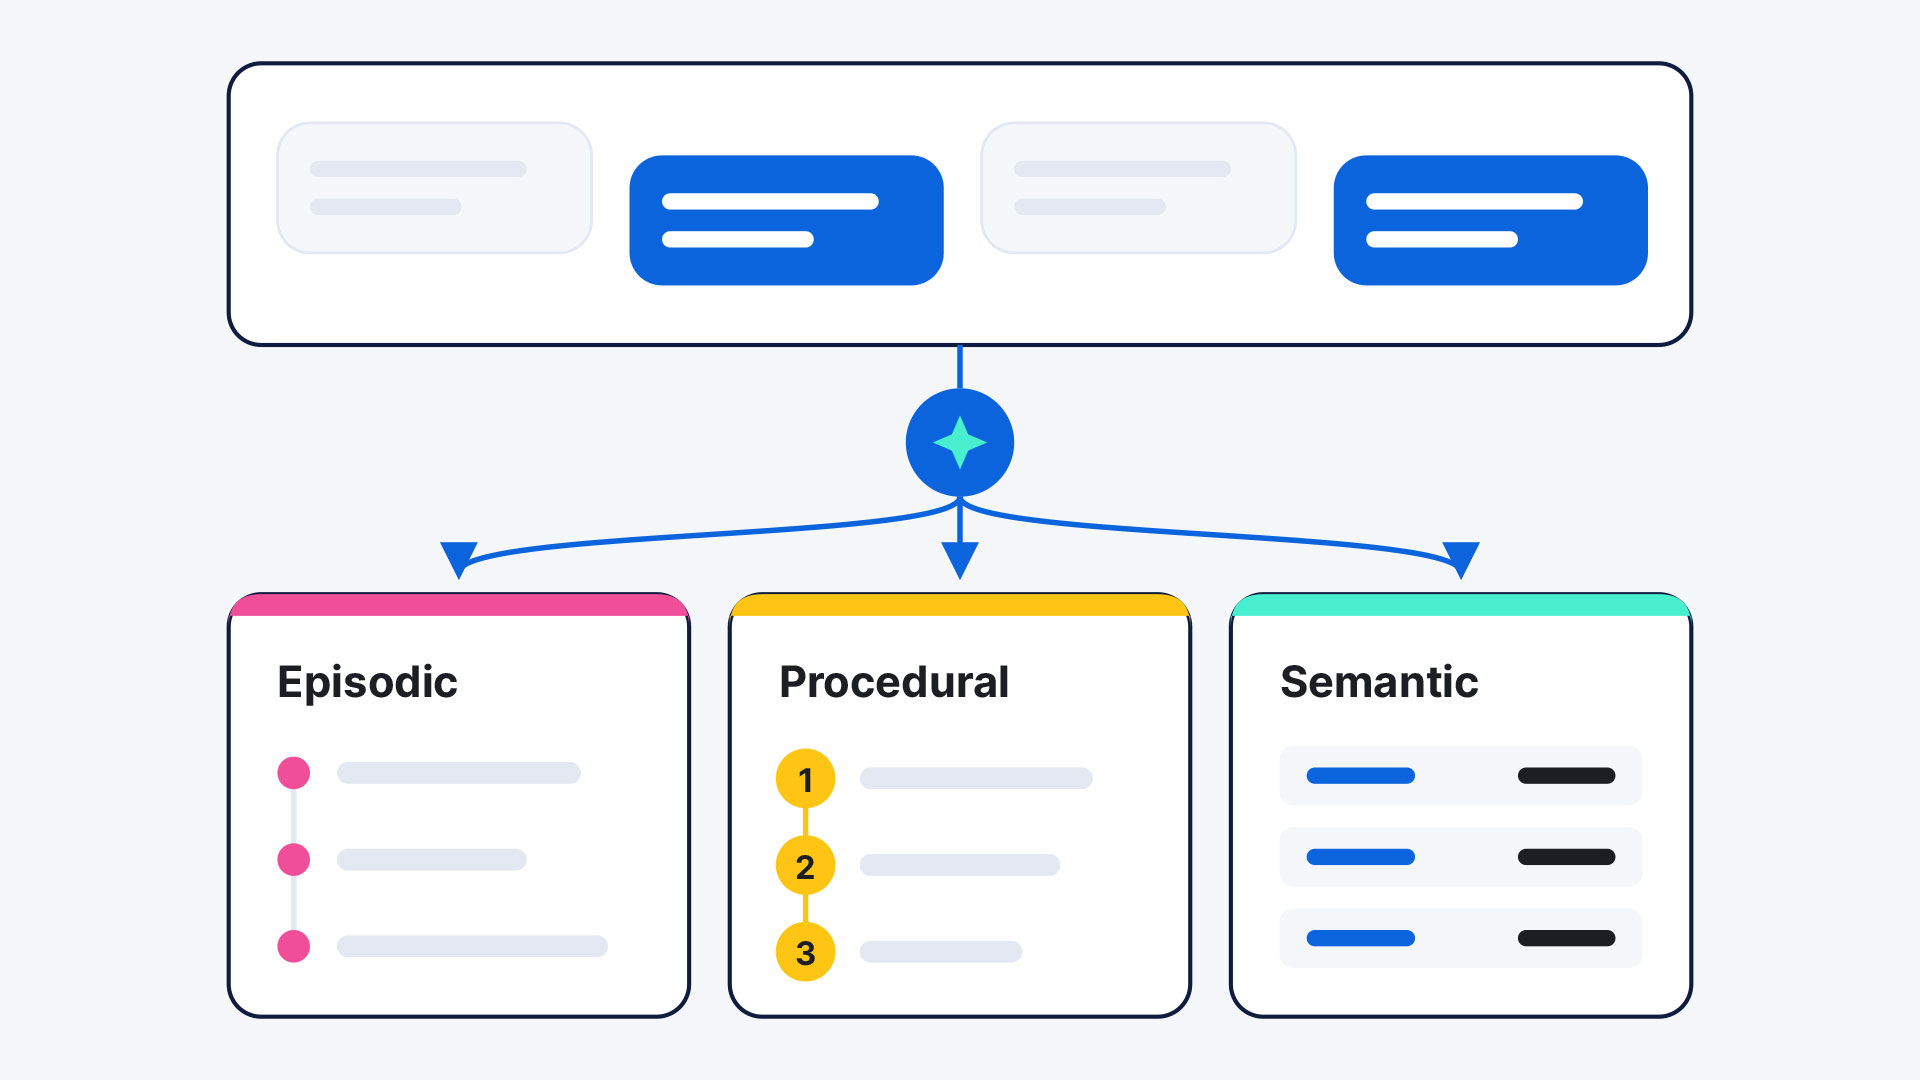
Mémoire de l’agent issue des interactions
Consignez les informations en mémoire pour accélérer les réponses et enrichir les connaissances de chaque agent au fil du temps.
CAS D'UTILISATION
Cas d'utilisation des agents
Cartographiez, effectuez des pré-calculs et identifiez les relations.


INTÉGRATIONS
Le meilleur de sa catégorie ? Intégré
Intégrez-vous aux frameworks d’agents et aux applications les plus populaires.
RESSOURCES POUR DÉMARRER
Passez aux étapes suivantes
En savoir plus grâce à des guides pas à pas, des démonstrations, et de la documentation.
Suivez un guide pas à pas pour créer et stocker du contexte dans un index d'IA et rendre vos agents plus intelligents tout en consommant moins de tokens.
Explorez cette démo interactive pour découvrir à quel point il est facile de commencer avec Context Engine.
Questions fréquentes
Qu'est-ce qu'un moteur de contexte ?
Qu'est-ce qu'un moteur de contexte ?
Un moteur de contexte fait partie de l’architecture d’un agent. Il recueille et construit le contexte à partir de données spécifiques à l’entreprise et d’interactions afin de rendre l’agent plus efficient et plus efficace.
Quelle est la différence entre un moteur de contexte, une base de données vectorielle et un système de stockage de mémoire ?
Quelle est la différence entre un moteur de contexte, une base de données vectorielle et un système de stockage de mémoire ?
Un moteur de contexte s'appuie sur des bases de données vectorielles et des systèmes de stockage de mémoire. Une base de données vectorielle permet de stocker et de récupérer le contexte, tandis qu'un système de stockage de mémoire capture directement le contexte des interactions avec les agents. Le moteur de contexte détermine les informations à stocker dans ces systèmes, la manière de les structurer, de les maintenir à jour, de les gouverner et de les sécuriser, ainsi que les outils permettant de les rendre accessibles pour leur récupération.
J’ai déjà un catalogue de données. Pourquoi ai-je besoin d’un moteur de contexte ?
J’ai déjà un catalogue de données. Pourquoi ai-je besoin d’un moteur de contexte ?
Les catalogues de données décrivent les données, mais reposent sur des informations statiques qui nécessitent des mises à jour manuelles. À mesure que les données évoluent, que les cas d'utilisation des agents se multiplient et que les comportements des utilisateurs et les prompts changent, ces catalogues deviennent rapidement obsolètes. En outre, ils offrent généralement peu de visibilité sur le contenu même des données. Ils peuvent en décrire la structure et le schéma, mais pas les entités, les anomalies ou les tendances dont l'identification nécessite des fonctionnalités de recherche et de récupération d'informations.
Qu'est-ce qu'un indicateur de connaissances ?
Qu'est-ce qu'un indicateur de connaissances ?
Un indicateur de connaissances est une unité de contexte. Il peut s’agir de tout élément de contexte pouvant être utile aux agents, y compris des descriptions d’index et de sources de données, des entités extraites, des faits tirés de documents, etc.
Que contient un index d'IA ?
Que contient un index d'IA ?
Un index d’IA stocke des indicateurs de connaissances issus de sources de données et des mémoires issues des interactions avec les agents et des traces.
Comment la sécurité et les autorisations sont-elles appliquées ?
Comment la sécurité et les autorisations sont-elles appliquées ?
Les index d'IA peuvent être gérés et soumis à des autorisations comme les autres index Elasticsearch, grâce à un contrôle d'accès complet basé sur les rôles. Les workflows et les agents peuvent être exécutés avec les droits d'un utilisateur afin de restreindre et d'auditer les accès. Context Engine enregistre également la provenance de chaque Knowledge Indicator généré pour faciliter la gestion des accès.
Comment Context Engine est-il facturé ?
Comment Context Engine est-il facturé ?
Context Engine ne fait actuellement l'objet d'aucune tarification distincte pendant sa phase de préversion privée. Les tarifs seront annoncés ultérieurement.