Elastic-Kontext-Engine
Vollständiger und aktueller Kontext
Elastic Context Engine* verbindet Unternehmensquellen mit präzisen Agenten: Kontextsynchronisierung nach Interaktion/Plan, Berechnung von schnellem quellübergreifendem Abruf und bessere Genauigkeit.
*Experimentell
Lesen Sie unseren Blog, um zu erfahren, wie Sie Kontext kontinuierlich kuratieren und verwalten.
Blogeintrag lesenIn unserer Dokumentation erfahren Sie mehr über Context Engine und darüber, wie Sie loslegen können.
Dokumentation ansehenWas leistet eine Context Engine für Agenten?
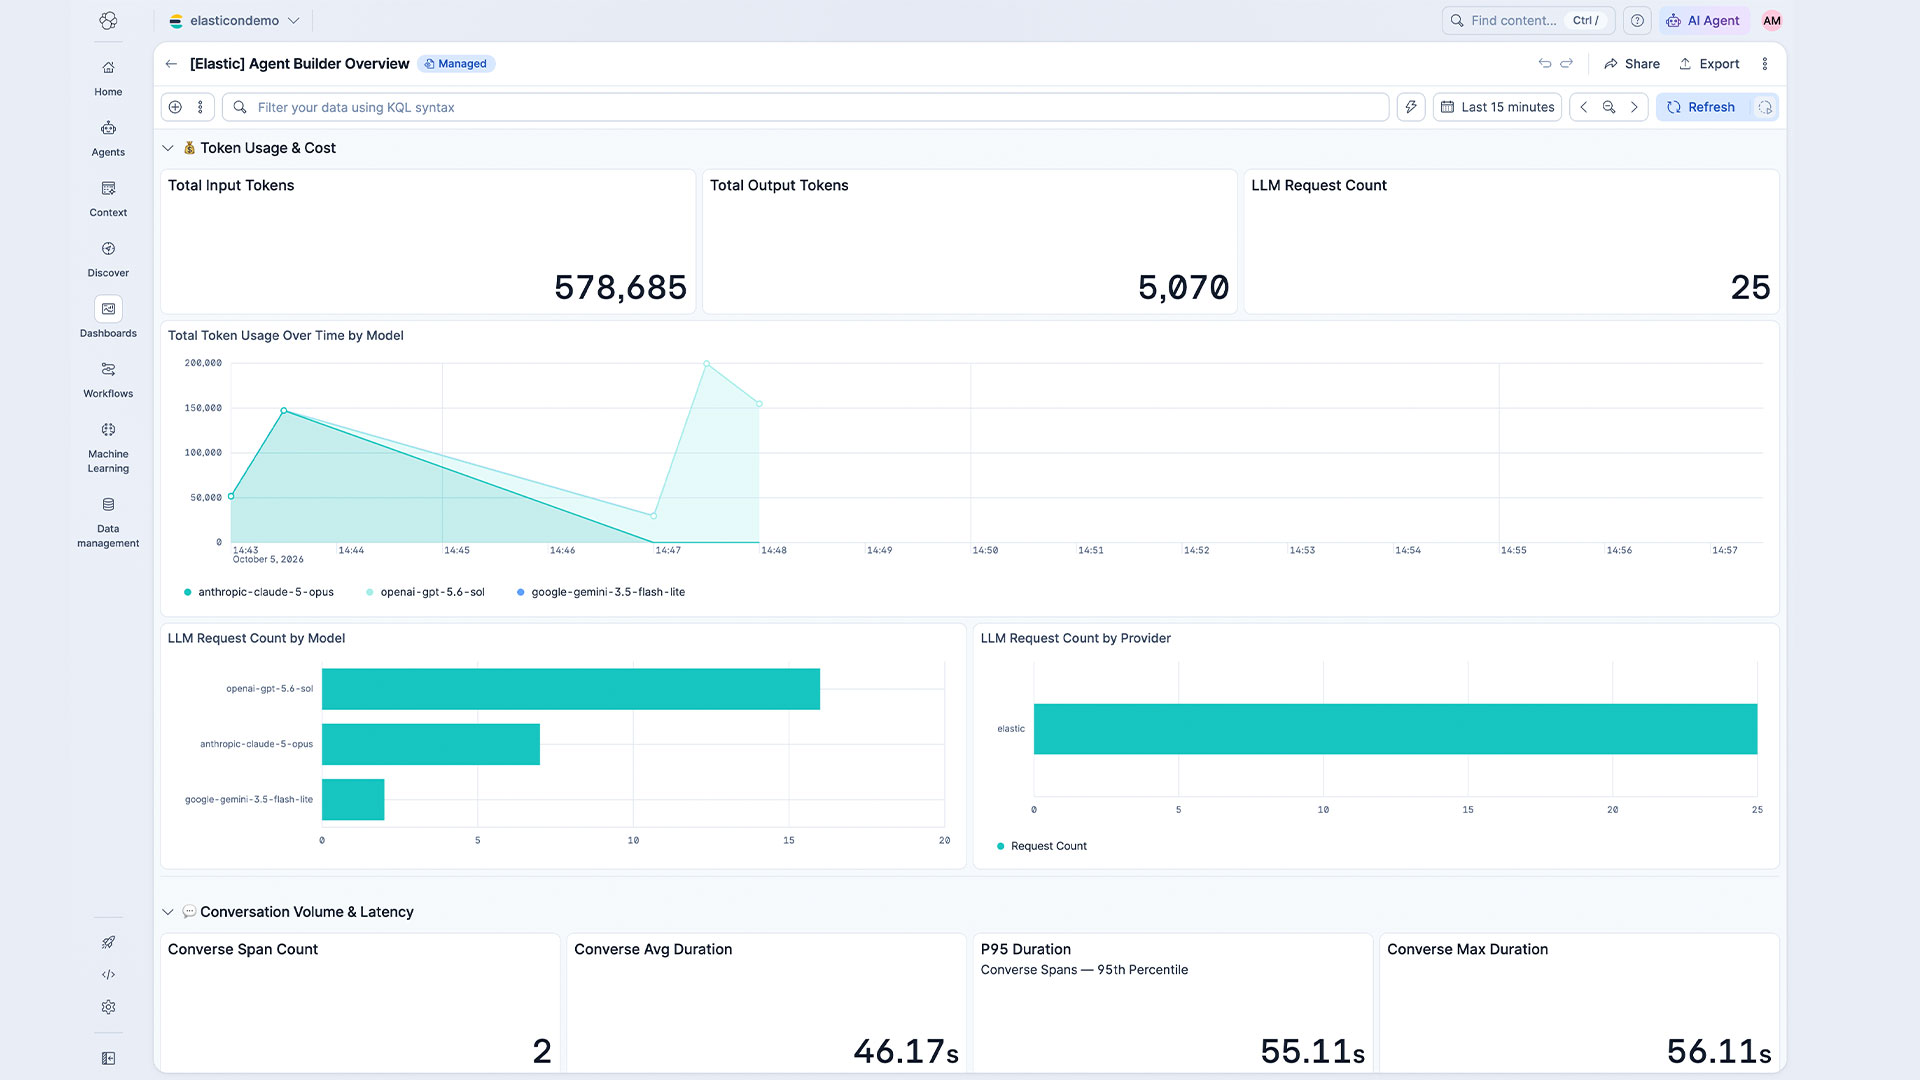
Berechnen Sie den Kontext im Voraus, um Eingabetokens zu reduzieren, die Latenz zu senken und die Antwortqualität zu verbessern. Mit der Context Engine für Support-Agenten sanken die Kosten um 55 % und die Latenz um 40 %.
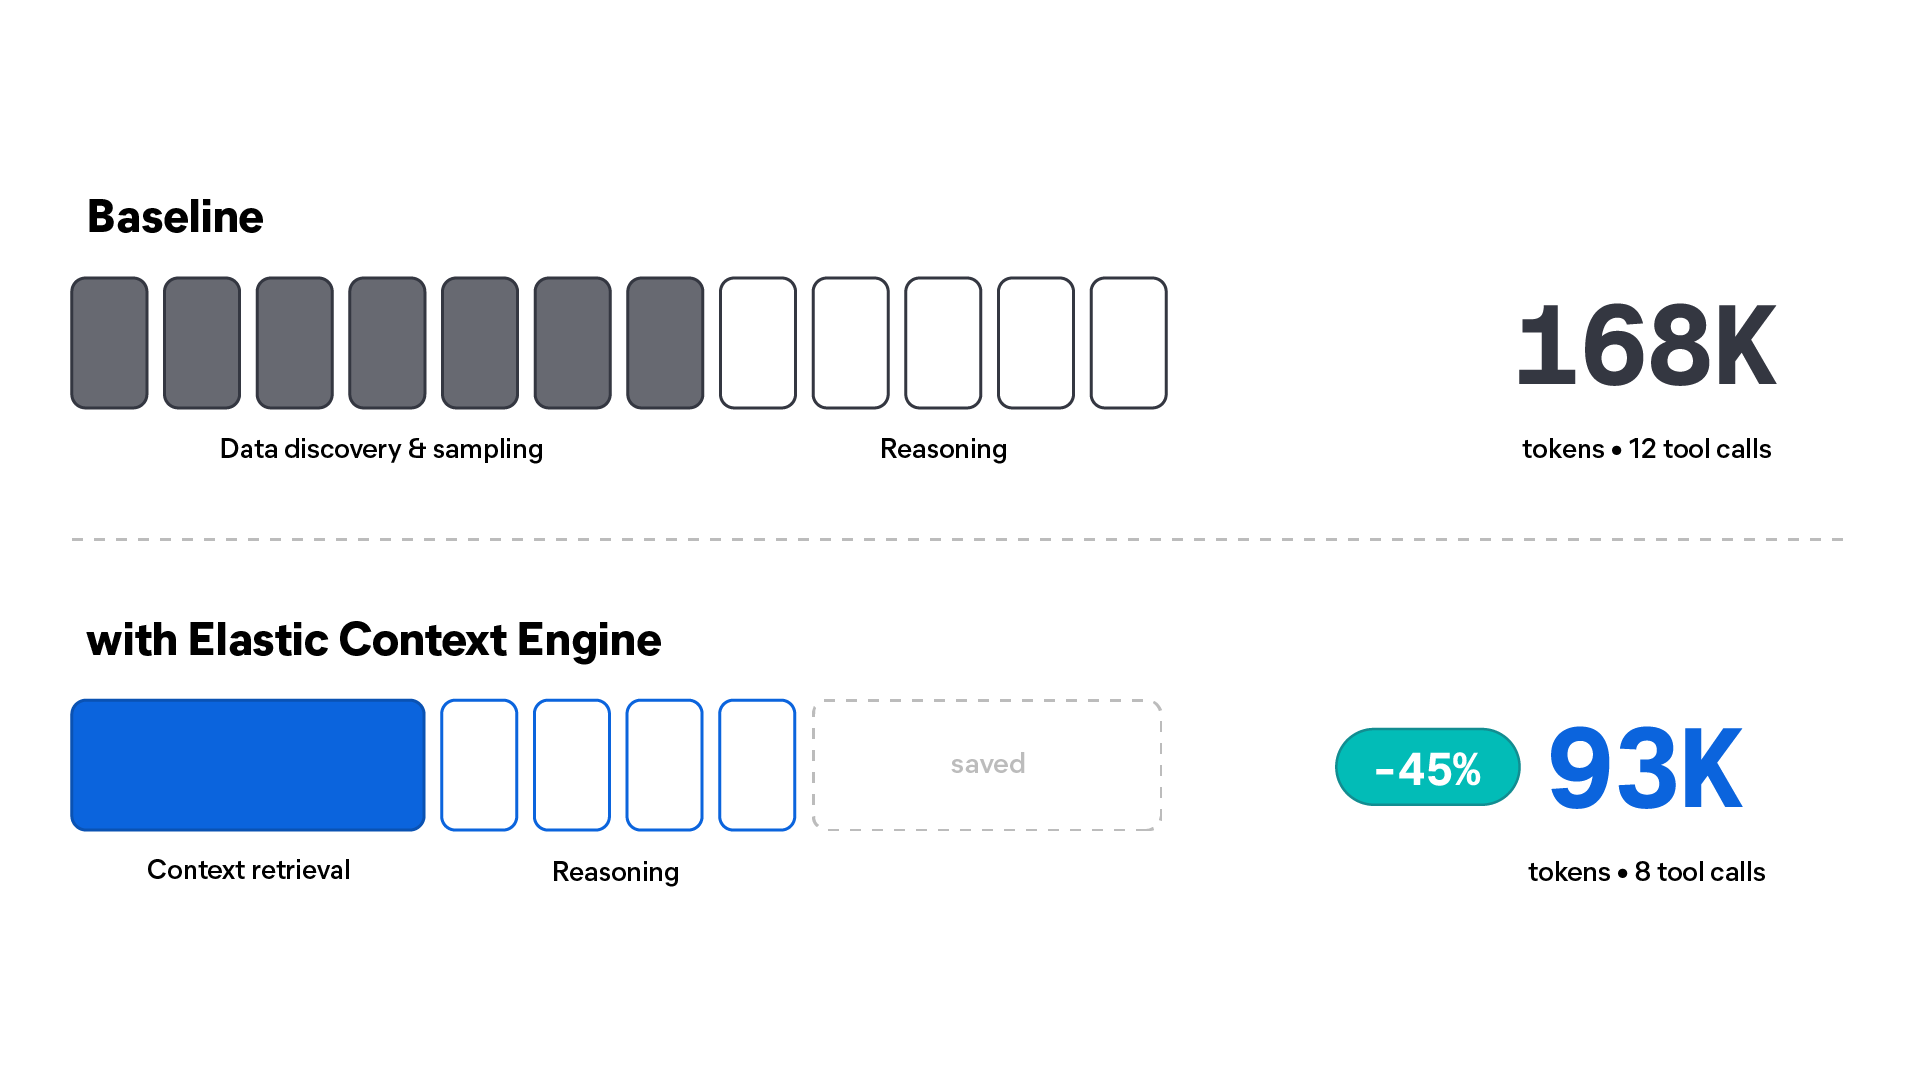
Baseline-RAG
Mit Context Engine (*Quelle)
VORTEILE
Alle Agenten effizienter gestalten
Sorgen Sie kontinuierlich dafür, dass der Kontext Ihrer Agenten vollständig, aktuell, effizient und messbar bleibt.


So funktionierts
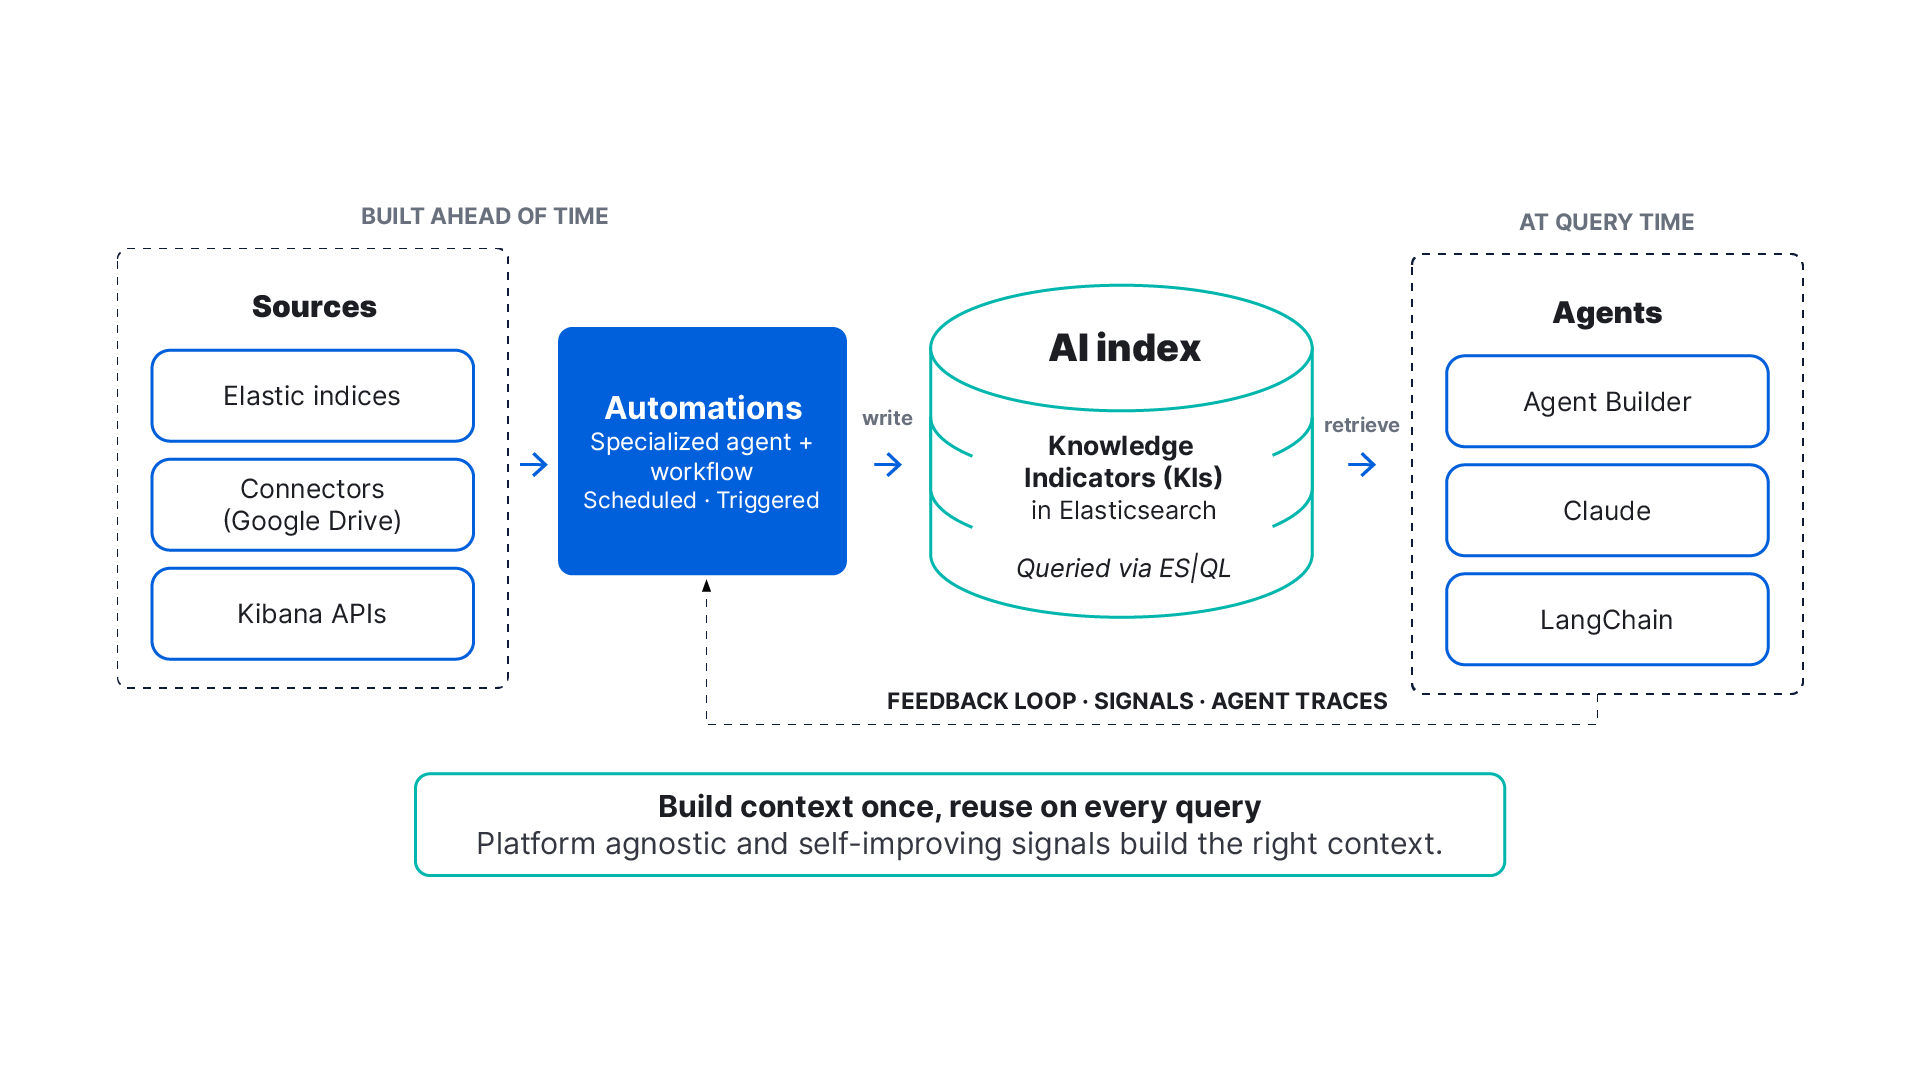
Verbinden Sie Unternehmensdaten, nutzen Sie Elastic Workflows, um daraus strukturierte Wissensindikatoren abzuleiten, und stellen Sie diesen Kontext jedem Agenten bereit.
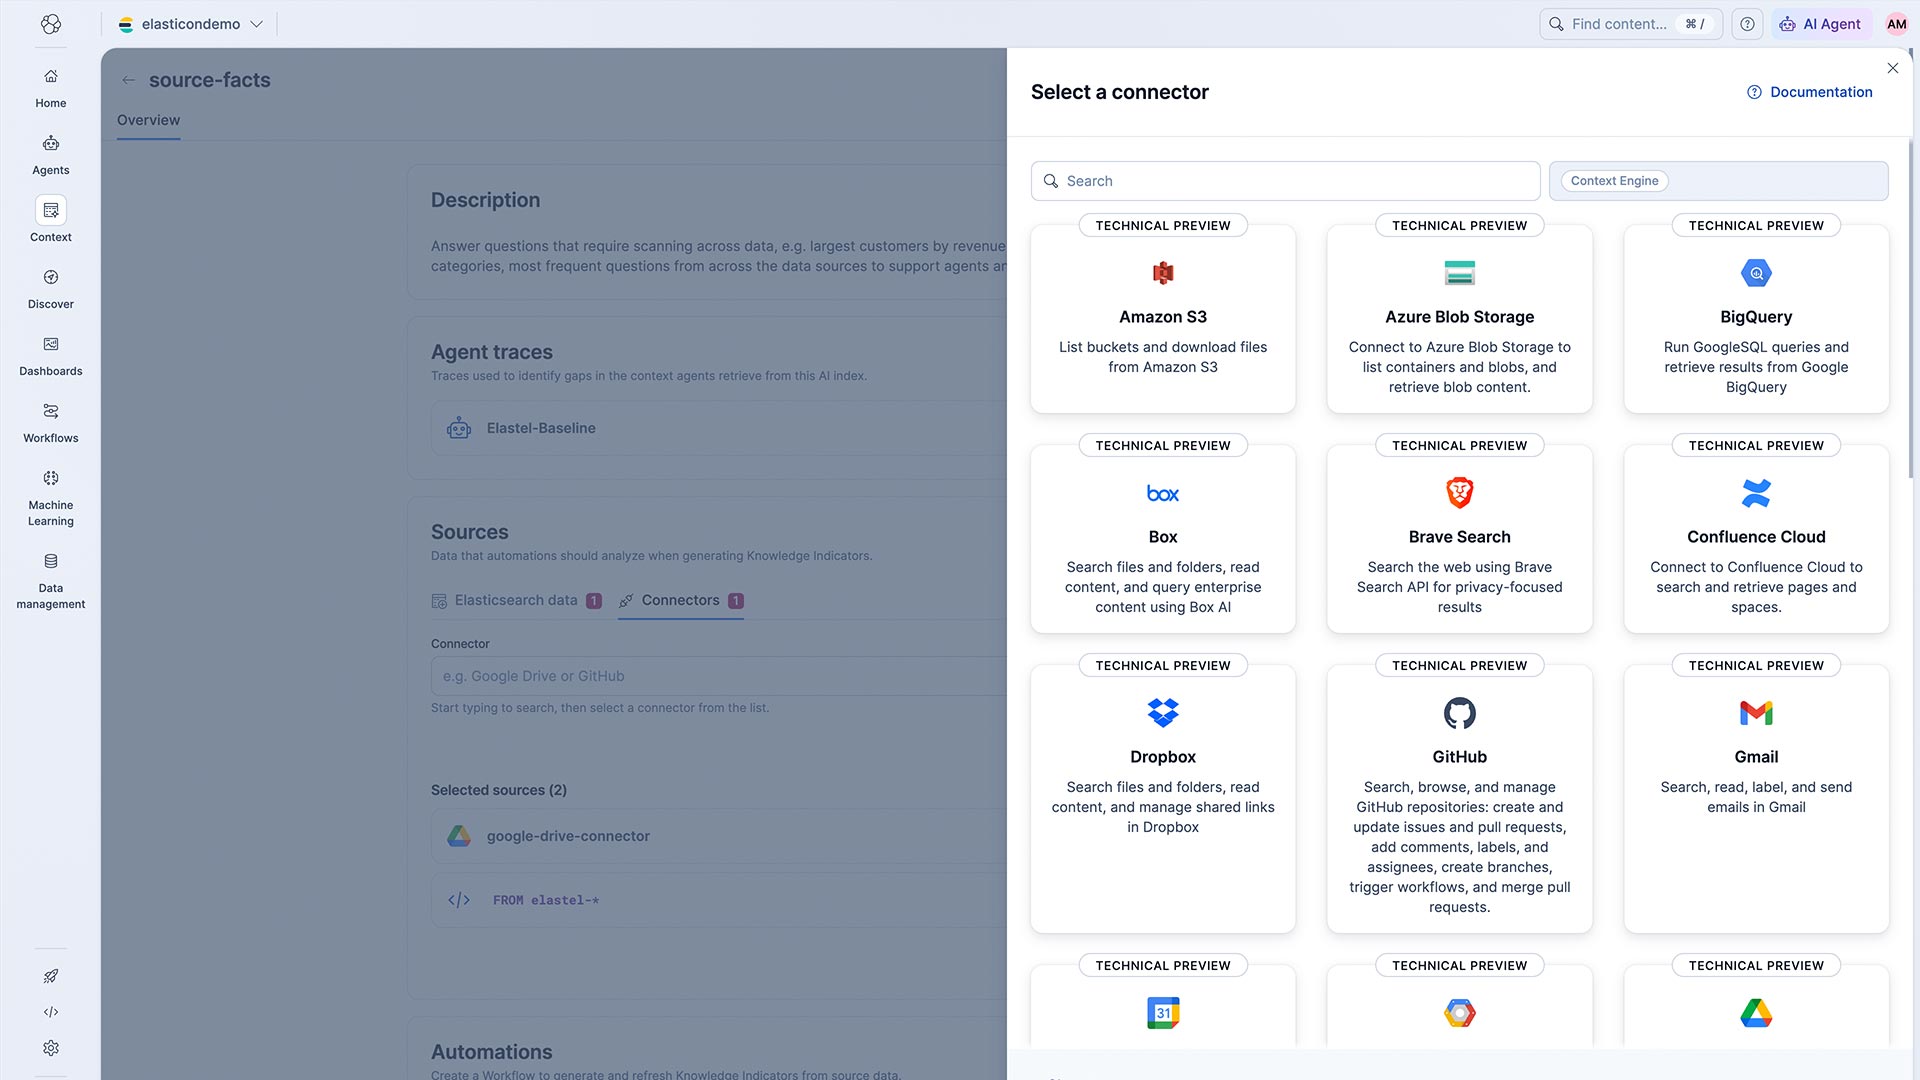
Verbinden
Verbinden Sie Ihre Agenten mit Kontext aus Elasticsearch-Indizes, externen Datenquellen über Kibana-Connectors oder ES|QL-Abfragen.
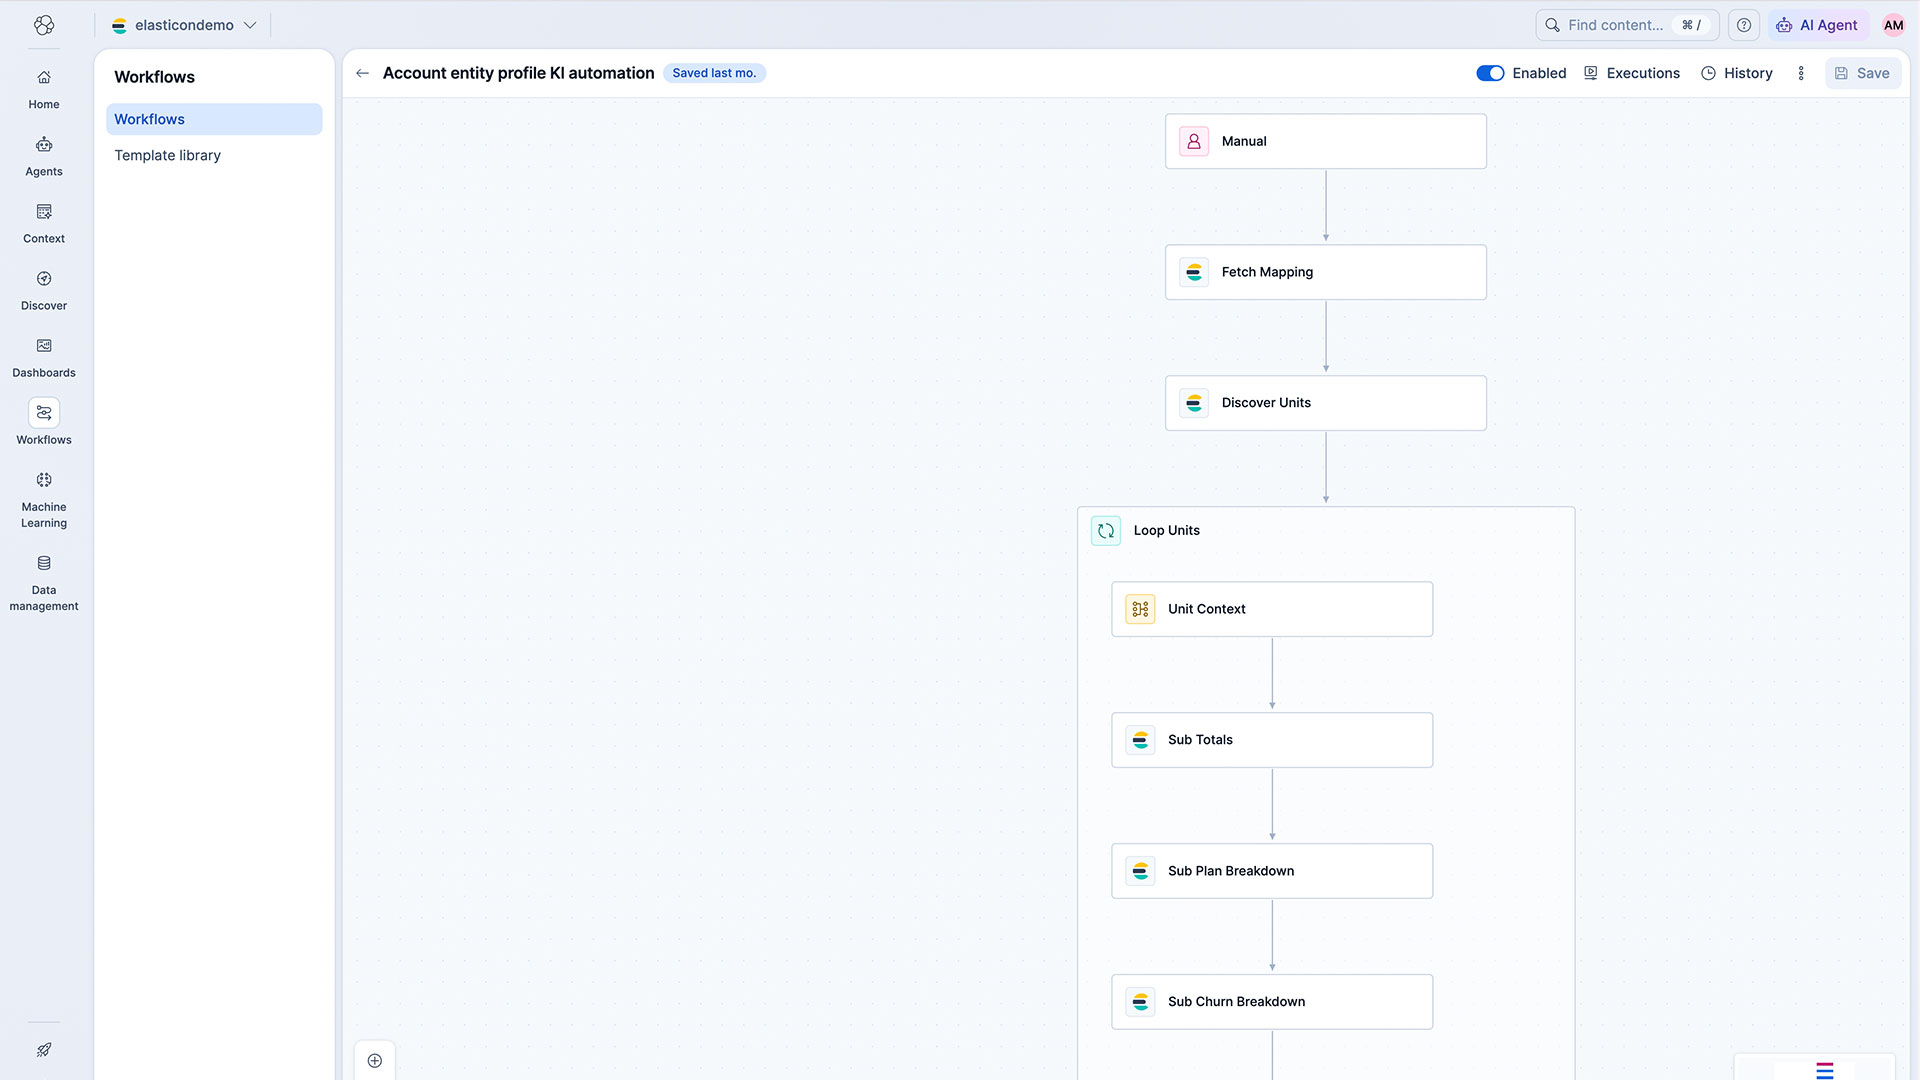
Zusammensetzen
Erstellen Sie Automatisierungen, um Knowledge Indicators zu erstellen, die Datensemantik, Beschreibungen, Beziehungen und Fakten in einen KI-Index extrahieren.
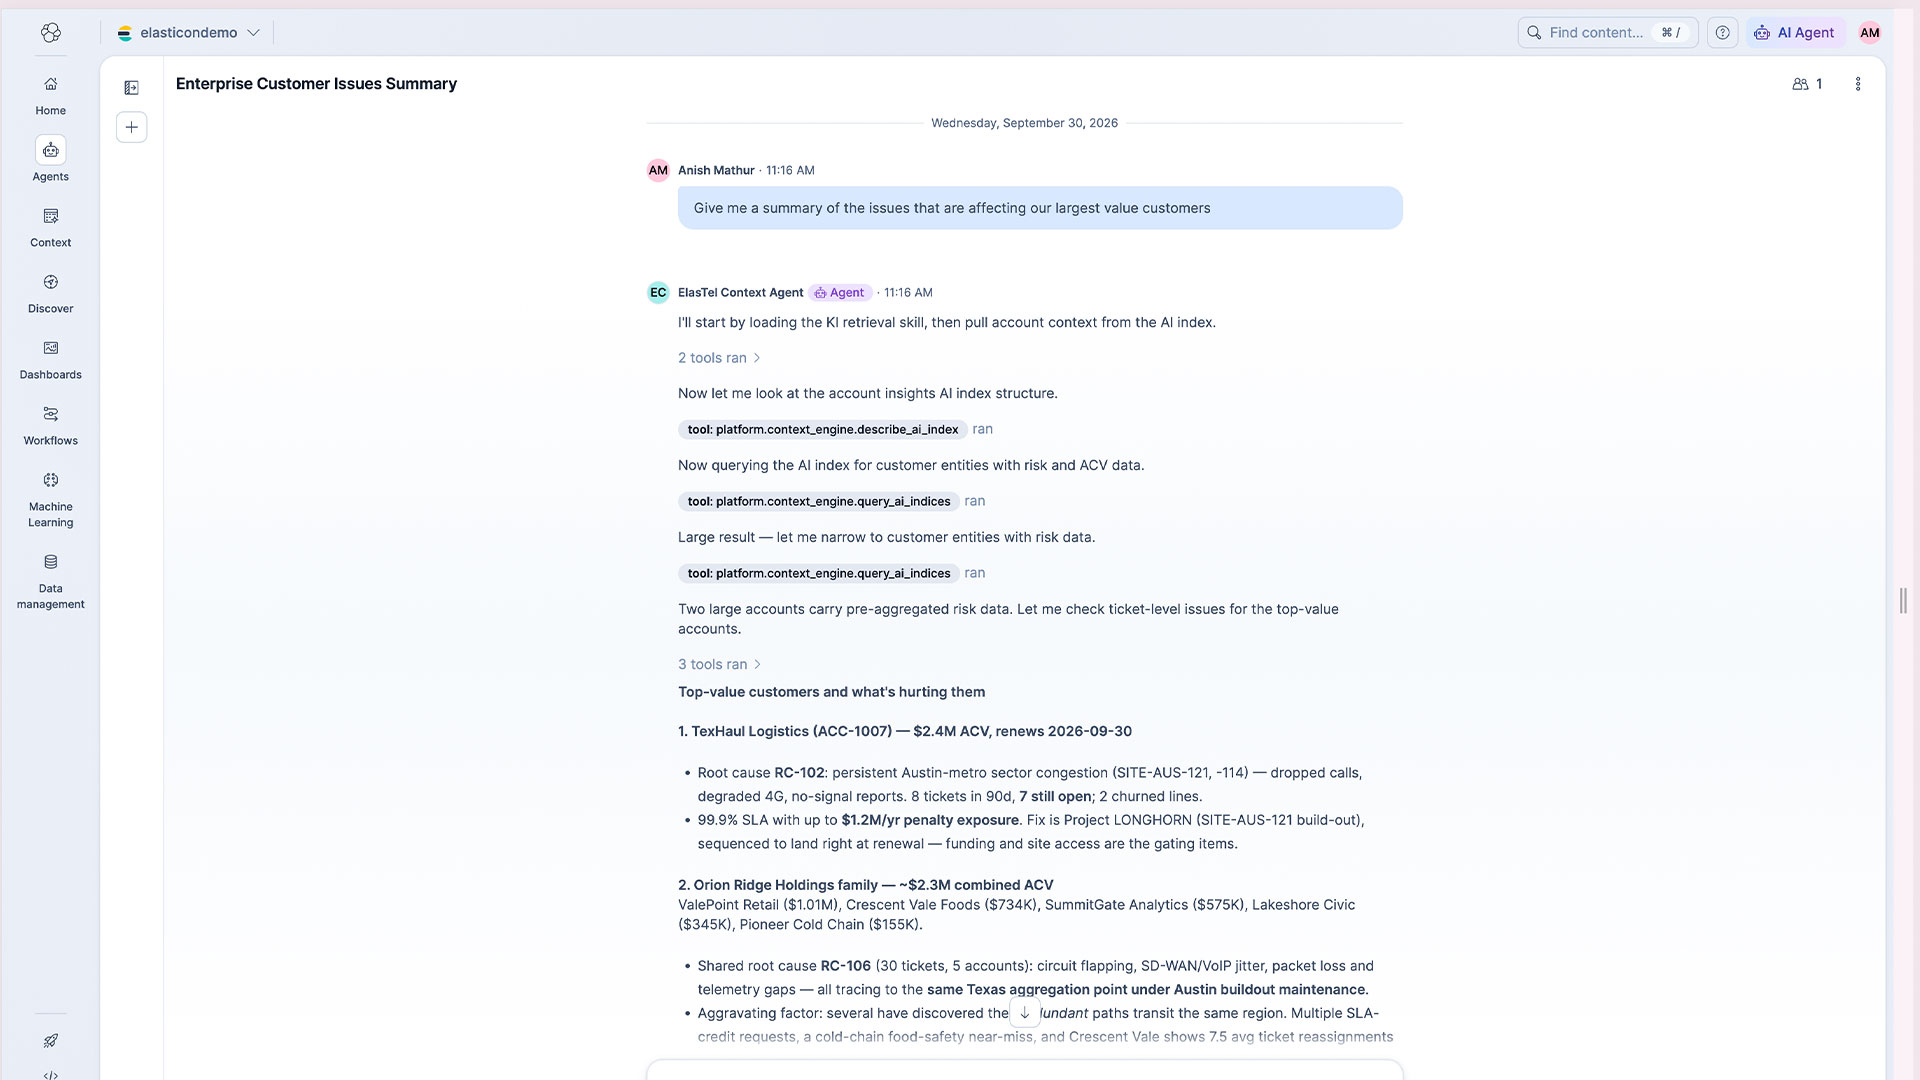
Abrufen
Nutzen Sie das zusammensetzbare ES|QL, um zum Inferenzzeitpunkt den relevantesten Kontext abzurufen.
Observe und verbessern
Nutzen Sie Bewertungen und Traces, um Agentenreaktionen nachzuverfolgen und den Kontext zu verbessern.
Integrieren
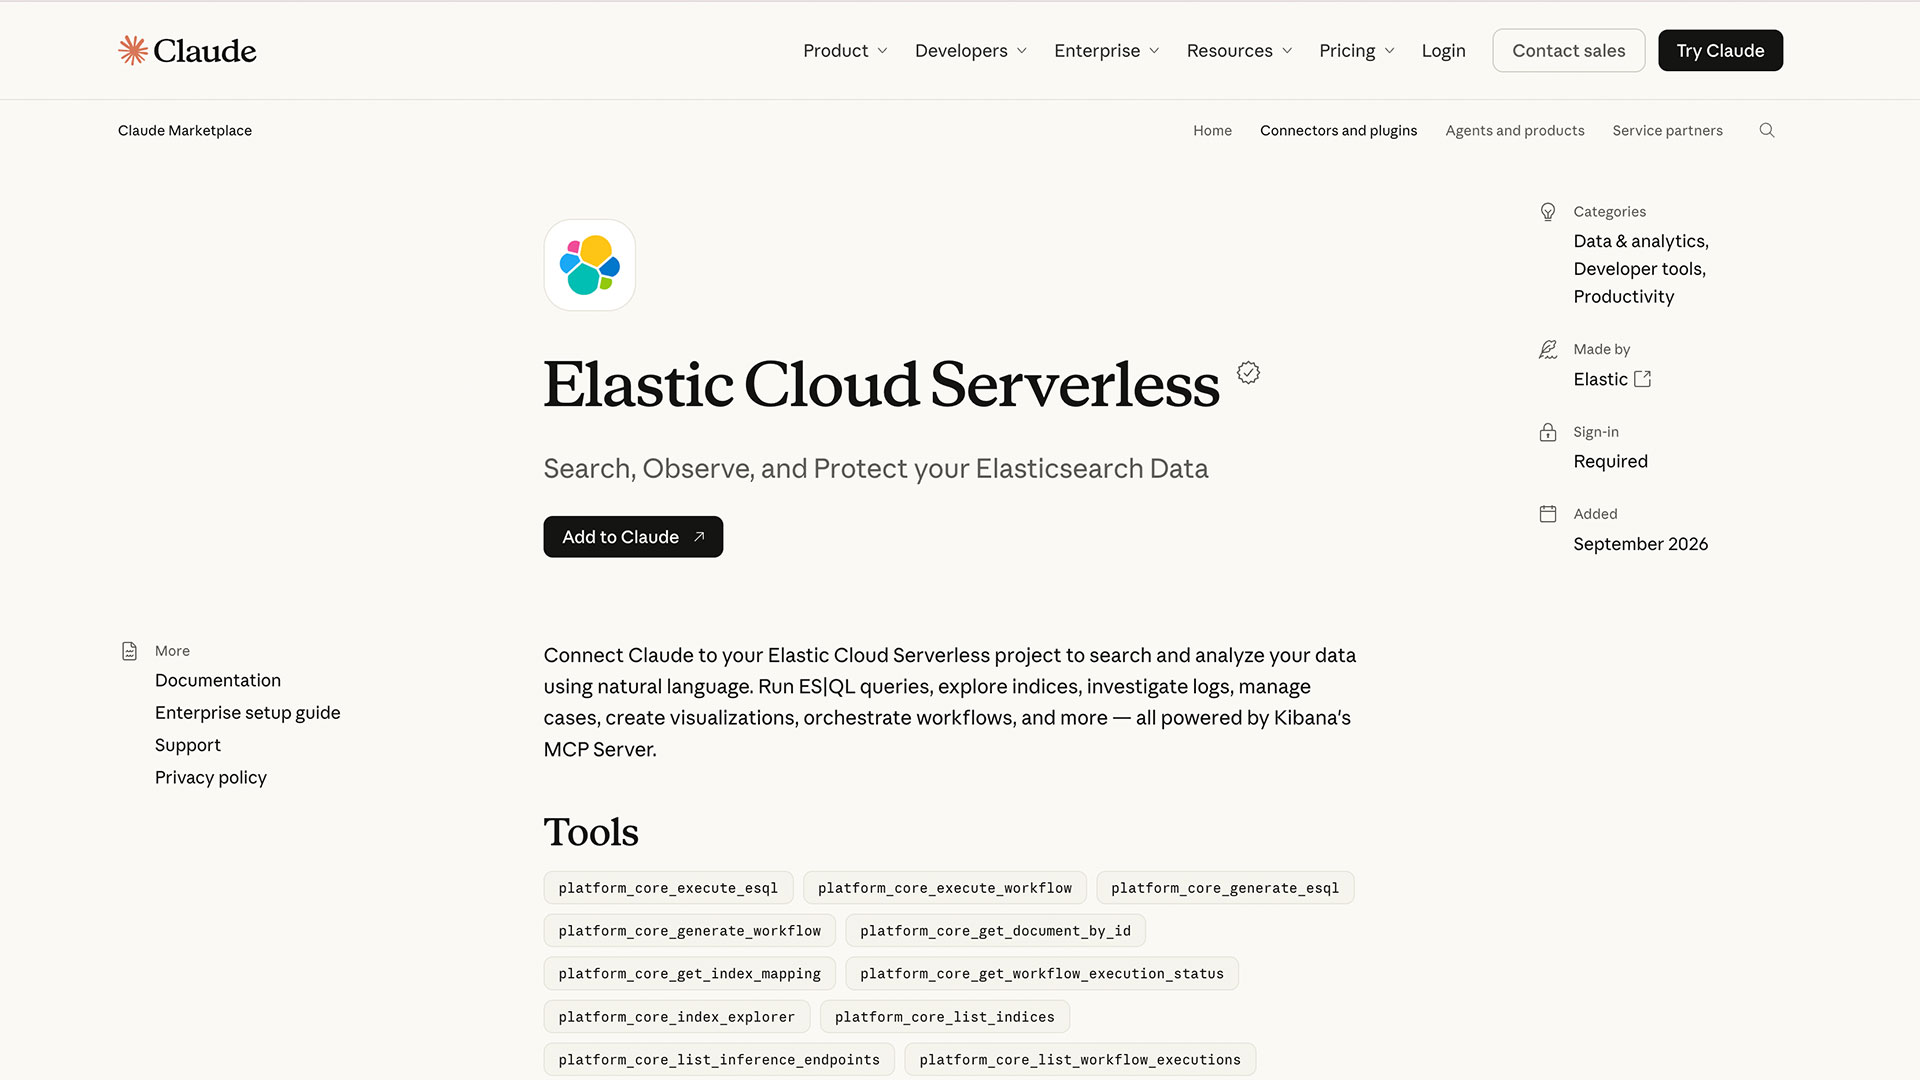
Stellen Sie über Plugins Kontext für Erstanbieter- und Drittanbieter-Agenten bereit, um verschiedene Harnesses von Claude Code, Codex, LangChain Deep Agents, von Claude verwalteten Agenten, AWS AgentCore, Gemini Agent Platform und anderen zu integrieren.
Architektur
Automatisierungen extrahieren Wissensindikatoren vorab in einen KI-Index, sodass jeder Agent den relevanten Kontext mit einer einfachen ES|QL-Abfrage abrufen kann.
Kontexttypen
Erstellen Sie mehrere Arten von Wissensindikatoren aus Rohdaten.
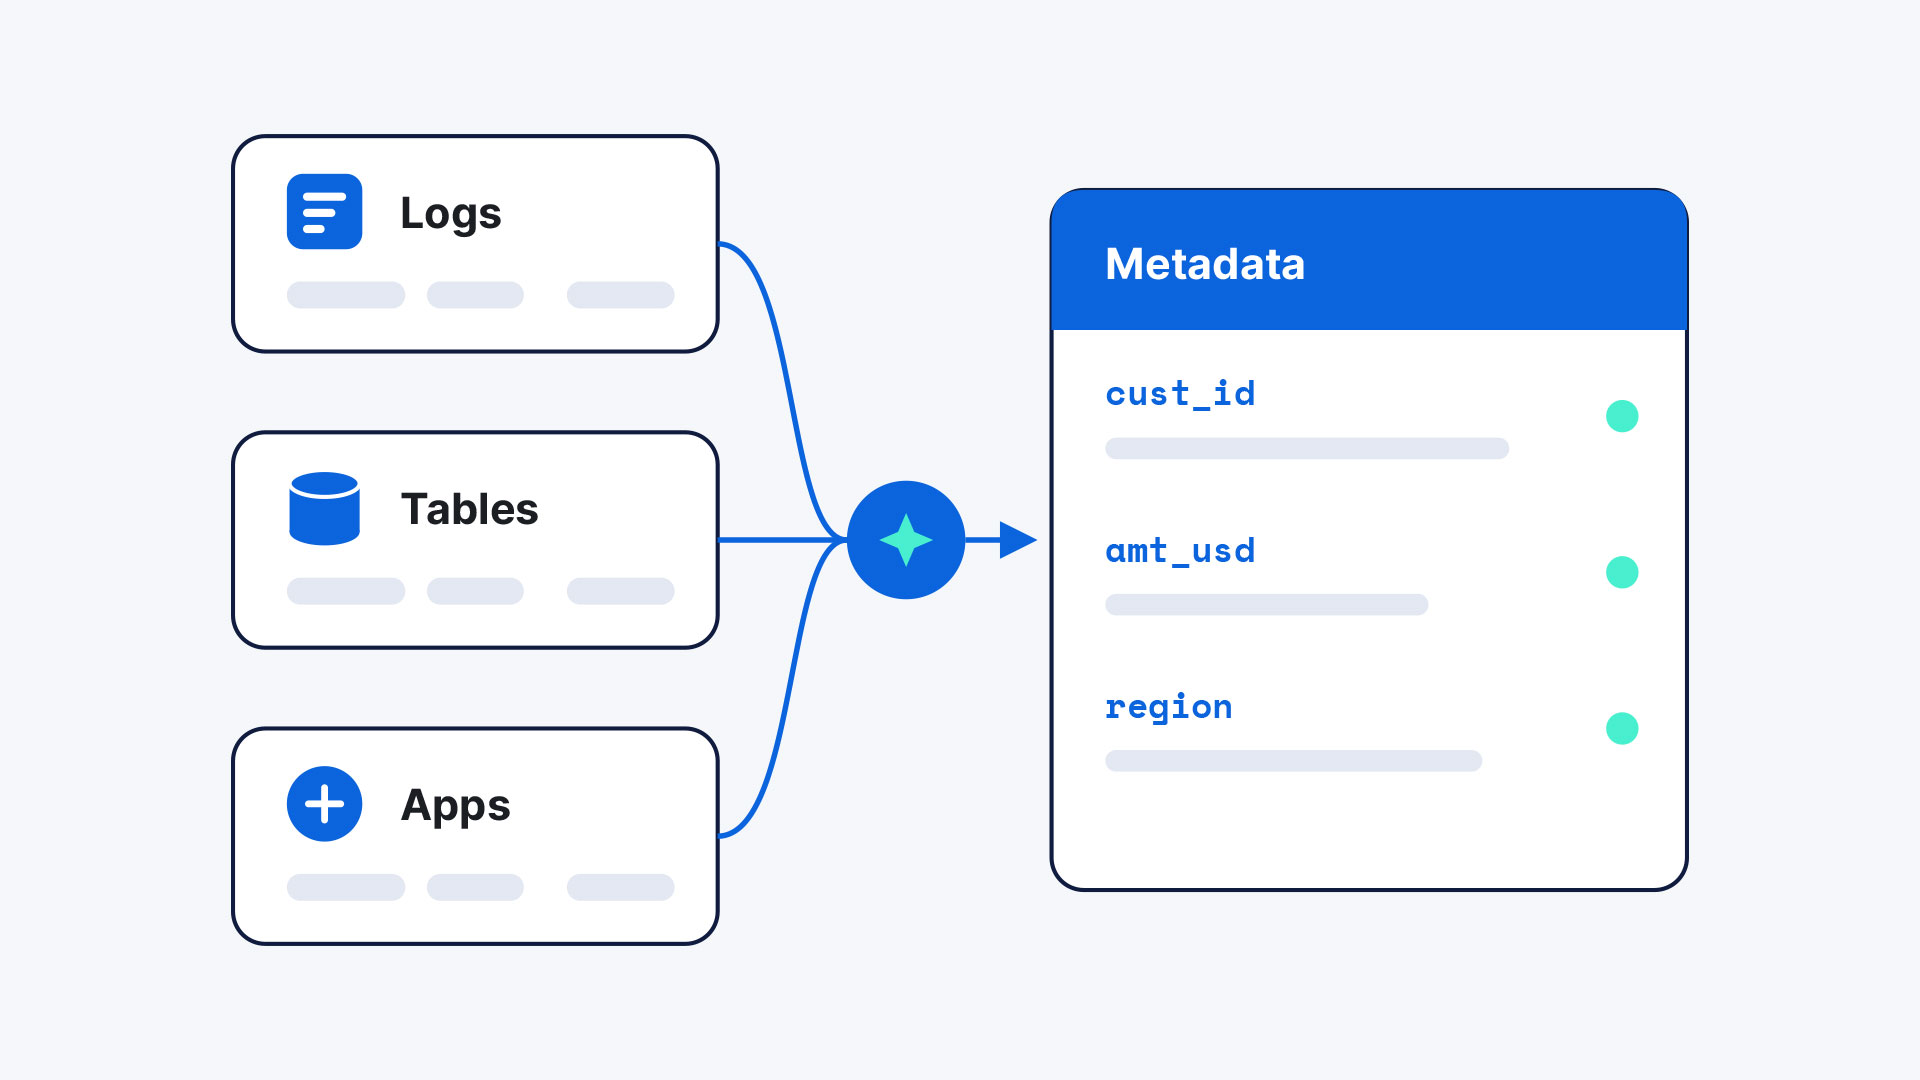
Semantische Metadaten aus Quellen
Leiten Sie Profile von Datenquellen ab, die ihren Zweck, ihre Felder, ihre Datenverteilung und ihre Merkmale beschreiben, um vorzugeben, wie Datenquellen abgefragt und wann sie verwendet werden.
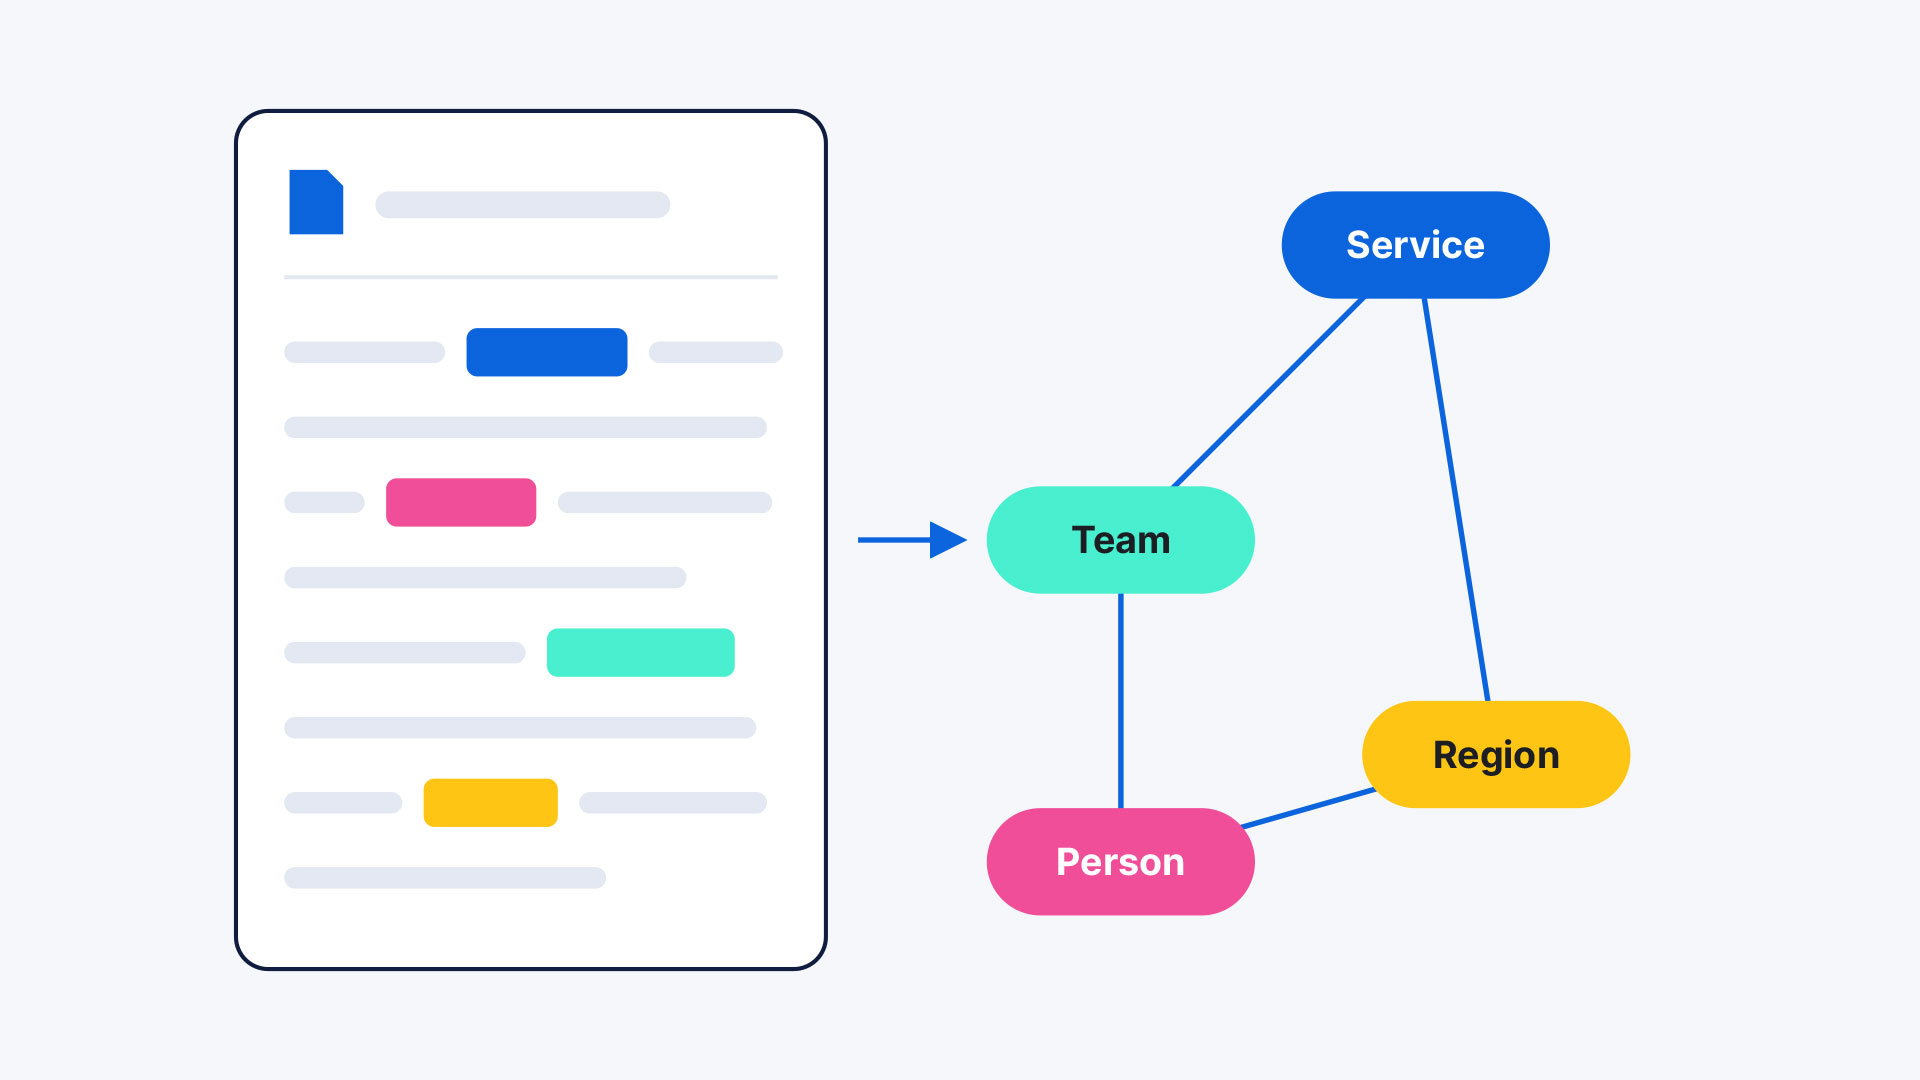
Entitäten und Beziehungen aus Dokumenten
Extrahieren Sie Entitäten wie Konten, Kontakte, Projekte, Geschäftsziele, Systeme und Dienste, und speichern Sie diese zusammen mit semantischen Zusammenhängen, um die Schlussfolgerungen der Agenten zu lenken.
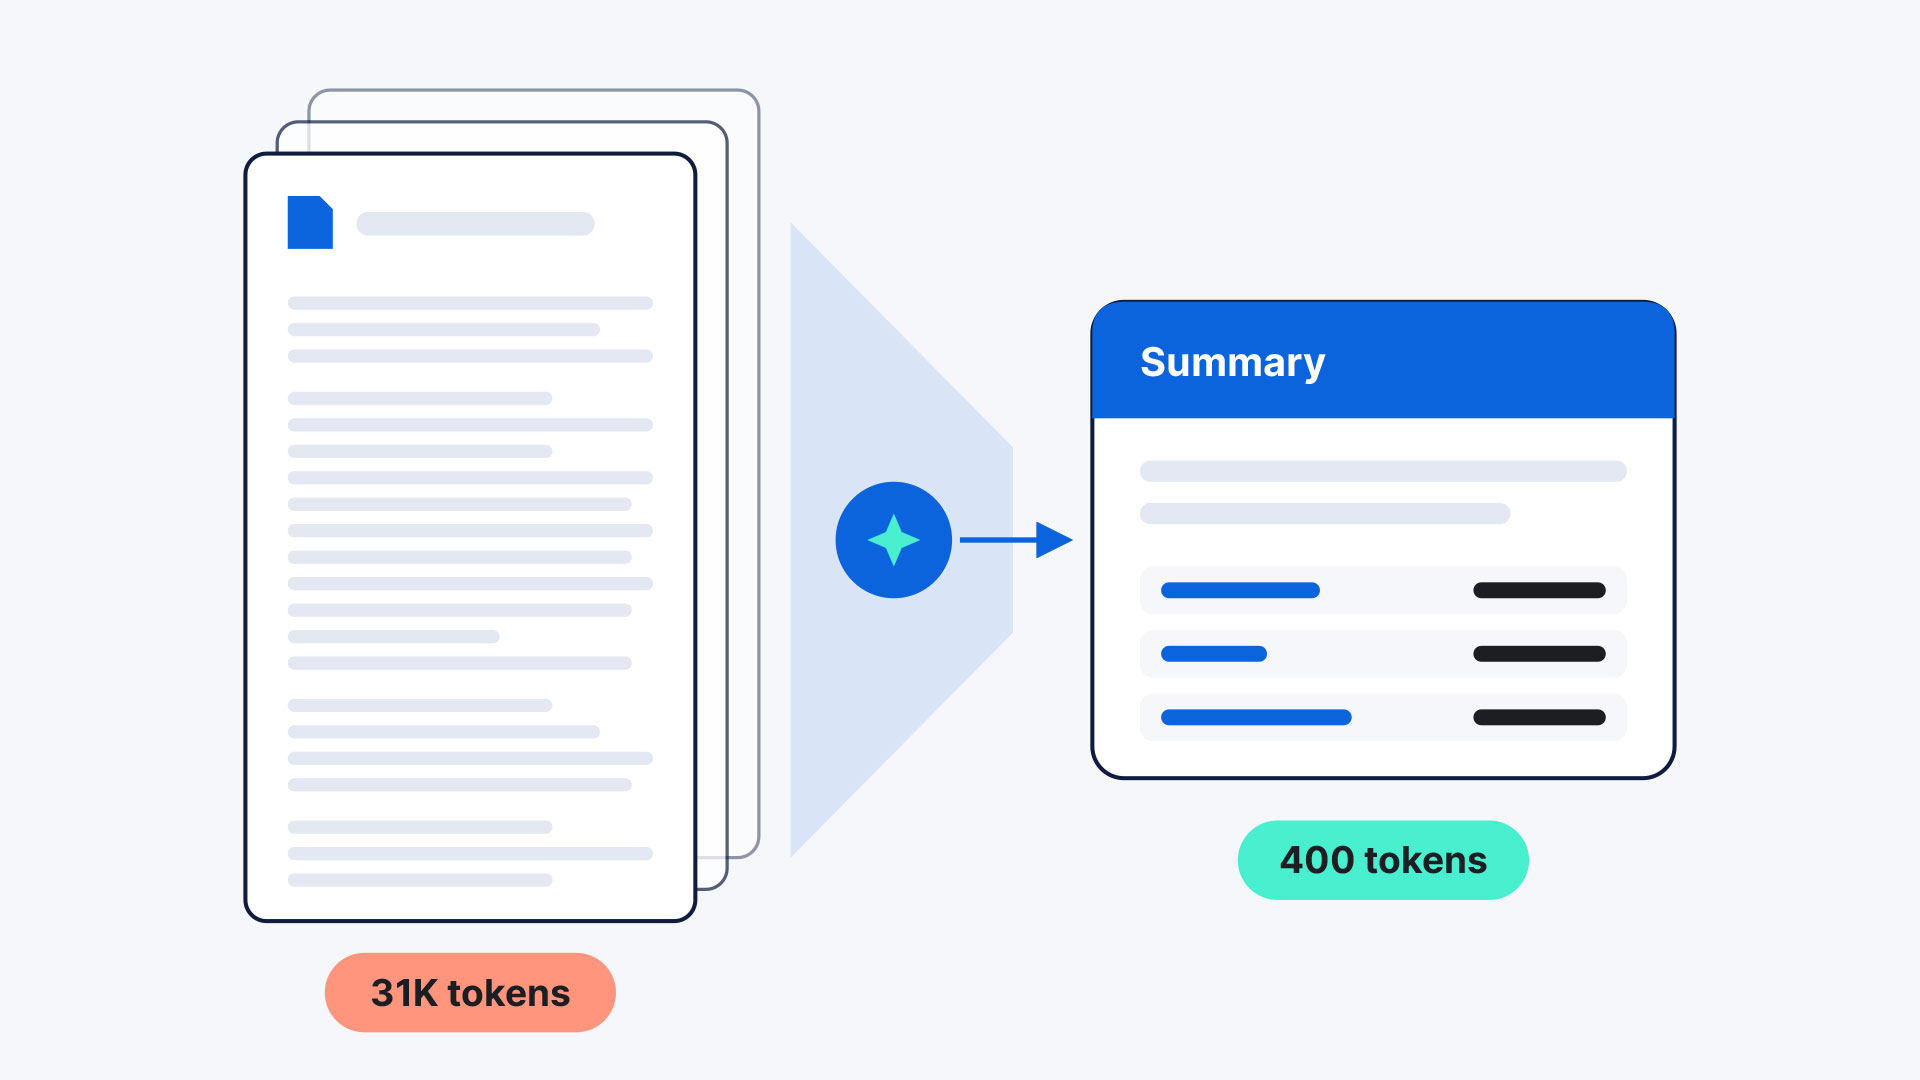
Dokumentfakten und Zusammenfassungen
Fassen Sie große, komplexe Dokumente zusammen und extrahieren Sie wichtige Fakten, um teure Lesezugriffe auf Dokumente zu reduzieren.
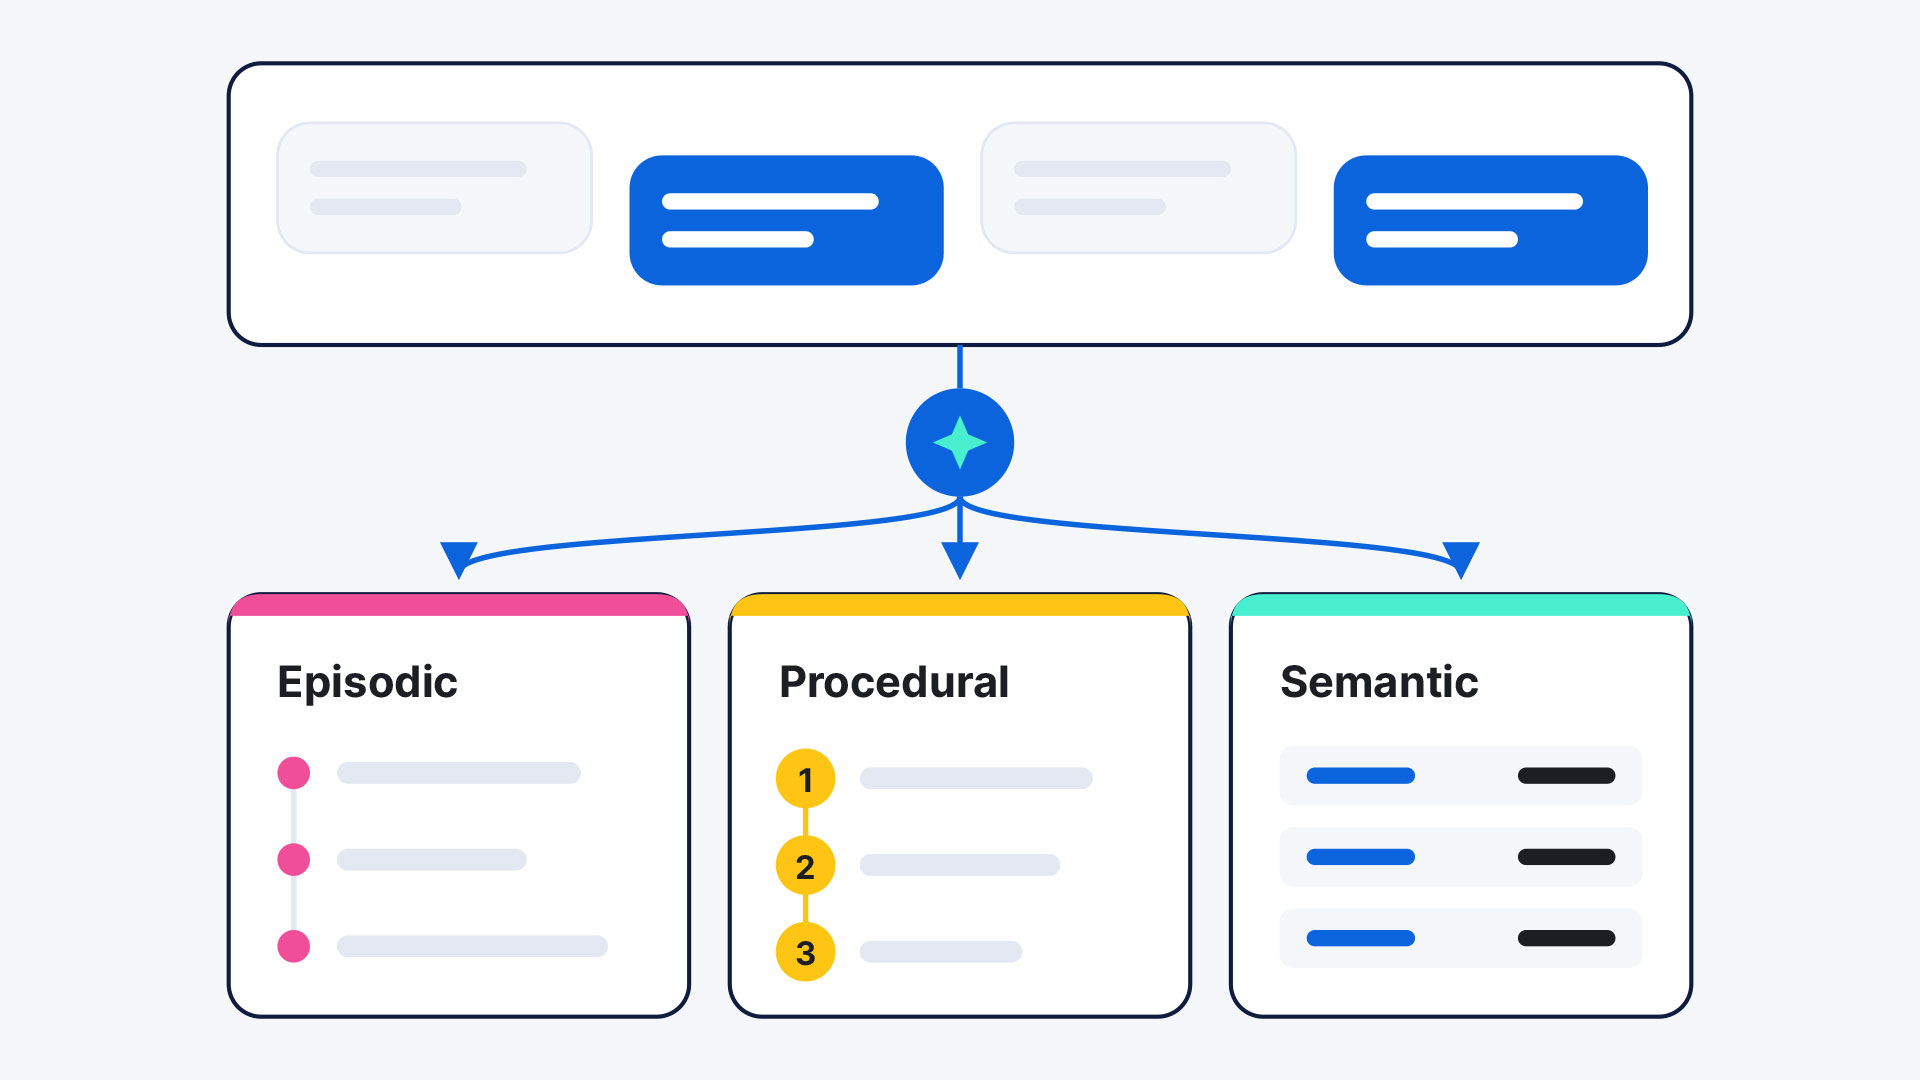
Agentengedächtnis aus Interaktionen
Erfassen Sie Erinnerungen, um Reaktionen zu beschleunigen und das Wissen jedes Agenten stetig zu erweitern.
ANWENDUNGSFÄLLE
Anwendungsfälle für Agenten
Zuordnen, vorab berechnen und Zusammenhänge identifizieren.


INTEGRATIONEN
Branchenführend? Direkt eingebaut
Integrieren Sie in die beliebtesten Agent-Frameworks und -Anwendungen.
RESSOURCEN FÜR DEN EINSTIEG
Die nächsten Schritte
Erfahren Sie mehr anhand von Anleitungen, Demos und Dokumentationen.
Folgen Sie einer Schritt-für-Schritt-Anleitung, um Kontext in einem KI-Index aufzubauen und zu speichern und intelligentere Agenten mit weniger Token zu unterstützen.
Entdecken Sie diese interaktive Demo, um zu sehen, wie einfach der Einstieg mit Context Engine ist.
Häufig gestellte Fragen
Was ist eine Context Engine?
Was ist eine Context Engine?
Eine Kontext-Engine ist ein Teil der Agentenarchitektur, der geschäftsspezifische Daten und Interaktionen sammelt und daraus Kontext aufbaut, damit ein Agent effizienter und effektiver arbeiten kann.
Was ist der Unterschied zwischen einer Context Engine und einer Vektordatenbank oder einem Memory Store?
Was ist der Unterschied zwischen einer Context Engine und einer Vektordatenbank oder einem Memory Store?
Eine Context Engine baut auf Vektordatenbanken und Memory Stores auf. Eine Vektordatenbank fungiert als Speicher- und Abrufkomponente für Kontext, während ein Memory Store Kontext direkt aus Agenteninteraktionen erfasst. Eine Context Engine entscheidet, was in diesen Speichern abgelegt wird, wie es strukturiert, gewartet, verwaltet und geschützt wird, und welche Tools für den Abruf zur Verfügung stehen.
Ich habe bereits einen Datenkatalog. Warum benötige ich eine Kontext-Engine?
Ich habe bereits einen Datenkatalog. Warum benötige ich eine Kontext-Engine?
Datenkataloge beschreiben Daten, beruhen jedoch auf statischen Informationen und müssen manuell aktualisiert werden. Wenn sich Daten, Anwendungsfälle für Agenten, das Nutzerverhalten und die Prompts ändern, veralten Datenkataloge schnell. Außerdem fehlt ihnen in der Regel der Einblick in die Daten selbst. Sie können zwar die Datenform und das Schema beschreiben, nicht aber Entitäten, Anomalien oder Trends, für die Suche und Abruf erforderlich sind.
Was ist ein Wissensindikator?
Was ist ein Wissensindikator?
Ein Knowledge Indicator ist eine Kontexteinheit. Er kann jedes für Agenten nützliche Kontextfragment darstellen, darunter Beschreibungen von Indizes und Datenquellen, extrahierte Entitäten, dokumentbasierte Fakten und mehr.
Was wird in einem KI-Index gespeichert?
Was wird in einem KI-Index gespeichert?
Ein KI-Index speichert Wissensindikatoren, die aus Datenquellen abgeleitet werden, sowie Erinnerungen, die aus Agenteninteraktionen und Traces abgeleitet werden.
Wie werden Sicherheit und Berechtigungen durchgesetzt?
Wie werden Sicherheit und Berechtigungen durchgesetzt?
KI-Indizes können wie andere Elasticsearch-Indizes mit vollständiger rollenbasierter Zugriffskontrolle verwaltet und mit Berechtigungen versehen werden. Workflows und Agenten können als Nutzer ausgeführt werden, um den Zugriff zu beschränken und zu auditieren. Die Context Engine erfasst außerdem die Herkunft jedes generierten Knowledge Indicators, sodass der Zugriff verwaltet werden kann.
Wie wird die Context Engine bepreist?
Wie wird die Context Engine bepreist?
Die Context Engine wird während der Private Preview derzeit nicht separat bepreist. Die Preise werden zu einem späteren Zeitpunkt bekannt gegeben.