Observabilidad de señal completa a la mitad del costo
Elastic Observability puede manejar datos a escala de petabytes a la mitad del costo de Datadog, por lo que la AI agéntica obtiene una visión completa de los logs, las métricas y las trazas para detectar y resolver problemas rápidamente.
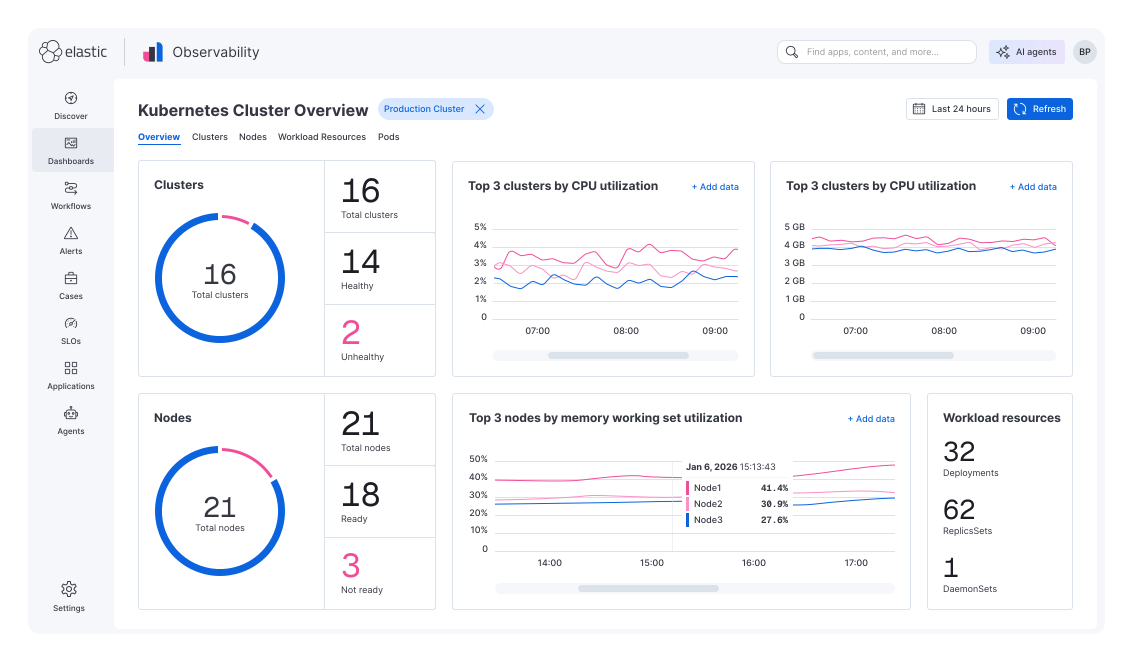
Observability a escala de AI
La AI y las cargas de trabajo nativas del cloud generan más telemetría de la que los equipos pueden permitirse conservar. El resultado: puntos ciegos que dificultan la gestión de incidentes y el análisis de la causa raíz.
Eficiencia líder en su clase para logs, métricas y trazas
Consérvalo todo. Elasticsearch concentra más telemetría en menos almacenamiento, lo que mantiene los costos bajos y el rendimiento alto, incluso para datos de alta cardinalidad.
Tus logs tienen la respuesta. Elastic la encuentra.
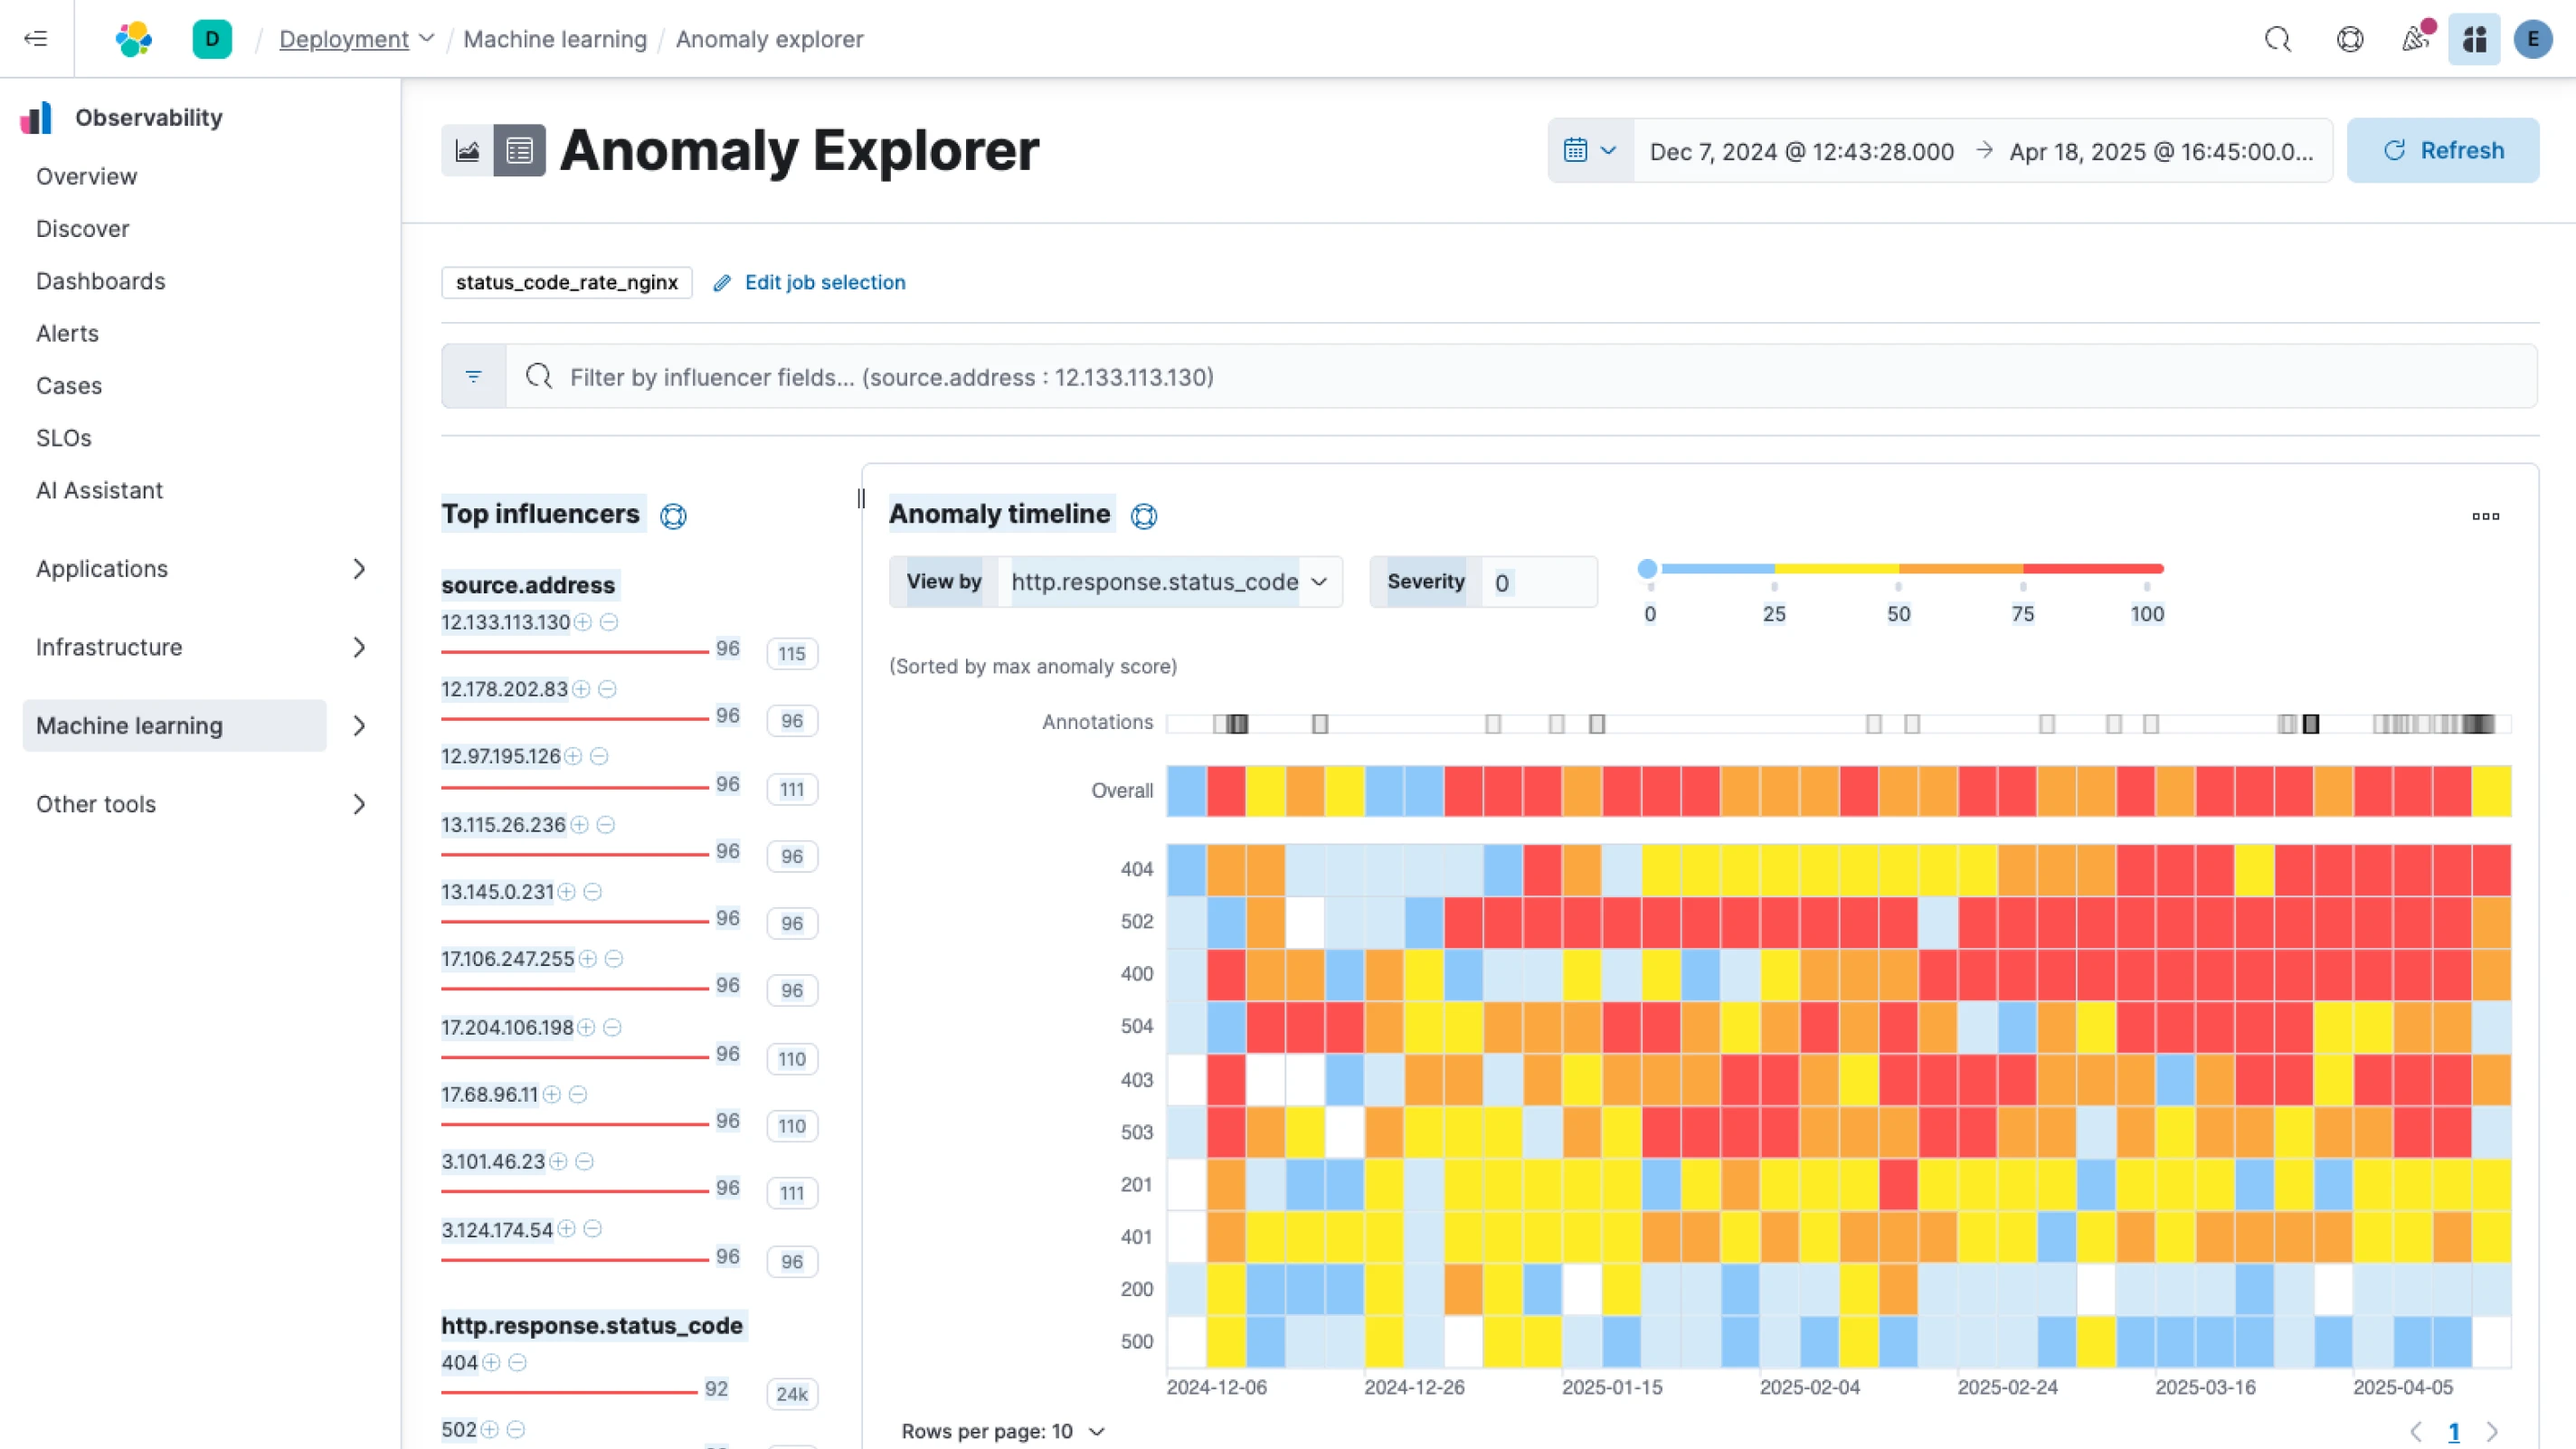
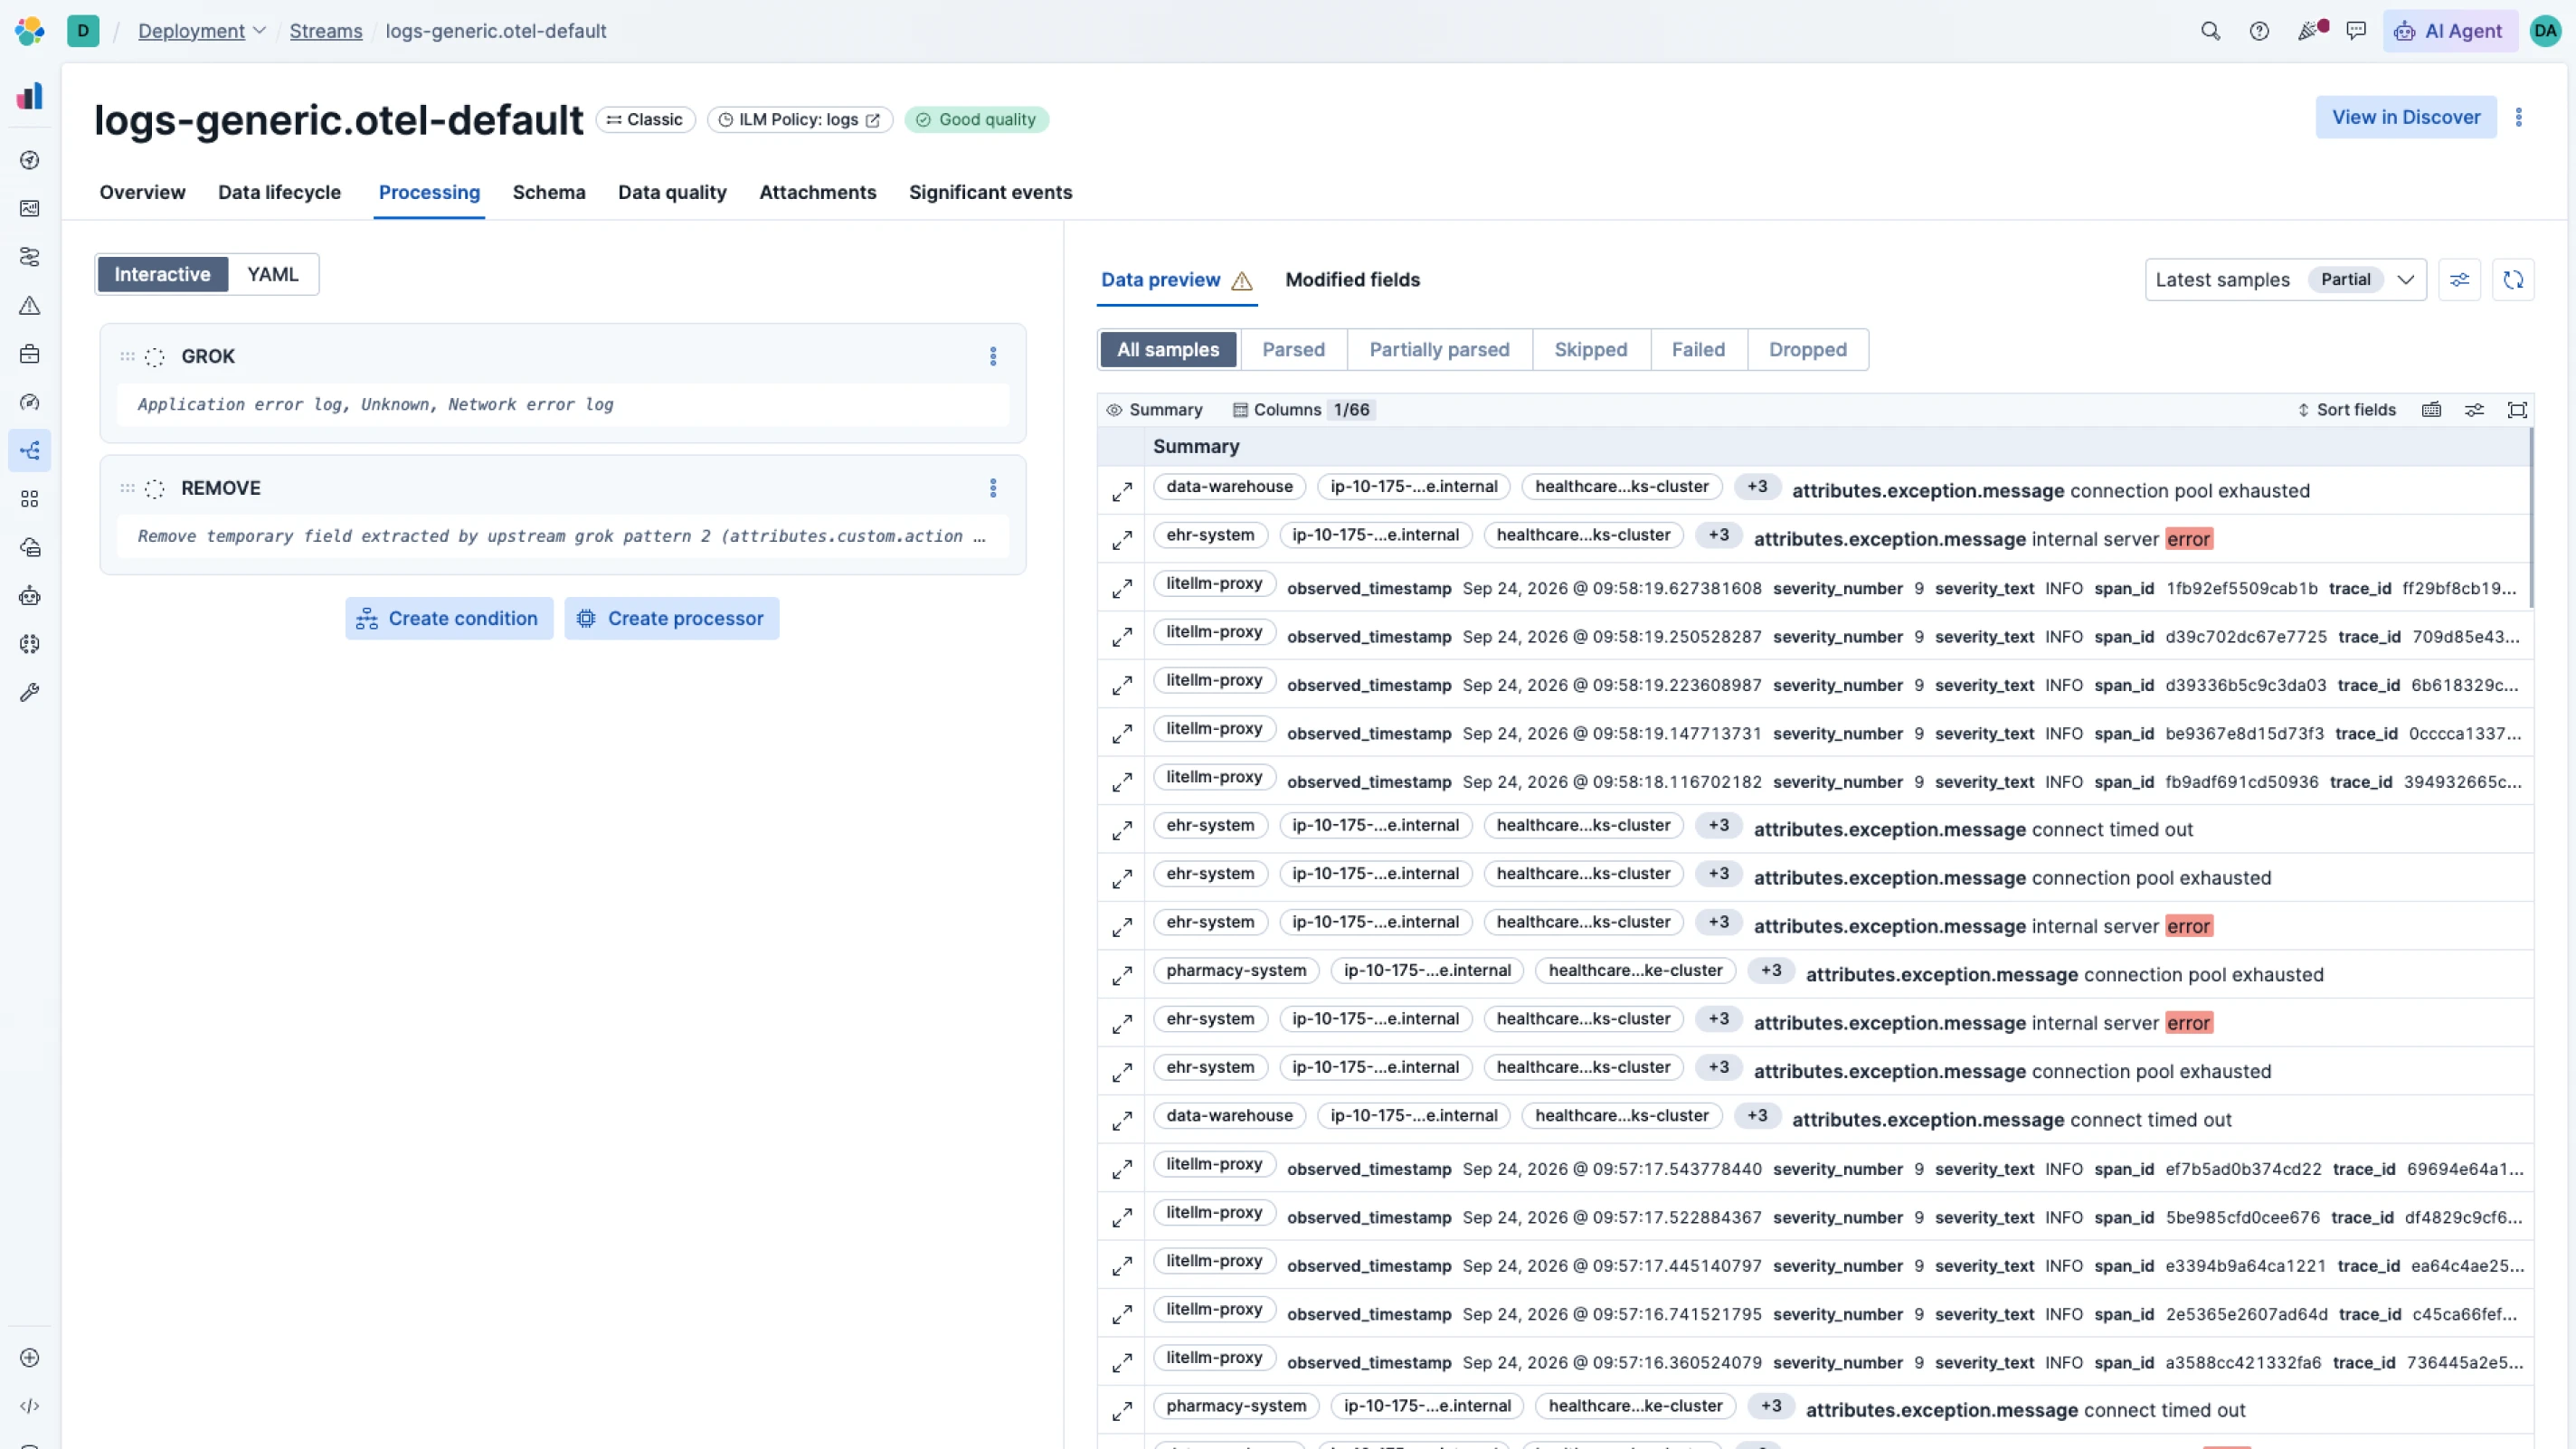
Elastic extrae estructura, significado y contexto operativo de la telemetría sin procesar, convirtiendo una señal reactiva y exclusiva para expertos en una proactiva.
Investigaciones impulsadas por IA con contexto completo
Elastic brinda a los agentes de SRE con AI y al ML el contexto más completo posible para investigar, identificar la causa raíz y automatizar la remediación con una transparencia que permite a los equipos mantener el control.
Basado en OpenTelemetry y nativo de Prometheus
Ingesta cualquier tipo de datos de cualquier fuente. Elastic es abierto por diseño, independiente del esquema, compatible de forma nativa con Prometheus y desarrollado desde cero sobre OpenTelemetry (OTel).
Una plataforma para todo
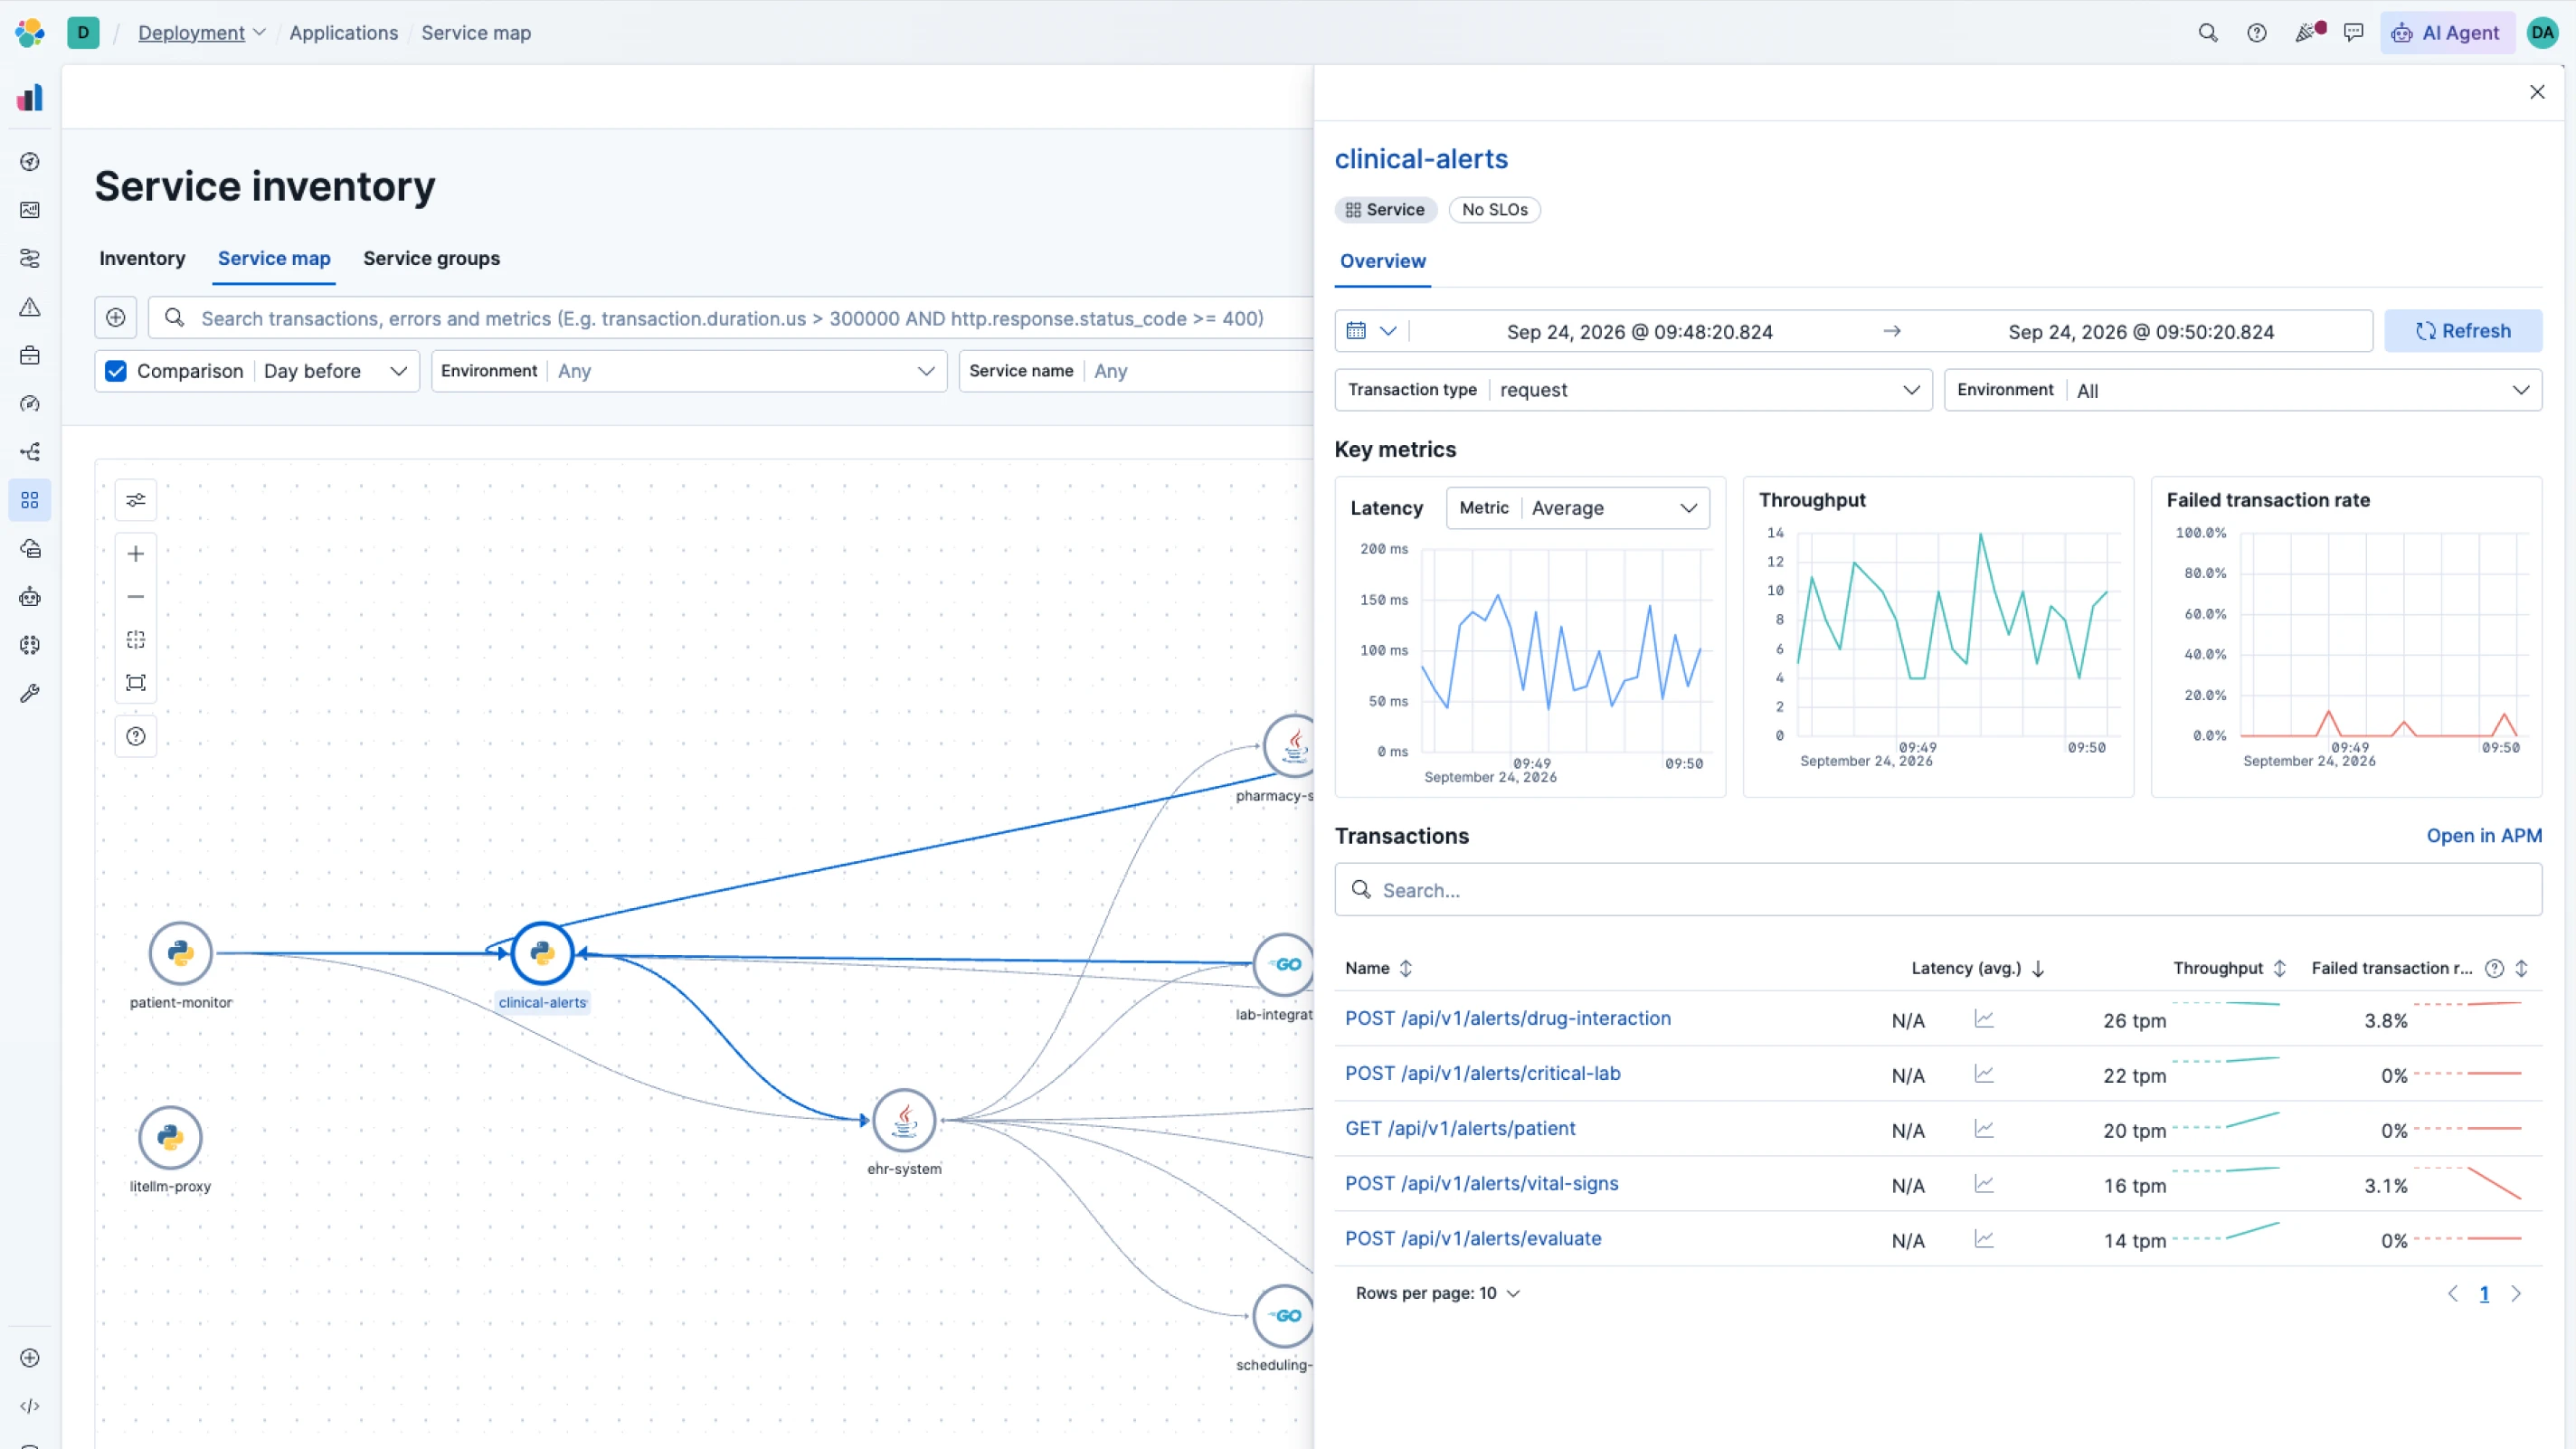
Todas las señales, una misma fuente de verdad. Conecta tus datos con más de 550 integraciones con un solo clic en clouds, CI/CD, bases de datos y más.
La mejor eficiencia en su clase
La AI es tan buena como la plataforma de datos que la potencia. Cada elemento de Elasticsearch se ha diseñado con un fin concreto: desde la arquitectura de almacenamiento hasta el rendimiento de las búsquedas.
Descubre cómo rediseñamos Elasticsearch para convertirlo en uno de los principales almacenes de datos de métricas con almacenamiento en columnas.
Modo de índice LogsDB
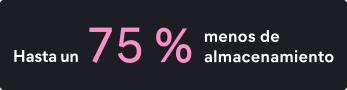
Un modo de índice especialmente diseñado para datos de logs y trazas. La ordenación inteligente por host.name y @timestamp mejora considerablemente la compresión. Synthetic _source reconstruye campos bajo demanda.
Rendimiento de las búsquedas de métricas
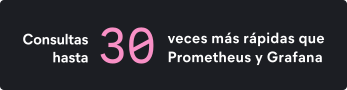
ES|QL ofrece respuestas en menos de un segundo en millones de métricas de series temporales, es decir, la velocidad que exigen las investigaciones de AI.
Eficiencia del almacenamiento de métricas
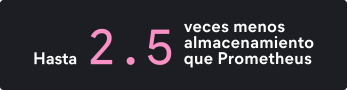
Almacena más datos para proporcionar un contexto más completo a la AI a un menor costo mediante doc value skippers, Synthetic ID y la reducción de seq_no, con una mejora de 6,6 veces respecto de hace un año.
Investiga como un SRE y te muestra cómo llegó ahí
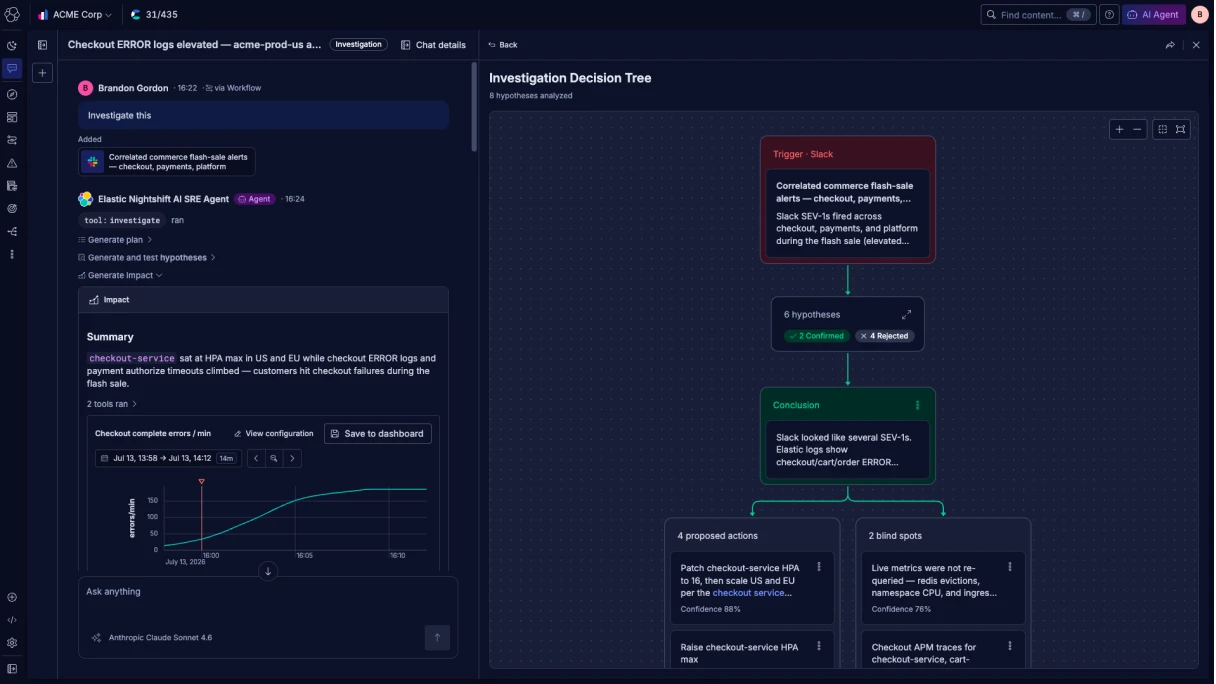
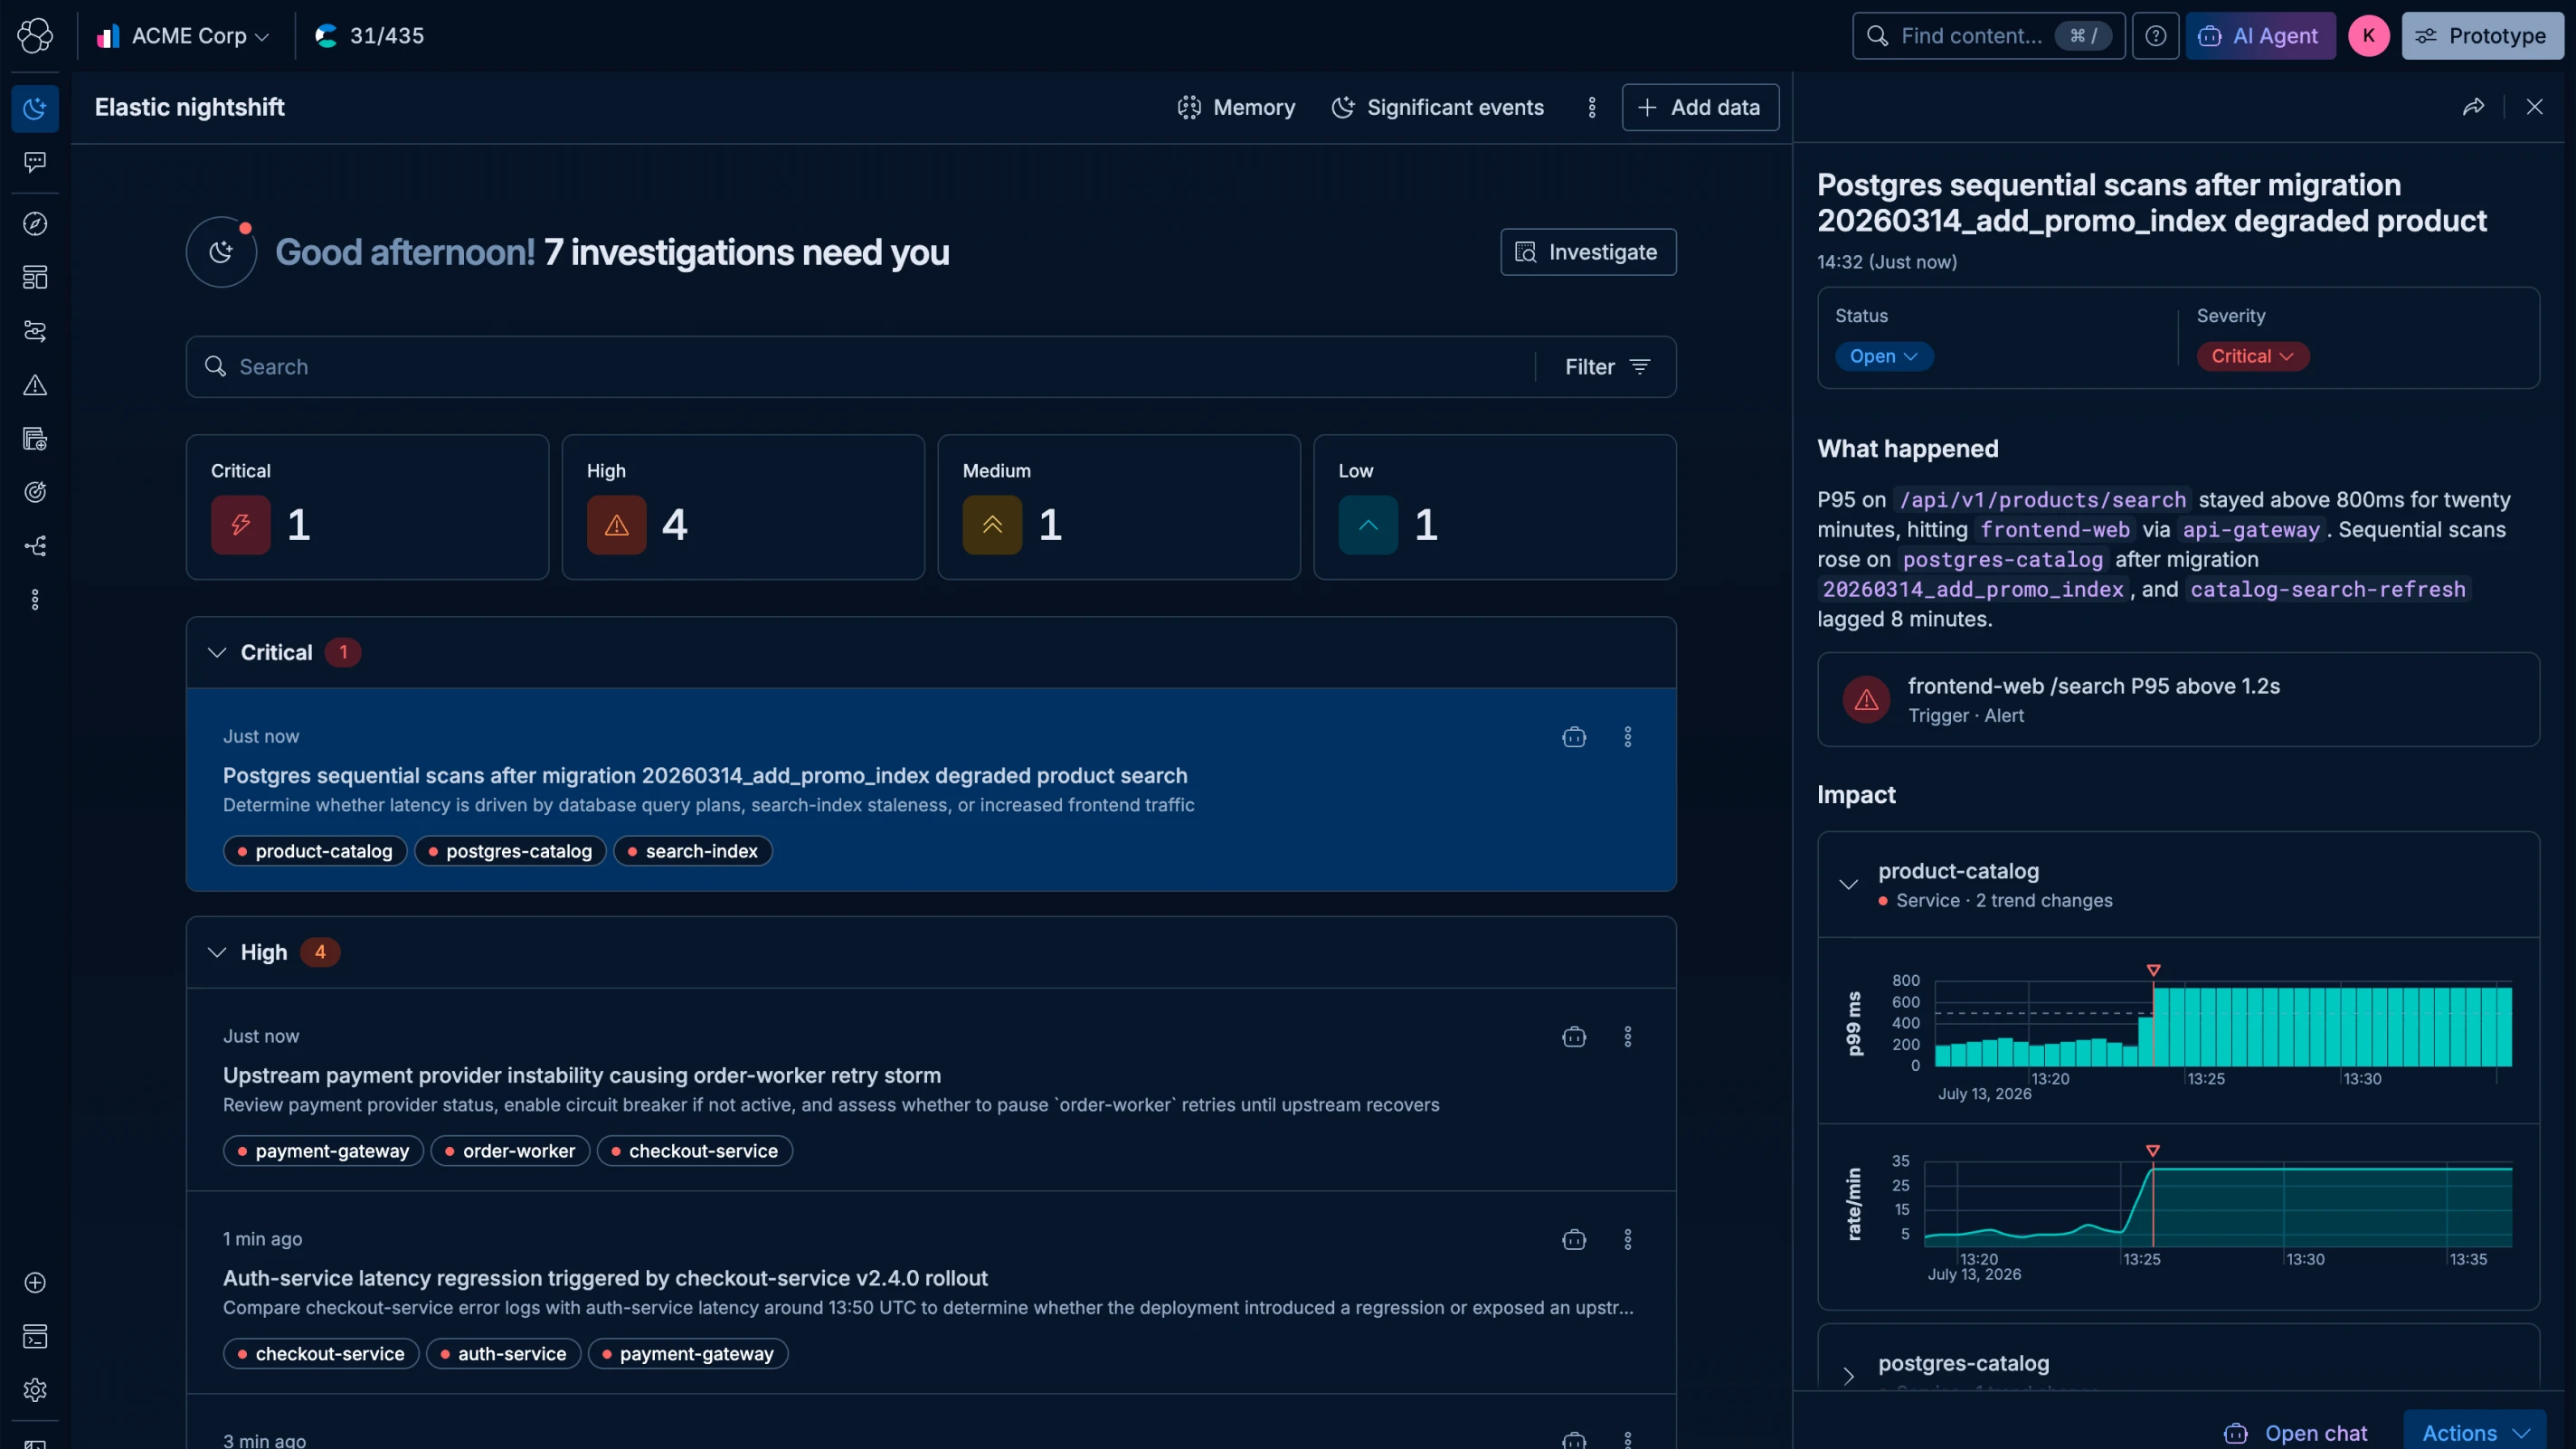
Elastic nightshift AI SRE aprende a investigar, no solo qué buscar. Al recorrer la cadena causal como lo haría un SRE, prueba múltiples hipótesis en paralelo y converge en la causa raíz con un razonamiento transparente.
Aprende con cada incidente
Razonamiento transparente y respaldado por evidencia
Remediación en la que puedes confiar
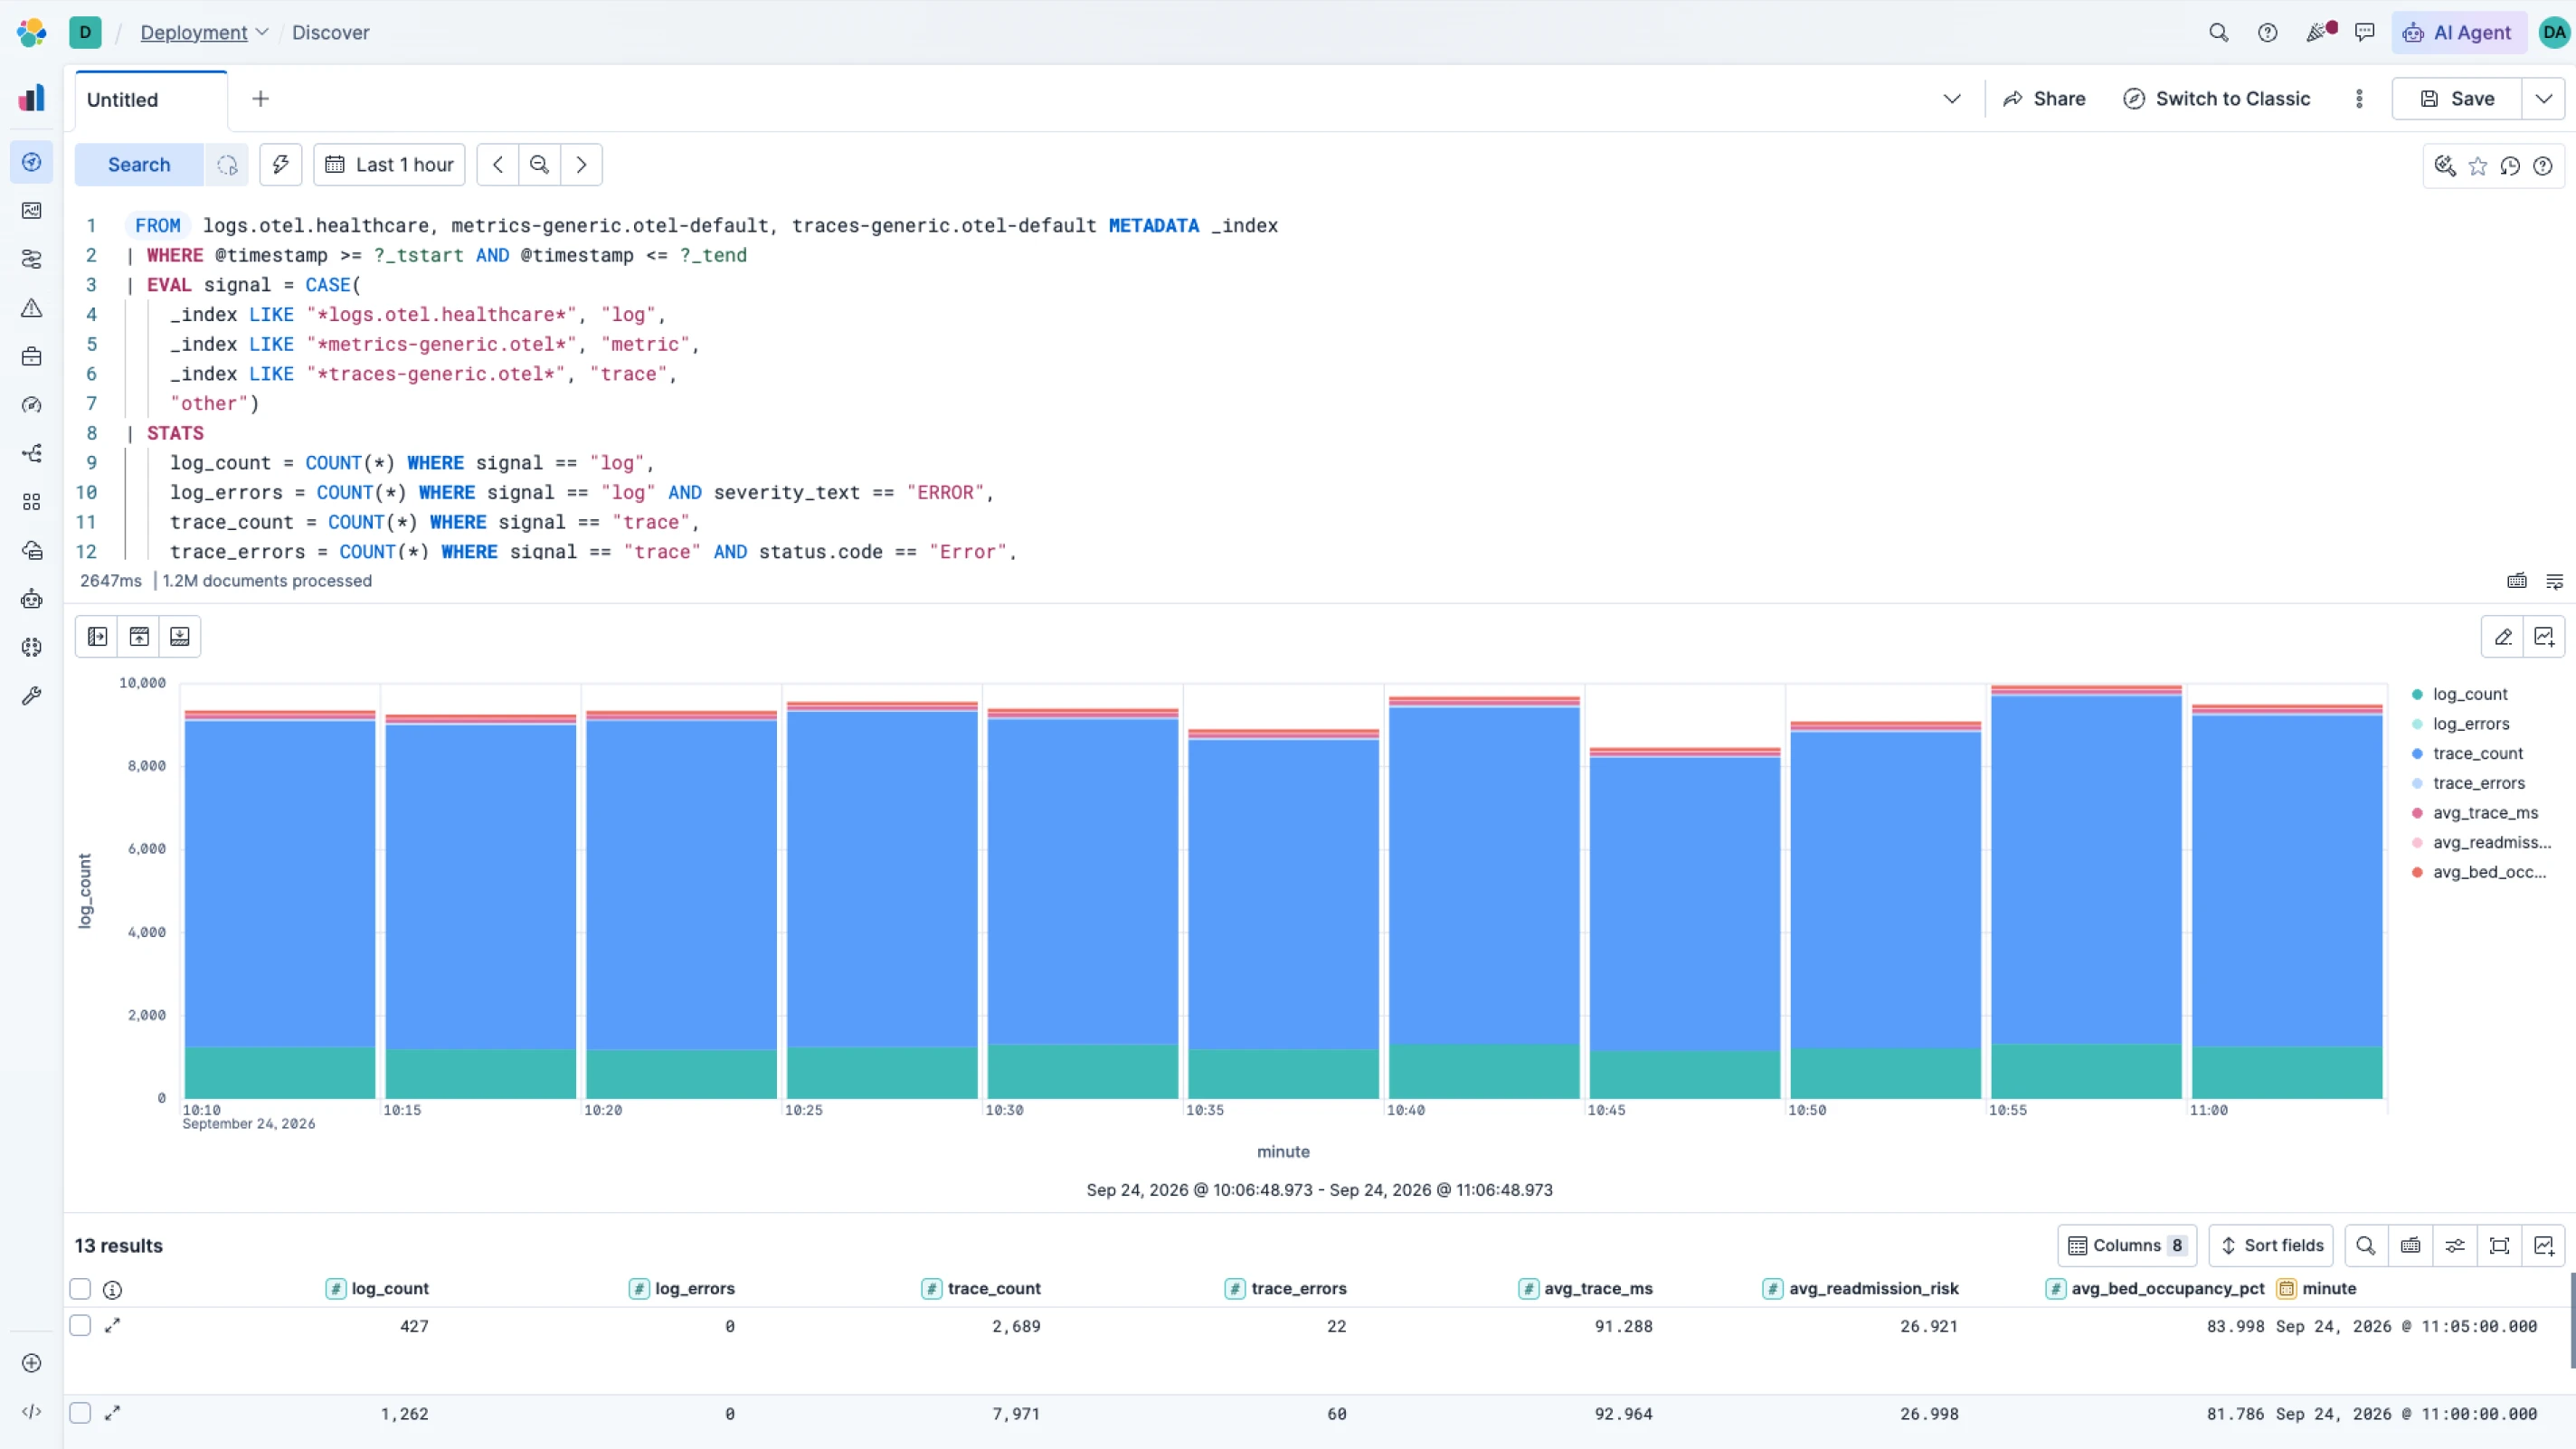
De los datos a las respuestas, sin esfuerzos de búsqueda
Desde la exploración de logs hasta las investigaciones agénticas, Elastic Observability está diseñado en función de cómo piensan y trabajan realmente los SRE de guardia.
El SRE de IA integrado de Elastic impulsa el análisis de causa raíz y la remediación. Interactúa directamente con tu telemetría mediante lenguaje natural y resuelve los problemas más rápido sin tener que cambiar de pestaña ni de contexto.
Lo que dicen los analistas sobre Elastic Observability
El 75 % de las empresas Fortune 100 confía en nosotros para impulsar la innovación
“Con Elastic Observability, podemos reducir o prevenir las interrupciones de la red, agilizar el análisis de la causa raíz y obtener información sobre el comportamiento de la red. Esto reduce significativamente los problemas de red y ayuda a aumentar la satisfacción de los clientes”.
“Con Elastic Observability, podemos reducir o prevenir las interrupciones de la red, agilizar el análisis de la causa raíz y obtener información sobre el comportamiento de la red. Esto reduce significativamente los problemas de red y ayuda a aumentar la satisfacción de los clientes”.
Erwin Halmans, gerente de proyectos, Operaciones y Garantía de Redes Basadas en Datos
Únete al chat
Conéctate a la comunidad global de Elastic y participa en conversaciones abiertas y colaborativas.
Preguntas frecuentes
¿Qué es la observabilidad?
La observabilidad se refiere a la recopilación y el análisis de telemetría, como logs, métricas y trazas, de una gran variedad de fuentes, para brindar información detallada sobre el comportamiento de la infraestructura y las aplicaciones que se ejecutan en tus entornos.
¿Cuál es la diferencia entre observabilidad y monitoreo?
La observabilidad puede considerarse la evolución del monitoreo de las aplicaciones modernas. Fundamentalmente, es la capacidad de las aplicaciones y la infraestructura para exponer su estado interno a través de logs procesables, métricas publicadas y trazas distribuidas. Como enfoque, la observabilidad es más adecuada que el monitoreo tradicional para gestionar la complejidad y la escala de los entornos nativos del cloud a través de la recopilación, la transformación, la correlación, el análisis y la visualización de las señales de telemetría. Elastic Observability reúne todas estas capacidades en una sola plataforma. La observabilidad sigue evolucionando con nuevas tendencias y tecnologías.
¿Qué es la observabilidad agéntica?
La observabilidad agéntica es un enfoque en el que los agentes de IA investigan y resuelven incidentes de forma activa, en lugar de esperar a que los ingenieros interpreten los dashboards y las alertas. Los agentes de IA realizan un análisis de la causa raíz al analizar los datos de telemetría para identificar la causa subyacente de un incidente. Correlacionan señales de registros, métricas, rastros y otros datos de telemetría con el fin de armar un panorama completo de lo que está pasando. Con la automatización de flujos de trabajo, los agentes pueden recomendar o automatizar la remediación según sus hallazgos. El soporte de servidores MCP extiende estas capacidades más allá de la plataforma de observabilidad y les da a los agentes acceso a herramientas y sistemas externos durante las investigaciones.
Elastic nightshift AI SRE va aún más allá: aprende a investigar como lo haría tu mejor ingeniero, pone a prueba varias hipótesis en paralelo y ofrece medidas correctivas respaldadas por evidencia, con un razonamiento transparente.
¿Cuáles son los beneficios de AIOps y la observabilidad agéntica?
Al implementar AIOps y observabilidad agéntica, los equipos de SRE pueden detectar y resolver problemas de forma proactiva más rápido mediante análisis contextual de la causa raíz y correlación entre señales. Las empresas pueden cumplir con los SLA y mejorar el tiempo de comercialización, la eficiencia operativa y la satisfacción del cliente. PepsiCo aumentó la eficiencia y redujo el MTTR en un 30 % con Elastic Observability, resolviendo problemas en minutos en lugar de días.
¿Por qué las empresas están cambiando de Datadog a Elastic Observability?
La razón más común por la que las empresas cambian de Datadog a Elastic Observability es el costo. Los precios de Datadog por host y por métrica suben rápido a medida que la infraestructura crece, y muchos equipos se ven obligados a tomar decisiones difíciles sobre qué datos conservar y cuáles descartar. Elasticsearch almacena logs, métricas y trazas con la mejor eficiencia de almacenamiento de su clase para que la retención de fidelidad completa deje de ser una decisión presupuestaria, alta cardinalidad incluida. Solo para métricas, Elastic puede ofrecer ahorros de hasta 4 veces en comparación con Datadog, lo que brinda a los equipos más control sobre lo que almacenan, cuánto tiempo lo conservan y lo que pagan.
¿Elastic Observability brinda soporte para OpenTelemetry y Prometheus de forma nativa?
Sí. Elastic Observability prioriza OpenTelemetry, con soporte nativo para datos y flujos de trabajo de OpenTelemetry. Elastic Distributions of OpenTelemetry (EDOT) ofrece distribuciones listas para producción para recopilar y enviar telemetría a Elastic. Elastic también ofrece monitoreo nativo de Prometheus, incluido el soporte para Prometheus remote write y PromQL directamente en Kibana. Los equipos pueden usar los estándares de OpenTelemetry y Prometheus sin agentes propietarios, conversiones de datos ni un stack de observabilidad independiente.