Base de datos vectorial de Elasticsearch: envía en minutos, escala de manera accesible a cientos de miles de millones
Las partes difíciles de la recuperación híbrida ya están resueltas. Valores predeterminados optimizados, modelos de terceros y nativos de Jina AI e inferencia de GPU gestionada: todo listo para usar. Crea apps de IA rápidas y escalables en vez de infraestructura.

¿Qué debería hacer tu base de datos vectorial por ti?


Base de datos vectorial de Elasticsearch: más que solo vectores, el favorito de los desarrolladores
Sin brechas ni vulnerabilidades. Valores predeterminados optimizados. Recuperación híbrida. Todo funciona en conjunto, porque así se desarrolló.
Una sola llamada, eso es todo: de cero a búsqueda de vectores en minutos
Comienza con la base de datos vectorial de Elasticsearch. El camino más rápido hacia la búsqueda vectorial con valores predeterminados para cargas de trabajo de vectores, la búsqueda híbrida y la opción de generar incrustaciones o traer las tuyas.
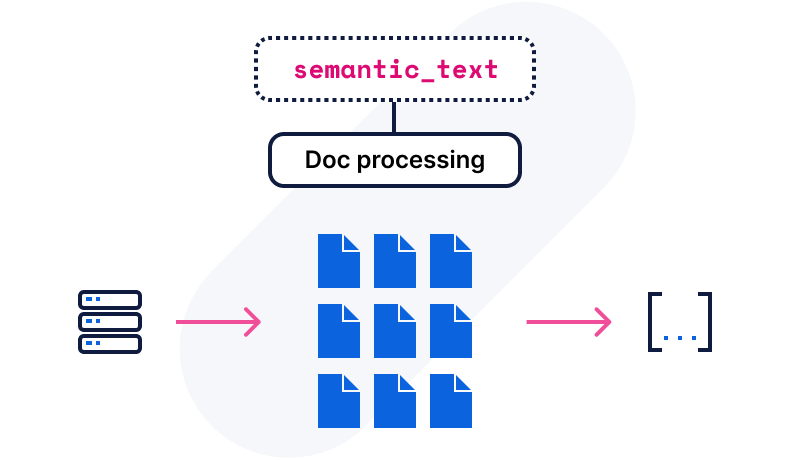
Trae tu contenido y deja que nos encarguemos del resto.
from elasticsearch import Elasticsearch

client = Elasticsearch(
   "https://xyz.elastic.cloud:443",
   api_key="..",

)

client.indices.create(
   index="my_semantic_vectors",
   mappings={
       "properties": {
           "content": {"type": "text", "copy_to": "semantic_content"},
           "semantic_content": {"type": "semantic_text"},
       }
   },
)

client.bulk(
   operations=[
       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Yellowstone National Park spans Wyoming, Montana, and Idaho, covering over 2.2 million acres. It is famous for the geyser Old Faithful and sits atop the Yellowstone Caldera, a supervolcano."},

       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Yosemite National Park covers over 750,000 acres in California. A UNESCO World Heritage Site, it is best known for its granite cliffs, waterfalls, and giant sequoia trees."},

       {"index": {"_index": "my_semantic_vectors"}},

       {"content": "Rocky Mountain National Park is known for its mountainous terrain, including Longs Peak, the highest in the park. It is a popular destination for hiking, camping, and wildlife viewing."},
   ],
)
Desarrolla con la base de datos vectorial de Elasticsearch


Base de datos vectorial, y el resto de lo que realmente necesitas
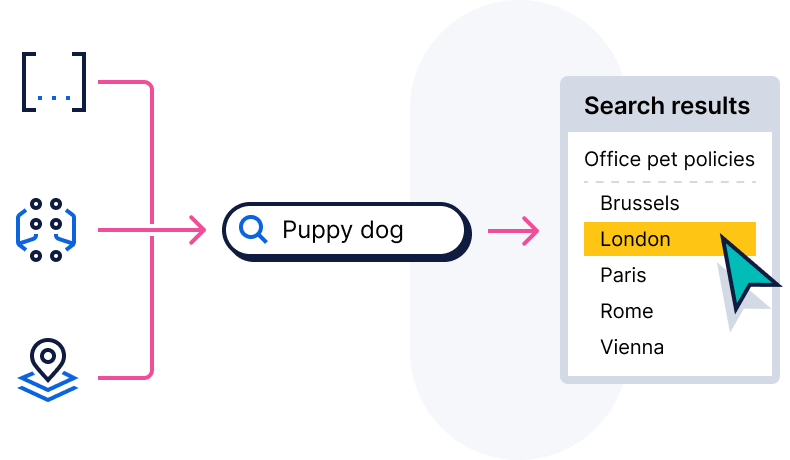
En el mundo real, la búsqueda de vectores necesita más que vectores. Combina la búsqueda semántica con filtros, seguridad, campos estructurados y clasificación BM25 en una sola búsqueda, sin necesidad de unir resultados de forma manual.

Un vecindario de alta calidad
Del prompt al producto: cómo desarrollar con la base de datos vectorial de Elasticsearch.
Cliente destacado
FRAIM usa Elasticsearch para desarrollar una plataforma de búsqueda de conocimiento para la era de la IA, consolidando de forma nativa la búsqueda de texto y de vectores para reducir los costos generales de su plataforma de búsqueda en más del 50 % y acelerar de manera significativa el desarrollo de RAG y agentes de IA.
Cliente destacado
WP Engine utiliza Elasticsearch para llevar la innovación en IA a los sitios web de WordPress, aprovechando las integraciones nativas de Google Cloud para reducir el tiempo de desarrollo de características de IA de semanas a horas y ofrecer tiempos de respuesta de búsqueda de 5 ms con cero tiempo de inactividad.
Cliente destacado

Adobe escala, gestiona múltiples casos de uso y pone a trabajar las características del machine learning con Elastic.
Resultados en cifras
Pruebas de rendimiento y resultados de la base de datos vectorial de Elasticsearch.


Primeros pasos: recursos para cada etapa de la compilación
Ingesta, parseo e indexación
Insertar
Recuperar
Herramientas de desarrollo
Insertar
Recuperar
Herramientas de desarrollo
Preguntas frecuentes
¿Qué es una base de datos vectorial y cómo funciona?
¿Qué es una base de datos vectorial y cómo funciona?
Una base de datos vectorial almacena información como vectores, que son representaciones numéricas de objetos de datos, también conocidos como incrustaciones de vectores. Usa incrustaciones de vectores para la búsqueda multimodal en un set masivo de datos estructurados, no estructurados y semiestructurados, como imágenes, texto, videos y audio. Las bases de datos vectoriales están diseñadas para gestionar incrustaciones de vectores y, por lo tanto, ofrecen una solución completa para la gestión de datos.
¿Qué son las incrustaciones de vectores?
¿Qué son las incrustaciones de vectores?
Las incrustaciones de vectores usan un modelo de machine learning para traducir texto en números, lo que te permite realizar búsquedas de vectores. Al convertir los datos en vectores, las incrustaciones facilitan la comparación, la búsqueda y el análisis de similitudes entre elementos de este espacio.
¿Cuáles son los beneficios de una base de datos vectorial?
¿Cuáles son los beneficios de una base de datos vectorial?
Una base de datos vectorial ofrece eficiencia a escala al permitir una migración de datos sin problemas entre entornos locales, aislados y de sovereign cloud, y al proporcionar almacenamiento para incrustaciones de vectores.
Las bases de datos vectoriales destacan en la búsqueda de similitudes, lo que te permite encontrar fácilmente elementos relacionados, lo cual es esencial para los sistemas de recomendación, la búsqueda de imágenes y el descubrimiento de contenido. Con capacidades de búsqueda semántica, van más allá de la simple coincidencia de palabras clave para ofrecer resultados basados en el significado y el contexto. Al almacenar incrustaciones de vectores, brindan soporte a aplicaciones de IA y Machine Learning, lo que facilita el despliegue de modelos de recomendación y procesamiento de lenguaje natural (NLP).
¿Elasticsearch es una base de datos vectorial?
¿Elasticsearch es una base de datos vectorial?
Sí, Elasticsearch es la base de datos vectorial open source más desplegada del mundo, que te ofrece una manera eficiente de crear, almacenar y buscar incrustaciones de vectores a escala. Con la base de datos vectorial lista para empresas de Elastic, logras tiempos de búsqueda rápidos y un rendimiento óptimo, incluso con datos que cambian rápidamente. Diseñada para escalarse, ofrece resultados de búsqueda relevantes y personalizados, a la vez que simplifica tus procesos de desarrollo.
¿Por qué elegir Elastic como tu base de datos vectorial?
¿Por qué elegir Elastic como tu base de datos vectorial?
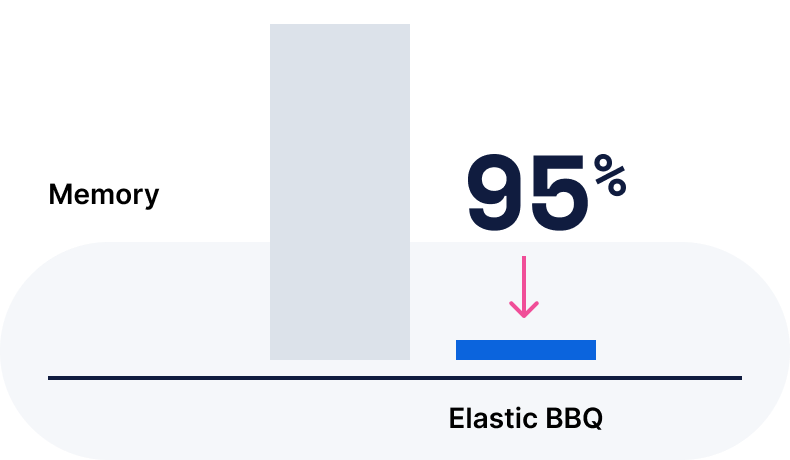
Elasticsearch es la base de datos vectorial más descargada del mundo, diseñada específicamente para ayudar a los desarrolladores a ofrecer búsquedas de alta precisión y experiencias de IA escalables más rápido y a menores costos. Elasticsearch Vector Database se encarga de las partes difíciles de la recuperación híbrida con valores predeterminados optimizados, modelos nativos de Jina AI y de terceros, e inferencia de GPU gestionada, todo listo para usar. Ejecuta búsquedas vectoriales y por palabras clave en datos de texto, imágenes y multimodales en un solo índice, sin necesidad de crear ni mantener un pipeline de incrustaciones. Viene preoptimizada para cargas de trabajo vectoriales, lo que ofrece un alto rendimiento, absorbe picos de tráfico automáticamente y reduce su escala cuando la demanda disminuye. Obtén la seguridad, el RBAC y las rutas de recuperación que esperas, para que crees apps, no infraestructura.
¿Puedo ejecutar Elasticsearch como una base de datos vectorial local o aislada?
¿Puedo ejecutar Elasticsearch como una base de datos vectorial local o aislada?
Sí. Elasticsearch se puede desplegar totalmente de forma local: en hardware, en un cloud privado o en redes completamente desconectadas sin conectividad externa. Las agencias gubernamentales, los contratistas de defensa y las empresas reguladas utilizan Elastic Cloud Enterprise (ECE) para orquestar clústeres locales de Elasticsearch para escalar, incluso en entornos clasificados y desconectados. Todas las capacidades de búsqueda vectorial, búsqueda híbrida y RAG disponibles en Elastic Cloud están igualmente disponibles en despliegues locales
.