Elasticsearch 向量数据库:数分钟内即可完成部署,能以超高性价比扩充至千亿规模
混合检索的难点部分已经解决,配备优化的默认设置、第三方和原生 Jina AI 模型以及开箱即用的托管型 GPU 推理功能。您可以构建快速、可扩展的 AI 应用,无需构建基础架构。
Elasticsearch 是全球部署最广泛的向量工作负载平台之一,为 GitHub、Docusign、Seismic 等众多公司的语义搜索、检索增强生成 (RAG) 以及推荐功能提供支持。今天,我们正式发布 Elasticsearch 向量数据库,这是一款专为基于向量的应用进行优化的全新无服务器产品。您只需提供文档和查询指令,我们来负责处理嵌入、索引调优以及基础架构。此外,该产品还兼具低成本和可扩展的优势。
对于新用户而言,这是运行高质量向量搜索的最快方式。如果您已在使用 Elasticsearch,这款新产品能够在您的数据所在平台上实现向量搜索,您无需引入任何新系统。Elasticsearch 向量数据库支持多种应用场景,例如为大型语言模型 (LLM) 提供事实依据,为 AI 智能体赋予检索与记忆能力,以及处理数千亿个向量等。立即创建新项目,只需几分钟即可开始使用。
一个引擎,满足所有向量应用场景
Elasticsearch 向量数据库专为使用向量构建应用程序的用户而设计:
RAG:通过密集和稀疏向量检索为您的 LLM 检索适当的上下文,或者采用结合向量检索和词汇检索的混合搜索。您的生成质量会随着检索质量的提升而提高。
AI 智能体:为智能体提供针对文档和对话记忆的快速筛选检索,满足多步智能体循环所需的低延迟要求。
语义搜索:根据含义而非关键字进行匹配,只需一种字段类型且无需任何管道代码。
推荐和相似度:针对产品、图像或任何内容大规模查找最近邻。
您的向量工作负载所需的一切,开箱即用且经过优化
构建基于向量的应用程序意味着将多个独立部分连接起来:设置并托管嵌入模型,通过这些模型为您的文档编制索引,高效存储向量,将嵌入模型应用于每个查询,与向量存储进行匹配,以及最后检索匹配项背后的文档。Elasticsearch 向量数据库可为您处理所有这些操作,无需进行额外配置或设置。
使用 vectordb_document 索引模式进行向量索引
vectordb_document 索引模式是一种专为向量优先型工作负载构建的新索引配置,默认启用,因此您可以获得专家会选择的设置。以下是它会启用的功能:
默认使用 bfloat16:向量的存储大小仅为 float32 的一半,对召回率的影响可忽略不计,甚至在考虑量化之前,就能将您的磁盘占用空间大致减半。
排除源向量:在 Elasticsearch 中,您的嵌入向量已存在于用于搜索的索引结构中;在 _source 中保留第二份原始副本只会增加存储占用并降低获取结果的速度。我们排除了重复项,以便更快获得响应并减少存储空间。
将正确的文件预加载到缓存中:向量查询最先访问的数据结构会提前预热到内存中,从而确保无论是第一次查询还是第一千次查询,速度都快如闪电。
并行合并:合并可将分段整合为组织更有序的向量结构,从而同时提升召回率并改善延迟,而以多线程方式运行这些合并则可以更快达成这一目标。
向量存储、压缩和自动调优
您的向量会自动压缩。更好的二进制量化 (BBQ) 可在保持召回率的同时将向量的内存占用最多减少 32 倍,而 DiskBBQ 则能针对大规模工作负载进一步降低内存需求。
选择启用自动校准,该功能会根据您的数据调整每个分段的量化参数,并在数据发生漂移时在每次合并时重新调整。在 18 个数据集上的测试结果显示,每秒查询数 (QPS) 平均提升了 16.7%,且大多数数据集的召回率也有所提高。
托管 GPU 推理上的嵌入
通过原生 Jina AI 嵌入和重排序模型生成嵌入向量,或引入第三方模型;所有模型均在 Elastic Inference Service (EIS) 提供的托管 GPU 上运行,无需运维模型服务器。如果您愿意,您也可以选择自行托管。
semantic_text 字段类型可自动处理分块和嵌入以及查询,这是市面上实现语义搜索的最简单途径。
混合搜索和过滤向量搜索
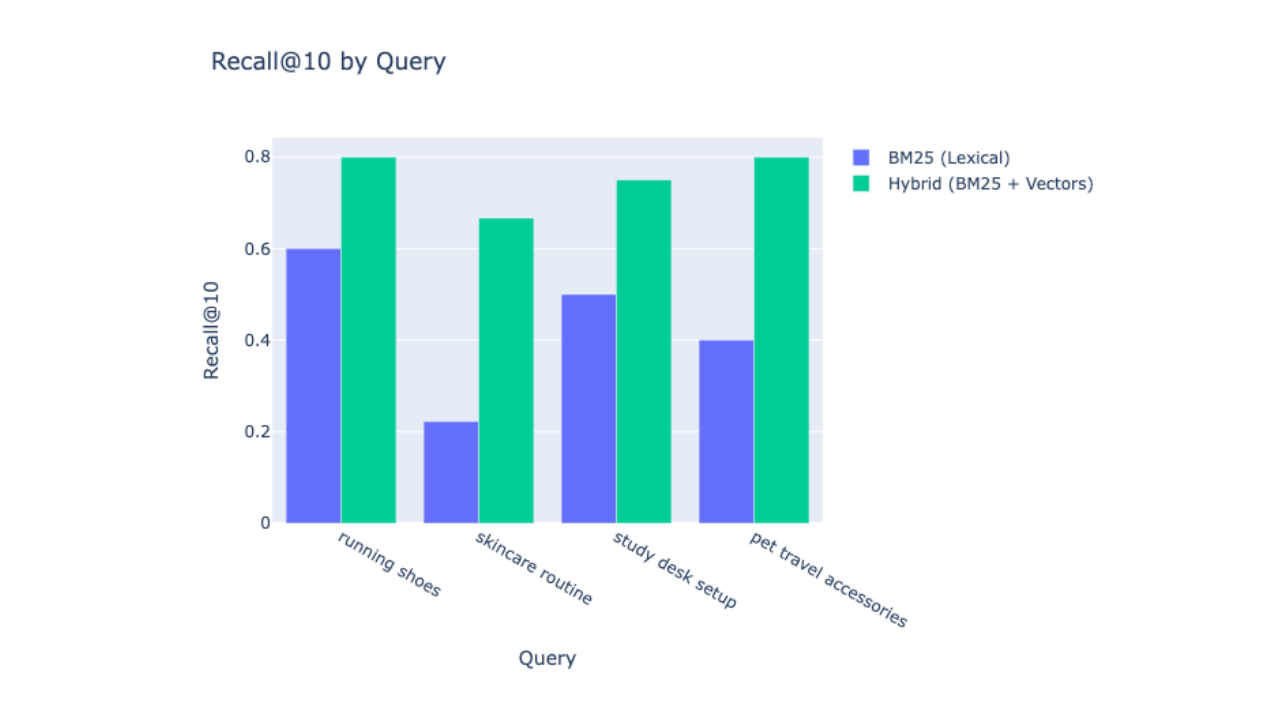
混合搜索是内置功能,可在单个查询中结合全文检索和向量检索。您可以使用倒数排序融合 (RRF) 或您所需的任何其他融合机制来融合结果。在混合搜索中,向量搜索部分的配置往往最具挑战性;而借助 Elasticsearch 向量数据库,这一难题迎刃而解,您的整个混合技术栈也会变得更加出色。
借助带过滤功能的向量搜索,将元数据过滤作为向量检索过程本身的一部分来实施,而不是将其作为事后补救措施,从而避免损害召回率。
从第一天起即面向企业
您还可以获得基于角色的访问控制 (RBAC)、审计日志,以及纯向量数据库通常缺乏的合规性认证。
扩展时经济实惠且具有可预测性
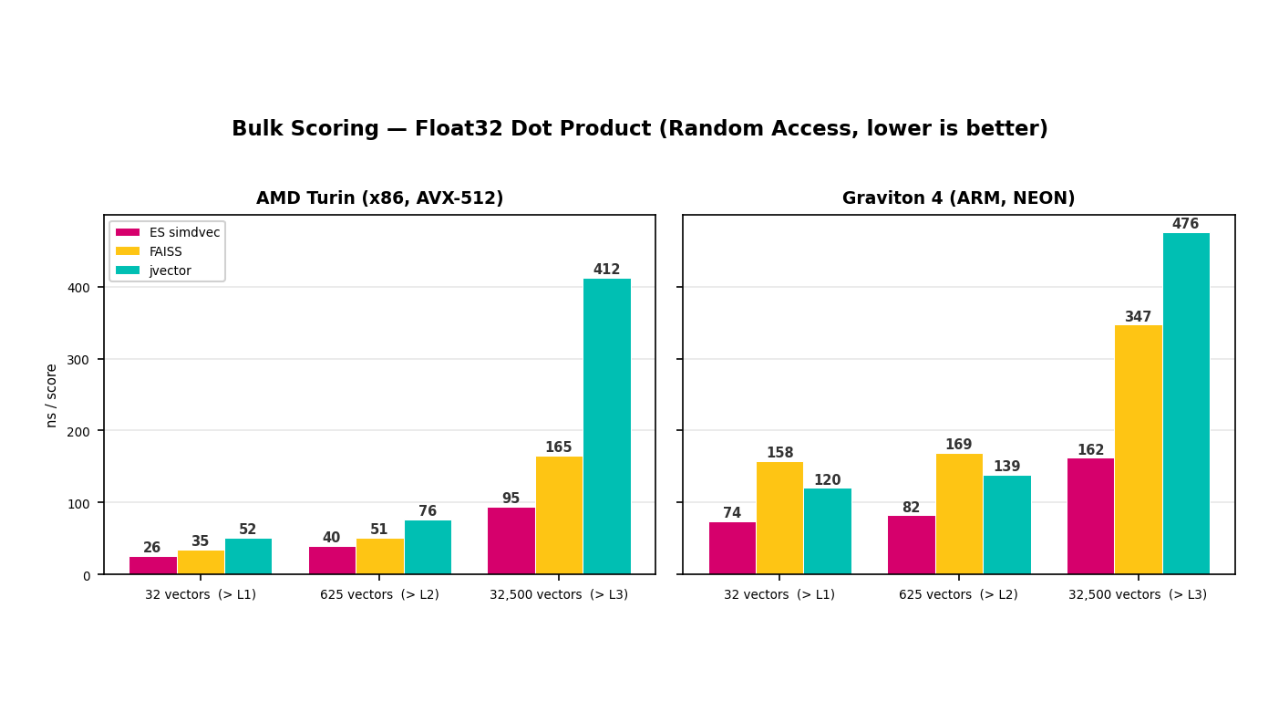
Elasticsearch 向量数据库旨在让您随着业务增长仍可负担:BBQ 和 DiskBBQ 压缩可使存储线性增长并保持较低内存占用,这意味着即使扩展到数千亿个向量,费用也不会大幅攀升。您实际支付的费用由您已知的数字决定:存储的数据量、索引的数据量,以及所需的搜索容量。估算您的文档数量、向量维度和查询负载,您便可在创建项目之前算出所需费用。您还可以在月底逐项了解账单明细。没有不透明的计算单元,也不会因后台操作产生意外费用。
如何开始使用 Elasticsearch 向量数据库
创建无服务器向量数据库项目
创建新的 Elastic Cloud 无服务器向量数据库项目。将数据指向终端,即可开始编入索引。
使用 semantic_text 创建索引
向量索引模式负责处理向量配置。使用 semantic_text 意味着系统会在托管 GPU 推理上为您管理嵌入和分块设置以及索引设置,无需构建嵌入管道。
PUT my-vectors
{
"mappings": {
"properties": {
"description": { "type": "semantic_text" }
    }
  }
}
采集文档
索引文本,系统便会为您生成嵌入。
POST /my-vectors/_doc
{
  "id": "park_rocky-mountain",
  "title": "Rocky Mountain",
  "description": "Bisected north to south by the Continental Divide, this portion of the Rockies has ecosystems varying from over 150 riparian lakes to montane and subalpine forests to treeless alpine tundra."
}
运行语义搜索查询
查询您刚刚创建的相同语义字段:
GET /my-vectors/_search
{
  "query": {
    "semantic": {
      "field": "description",
      "query": "a mountain range in the middle of north america"
    }
  }
}
然后您会获得返回的结果:
{
  "took": 80,
  "hits": {
    "max_score": 0.7792325,
    "hits": [
      {
        "_index": "my-vectors",
        "_score": 0.7792325,
        "_source": {
          "id": "park_rocky-mountain",
          "title": "Rocky Mountain",
          "description": "Bisected north to south by the Continental Divide, ..."
        }
      }
    ]
  }
}语义搜索只是开始。运行纯文本查询,或将两者结合为混合查询。您甚至可以构建自己的向量查询,实现完全控制。请参阅文档中的语义搜索快速入门,获取完整说明。
Elasticsearch 中向量搜索的未来展望
我们已经在着手进行后续改进:
更出色的多租户处理:如果您的数据需要按租户保持隔离,我们将为您提供一种速度更快、代码量更少的方法来实现这一目标。
自动索引优化:从“全新索引”到“完全优化”,无需过多人工干预。
持续的基础架构改进:对向量数据库的设置和基础架构进行持续调优,确保您始终获得最佳吞吐量和最快响应。
在 Elastic Cloud Serverless 上试用 Elasticsearch 向量数据库
仅需数分钟,您即可从零开始构建支持混合检索与过滤功能的向量查询应用,并利用生产级默认配置自动完成性能调优。您可以构建快速、可扩展的 AI 应用,无需构建基础架构。
开始使用 Elastic Cloud Serverless,或深入了解完整文档和 API 参考。
这些内容对您有多大帮助?