Jina AI 搜索模型
用于采集和检索的前沿级模型
Jina AI 模型可在从采集到检索的全过程中保留语义。仅需一小部分计算成本,即可实现前沿级准确性;它可以部署在您的云环境或本地部署环境中,也可以在 Elasticsearch 中原生运行。
能够在从文档到答案的过程中保留语义的 AI 模型
Jina AI 开发前沿级小型模型,用于高精度、高性价比的文档采集、跨文本和媒体多语言嵌入以及重排序。它可在 Elasticsearch 上零配置原生运行。
设计紧凑,结果精准
通过一个 API,将文档转化为整洁的结构化数据和高精度搜索结果。

无论您在哪里构建,都可以使用 Jina 模型
从完全托管到自托管,Jina 模型能完美适配你数据所在的任何环境。选择最适合您的访问路径。
我们的研究
加入我们的开源社区
Jina 的模型采用开放权重,可在 Hugging Face 上免费获取,每月下载量达数百万次。其代码库也已在 GitHub 上公开。社区成员还可直接与我们的开发人员交流。
常见问题
什么是 Jina 搜索模型?
什么是 Jina 搜索模型?
Jina 模型是开源的、前沿的检索 AI 模型。它们包括用于向量的嵌入模型、用于提高精确度的重排序器,以及用于从 URL 和文档中提取和构建内容的 OCR 和读取器。
使用 Jina 模型是否需要 AI 或机器学习专业知识?
使用 Jina 模型是否需要 AI 或机器学习专业知识?
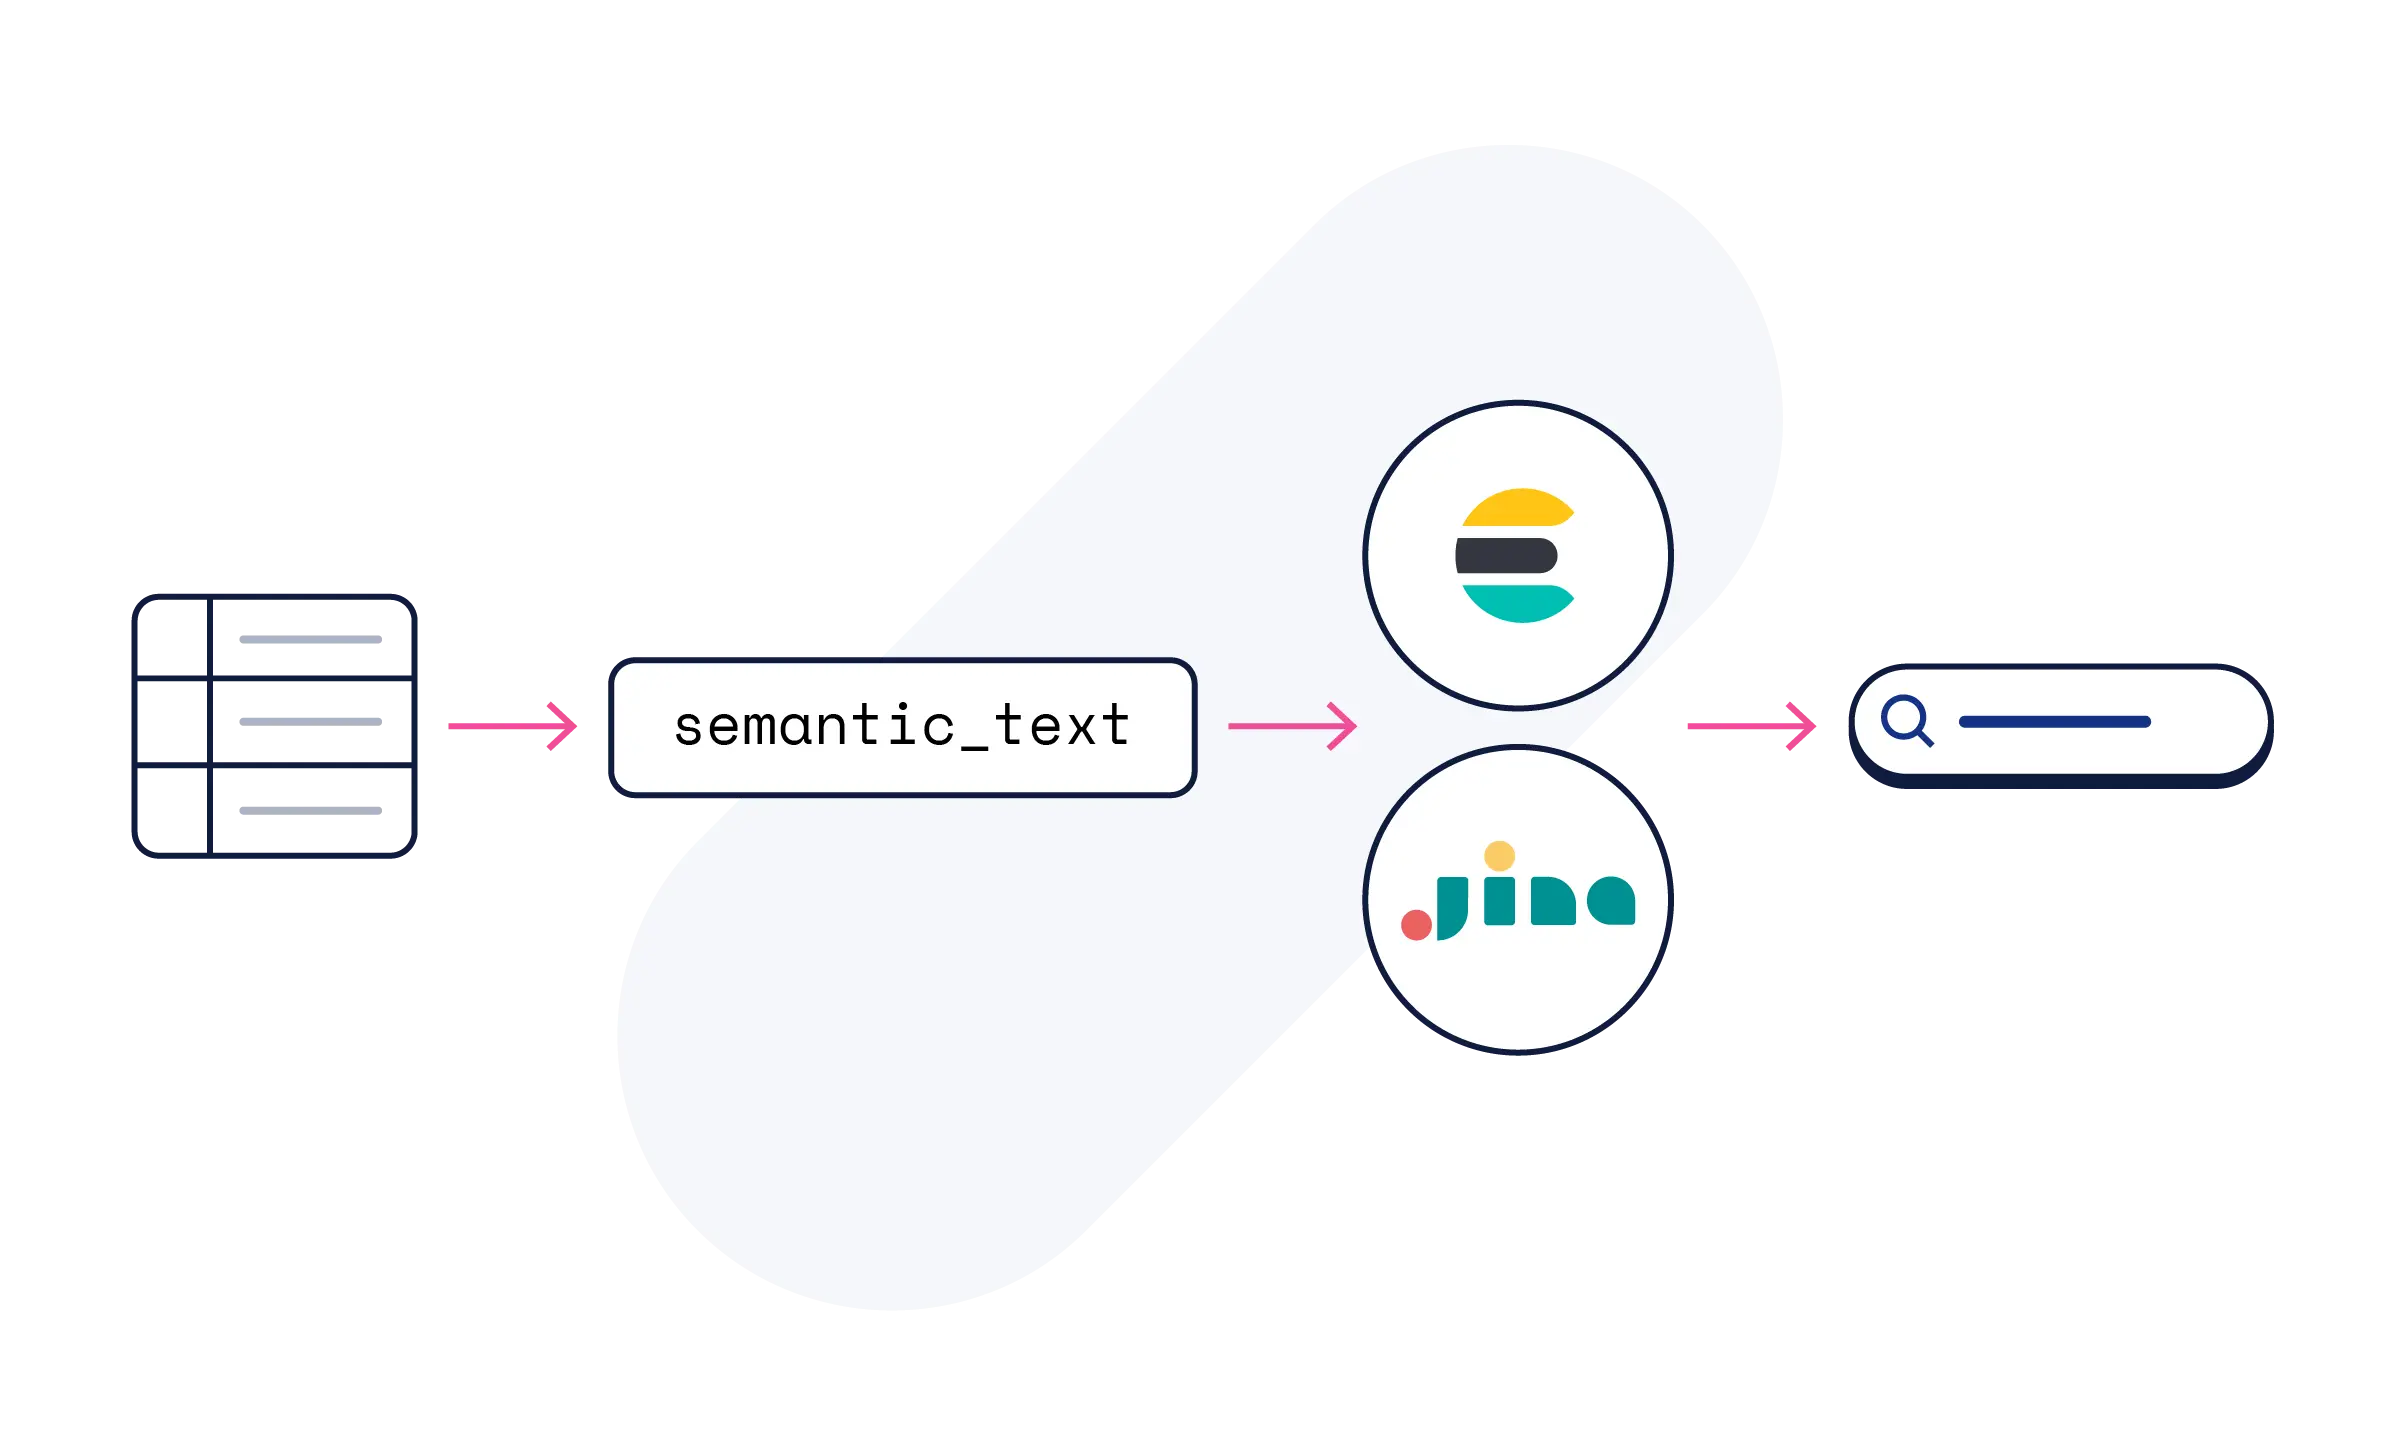
无需具备 ML 专业知识。Jina 模型在 Elasticsearch 中以预配置端点形式提供。只需映射 semantic 或 semantic_text 字段,即可自动生成向量嵌入。
我要怎么开始呢?
我要怎么开始呢?
Jina 模型可在 Elastic Cloud 的 Elastic 推理服务上使用,所有试用版均已包含该能力。您可先定义 semantic 或 semantic_text 字段,也可前往 Hugging Face 的模型卡片查看代码示例。
目前可用的 Jina 模型有哪些?
目前可用的 Jina 模型有哪些?
有关 Elastic Inference Service 中支持的 Jina 模型的详细信息,请参阅我们的 Jina 模型文档。
支持多少种语言?
支持多少种语言?
Jina-embeddings-v5-omni 和 Jina-ocr-v1 支持 100 多种语言。使用一种语言发起查询,也能找到以另一种语言编写的相关内容,无需翻译管道。
这与 ELSER 有何关系?
这与 ELSER 有何关系?
Jina 嵌入模型是新项目的默认选择。对于选择使用 ELSER 的客户,ELSER 将继续获得支持。两者均可在 Elasticsearch 的混合搜索框架中使用。
请问这是一个独立的产品吗?
请问这是一个独立的产品吗?
Elastic 推理服务上的 Jina 搜索模型面向所有 Elastic Cloud 用户开放,采用按量计费模式。无需单独的许可证、订阅或 API 密钥。Jina 模型也可作为 Jina On-Prem 的一部分单独购买。
这与 Elastic 的向量数据库页面有什么关系?
这与 Elastic 的向量数据库页面有什么关系?
向量数据库页面介绍了如何大规模存储和搜索向量;本页面则介绍了生成和重排序这些向量的 AI 模型。两者结合,涵盖存储、计算和应用。