Redução de falsos positivos com investigações automatizadas de SIEM da Elastic e Tines

 Share on Twitter
Compartilhar no Twitter

 Share on LinkedIn
Compartilhar no LinkedIn

 Share on Facebook
Compartilhar no Facebook

 Share by Email
Compartilhar por e-mail

 Print this page
Imprimir
Um dos maiores problemas de gerenciamento de SIEM que as equipes de SOC enfrentam é que elas geralmente ficam sobrecarregadas por falsos positivos, levando à fadiga dos analistas e lacunas de visibilidade. Além disso, um dos desafios mais difíceis na segurança é detectar quando os tokens de acesso SaaS estão comprometidos sem aumentar o problema dos falsos positivos.
Na Elastic, a equipe de InfoSec lida com ambos os problemas automatizando investigações de alertas de SIEM com ferramentas como Tines. Este post do blog compartilha como otimizamos nossos fluxos de trabalho, reduzimos falsos positivos e capacitamos nossos analistas a focar em ameaças reais.
Automação da investigação inicial de alertas SIEM
Em um post do blog anterior, escrevemos sobre como a equipe de InfoSec da Elastic criou pacotes de regras que detectavam analítica de comportamento de usuário e entidade (UEBA). À medida que expandimos esses pacotes de alertas para incluir mais fontes de dados, descobrimos que estávamos sobrecarregando os analistas do SOC com um alto nível de falsos positivos causados por atividades anômalas, porém benignas — por exemplo, atividade de token de API que ocorria apenas uma vez por mês ou a partir de um scanner conhecido. Isso levou a um problema em que tínhamos que decidir se criaríamos uma regra de detecção que poderia ser ruidosa devido a falsos positivos, ou aceitar que haveria uma lacuna de visibilidade por não ter essa detecção. Uma detecção ruidosa que tem muitos falsos positivos cria seu próprio tipo de lacuna de visibilidade devido à fadiga do analista. Mas esse problema gerou uma nova ideia: e se pudéssemos automatizar a investigação inicial de um alerta, fechando os falsos positivos conhecidos e escalando aqueles que não podemos fechar?
Descobrimos que, para muitas de nossas regras de detecção de provedores SaaS e UEBA, poderíamos fechar a regra se a atividade viesse de um dispositivo confiável, como uma de nossas estações de trabalho gerenciadas. A ação inicial do playbook de investigação, em muitos casos, é usar uma informação do alerta original, como o source.ip, e então consultar outros padrões de indexação no Elasticsearch para esse source.ip. Se houver algum resultado para a consulta, o alerta pode ser fechado como um falso positivo. Por exemplo, se você vir um alerta UEBA para atividade de AWS Secret Key, executaríamos o seguinte grupo de consultas para triar o alerta e ver se a atividade é de um dispositivo confiável:
Existem logs de proxy mostrando que o Elastic Agent se conectou com sucesso ao nosso Fleet Server a partir de uma estação de trabalho ou servidor com esse source.ip?
Esse source.ip pertence ao intervalo de IP público de uma das zonas de rede da AWS, do GCP ou do Azure que gerenciamos e controlamos?
O source.ip pertence a um aplicativo de terceiros autorizado, como Okta, Terraform, Tines, Qualys ou Snyk?
Houve algum login de autenticação de sign-on único FIDO2 bem-sucedido a partir desse source.ip nas últimas 2 horas?
Se qualquer uma dessas consultas subsequentes do Elasticsearch retornar resultados, podemos presumir que essa atividade da chave de API da AWS provavelmente está autorizada e podemos fechar o alerta. Se todas essas consultas retornarem zero resultados, acreditamos que a atividade é suspeita, portanto, encaminhamos para um membro da equipe do SOC para investigação adicional. Todas as consultas do Elasticsearch acima podem ser concluídas usando a API _search, e podemos usar a Signals API para fechar e marcar os alertas, o que nos permite automatizar todo o processo.
Ao enviar nossas detecções de SIEM do Elastic para um sistema de orquestração, automação e resposta de segurança (SOAR) usando o recurso Alert Actions, podemos usar nosso SOAR para executar automaticamente essas consultas de investigação para cada alerta aplicável. Com base nos resultados das consultas, podemos fechar o alerta automaticamente ou encaminhá-lo para um analista.
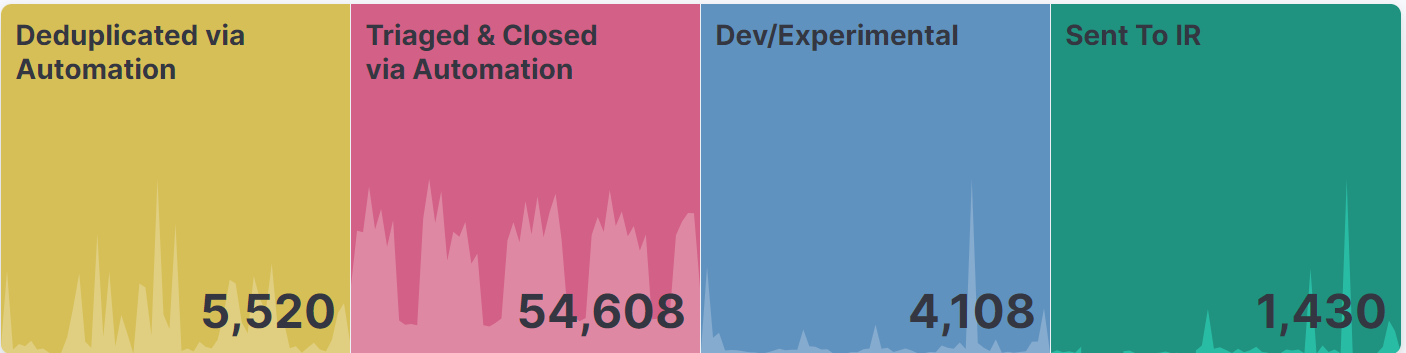
Essa capacidade de triagem automatizada nos permite criar classes inteiras de detecções que, normalmente, seriam ruidosas demais para investigar sem um aumento drástico no número de funcionários do SOC. Nosso fluxo de trabalho automatizado está atualmente triando e fechando mais de 3.000 alertas por dia sem qualquer interação humana. Levaria mais de 15 minutos para um analista experiente por alerta fazer a triagem da mesma forma. Se quiséssemos ter as mesmas detecções sem essa automação, precisaríamos de 94 funcionários adicionais em tempo integral. Este gráfico mostra nossos números dos últimos 30 dias de alertas em nosso SIEM:
Este fluxo de trabalho de triagem automatizado poderia ser criado usando scripts personalizados, mas este blog mostrará como construir essa automação com o Tines. Decidimos explorar dessa forma porque é o que a equipe de InfoSec da Elastic usa e, simplesmente, é mais fácil do que criar scripts. Descobrimos que o Tines facilita a criação e modificação de automações sem a necessidade de uma equipe de desenvolvimento dedicada.
Enviando os alertas para qualquer SOAR
Como mencionado acima, a primeira etapa é retirar o conteúdo do alerta do Elastic Security e enviá-lo para a sua solução SOAR de preferência. Para fazer isso, usamos o recurso Alert Actions no Elastic Security, que executará uma ação personalizada toda vez que um alerta for disparado.
Ao configurar uma regra de detecção, há uma opção para adicionar uma Ação de Regra. A partir daqui, você pode selecionar o tipo de conector desejado.
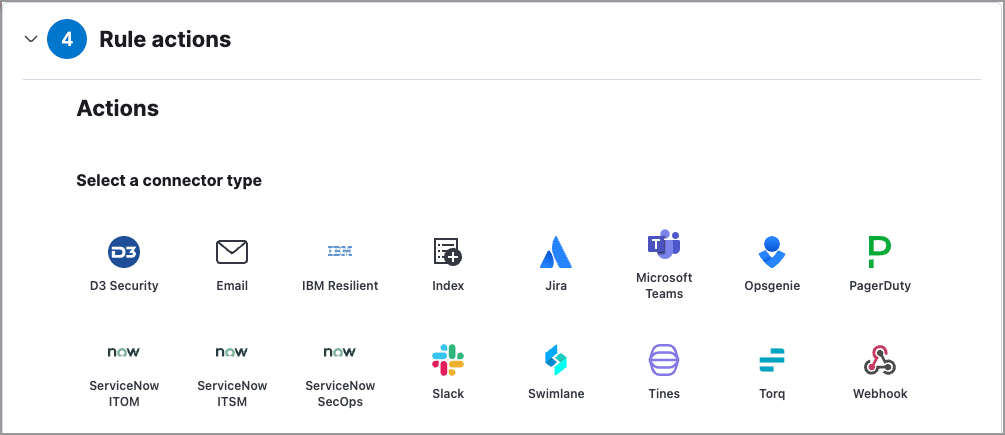
A maneira mais fácil de enviar seus alertas para o Tines é configurar e usar o conector Tines integrado no Elastic, que envia seus alertas para uma história do Tines para processamento.
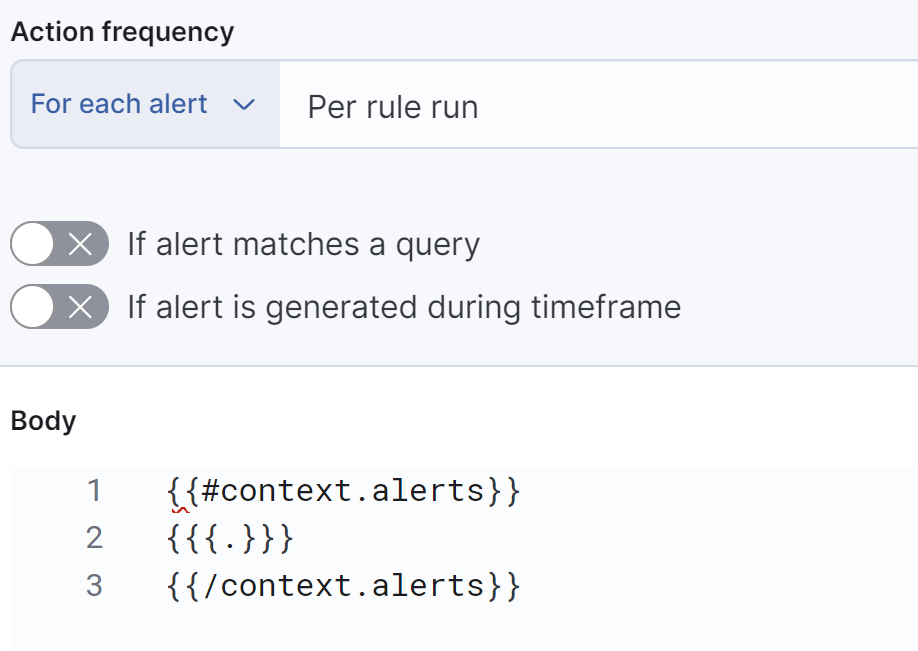
A outra opção é usar o conector Webhook, que é muito flexível porque permite que você envie uma parte do alerta ou todo o conteúdo do alerta em um formato ndjson para um Webhook de escuta. Usamos o Tines internamente na Elastic desde antes da existência do conector Tines, portanto, a maioria de nossas automações ainda usa o conector Webhook. Você pode enviar os alertas um por vez para o Webhook ou todos juntos em um único ndjson. Se você estiver usando scripts personalizados, pode usar este conector para receber e processar os alertas, e ele também funciona com a ação Webhook do Tines. Para enviar o conteúdo completo do alerta para um Webhook, você precisará configurar um conector Webhook para usar uma ação POST com o tipo de conteúdo definido como application/x-ndjson; charset=utf-8.
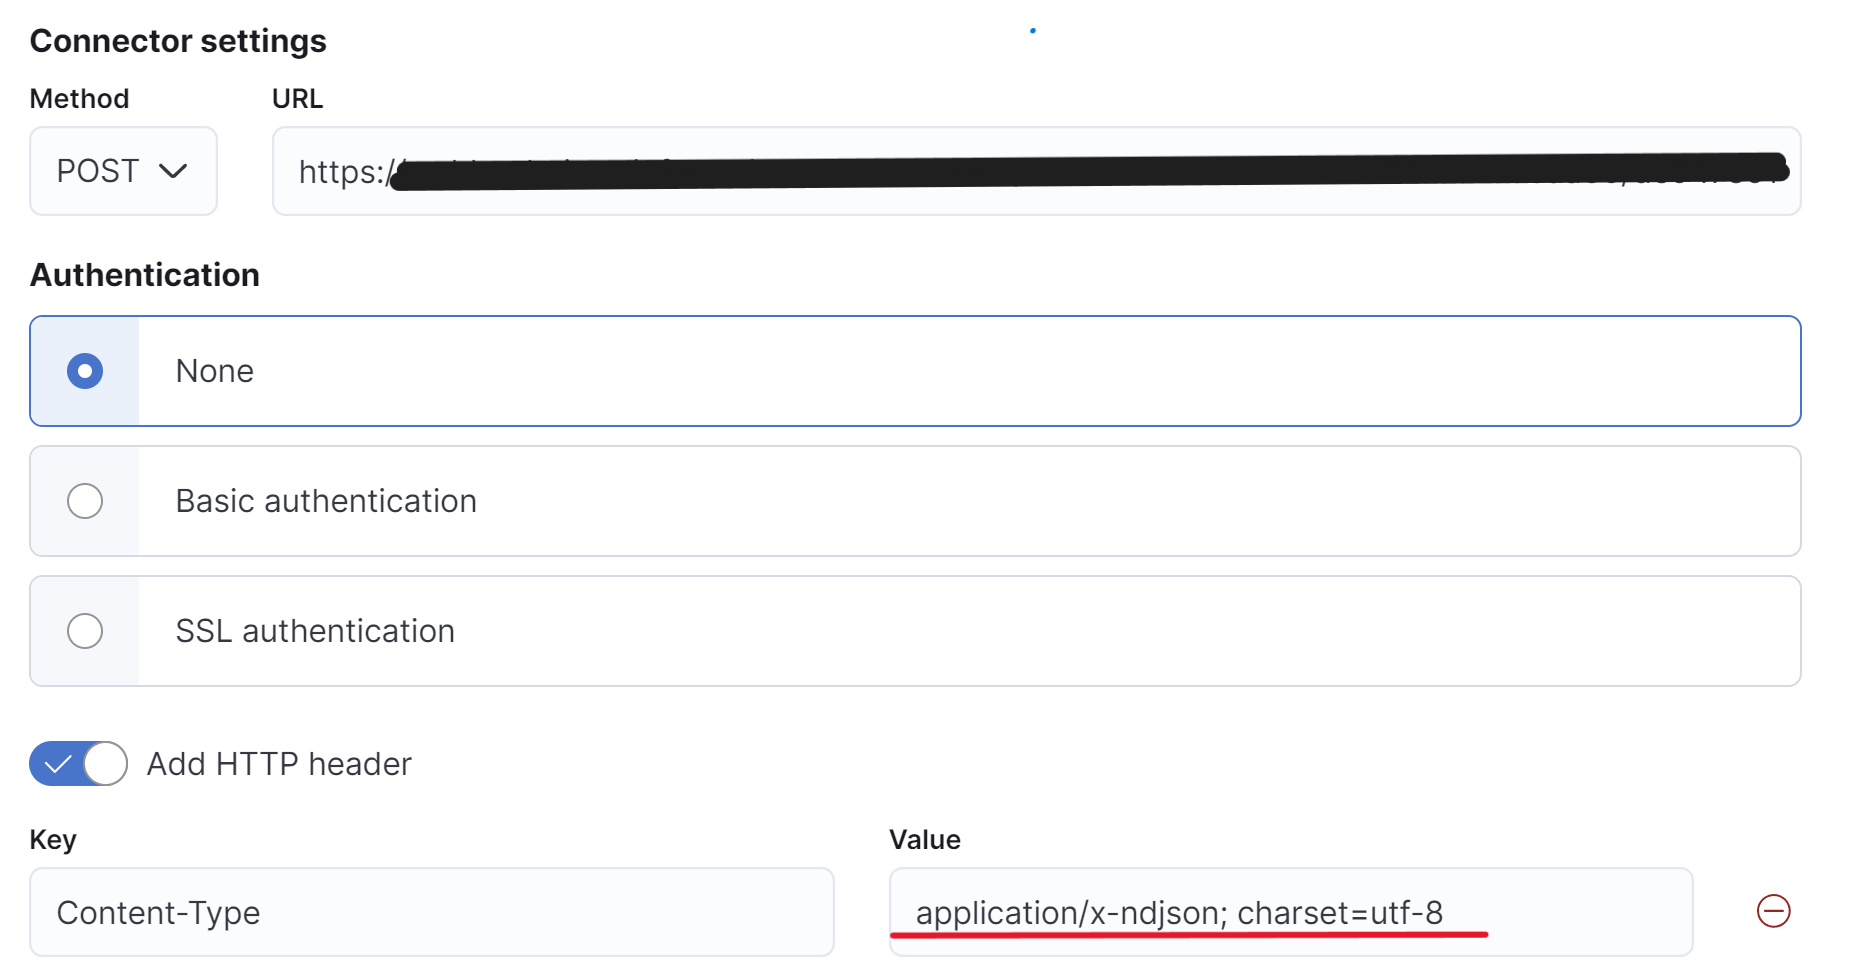
Ao adicionar as ações às suas regras, selecione o conector Webhook configurado e use a seguinte sintaxe mustache em sua configuração para enviar o alerta completo como um ndjson para o Webhook.
Uso de tags para rotear a automação
Ao criar essas automações, começamos criando um caminho de automação personalizado para cada alerta individualmente, mas descobrimos muito rapidamente que isso não é escalável. Nossa solução para isso foi usar tags personalizadas em nossas regras de detecção para rotear a regra para o caminho de triagem apropriado. Estamos enviando o alerta completo para o Tines, que inclui as tags como uma matriz no campo signal.rule.tags. Decidimos usar uma convenção de nomenclatura de Triage:{option} para descrever quais verificações automatizadas serão realizadas em uma regra. As regras de detecção podem ter várias tags diferentes.
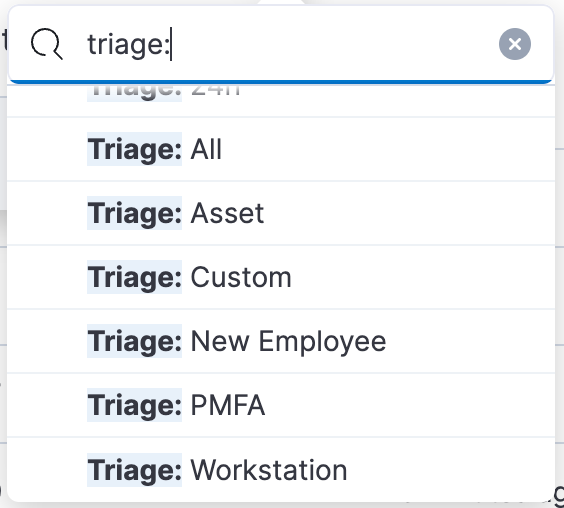
Aqui está uma descrição das tags de triagem automatizada que estamos usando:
Triagem: Todos rotearão o alerta pelos caminhos de triagem automatizada de Ativos, PMFA e estação de trabalho, e se alguma consulta retornar verdadeiro, o alerta será encerrado. Se nenhuma das consultas retornar verdadeiro, o alerta será escalado.
Triagem: Ativo verificará vários padrões de indexação para determinar se o IP de origem vem de um ativo que a Elastic possui ou gerencia de alguma forma. Isso inclui nosso banco de dados de ativos que armazenamos no Elastic, zonas de rede internas, nossos IPs públicos do Elastic Cloud, sistemas de CI/CD e espaço de IP público de sistemas de terceiros autorizados, como Okta ou Tines.
Triagem: PMFA analisará nossos logs de auditoria do Okta em busca de uma autenticação bem-sucedida usando MFA resistente a phishing, como uma passkey usando o Okta Verify ou o Windows Hello. Usamos a integração do Okta para coletar nossos logs de auditoria do Okta.
Triagem: Estação de trabalho verificará nossos logs de proxy Nginx em busca de conexões bem-sucedidas do Elastic Defend ao nosso servidor Fleet a partir do endereço IP. A Elastic é uma empresa distribuída e os funcionários podem trabalhar de qualquer lugar do mundo, mas seus agentes do Elastic Defend se conectam regularmente, então geralmente podemos ver que a estação de trabalho gerenciada de um funcionário da Elastic foi conectada a partir do mesmo IP que gerou o alerta.
Triagem: Novo Funcionário verificará nosso banco de dados de ativos, que contém um relatório diário de todos os funcionários exportado do nosso sistema de RH para ver se o usuário é um novo funcionário. Isso é importante para certas categorias de regras de detecção, como o Slack UEBA, que geralmente são acionadas quando um novo funcionário está configurando suas contas, mas raramente alertam para funcionários existentes.
Triagem: 1h instruirá o Tines a pausar a triagem de alertas por 1 hora antes de realizar o restante das ações de triagem. Isso pode ser útil para eventos como um usuário configurando uma estação de trabalho nova, onde o alerta pode ser fechado se a estação de trabalho estiver devidamente inscrita e registrada em nossos sistemas de gerenciamento de endpoint que instalam o Elastic Defend.
Triagem: 24h instruirá o Tines a pausar a triagem de alertas por 24 horas completas antes do processamento. Isso pode ser necessário para alguns caminhos de triagem onde os dados são atualizados apenas diariamente, como partes do nosso banco de dados de ativos que coletam um inventário diário de todos os computadores, usuários e contas de nuvem.
Triagem: Personalizada é para quaisquer caminhos de triagem personalizados que possam ser necessários para um alerta. Um bom exemplo disso é um cenário em que fornecemos a terceiros, como o Okta, uma chave de API altamente privilegiada usada para criar ou desativar contas no Azure e queremos ser alertados se esse token de API for usado a partir de um endereço IP que não pertence ao Okta. Esse alerta e a triagem automatizada nos permitem "Confiar, mas verificar" caso o armazenamento da nossa chave de API pelo Okta seja comprometido e usado fora dos espaços de IP do Okta.
Elementos fundamentais para a automação
Agora que estamos enviando o alerta completo como um JSON para nosso SOAR, podemos enviá-lo através do nosso caminho de triagem e, em seguida, para outras fontes, como Slack ou PagerDuty. No Tines, existem sete tipos diferentes de ações que podem ser usadas para criar suas histórias:
A ação Webhook emitirá eventos que ela recebe por meio de Webhooks (callbacks HTTP). Este é o método principal para enviar eventos para uma história no Tines.
A ação Send Email envia e-mails para os destinatários especificados nas opções da ação.
A ação Receive Email, formalmente conhecida como Ação IMAP, emite Eventos quando detecta novos e-mails em um servidor IMAP ou quando e-mails são enviados para um endereço de e-mail gerado exclusivamente.
Ação de transformação de evento tem vários modos que modificam o conteúdo dos eventos recebidos. Essas ações são extremamente flexíveis e poderosas.
A ação HTTP Request envia solicitações HTTP usando vários métodos para um URL especificado.
A ação de gatilho compara o conteúdo de um campo de um Evento recebido com regras predefinidas e, quando as regras correspondem, uma emissão de evento é acionada. Isso pode ser pensado como uma ação lógica “Se Então” (If Then).
A ação Send to Story envia eventos para outra story do Tines (a sub-story). Depois que a sub-story concluir sua ação, a ação Send to Story emitirá um evento. As ações Send to Story são semelhantes a funções ou bibliotecas em código onde você deseja reutilizar ações em vários locais.
Utilizando essas ações, podemos criar automações que nos economizam milhares de horas de trabalho por mês.
Exemplo de fluxo de trabalho de triagem automatizada simplificado:
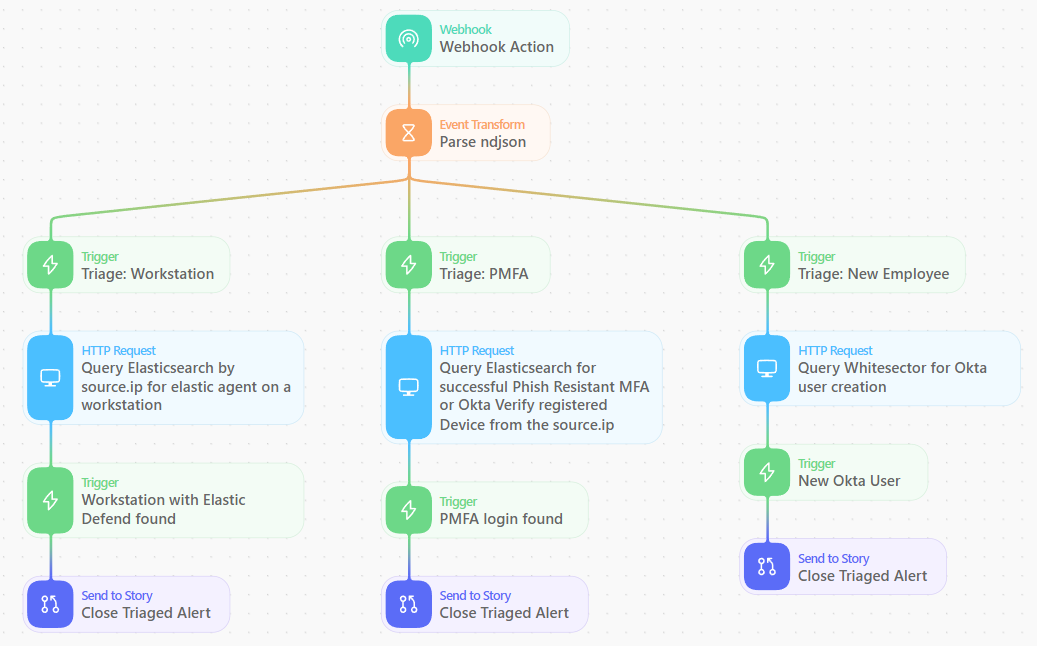
Nesta história de automação, processamos novos alertas à medida que chegam ao Webhook, usamos uma ação de transformação de evento para analisar o ndjson em um objeto que podemos referenciar mais facilmente e, em seguida, usamos ações de gatilho para determinar quais caminhos de triagem o alerta deve seguir.
A maioria das ações de solicitação HTTP são consultas à API _search do Elasticsearch. Nessas consultas subsequentes, usamos campos do alerta original, como o source.ip ou o user.email para fazer a triagem dos alertas.
O Tines vem com centenas de modelos de ação pré-criados, incluindo vários para interagir com o Elasticsearch. Você pode usar o modelo ’Query an Elasticsearch index for all records’ e, em seguida, modificar o payload para adicionar sua consulta usando o IP de origem do alerta. Como a maioria das consultas procura por quaisquer eventos de um source.ip específico, recomendo adicionar a opção ”size”: 1 às suas consultas para melhorar a velocidade e o desempenho. Isso retornará se o Elasticsearch encontrar um resultado correspondente ao source.ip nas últimas 4 horas.
{
  "size": 1,
  "query": {
    "bool": {
      "must": [],
      "filter": [
        {
          "bool": {
            "should": [
              {
                "match_phrase": {
                  "source.ip": "<<extract_source_ip.source_ip>>"
                }
              }
            ]
          }
        },
        {
          "range": {
            "@timestamp": {
              "format": "strict_date_optional_time",
              "gte": "now-4h",
              "lte": "now"
            }
          }
        }
      ],
      "should": [],
      "must_not": []
    }
  }
}Após cada ação de consulta, temos uma ação de gatilho para verificar se algum resultado foi encontrado. Se o número de hits for maior que zero, usamos a Signals API para fechar o alerta. Se não houver resultados, continuamos o processamento e passamos para a próxima ação. Se todas as ações retornarem zero resultados, enviamos o alerta ao Slack para notificar os analistas para investigação.
Estas são as configurações de exemplo para uma ação de gatilho que verifica se há resultados para uma consulta:
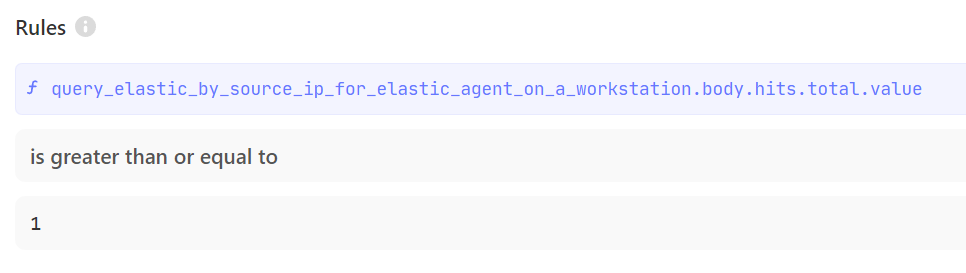
Ao usar a lógica de executar uma consulta do Elasticsearch e, em seguida, fechar o alerta se houver resultados, podemos encadear várias dessas ações para criar histórias abrangentes que fecham alertas provenientes de endereços IP conhecidos como seguros.
Exemplo de triagem de estação de trabalho gerenciada
No exemplo de ramificação de história abaixo, estamos fechando qualquer alerta proveniente de uma estação de trabalho ou servidor que gerenciamos. A Elastic é uma empresa distribuída globalmente e a maioria dos nossos funcionários trabalha de casa, por isso não temos como prever de qual endereço IP eles se conectarão à internet e, em muitos casos, o endereço IP público deles pode mudar várias vezes ao dia. Nossa solução para encontrar de forma confiável os endereços IP públicos dessas estações de trabalho enquanto elas viajam pelo mundo é implantar o Elastic Agent nos proxies nginx que ficam na frente da nossa infraestrutura de segurança da informação.
Usando esses dados, agora podemos identificar conexões bem-sucedidas através do proxy enviando tráfego do Elastic Agent, Auditbeat ou Endgame para nossos clusters. Todos os nossos sistemas de servidor em nuvem têm o Auditbeat ou o Elastic Agent instalado, portanto, essas consultas também detectarão os endereços IP públicos de nossos sistemas de servidor que usam regularmente chaves secretas para executar pipelines de CI/CD e DevOps.
Abaixo está o caminho na história do Tines que usamos para verificar uma estação de trabalho ou servidor gerenciado a partir de um IP de origem. As linhas tracejadas das ações de gatilho representam o caminho que a história percorre se uma ação de gatilho não retornar verdadeiro.
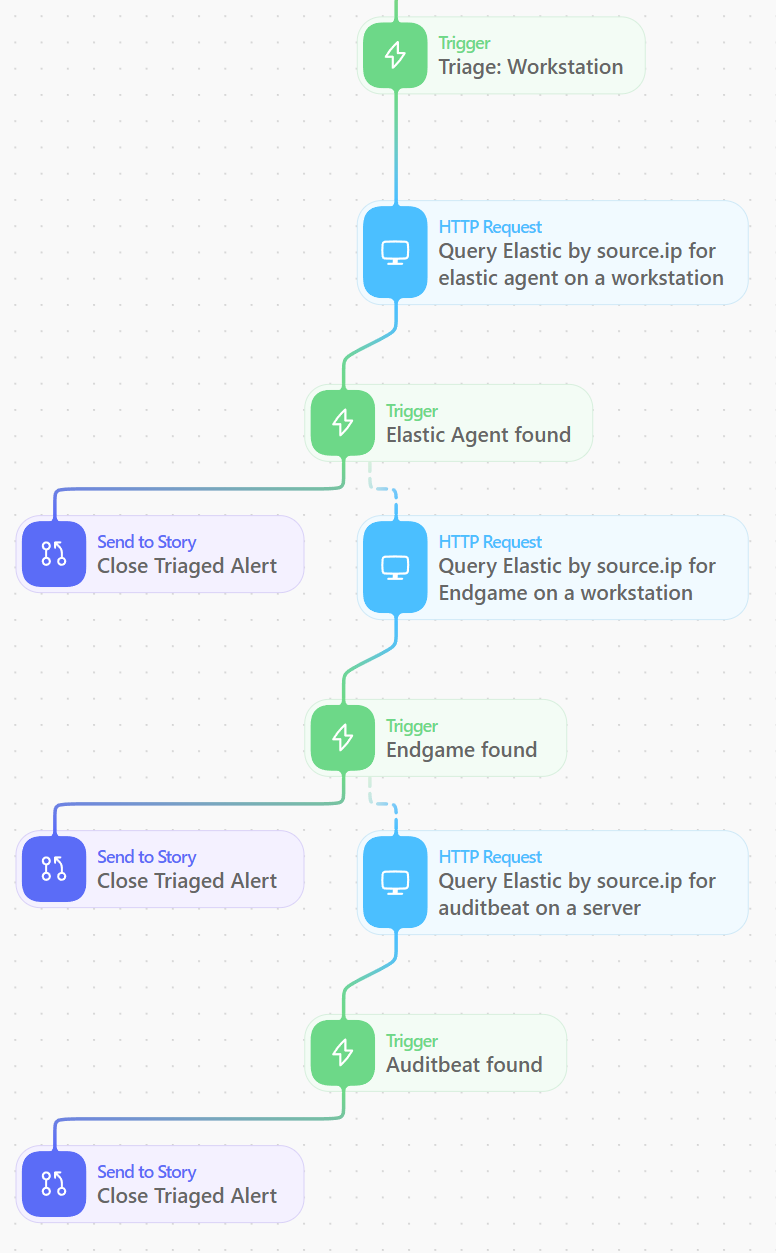
O alerta de fechamento Enviar para Story
Você deve ter notado que, toda vez que queremos fechar o alerta, usamos uma ação Send to Story no Tines. Esta ação enviará os campos que escolhemos para uma nova história no Tines via Webhook, onde então fechamos e marcamos o alerta. Ao usar um Send to Story, mantemos nossa história principal mais fácil de manter e podemos adicionar funcionalidades extras, como a desduplicação pelo ID do sinal, para não tentarmos fechar o mesmo alerta duas vezes a partir de dois ramos diferentes de triagem, e usar uma ação de throttle para não sobrecarregar a API se muitos alertas chegarem de uma só vez.
Também usamos a API de sinais para atualizar as tags de regra, o que pode ser útil para métricas e para rastrear o status dos alertas. Todos os alertas que fechamos com nosso fluxo de trabalho de triagem automatizada também são marcados como Triagem automatizada para que possamos rastrear o número de alertas triados por mês e ver facilmente na UI do SIEM se um alerta foi fechado pela automação ou por um analista.
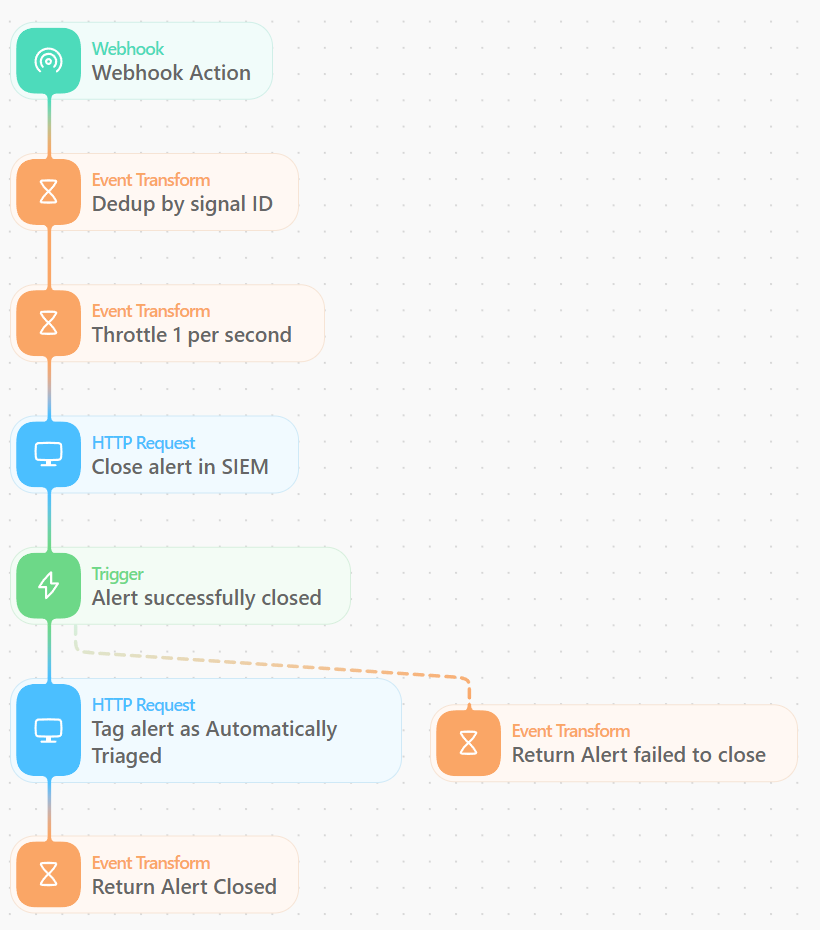
Escalonamento de alertas abertos para o Slack
Como estamos enviando os alertas através dos vários caminhos de triagem automatizados em paralelo, também enviamos a história por um caminho onde pausamos o processamento por 5 minutos. Essa pausa de 5 minutos dá tempo para que os outros ramos concluam e fechem quaisquer alertas que sejam provenientes de um IP de origem confiável. Após a pausa de 5 minutos, enviamos uma solicitação para a API de busca de sinais para verificar se o alerta ainda está aberto. Se o alerta ainda estiver aberto, enviamos uma mensagem para o nosso canal de Slack de alertas para informar aos analistas do SOC que um alerta não foi triado automaticamente.
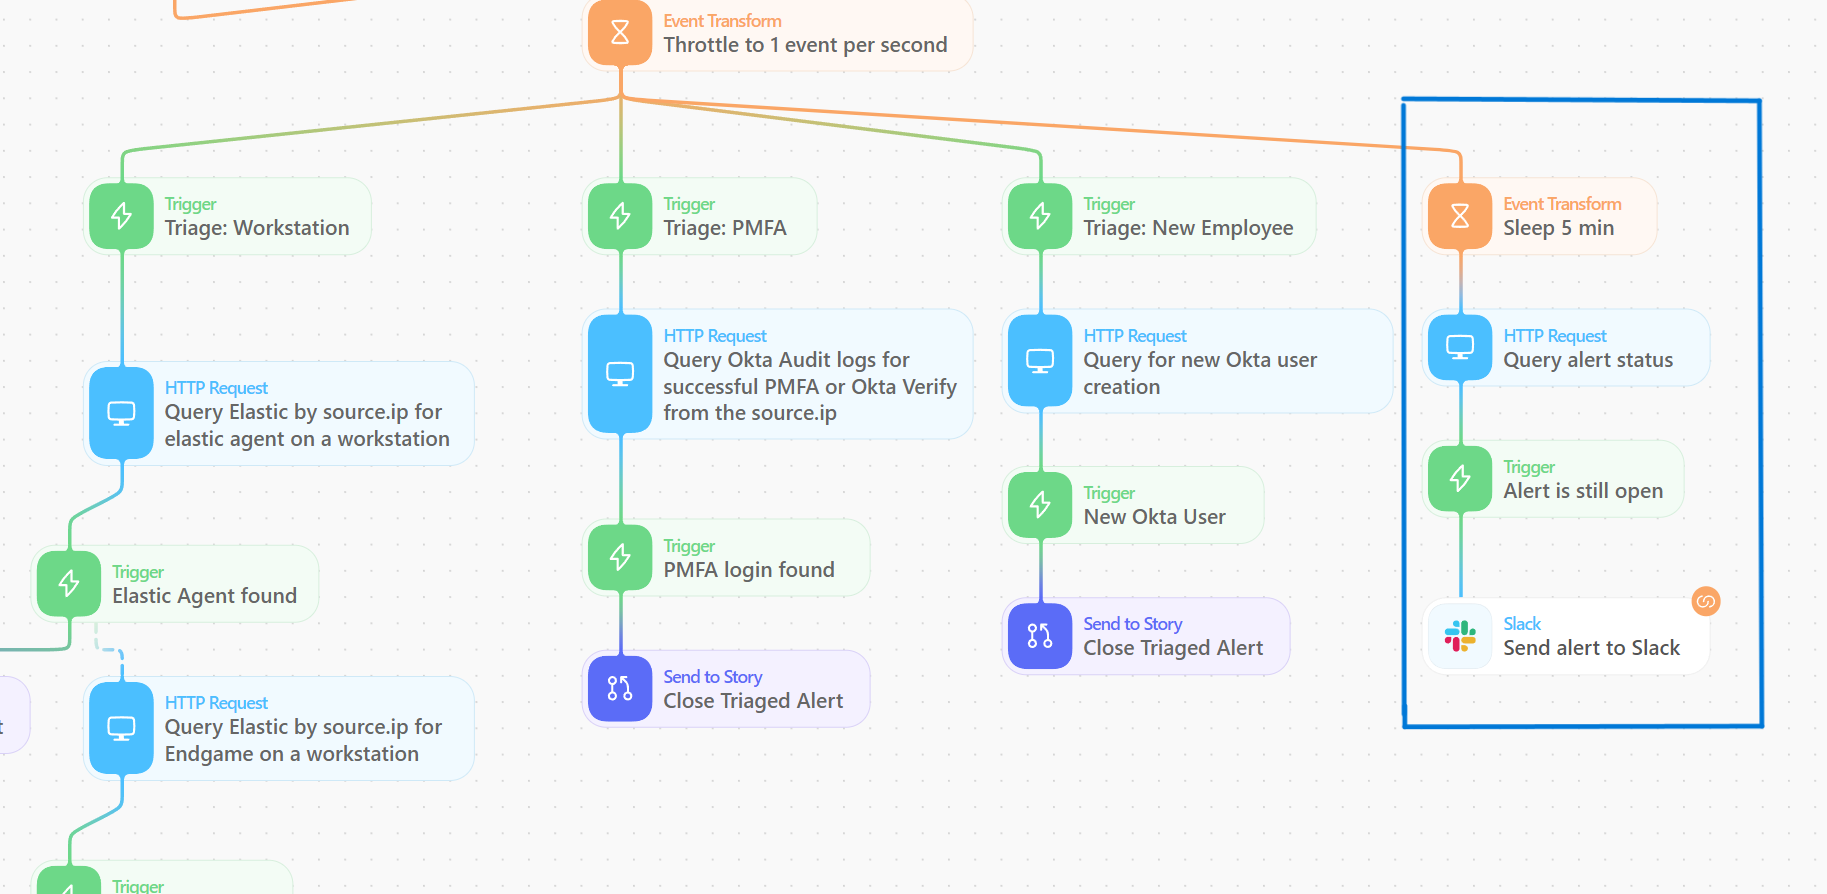
Se você quiser adicionar mais funcionalidade a esta história, o Tines facilita a criação de outra ramificação para a história para adicionar recursos adicionais. Por exemplo, se você tiver um SLA que exija que você reconheça alertas de gravidade crítica ou alta em um determinado período de tempo, você pode adicionar uma lógica para aguardar uma hora e, em seguida, verificar se o alerta foi reconhecido no Elastic SIEM. Se o alerta ainda estiver aberto e não tiver sido atribuído a ninguém, você pode escalar enviando um alerta para o PagerDuty ou uma segunda mensagem do Slack para uma equipe diferente.
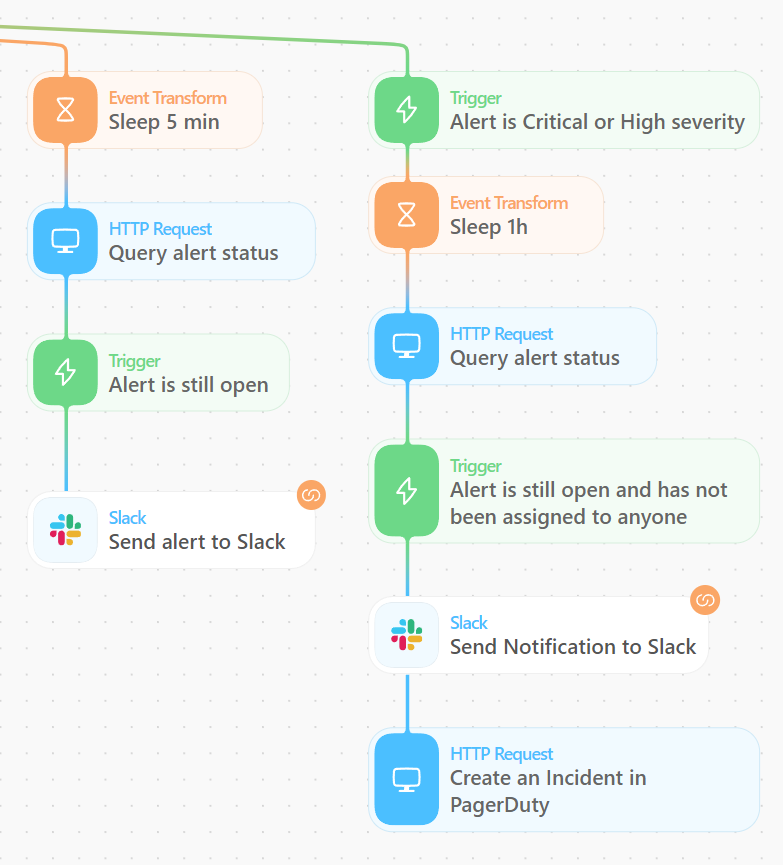
O Tines também inclui modelos para trabalhar com Cases no Elastic Security — com algumas ações extras nesta ramificação, você poderia abrir um novo caso, atribuí-lo ao analista de plantão e adicionar os detalhes do alerta ao caso.
Desafios que encontramos
Nada em segurança é perfeito, e para cada controle de segurança existem maneiras de os agentes de ameaça contorná-los. Mas só porque algo não é perfeito não significa que não valha o esforço. Uma das fraquezas óbvias é que esses alertas têm eficácia limitada para ameaças internas e, se um agente de ameaça estiver se movendo através de uma estação de trabalho, servidor ou conexão VPN corporativa comprometida, eles podem vir de um endereço IP conhecido como seguro e, para regras com fluxos de trabalho de triagem automatizados, os alertas seriam fechados automaticamente.
Tenho dois argumentos para isso: o primeiro é que, sem essa automação, a maioria dessas detecções é impossível de implantar sem centenas de funcionários adicionais. Mesmo com suas fraquezas, essas detecções automatizadas oferecem melhor visibilidade do que sem elas. Os alertas triados podem ser usados para caça a ameaças e incluídos em detecções que alertam sobre múltiplas regras de detecção distintas para um host ou usuário, para que ainda possam agregar valor.
Em segundo lugar, se pudermos forçar os agentes de ameaças a mudar suas táticas — como forçá-los a comprometer e pivotar através de uma de nossas estações de trabalho ou servidores — isso aumenta drasticamente as chances de detecção. Nossas estações de trabalho e servidores são altamente instrumentados com Elastic Defend e contêm mais de mil regras de detecção em vigor. Vimos que, na maioria das vezes, quando um agente de ameaça compromete credenciais SaaS ou um token secreto de API, ele geralmente se conecta ao serviço diretamente de sua própria infraestrutura e não através de um host comprometido.
O outro grande desafio ao construir essas detecções é a TI paralela e todas as interconexões e confianças com terceiros em um sistema de TI moderno. Shadow IT é um termo usado para descrever quando uma equipe da empresa configura seus próprios sistemas de TI sem passar por todos os canais adequados para adicionar os sistemas ao inventário de ativos e instalar o Elastic Agent ou Auditbeat.
Ao criar esses fluxos de trabalho de triagem e definir o que é um “IP conhecido como seguro”, você também encontrará inevitavelmente tokens de API sendo usados de forma autorizada a partir de endereços IP que não pertencem à sua empresa. Esses tokens são geralmente usados para várias automações de terceiros, como o GitHub Actions, ou por aplicativos de verificação, como o Qualys ou o Snyk. Rastrear esses itens e criar as exceções pode levar tempo, mas também pode ser muito valioso à medida que você identifica e remove a Shadow IT.
Em alguns casos, provedores terceirizados como Okta, GitHub ou Elastic Cloud terão seus espaços de IP público publicados para que você possa criar verificações adicionais para filtrar atividades desses IPs. Se você estiver usando um tenant de nuvem do Tines, poderá recuperar o IP público atual do seu tenant em https://<tenant-domain>/info.
Exemplos de detecção
Essas automações começaram originalmente como uma solução para uma única regra de detecção, mas descobrimos que elas são extremamente valiosas para muitos cenários diferentes. Para muitas de suas regras de detecção, você pode se perguntar: "Se este alerta for acionado por um endereço IP que confirmamos pertencer a nós, nosso SOC fecharia o alerta?" Descobrimos que isso é verdade para a maioria das regras de detecção baseadas em comportamento para serviços de terceiros, tornando-as boas candidatas para triagem automatizada.
Aqui está uma lista de algumas das detecções para as quais automatizamos a triagem inicial, para lhe dar algumas ideias de detecções que você pode criar com este fluxo de trabalho. Algumas dessas detecções são detecções personalizadas criadas para funcionar com este fluxo de trabalho de triagem automatizado, mas muitas delas são detecções existentes às quais adicionamos as tags de triagem para eliminar alguns falsos positivos.
Autenticação de alto risco do Okta
Atividade de suporte do Okta a partir de um IP que não é do Okta
Atividade da API do Okta a partir de um novo IP
Okta UEBA: vários alertas diferentes para o mesmo e-mail e IP
Okta: múltiplos endereços de e-mail vistos com um único hash dt
Login de usuário bem-sucedido no Okta sem MFA resistente a phishing
Autenticação Okta por MFA Isentar conta de novo IP
Alto número de tentativas de redefinição de senha ou desbloqueio de usuário Okta
Sessões de usuário do Okta iniciadas a partir de diferentes geolocalizações
Slack UEBA: vários alertas diferentes para um usuário do Slack
Login no portal do GCP a partir de um novo IP
Atividade de IAM do GCP a partir de um novo IP
Atividade web do Buildkite a partir de um novo IP
Atividade da API do Buildkite a partir de um novo IP
GitHub: alerta de UEBA múltiplo para um PAT do GitHub
GitHub: Pico de usuários clonando repositórios privados
Hashicorp Vault: múltiplos alertas de UEBA para um usuário do Vault
Autenticação de alto risco do Azure Active Directory
Login no portal do Azure a partir de um novo IP
Início de sessão do PowerShell no Azure Active Directory a partir de um novo IP
Autenticação de código de dispositivo do Azure Active Directory
Login bem-sucedido no Azure Active Directory sem MFA
Atividade do IAM da AWS a partir de um novo IP
UEBA de chave da AWS: vários alertas diferentes para uma chave da AWS
UEBA de usuário da AWS: vários alertas diferentes para uma conta da AWS
Autenticação no console da AWS a partir de um novo IP
Tentativas de força bruta em uma conta de usuário do Microsoft 365
Erros excessivos de login de Single Sign-On no O365
Pico em eventos de logon bem-sucedidos a partir de um IP de origem
Alcançando novos níveis de proteção
Neste post do blog, mostrei como a equipe de InfoSec da Elastic usa o Tines para automatizar a triagem inicial de muitos de nossos alertas. Essa automação nos permite ter uma visibilidade muito melhor enquanto aumenta a eficiência, e nos permite gastar nosso tempo investigando as ameaças reais. Usando o Tines, conseguimos investigar totalmente e fechar mais de 50.000 alertas nos últimos 30 dias. Cada um desses alertas foi minuciosamente investigado e fechado segundos após ser disparado. Seria impossível ter o mesmo nível de proteção em nossa rede sem isso.
Se você quiser experimentar por conta própria, pode fazer isso gratuitamente com uma avaliação de 14 dias do Elastic Cloud e a edição comunitária sempre gratuita do Tines para ver o quão poderosos esses fluxos de trabalho podem ser para você.
O lançamento e o tempo de amadurecimento de todos os recursos ou funcionalidades descritos neste artigo permanecem a exclusivo critério da Elastic. Os recursos ou funcionalidades não disponíveis no momento poderão não ser entregues ou não chegarem no prazo previsto.
Compartilhar
- Share on Twitter
Compartilhar no Twitter
- Share on LinkedIn
Compartilhar no LinkedIn
- Share on Facebook
Compartilhar no Facebook
- Share by Email
Compartilhar por e-mail
- Print this page
Imprimir