Elastic na Elastic: uma análise aprofundada da nossa arquitetura de SIEM
Elastic na Elastic
A equipe de detecções e analítica de segurança da informação na Elastic é responsável por criar, ajustar e manter as detecções de segurança usadas para proteger todos os sistemas Elastic. Na Elastic, nós nos consideramos o cliente zero e nos esforçamos para usar sempre as versões mais recentes dos nossos produtos.
Nesta série de posts do blog, vamos apresentar uma visão geral da nossa arquitetura, quais dados enviamos para nossos clusters, como e por que usamos a busca entre clusters (CCS) com os aplicativos Security e Machine Learning (ML), e como ajustamos e gerenciamos esses alertas e notificamos os analistas sobre eles.
Visão geral do ambiente de segurança da informação da Elastic
Muitos produtos de segurança cibernética e controles de segurança são desenvolvidos para apoiar uma “rede corporativa” tradicional, com estações de trabalho e servidores em uma rede local, protegida por um firewall. Quando um alerta é acionado e um host precisa ser investigado, você vai pessoalmente até o sistema para despejar a memória e criar uma imagem do disco rígido. Como a Elastic não é uma empresa “tradicional” por princípio, a equipe de segurança da informação precisa ser inovadora e flexível para proteger a Elastic sem tentar forçar a empresa a se encaixar em um molde “em nome da segurança”. Felizmente, o Elastic Stack é a solução perfeita para isso.
A Elastic é uma empresa global que é descentralizada por design, com clientes e funcionários em mais de 80 países ao redor do mundo. A maioria dos nossos funcionários trabalha de modo totalmente remoto, realizando suas tarefas diárias em um notebook da Elastic conectado à internet por meio de redes não confiáveis pelo mundo. Como uma empresa de open source, nosso código-fonte está no GitHub, e nossos sistemas de integração contínua e compilação de software são baseados na nuvem e ficam visíveis publicamente para os colaboradores. Monitorar e investigar com sucesso nessa moderna rede corporativa espalhada exige coletar as informações certas e disponibilizá-las aos analistas em um único local.
Além das nossas estações de trabalho e sistemas corporativos, monitoramos e protegemos o Elastic Cloud, que fornece serviços Elastic SaaS atualmente executando mais de 37.000 clusters da Elastic em mais de 40 regiões de nuvem hospedadas na AWS, GCP, Azure e IBM. Embora o Elastic Cloud seja um ambiente separado com privilégios elevados que é gerenciado pela equipe de nuvem, a equipe de segurança da informação da Elastic é responsável por criar, monitorar e responder a alertas lá também.
Um exame detalhado da infraestrutura de segurança da informação da Elastic
A equipe de engenharia de segurança (SecEng) da área de segurança da informação cria e mantém nosso conjunto de clusters usando o Elastic Cloud no Kubernetes e o Helm para implantar infraestrutura e manter tudo atualizado. A SecEng gerencia sete clusters diferentes: seis clusters de “dados” com funções diferentes e um sétimo cluster de “nó de busca” como nosso sistema de gerenciamento de informações e eventos de segurança (SIEM), que usa CCS para consultar os dados em todos os outros clusters e gerar alertas sobre eles. Usamos as versões de stack mais recentes e candidatos a versão com dados reais. Assim, os desenvolvedores de stack usarão regularmente nossos clusters para encontrar e corrigir problemas e melhorar o Elastic Stack para nossos clientes.
Uma das chaves para monitorar e proteger qualquer organização com sucesso é coletar os dados certos e disponibilizá-los para busca em um único local. Não existe uma única fonte de dados que tenha tudo o que você precisa para segurança da informação. Um desafio comum para muitas organizações é registrar e armazenar os tipos certos de dados, mas manter cada tipo de dado em um local separado. Às vezes, os dados precisam permanecer separados devido a diferentes níveis de confidencialidade ou privacidade. Com frequência, equipes diferentes são proprietárias das fontes de dados e responsáveis por mantê-las. E, ocasionalmente, os custos de transferir os dados para um único local são a causa. Com o poder da CCS, podemos manter os dados armazenados em clusters separados e ainda assim buscar esses dados e gerar alertas sobre eles em uma única interface do Kibana, dando aos analistas uma visão completa.
Com todas as informações visíveis em um único local, os analistas podem criar os ambientes de detecção, inteligência de ameaças e resposta a incidentes no Elastic Stack. Ao investigar um alerta, podemos usar as linhas do tempo no app Security para examinar um alerta consultando um valor em todos os índices. Além das linhas do tempo do app Security, também usamos vários dashboards customizados de “investigação” para exibir rapidamente as informações necessárias de todos os diversos índices.
Cenário de alerta crítico
Imagine um cenário em que recebemos um alerta crítico de que a conta Okta de um funcionário pode ter sido comprometida. Também podemos ver que, no último mês, houve alguns alertas comportamentais de baixo risco relacionados à estação de trabalho desse usuário, que foram inicialmente descartados como falsos alarmes, mas agora precisam ser analisados novamente. Podemos usar o dashboard User Investigation para buscar pelo endereço de e-mail desse usuário e analisar rapidamente todas as atividades de autenticação dele no Okta, os apps acessados usando o logon único do Okta, os arquivos do Google Drive que ele acessou ou alterou, as atividades no GitHub nesse período e os arquivos do o365 acessados enquanto a conta dele pode ter sido comprometida. Um painel do dashboard exibe o inventário do sistema JAMF referente ao notebook de trabalho fornecido a esse usuário, bem como as informações de contato dele.
Com as informações do sistema, podemos acessar o dashboard de investigação de hosts para ver todas as atividades nesse sistema e descobrir se ele também foi comprometido ou se apenas a conta do Okta foi comprometida. O fato de não haver usuários conectados no momento dos alertas indica que o sistema pode estar comprometido e precisa ser isolado. Os eventos do Okta contêm o endereço IP usado para fazer login. Também podemos buscar esse IP para verificar se ele apareceu em algum dos nossos outros conjuntos de dados, como os dos serviços de nuvem, naquele momento.
Investigações como essa podem ser extremamente demoradas se você não tiver todos os eventos disponíveis em um único local. Sem a coleta centralizada dos seus eventos, você precisará fazer login no console de administração de cada um dos serviços hospedados para revisar os logs nos respectivos ambientes.
Busca entre clusters, sem sombra de dúvida
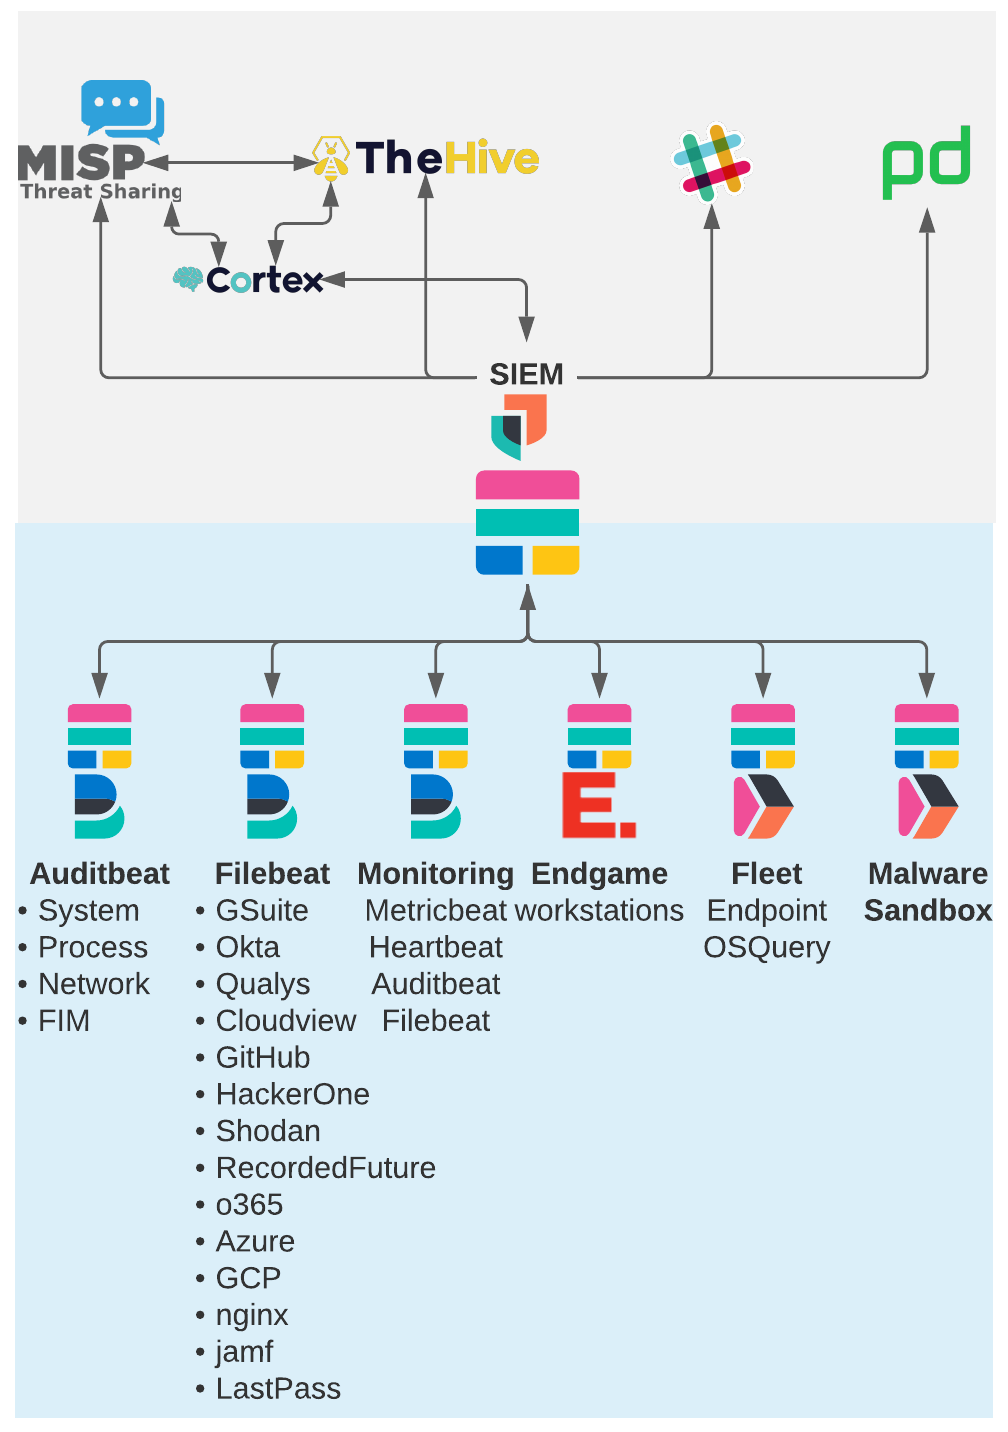
Nosso motivo inicial para usar CCS foi a existência dos clusters com os dados, mas queríamos que todos os nossos dados pudessem ser pesquisados em um único cluster para simplificar o gerenciamento de watchers, dashboards, tarefas de machine learning e regras do mecanismo de detecção. Em vez de migrar todos os dados para um único cluster, decidimos usar CCS. Antes da CCS, tínhamos que manter todos esses objetos e configurações em vários clusters, muitas vezes duplicando o trabalho entre eles.
Ao investigar um alerta, antes precisávamos abrir várias abas do navegador para ver as diversas fontes de dados sobre o evento. Agora, ao investigar, podemos criar um caso e uma linha do tempo no app Security que contém todos os eventos relacionados ao caso. Por exemplo, se aparecer um alerta de atividade incomum em um servidor nos dados do Auditbeat, e o evento tiver um endereço IP, poderemos consultar esse IP em uma linha do tempo em todos os índices e verificar rapidamente se ele apareceu em algum dos nossos outros serviços, como dados do proxy Nginx, Okta, GitHub, logs do provedor de serviços em nuvem, eventos de estação de trabalho do Endgame e muito mais. Graças ao ECS, os campos têm um formato padronizado em todos os padrões de indexação. Uma consulta sobre source.ip retornará documentos de qualquer índice com uma correspondência.
Além desses motivos iniciais, descobrimos muitas outras vantagens dessa configuração. Abaixo estão algumas das diversas vantagens que encontramos ao usar a busca entre clusters para segurança.
- Armazenar diferentes tipos de dados em clusters separados significa que não temos um único ponto de falha para todos os nossos dados. Ao atualizar um cluster, todos os outros clusters estão disponíveis para uso.
- Podemos conceder aos desenvolvedores acesso para testar e solucionar problemas em um cluster de dados específico sem conceder a eles acesso a todos os dados usados pela Infosec.
- Os dados dos clusters de Observability e APM costumam ser muito úteis para os analistas de segurança durante uma investigação. Em vez de duplicar todos os dados, podemos adicionar os clusters remotos à nossa configuração do CCS.
- Os analistas podem receber privilégios elevados para criar e gerenciar alertas e índices no cluster de SIEM, com acesso somente leitura aos dados originais no cluster remoto. Isso permite usar todos os recursos do Kibana e, ao mesmo tempo, proteger a integridade dos dados originais para fins de auditoria e conformidade regulatória.
- A atualização do cluster principal de “nó de busca” da Elastic para uma nova versão dará acesso a todos os novos recursos do Kibana, mesmo que os outros clusters ainda não tenham sido atualizados. Isso reduz bastante a pressão para atualizar seu SIEM de produção de forma precoce e frequente, pois permite testar os recursos mais recentes sem correr o risco de causar uma interrupção nos clusters que contêm os dados reais.
- A partir da versão 7.13, os usuários do Fleet precisam ter privilégios de superusuário no cluster. Podemos manter o número de administradores do Fleet bem pequeno no cluster do Fleet, concedendo a todos os outros usuários privilégios somente leitura para os eventos coletados pelo cluster do Fleet.
Cliente Zero (continuação)
Neste post, apresentamos uma visão geral de como a equipe de Infosec da Elastic usa os muitos recursos do Elastic Stack para coletar dados de diversas fontes e proporcionar aos analistas uma visibilidade incrível dos eventos relacionados à segurança.
Não deixe de voltar para conferir a segunda parte desta série, que vai explorar os tipos de dados pesquisáveis no SIEM da Elastic e como você pode ajudar suas equipes a simplificar e otimizar seus esforços.