Reducción de falsos positivos con investigaciones de SIEM automatizadas de Elastic y Tines

 Share on Twitter
Comparte en Twitter

 Share on LinkedIn
Comparte en LinkedIn

 Share on Facebook
Comparte en Facebook

 Share by Email
Comparte por correo electrónico

 Print this page
Imprime
Uno de los mayores problemas de gestión de SIEM que enfrentan los equipos de SOC es que a menudo se ven abrumados por los falsos positivos, lo que genera fatiga en los analistas y brechas de visibilidad. Además de eso, uno de los desafíos más difíciles en seguridad es detectar cuándo los tokens de acceso SaaS están comprometidos sin aumentar el problema de los falsos positivos.
En Elastic, el equipo de InfoSec aborda ambos problemas automatizando las investigaciones de alertas de SIEM con herramientas como Tines. Esta publicación de blog comparte cómo hemos optimizado nuestros flujos de trabajo, reducido los falsos positivos y capacitado a nuestros analistas para centrarse en amenazas reales.
Automatización de la investigación inicial de alertas SIEM
En una publicación de blog anterior, escribimos sobre cómo el equipo de InfoSec de Elastic creó paquetes de reglas que detectaban analíticas de comportamiento de usuario y entidad (UEBA). A medida que expandimos estos paquetes de alertas para incluir más fuentes de datos, descubrimos que estábamos sobrecargando a los analistas del SOC con un alto nivel de falsos positivos causados por actividad anómala pero benigna; por ejemplo, actividad de tokens de API que solo ocurría una vez al mes o desde un escáner conocido. Esto nos llevó a un problema en el que debíamos decidir si crear una regla de detección que pudiera ser ruidosa debido a los falsos positivos, o aceptar que habría una brecha de visibilidad por no tener esa detección. Una detección ruidosa que tiene muchos falsos positivos crea su propio tipo de brecha de visibilidad debido a la fatiga del analista. Pero este problema generó una nueva idea: ¿qué pasaría si pudiéramos automatizar la investigación inicial de una alerta, cerrando los falsos positivos conocidos y escalando aquellos que no podemos cerrar?
Descubrimos que para muchas de nuestras reglas de detección de proveedores SaaS y UEBA, podíamos cerrar la regla si la actividad provenía de un dispositivo de confianza, como una de nuestras estaciones de trabajo administradas. La acción del playbook de investigación inicial en muchos casos es usar una pieza de información de la alerta original, como la source.ip, y luego realizar una búsqueda en otros patrones de índice en Elasticsearch para esa source.ip. Si hay algún resultado para la búsqueda, la alerta puede cerrarse como un falso positivo. Por ejemplo, si ves una alerta de UEBA por actividad de AWS Secret Key, ejecutaríamos el siguiente grupo de búsquedas para clasificar la alerta y ver si la actividad proviene de un dispositivo de confianza:
¿Hay logs de proxy que muestren que el Elastic Agent se conecta correctamente a nuestro servidor de Fleet desde una estación de trabajo o servidor con esa source.ip?
¿Esa source.ip pertenece al rango de IP pública de una de las zonas de red de AWS, GCP o Azure que gestionamos y controlamos?
¿La source.ip pertenece a una aplicación de terceros autorizada como Okta, Terraform, Tines, Qualys o Snyk?
¿Ha habido algún inicio de sesión único (SSO) FIDO2 exitoso desde esa source.ip en las últimas 2 horas?
Si alguna de estas búsquedas de seguimiento de Elasticsearch devuelve resultados, podemos asumir que esta actividad de la clave de API de AWS probablemente esté autorizada y podemos cerrar la alerta. Si todas estas búsquedas devuelven cero resultados, creemos que la actividad es sospechosa, por lo que la escalamos a un miembro del equipo SOC para una investigación adicional. Todas las búsquedas de Elasticsearch anteriores se pueden completar usando la API _search, y podemos usar la Signals API para cerrar y etiquetar las alertas, lo que nos permite automatizar todo el proceso.
Al enviar nuestras detecciones de SIEM desde Elastic a un sistema de orquestación, automatización y respuesta de seguridad (SOAR) mediante la característica Alert Actions, podemos usar nuestro SOAR para ejecutar automáticamente estas búsquedas de investigación para cada alerta aplicable. Según los resultados de las búsquedas, podemos cerrar automáticamente la alerta o escalarla a un analista.
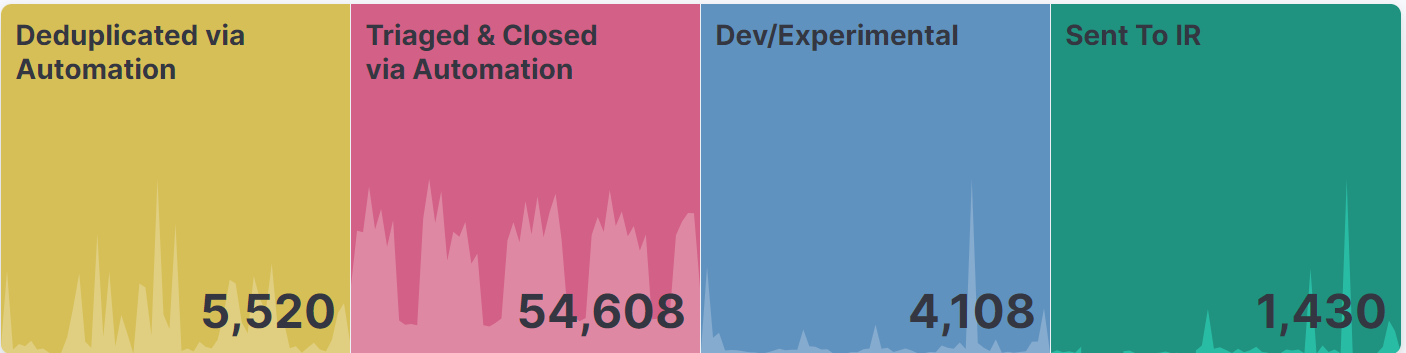
Esta capacidad de clasificación automatizada nos permite crear clases completas de detecciones que normalmente serían demasiado ruidosas para investigar sin un aumento drástico en el número de personal del SOC. Nuestro flujo de trabajo automatizado actualmente clasifica y cierra más de 3 000 alertas por día sin ninguna interacción humana. A un analista experimentado le tomaría más de 15 minutos por alerta realizar la clasificación de la misma manera. Si quisiéramos tener las mismas detecciones sin esta automatización, necesitaríamos 94 empleados adicionales a tiempo completo. Este gráfico muestra nuestros números de los últimos 30 días de alertas en nuestro SIEM:
Este flujo de trabajo de clasificación automatizado podría crearse usando scripts personalizados, pero esta publicación de blog te mostrará cómo crear esta automatización con Tines. Hemos decidido explorarlo de esta manera porque es lo que usa el equipo de InfoSec de Elastic y, sencillamente, es más fácil que usar scripts. Hemos descubierto que Tines facilita la creación y modificación de automatizaciones sin necesidad de tener un equipo de desarrollo dedicado.
Envío de las alertas a cualquier SOAR
Como se mencionó anteriormente, el primer paso es extraer el contenido de la alerta de Elastic Security y llevarlo a la solución SOAR de tu elección. Para hacer esto, usamos la característica Alert Actions en Elastic Security, la cual realizará una acción personalizada cada vez que se active una alerta.
Al configurar una regla de detección, hay una opción para agregar una acción de regla. Desde aquí puedes seleccionar el tipo de conector deseado.
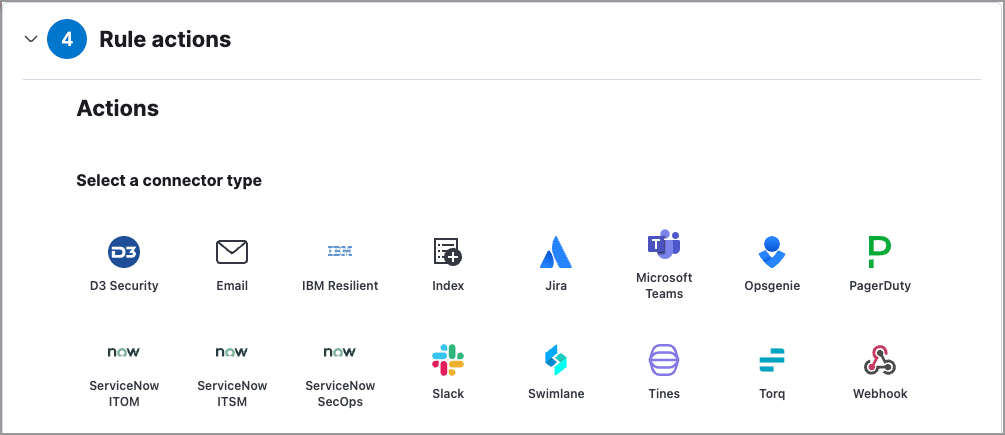
La forma más sencilla de enviar tus alertas a Tines es configurar y usar el conector de Tines integrado en Elastic, que envía tus alertas a una historia de Tines para su procesamiento.
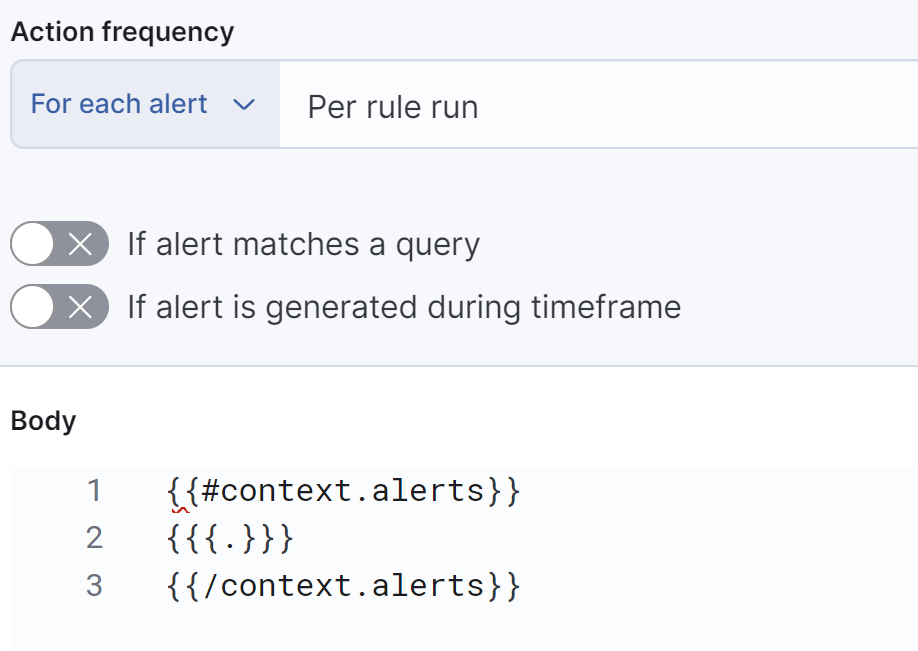
La otra opción es usar el conector Webhook, que es muy flexible porque te permite enviar una parte de la alerta o el contenido completo de la misma en formato ndjson a un Webhook de escucha. Hemos estado usando Tines internamente en Elastic desde antes de que existiera el conector de Tines, por lo que la mayoría de nuestras automatizaciones todavía usan el conector Webhook. Puedes enviar las alertas una por una al Webhook o todas juntas en un solo ndjson. Si estás usando scripts personalizados, puedes usar este conector para recibir y procesar las alertas, y también funciona con la acción Webhook de Tines. Para enviar el contenido completo de la alerta a un Webhook, deberás configurar un conector Webhook para usar una acción POST con el tipo de contenido establecido en application/x-ndjson; charset=utf-8.
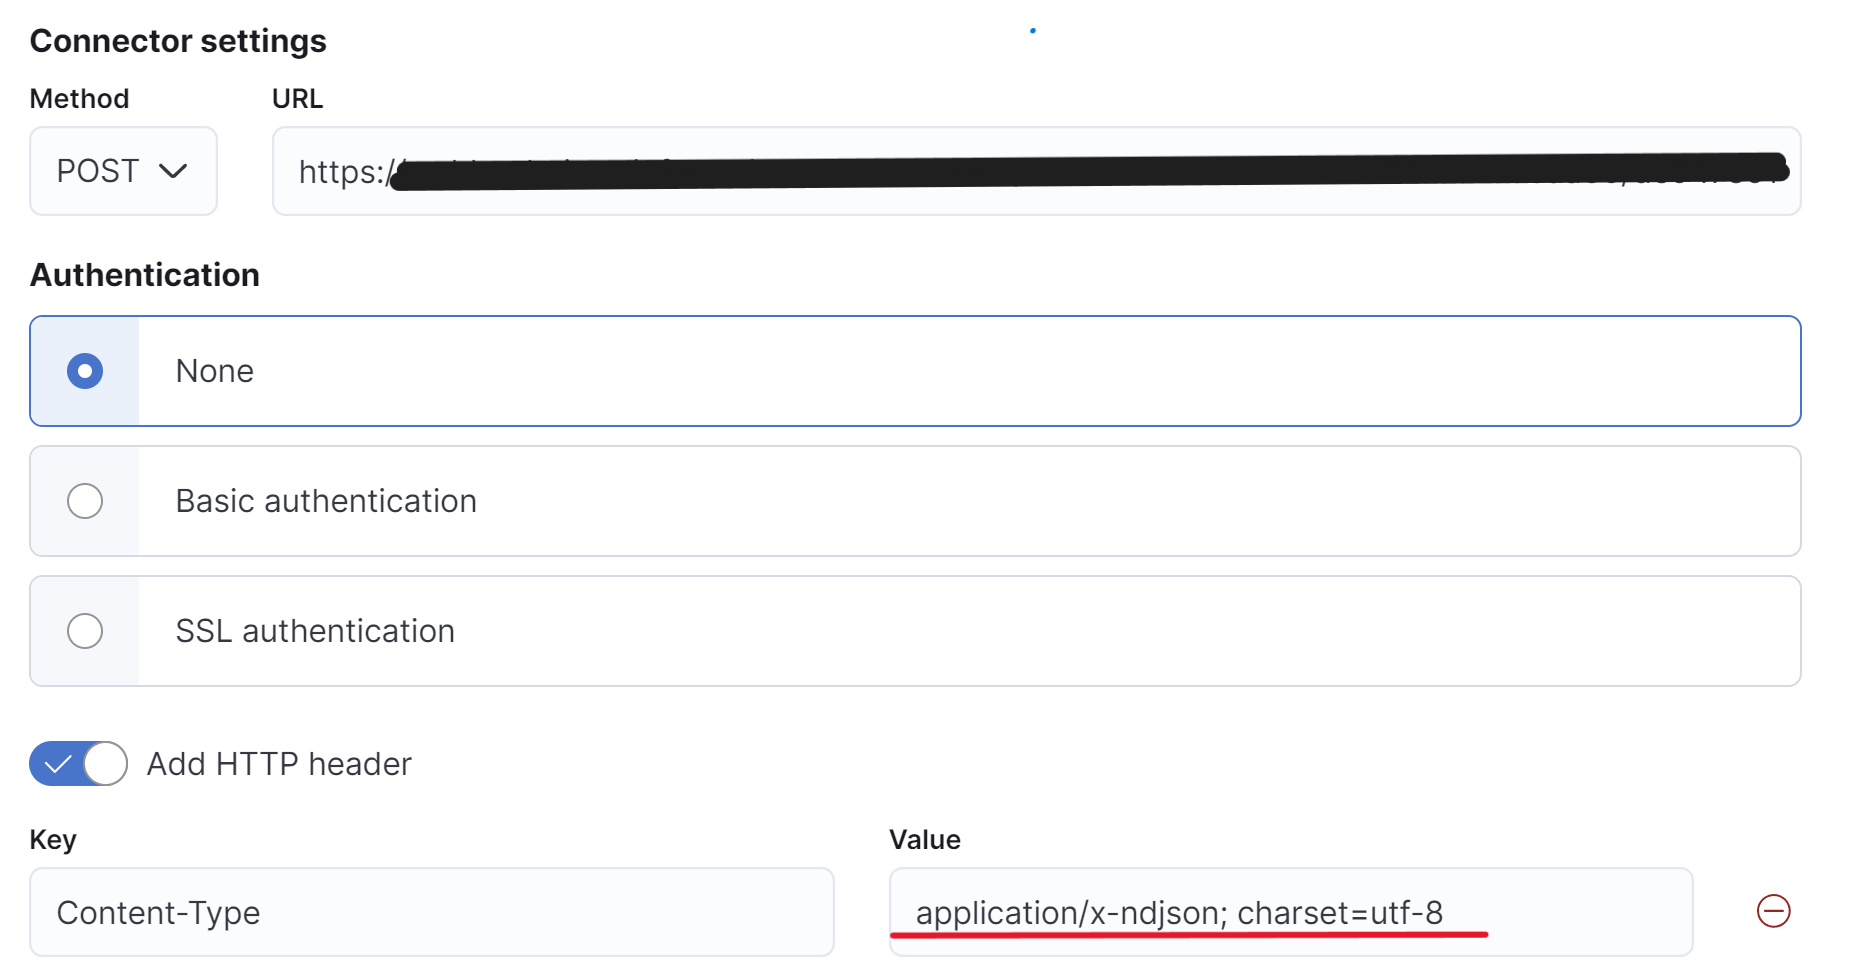
Al agregar las acciones a tus reglas, selecciona el conector Webhook configurado y usa la siguiente sintaxis mustache en tu configuración para enviar la alerta completa como un ndjson al Webhook.
Uso de etiquetas para enrutar la automatización
Al crear estas automatizaciones, comenzamos construyendo una ruta de automatización personalizada para cada alerta individualmente, pero descubrimos muy rápido que esto no escala. Nuestra solución para esto fue usar etiquetas personalizadas en nuestras reglas de detección para dirigir la regla a la ruta de clasificación adecuada. Enviamos la alerta completa a Tines, la cual incluye las etiquetas como una matriz en el campo signal.rule.tags. Decidimos usar una convención de nombres de Triage:{option} para describir qué comprobaciones automatizadas se realizarán en una regla. Las reglas de detección pueden tener múltiples etiquetas diferentes.
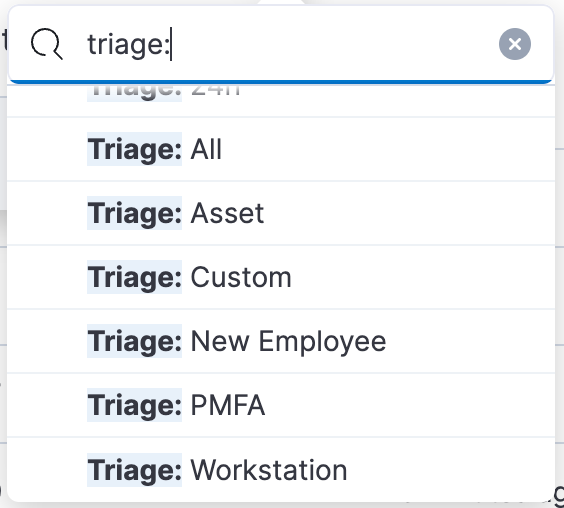
Aquí hay una descripción de las etiquetas de clasificación automatizada que estamos usando:
Clasificación: Todo enrutará la alerta a través de las rutas de clasificación automatizada de activos, PMFA y estaciones de trabajo, y si alguna búsqueda devuelve verdadero, la alerta se cierra. Si ninguna de las búsquedas devuelve verdadero, la alerta se escala.
Triaje: Activo comprobará varios patrones de índice para determinar si la IP de origen proviene de un activo que Elastic posee o gestiona de alguna manera. Esto incluye nuestra base de datos de activos interna que almacenamos en Elastic, zonas de red internas, nuestras IP públicas de Elastic Cloud, sistemas CI/CD y el espacio de IP público de sistemas de terceros autorizados como Okta o Tines.
Clasificación: PMFA buscará en nuestros logs de auditoría de Okta una autenticación exitosa mediante MFA resistente al phishing, como una passkey que use Okta Verify o Windows Hello. Usamos la integración de Okta para recopilar nuestros logs de auditoría de Okta.
Triaje: estación de trabajo verificará nuestros logs de proxy de Nginx en busca de conexiones exitosas desde Elastic Defend a nuestro servidor de Fleet desde la dirección IP. Elastic es una empresa distribuida y los empleados pueden trabajar desde cualquier parte del mundo, pero sus agentes de Elastic Defend se conectan regularmente, por lo que generalmente podemos ver que la estación de trabajo administrada de un empleado de Elastic estaba conectada desde la misma IP que generó la alerta.
Clasificación: nuevo empleado verificará nuestra base de datos de activos, que contiene un reporte diario de todos los empleados exportado desde nuestro sistema de RR. HH. para ver si el usuario es un nuevo empleado. Esto es importante para ciertas categorías de reglas de detección, como Slack UEBA, que suelen activarse cuando un nuevo empleado está configurando sus cuentas, pero rara vez alertan sobre empleados existentes.
Triaje: 1h dará instrucciones a Tines para pausar el triaje de alertas durante 1 hora antes de realizar el resto de las acciones de triaje. Esto puede ser útil para eventos como un usuario que configura una estación de trabajo nueva, donde la alerta puede cerrarse si la estación de trabajo está correctamente inscrita y registrada en nuestros sistemas de gestión de endpoint que instalan Elastic Defend.
Clasificación: 24h dará instrucciones a Tines para pausar la clasificación de alertas durante 24 horas completas antes de procesarlas. Esto puede ser necesario para algunas rutas de clasificación donde los datos solo se actualizan diariamente, como partes de nuestra base de datos de activos que recopilan un inventario diario de todas las computadoras, usuarios y cuentas cloud.
Clasificación: personalizada es para cualquier ruta de clasificación personalizada que pueda ser necesaria para una alerta. Un buen ejemplo de esto es un escenario en el que proporcionamos a un tercero, como Okta, una clave de API con privilegios elevados utilizada para crear o deshabilitar cuentas en Azure, y queremos recibir una alerta si ese token de API se utiliza desde una dirección IP que no pertenece a Okta. Esta alerta y clasificación automatizada nos permite "confiar, pero verificar" en caso de que el almacenamiento de nuestra clave de API en Okta se vea comprometido y se utilice fuera de los espacios IP de Okta.
Bloques de construcción para la automatización
Ahora que enviamos la alerta completa como JSON a nuestro SOAR, podemos enviarla a través de nuestra ruta de clasificación y luego a otras fuentes como Slack o PagerDuty. En Tines, hay siete tipos diferentes de acciones que se pueden usar para crear tus historias:
La acción Webhook emitirá los eventos que recibe a través de webhooks (devoluciones de llamada HTTP). Este es el método principal para enviar eventos a una historia en Tines.
La acción Send Email (Enviar correo electrónico) envía correos electrónicos a los destinatarios especificados en las opciones de la acción.
La acción Receive Email, conocida formalmente como IMAP Action, emite eventos cuando detecta correos electrónicos nuevos en un servidor IMAP o cuando se envían correos electrónicos a una dirección generada de forma única.
Acción de transformación de eventos tiene varios modos que modifican el contenido de los eventos recibidos. Estas acciones son extremadamente flexibles y potentes.
La acción de solicitud HTTP envía solicitudes HTTP utilizando una variedad de métodos a una URL especificada.
La acción Trigger (desencadenador) compara el contenido de un campo de un evento entrante con reglas predefinidas y, cuando las reglas coinciden, se desencadena una emisión de evento. Esto puede considerarse como una acción lógica de tipo “si... entonces” (If Then).
La acción Send to Story envía eventos a otra story de Tines (la sub-story). Después de que la sub-story haya completado su acción, la acción Send to Story emitirá un evento. Las acciones Send to Story son similares a las funciones o bibliotecas en el código donde quieres reutilizar acciones en múltiples lugares.
Usando estas acciones, podemos crear automatizaciones que nos ahorran miles de horas de trabajo al mes.
Ejemplo de flujo de trabajo de clasificación automatizado simplificado:
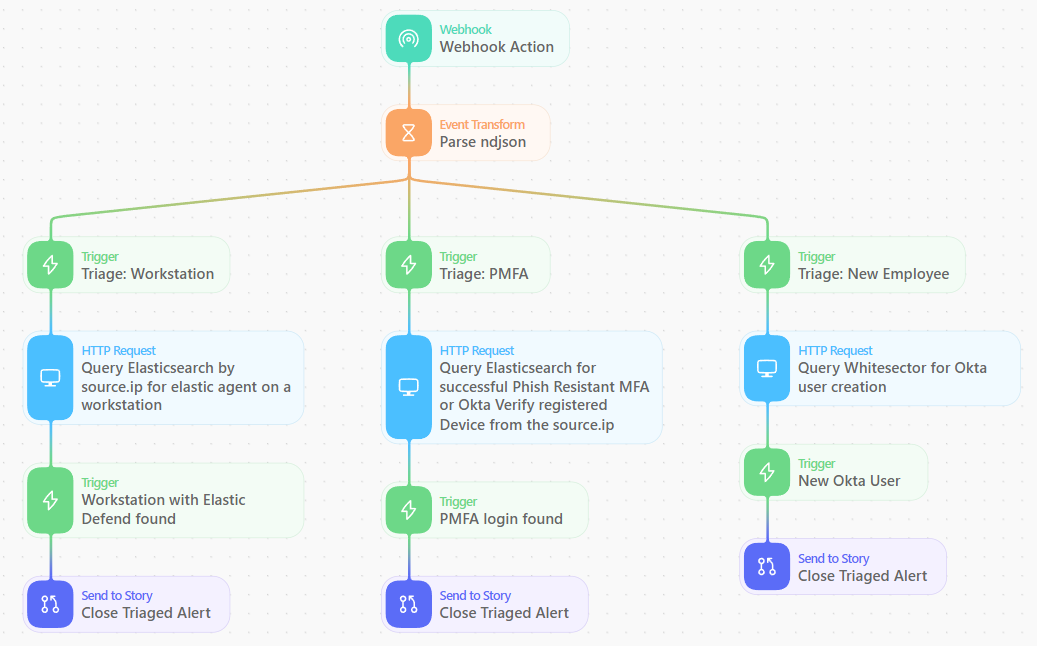
En esta historia de automatización, procesamos nuevas alertas a medida que llegan al Webhook, usamos una acción de transformación de eventos para parsear el ndjson en un objeto al que podamos hacer referencia más fácilmente y, luego, usamos acciones de activación para determinar qué rutas de clasificación debe seguir la alerta.
La mayoría de las acciones de solicitud HTTP son consultas a la API _search de Elasticsearch. En estas consultas de seguimiento, utilizamos campos de la alerta original, como source.ip o user.email, para clasificar las alertas.
Tines viene con cientos de plantillas de acción preconstruidas, incluidas varias para interactuar con Elasticsearch. Puedes usar la plantilla “Query an Elasticsearch index for all records” y luego modificar el payload para añadir tu búsqueda usando la IP de origen de la alerta. Debido a que la mayoría de las búsquedas buscan cualquier evento de una source.ip específica, recomiendo añadir la opción ”size”: 1 a tus búsquedas para mejorar la velocidad y el rendimiento. Esto devolverá si Elasticsearch encuentra un resultado que coincida con la source.ip en las últimas 4 horas.
{
  "size": 1,
  "query": {
    "bool": {
      "must": [],
      "filter": [
        {
          "bool": {
            "should": [
              {
                "match_phrase": {
                  "source.ip": "<<extract_source_ip.source_ip>>"
                }
              }
            ]
          }
        },
        {
          "range": {
            "@timestamp": {
              "format": "strict_date_optional_time",
              "gte": "now-4h",
              "lte": "now"
            }
          }
        }
      ],
      "should": [],
      "must_not": []
    }
  }
}Después de cada acción de búsqueda, tenemos una acción de activación para comprobar si se encontraron resultados. Si el número de coincidencias es mayor que cero, usamos la API de Signals para cerrar la alerta. Si hay cero resultados, continuamos con el procesamiento y pasamos a la siguiente acción. Si todas las acciones devuelven cero resultados, enviamos la alerta a Slack para notificar a los analistas para su investigación.
Estos son los ajustes de ejemplo para una acción de activador que comprueba si hay resultados para una búsqueda:
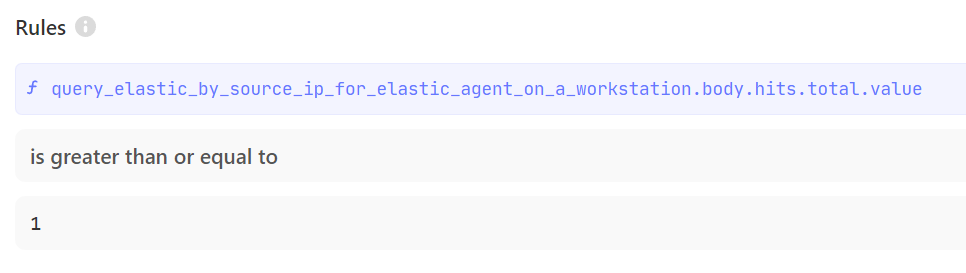
Al usar la lógica de ejecutar una búsqueda de Elasticsearch y luego cerrar la alerta si hay resultados, podemos encadenar varias de estas acciones para crear historias integrales que cierren las alertas provenientes de direcciones IP conocidas como seguras.
Ejemplo de clasificación de estaciones de trabajo gestionadas
En la rama de historia de ejemplo a continuación, estamos cerrando cualquier alerta que provenga de una estación de trabajo o servidor que administramos. Elastic es una empresa distribuida globalmente y la mayoría de nuestros empleados trabaja desde casa, por lo que no tenemos forma de predecir desde qué dirección IP se conectarán a Internet y, en muchos casos, su dirección IP pública puede cambiar varias veces al día. Nuestra solución para encontrar de forma fiable las IP públicas de estas estaciones de trabajo a medida que viajan por todo el mundo es desplegar Elastic Agent en los proxies nginx que se encuentran frente a nuestra infraestructura de InfoSec.
Usando estos datos, ahora podemos identificar conexiones exitosas a través del proxy que envía tráfico de Elastic Agent, Auditbeat o Endgame a nuestros clusters. Todos nuestros sistemas de servidores en el cloud tienen instalado Auditbeat o Elastic Agent, por lo que estas búsquedas también detectarán las direcciones IP públicas de nuestros sistemas de servidores que usan regularmente claves secretas para ejecutar pipelines de CI/CD y DevOps.
A continuación se muestra la ruta en la historia de Tines que utilizamos para comprobar si hay una estación de trabajo o un servidor gestionado a partir de una IP de origen. Las líneas discontinuas de las acciones de desencadenamiento (Trigger actions) son la ruta por la que fluye la historia si una acción de desencadenamiento no devuelve un valor verdadero.
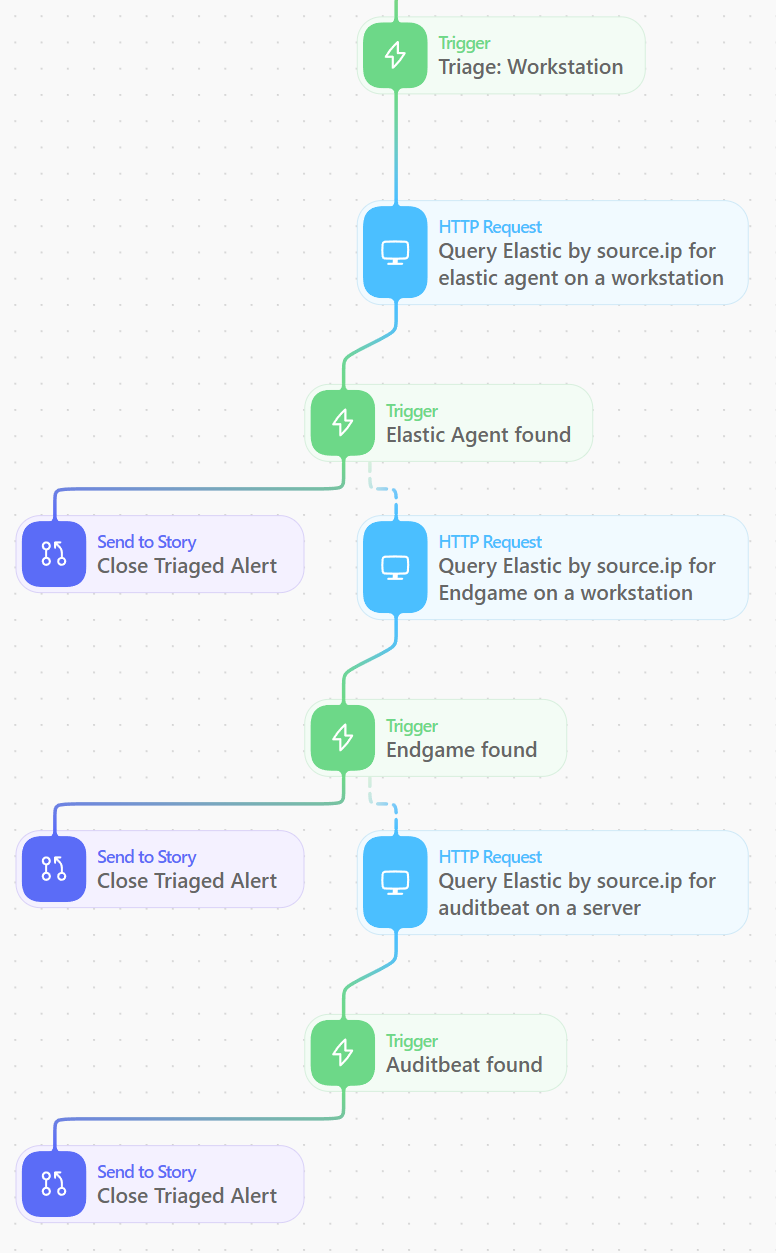
La alerta de cierre Enviar a Story
Es posible que hayas notado que cada vez que queremos cerrar la alerta usamos una acción Send to Story en Tines. Esta acción enviará los campos que elegimos a una nueva historia en Tines a través de un Webhook, donde luego cerramos y etiquetamos la alerta. Al usar un Send to Story, mantenemos nuestra historia principal más fácil de mantener y podemos agregar funcionalidad adicional, como la deduplicación por ID de señal para no intentar cerrar la misma alerta dos veces desde dos ramas diferentes de clasificación, y usar una acción de limitación (throttle) para no saturar la API si llegan muchas alertas a la vez.
También usamos la API de Signals para actualizar las etiquetas de reglas, lo cual puede ser útil para métricas y para realizar el seguimiento del estado de las alertas. Todas las alertas que cerramos con nuestro flujo de trabajo de clasificación automatizada también se etiquetan como Clasificación automatizada para que podamos realizar el seguimiento del número de alertas clasificadas por mes y ver fácilmente en la UI de SIEM si una alerta fue cerrada por la automatización o por un analista.
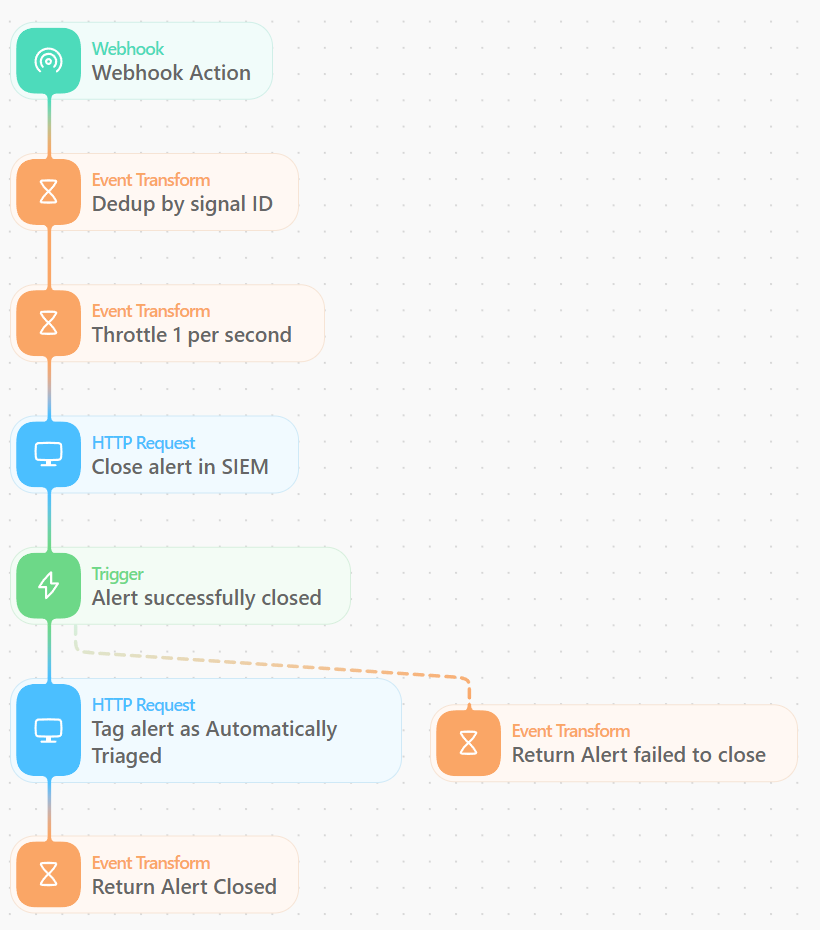
Escalar alertas abiertas a Slack
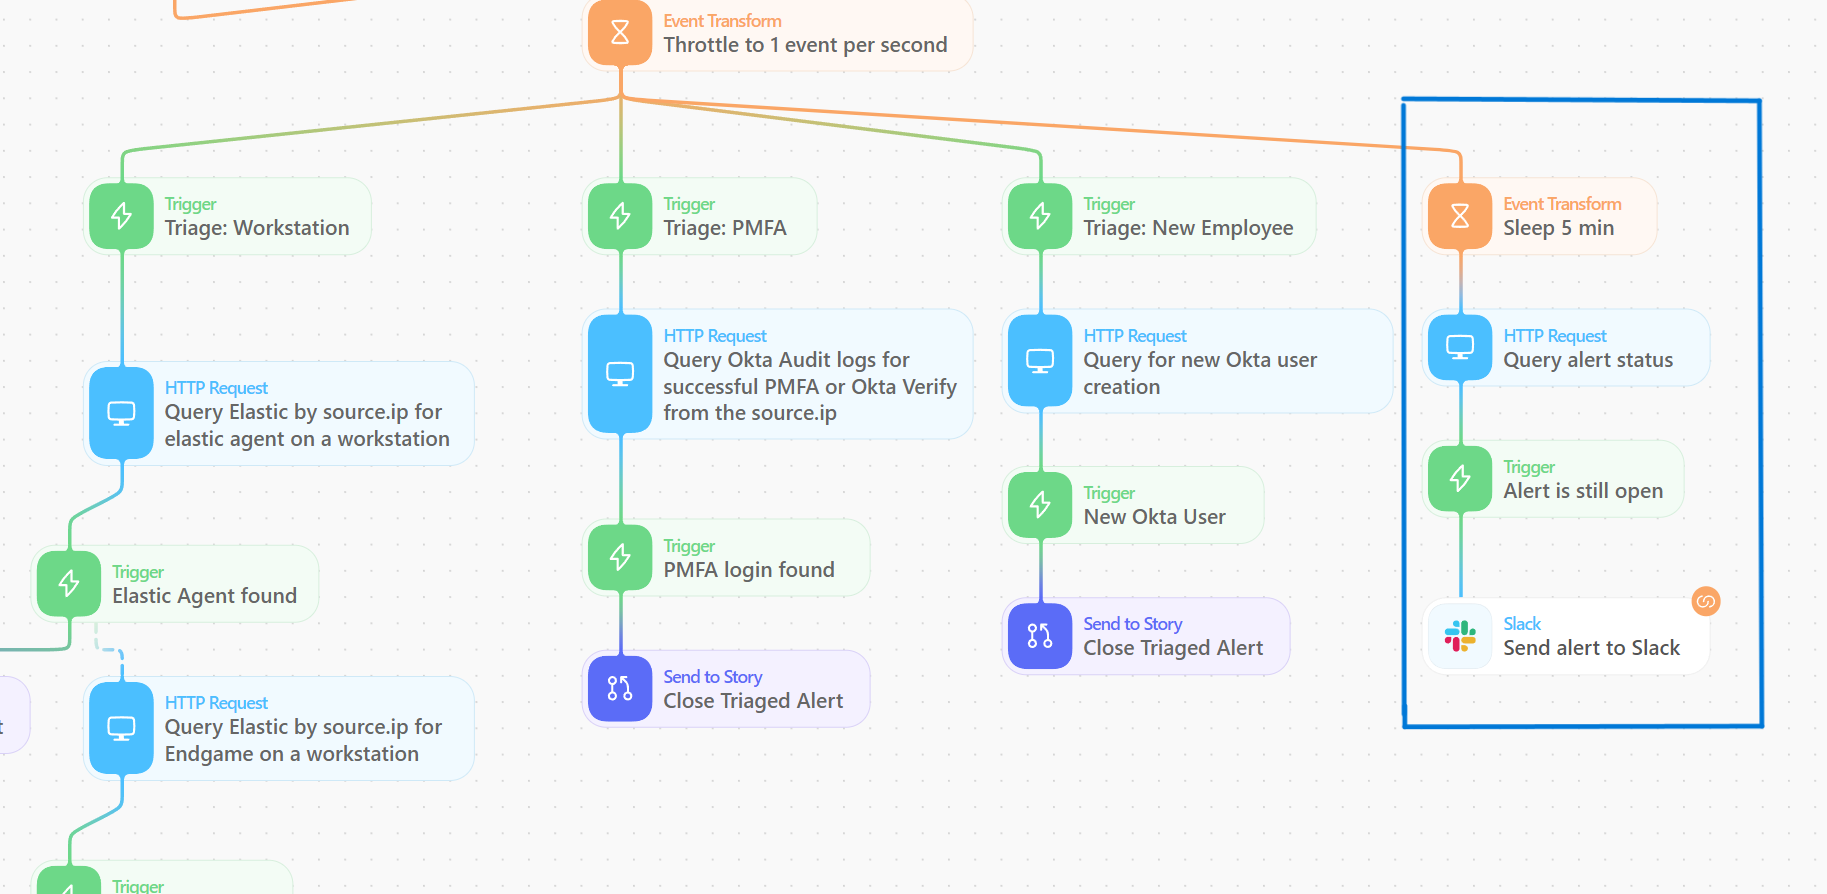
Como enviamos las alertas a través de las diversas rutas de triaje automatizado en paralelo, también enviamos la historia por una ruta donde pausamos el procesamiento durante 5 minutos. Esta pausa de 5 minutos permite que las otras ramas tengan tiempo para completar y cerrar cualquier alerta que provenga de una IP de origen confiable. Después de la pausa de 5 minutos, enviamos una solicitud a la API de búsqueda de señales para verificar si la alerta sigue abierta. Si la alerta sigue abierta, enviamos un mensaje a nuestro canal de Slack de alertas para informar a los analistas del SOC que una alerta no fue triada automáticamente.
Si deseas agregar más funcionalidad a esta historia, Tines facilita la creación de otra rama en la historia para añadir capacidades adicionales. Por ejemplo, si tienes un SLA que requiere que reconozcas alertas de gravedad crítica o alta en un tiempo determinado, podrías agregar lógica para esperar una hora y luego verificar si la alerta ha sido reconocida en el Elastic SIEM. Si la alerta sigue abierta y no se ha asignado a nadie, puedes escalar enviando una alerta a PagerDuty o un segundo mensaje de Slack a un equipo diferente.
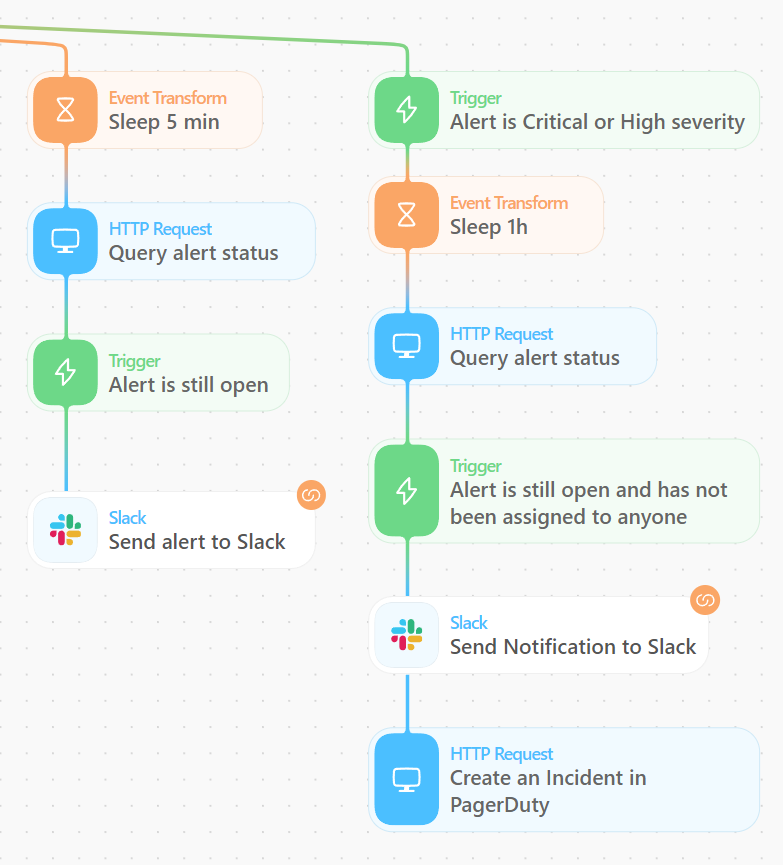
Tines también incluye plantillas para trabajar con Casos en Elastic Security — con un par de acciones adicionales en esta rama, podrías abrir un caso nuevo, asignárselo al analista de guardia y agregar los detalles de la alerta al caso.
Desafíos que hemos encontrado
Nada en seguridad es perfecto y, para cada control de seguridad, existen formas en las que los actores de amenazas pueden evitarlos. Pero el hecho de que algo no sea perfecto no significa que no valga la pena el esfuerzo. Una de las debilidades obvias es que estas alertas tienen una eficacia limitada para las amenazas internas y, si un actor de amenazas se mueve a través de una estación de trabajo, un servidor o una conexión VPN corporativa comprometidos, pueden provenir de una dirección IP conocida como segura y, para las reglas con flujos de trabajo de clasificación automatizados, las alertas se cerrarían automáticamente.
Tengo dos argumentos para eso: el primero es que sin esta automatización, la mayoría de estas detecciones son imposibles de desplegar sin cientos de empleados adicionales. Incluso con sus debilidades, estas detecciones automatizadas proporcionan una mejor visibilidad que sin ellas. Las alertas clasificadas pueden utilizarse para la búsqueda de amenazas e incluirse en detecciones que alertan sobre múltiples reglas de detección distintas para un host o usuario para que aún puedan proporcionar valor.
En segundo lugar, si podemos obligar a los actores de amenazas a cambiar sus tácticas (como obligarlos a comprometer y pivotar a través de una de nuestras estaciones de trabajo o servidores), eso aumenta drásticamente las posibilidades de detección. Nuestras estaciones de trabajo y servidores están altamente instrumentados con Elastic Defend y contienen más de mil reglas de detección implementadas. Hemos visto que la mayoría de las veces, cuando un actor de amenazas compromete credenciales SaaS o un token secreto de API, generalmente se conectan al servicio directamente desde su propia infraestructura y no a través de un host comprometido.
El otro gran desafío al crear estas detecciones es la Shadow IT y todas las interconexiones y confianzas con terceros en un sistema de TI moderno. Shadow IT es un término utilizado para describir cuando un equipo de la empresa configura sus propios sistemas de TI sin pasar por todos los canales adecuados para agregar los sistemas al inventario de activos e instalar Elastic Agent o Auditbeat.
Cuando creas estos flujos de trabajo de clasificación y defines qué es una "dirección IP conocida como buena", inevitablemente también encontrarás que hay tokens de API que se usan de forma autorizada desde direcciones IP que no pertenecen a tu empresa. Estos tokens suelen usarse para diversas automatizaciones de terceros, como GitHub Actions, o mediante aplicaciones de escaneo como Qualys o Snyk. Localizarlas y crear las excepciones puede llevar tiempo, pero también puede ser muy valioso a medida que identificas y eliminas la Shadow IT.
En algunos casos, los proveedores externos como Okta, GitHub o Elastic Cloud tendrán publicados sus espacios de IP públicos para que puedas crear comprobaciones adicionales para filtrar la actividad de esas IP. Si usas un inquilino cloud de Tines, puedes recuperar la IP pública actual de tu inquilino desde https://<tenant-domain>/info.
Ejemplos de detección
Estas automatizaciones comenzaron originalmente como una solución para una sola regla de detección, pero hemos descubierto que son extremadamente valiosas para muchos escenarios diferentes. Para muchas de tus reglas de detección, puedes preguntarte: “Si esta alerta se activa mediante una dirección IP que confirmamos que nos pertenece, ¿nuestro SOC cerraría la alerta?” Hemos descubierto que esto es cierto para la mayoría de las reglas de detección basadas en el comportamiento para servicios de terceros, lo que los convierte en buenos candidatos para la clasificación automatizada.
Aquí tienes una lista de algunas de las detecciones para las que automatizamos la clasificación inicial, para darte algunas ideas de detecciones que puedes crear con este flujo de trabajo. Algunas de estas detecciones son detecciones personalizadas creadas para funcionar con este flujo de trabajo de clasificación automatizado, pero muchas de ellas son detecciones existentes a las que añadimos etiquetas de clasificación (Triage) para eliminar algunos falsos positivos.
Autenticación de alto riesgo de Okta
Actividad de soporte de Okta desde una IP que no es de Okta
Actividad de la API de Okta desde una nueva IP
Okta UEBA: múltiples alertas diferentes para el mismo correo electrónico y la misma IP
Okta: múltiples direcciones de correo electrónico detectadas con un solo hash dt
Inicio de sesión de usuario exitoso en Okta sin MFA resistente al phishing
Autenticación de Okta por MFA Eximir cuenta de nueva IP
Número elevado de intentos de restablecimiento o desbloqueo de contraseña de usuario de Okta
Sesiones de usuario de Okta iniciadas desde diferentes geolocalizaciones
UEBA de Slack: múltiples alertas diferentes para un usuario de Slack
Inicio de sesión en el portal de GCP desde una IP nueva
Actividad de IAM de GCP desde una IP nueva
Actividad web de Buildkite desde una IP nueva
actividad de la API de Buildkite desde una IP nueva
GitHub: alerta de múltiples UEBA para un PAT de GitHub
GitHub: aumento en la clonación de repositorios privados por parte de usuarios
Hashicorp Vault: múltiples alertas de UEBA para un usuario de Vault
Autenticación de alto riesgo de Azure Active Directory
Inicio de sesión en el portal de Azure desde una IP nueva
Inicio de sesión de PowerShell en Azure Active Directory desde una IP nueva
Autenticación de código de dispositivo de Azure Active Directory
Inicio de sesión correcto en Azure Active Directory sin MFA
Actividad de AWS IAM desde una IP nueva
AWS Key UEBA: múltiples alertas diferentes para una clave de AWS
UEBA de usuario de AWS: múltiples alertas diferentes para una cuenta de AWS
Autenticación en la consola de AWS desde una IP nueva
Intentos de fuerza bruta a una cuenta de usuario de Microsoft 365
Errores excesivos de inicio de sesión único (SSO) en O365
Pico en eventos de inicio de sesión exitosos desde una IP de origen
Lograr nuevos niveles de protección
En esta publicación de blog, te mostré cómo el equipo de InfoSec de Elastic usa Tines para automatizar la clasificación inicial de muchas de nuestras alertas. Esta automatización nos permite tener una visibilidad mucho mejor mientras aumentamos la eficiencia, y nos permite dedicar nuestro tiempo a investigar las amenazas reales. Usando Tines, pudimos investigar y cerrar por completo más de 50 000 alertas en los últimos 30 días. Cada una de estas alertas fue investigada exhaustivamente y cerrada a los pocos segundos de haberse activado. Sería imposible tener el mismo nivel de protección en nuestra red sin esto.
Si quieres probar esto por tu cuenta, puedes hacerlo gratis con una prueba de 14 días de Elastic Cloud y la edición comunitaria siempre gratuita de Tines para ver lo potentes que pueden ser estos flujos de trabajo para ti.
El momento del lanzamiento de cualquiera de las características o funcionalidades descritas en esta publicación queda a exclusivo criterio de Elastic. Es posible que algunas características o funcionalidades que no estén disponibles en este momento no se lancen a tiempo o no se lancen en absoluto.
Comparte
- Share on Twitter
Comparte en Twitter
- Share on LinkedIn
Comparte en LinkedIn
- Share on Facebook
Comparte en Facebook
- Share by Email
Comparte por correo electrónico
- Print this page
Imprime