¡Las uniones ES|QL ya están aquí! ¡Sí, uniones!
Elasticsearch 8.18 incluye el comando LOOKUP JOIN de ES|QL, nuestro primer JOIN estilo SQL.

 Share on Twitter
Comparte en Twitter

 Share on LinkedIn
Comparte en LinkedIn

 Share on Facebook
Comparte en Facebook

 Share by Email
Comparte por correo electrónico

 Print this page
Imprime
Elasticsearch 8.18 incluye nuestro primer JOIN de estilo SQL: el comando LOOKUP JOIN de ES|QL. Ya está disponible en vista previa técnica y permite la correlación y el enriquecimiento de datos con sets de datos de búsqueda fácilmente actualizables. ¿Necesitas agregar información de host y activos a tus eventos? No hay problema. ¿Quieres comprobar qué direcciones IP o URL están en listas de inteligencia de amenazas? ¡Claro! ¿Realizar actualizaciones en el set de datos de búsqueda y usarlas inmediatamente? ¡También!
Lookup Join es un LEFT OUTER JOIN de estilo SQL que se basa en un nuevo modo de índice llamado lookup para el lado derecho. El índice lookup podría ser activos, datos de inteligencia de amenazas como IP maliciosas conocidas, información de pedidos, información de empleados o clientes — hay infinitas posibilidades.
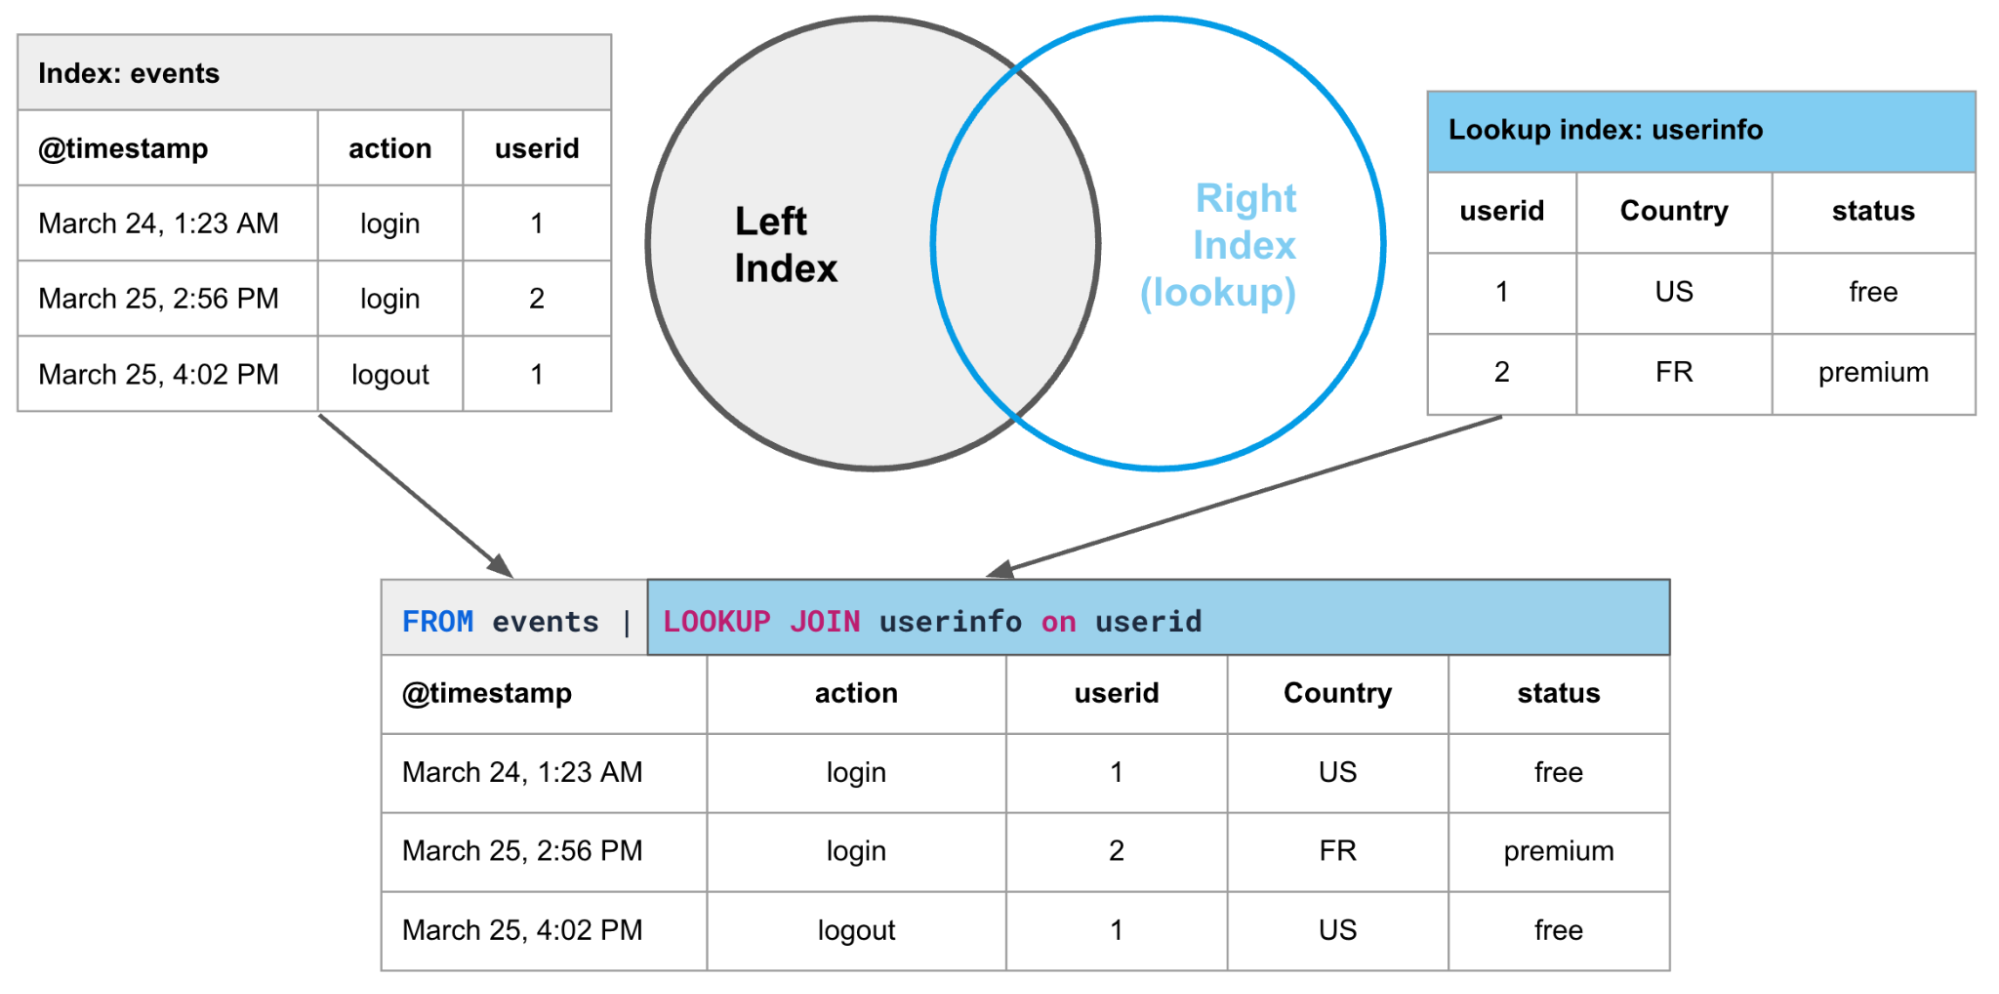
Históricamente, Elasticsearch carecía de capacidad de unión, aunque con el tiempo se hicieron algunos intentos en esa dirección, como nested, _parent y tipos de campo join, y enrich. Por lo general, fomentamos la desnormalización de los datos colocando los datos de referencia junto a los eventos en el mismo índice, o uniones del lado del cliente. Estas soluciones dificultan la escalabilidad para volúmenes de datos más grandes y pueden ser limitantes cuando hay una gran variedad de datos y casos de uso. Es hora de que Elasticsearch tenga uniones. Y ahora es posible: ES|QL no es solo un lenguaje — está construido sobre un nuevo motor de cómputo. El motor ES|QL hace posibles las características avanzadas, como la unión.
Para habilitar las lookup joins, creamos un nuevo modo de índice: "lookup". Un índice lookup es similar a un índice regular ("mode:standard" es el predeterminado), lo que significa que se puede actualizar directamente. La principal diferencia es que un índice lookup es de un solo shard. Por lo tanto, está limitado a 2 000 000 000 documentos, un límite de Lucene para un solo shard. Esto debería ser más que suficiente para almacenar los datos del lado derecho en muchos de los casos de uso de las lookup joins. Imponer este límite nos ayuda a evitar algunos de los problemas asociados con las uniones totalmente distribuidas al reducir la cardinalidad de origen del lado derecho de la unión. Esto también nos indica qué sets de datos planeas usar como referencias lookup para que podamos encontrar formas de optimizarlos en el futuro.
Aparte del modo de índice de búsqueda, no hay restricciones en los datos de origen ni ninguna preparación de datos requerida para realizar una unión. Eso significa que es fácil agregar sets de datos de búsqueda y es fácil mantenerlos actualizados.
Parte de esto ya ha sido posible con el comando ENRICH en ES|QL. ENRICH se optimizó para búsquedas en tiempo de ingesta en pipelines de ingesta y pequeños sets de datos que no cambian a menudo, por lo que fue conveniente pero no ideal. Lookup Join es más fácil de configurar y gestionar que ENRICH:
Sin crear políticas de enriquecimiento
Sin ejecución de políticas
Los índices de búsqueda son modificables
Hay menos copias de los datos
Mejor manejo de coincidencias múltiples: mientras que la función enrich crea campos con múltiples valores cuando hay varias coincidencias, la función lookup join crea varias filas. Esto hace que sea más fácil realizar análisis adicionales como agrupar y agregar, como bytes transferidos por usuario o totales de pedidos.
Lookup Join permite especificar el campo de coincidencia sobre la marcha
Aquí tienes solo algunas de las formas en que podrías usar una función LOOKUP JOIN:
Unirte a eventos de seguridad con inteligencia de amenazas para enriquecer aún más el evento
Consultar mi conjunto actual de hosts o la información más reciente sobre amenazas o metadatos internos
Correlacionar lecturas de IOT con metadatos estáticos o dinámicos (fabricante, unidad de volumen)
Combinar eventos de seguridad con información del host para más contexto y filtrado
Agregar algunos datos como la criticidad de los activos (este usuario es un ejecutivo)
Agregar los AID de CrowdStrike a una fuente que tenga nombres de host
Comprobar si cierta dirección IP aparece en los feeds de inteligencia de amenazas
Agregar información de empleados a los eventos
Las posibilidades son infinitas.
Ejemplo de uso
Veamos algunos ejemplos reales para ver lo fácil y poderoso que puede ser esto.
Como SRE, puede que necesites:
Agregar un entorno a los registros según la dirección IP o el nombre de host
Agregar información de empleados a los registros
Descubrir qué equipo es propietario de un servidor
Antes de LOOKUP JOIN, tendrías que:
Colocar tus datos de referencia (entornos) en un índice
Definir una política de enriquecimiento basada en ese índice, especificando el tipo de política, el campo de coincidencia y los campos de enriquecimiento
Ejecutar la política de enriquecimiento una vez para construir el índice de enriquecimiento
Repetir para cada set de datos de referencia (empleados, equipos)
Ejecutar la política de enriquecimiento siempre que los datos cambien
Con LOOKUP JOIN, solo pon los datos de referencia en un índice de búsqueda y ¡listo!
Imagina que recibes una alerta de que hay usuarios que están experimentando errores en tu sitio de comercio electrónico. Encuentras registros web donde la respuesta no es el código de respuesta HTTP 200 para el éxito. Te gustaría desglosarlos por entorno para ver si los clientes de producción se ven afectados, pero los registros no tienen un campo de entorno. Está bien, simplemente agrega una unión de búsqueda en el entorno, tal vez usando un archivo como este:
clientip,environment
192.168.1.9,QA
192.168.14.2,Dev
192.168.12.3,Prod
…Ahora agrega el LOOKUP JOIN en el índice de búsqueda de entornos (el mío se llama envs_lkp):
FROM kibana_sample_data_logs | WHERE response.keyword != "200"
| LOOKUP JOIN envs_lkp ON clientip
| STATS COUNT(*) by response, environment
Existen errores en producción y aseguramiento de calidad (QA). Podemos hacer una unión con una lista que indica qué equipo es propietario de cada servidor web para ver a quién debemos contactar:
host,team
www.elastic.co,Web team
artifacts.elastic.co,Delivery team
cdn.elastic-elastic-elastic.org,Cloud team
elastic-elastic-elastic.org,Web teamFROM kibana_sample_data_logs | WHERE response.keyword != "200"
| LOOKUP JOIN teams_lkp ON host
| STATS num = COUNT(*) by host, response.keyword, team
| SORT num DESC
¡A los analistas de Security les encantan sus joins! Tal vez quieran:
Identificar las IPs de los clientes que solicitan URLs maliciosas conocidas
Correlacionar con la información de activos para agrupar eventos y asignar prioridad o riesgo
Podrías descargar una lista de URL maliciosas de URLhaus en Abuse.ch y subirla a un índice de búsqueda.
FROM logs
| LOOKUP JOIN urlhaus_lkp ON url
| WHERE threat IS NOT NULL
| KEEP @timestamp, url.keyword, clientip, threat
Cómo crear lookups
Necesitarás al menos un lookup index para usar la lookup join. Estamos diseñando maneras de hacer que sea fácil y conveniente crear y actualizar lookups en Kibana. Por ahora, puedes comenzar creando un índice de lookups de varias maneras — el detalle clave es que el modo de índice debe ser “lookup.”.
Crea un índice de búsqueda usando la administración de índices
En el panel de navegación izquierdo de Kibana, haz clic en Stack Management, y luego en Gestión de índices. En el lado derecho, haz clic en Crear índice.

Proporciona un nombre de índice y selecciona “Buscar” en el menú desplegable modo índice:

Haz clic en Crear para crear un índice de búsqueda vacío.
Crear índice de lookup mediante API
Crea un índice de búsqueda usando la API de creación de índice — solo asegúrate de incluir el modo de índice:
PUT mylookupindex
{
 "settings": {
   "index.mode": "lookup"
 }
}Crear índice de búsqueda usando el cargador de archivos ML
En el panel de navegación izquierdo de Kibana, haz clic en machine learning, y a continuación, file data visualizer (o escribe “subir” en la barra de búsqueda de Kibana).

Selecciona o arrastra y suelta tu archivo — CSV funciona bien para esto.
Después de hacer clic en Importar, proporciona un nombre para el índice y haz clic en Avanzado para revelar la configuración del índice. Aquí, querrás agregar el index.mode: lookup.

Completa la carga del archivo haciendo clic en Importar. Se creará un índice y una Data view.
En todos los casos, ahora puedes hacer referencia al índice de búsqueda en tus consultas ES|QL.
Preguntas frecuentes
Q: ¿cuándo no debería usar los lookup joins?
Lookup Join es realmente poderoso, pero con gran poder… bueno, ya sabes. Las lookup joins pueden ser una operación costosa, y cada join agregará algo de latencia a tu consulta. Puede que aún existan situaciones en las que un join sea excesivo o no sea la mejor opción. Por ejemplo, si hay un campo al que te unes muy frecuentemente en muchas consultas, considera desnormalizarlo en el índice izquierdo. Agrégalo en el momento de la ingesta usando un procesador de ingesta enriquecido, configuración del agente de archivos, usa un filtro Logstash, etc. Este procesamiento de ingesta única es un compromiso entre un ligero aumento en el uso de almacenamiento para consultas más rápidas. Esto sería especialmente aplicable para valores de referencia que no cambian con frecuencia (el nombre de usuario de un ID de usuario) o que nunca cambian (el fabricante de un host).
Q: ¿puedo consultar un lookup directamente?
¡Sí! Un índice lookup es principalmente "solo un índice", así que puedes consultarlo con ES|QL.
FROM <lookup_index> | …O bien, crea una data view.

Q: ¿Puedo enviar datos de Logstash o de un agente?
¡Sí! Solo ten en cuenta que un índice de búsqueda no es un flujo de datos y es solo un shard, así que puedes "solo" enviar hasta 2 000 000 000 de documentos a cada índice de búsqueda.
¿Qué sigue?
Estamos trabajando para eliminar algunas limitaciones conocidas para que el join de búsqueda pueda estar disponible de forma generalizada. Además, estamos diseñando una experiencia de edición de primera clase para los sets de datos de búsqueda. Imagina poder crear y editar índices de lookup directamente en Kibana Discover, o soltar un archivo CSV en Discover para rellenar el índice. Aquí tienes una maqueta de cómo podría verse:

Y las uniones de búsqueda son solo el principio. Nos gustaría ofrecer otros tipos útiles de uniones, como uniones inner o subconsultas, y también permitir unir contra cualquier índice (no solo índices de búsqueda).
Comienza
Así que eso es lookup join, disponible en Elasticsearch 8.18/9.0 como vista previa técnica.
¿Listo para comenzar? Elastic 8.18 y 9.0 ya están disponibles en Elastic Cloud — el servicio hospedado de Elasticsearch que incluye todas las nuevas características de esta última versión. En nombre del equipo de ES|QL, estamos deseando recibir tus comentarios — puedes usar el botón Enviar comentarios en el editor ES|QL en Discover. Y oye, llegamos hasta el final de este blog sobre joins sin hacer ningún juego de palabras sobre joins... ¡gracias por acompañarnos!
El momento del lanzamiento de cualquiera de las características o funcionalidades descritas en esta publicación queda a exclusivo criterio de Elastic. Es posible que algunas características o funcionalidades que no estén disponibles en este momento no se lancen a tiempo o no se lancen en absoluto.
Comparte
- Share on Twitter
Comparte en Twitter
- Share on LinkedIn
Comparte en LinkedIn
- Share on Facebook
Comparte en Facebook
- Share by Email
Comparte por correo electrónico
- Print this page
Imprime