Mecanismo de contexto da Elastic
Contexto completo e sempre atualizado
O mecanismo de contexto da Elastic* conecta qualquer fonte corporativa para criar agentes precisos: sincronize o contexto a cada interação ou de forma programada, pré-calcule o contexto para uma recuperação rápida de entre fontes e melhore continuamente a precisão.
*Experimental
Leia nosso blog para saber como selecionar e gerenciar o contexto de forma contínua.
Leia o postVisite nossa documentação para saber mais sobre o Context Engine e como você pode começar.
Veja a documentaçãoO que um mecanismo de contexto faz pelos agentes?
Pré-calcule o contexto para reduzir o consumo de tokens de entrada, diminuir a latência e melhorar a qualidade das respostas. O uso do mecanismo de contexto da Elastic para agentes de suporte reduziu os custos em 55% e a latência em 40%.
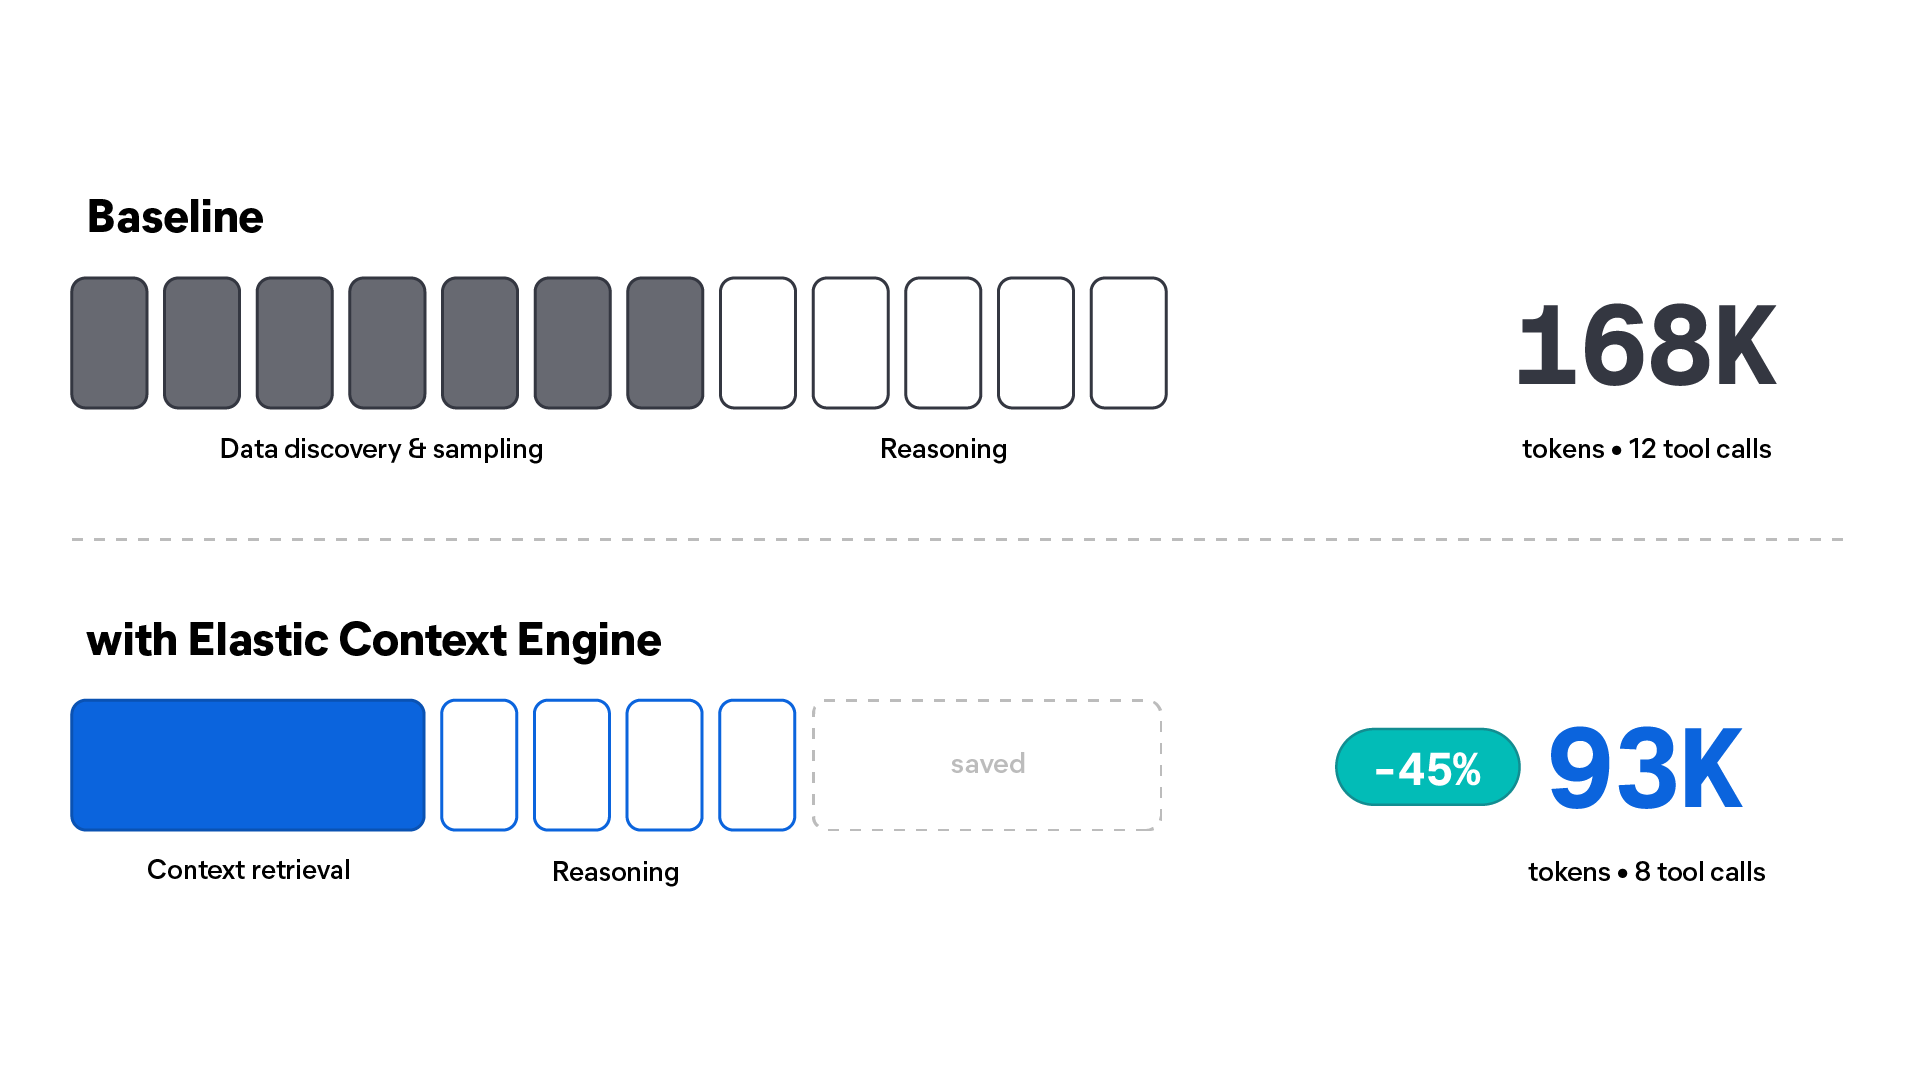
BENEFÍCIOS
Torne qualquer agente eficiente
Mantenha o contexto dos seus agentes sempre completo, atualizado, eficiente e mensurável.


Como funciona
Conecte os dados empresariais, use o Elastic Workflows para transformá-los em indicadores de conhecimento estruturados e disponibilize esse contexto para qualquer agente.
Conectar
Conecte seus agentes ao contexto fornecido por índices do Elasticsearch, por fontes de dados externas por meio dos conectores do Kibana ou por consultas ES|QL.
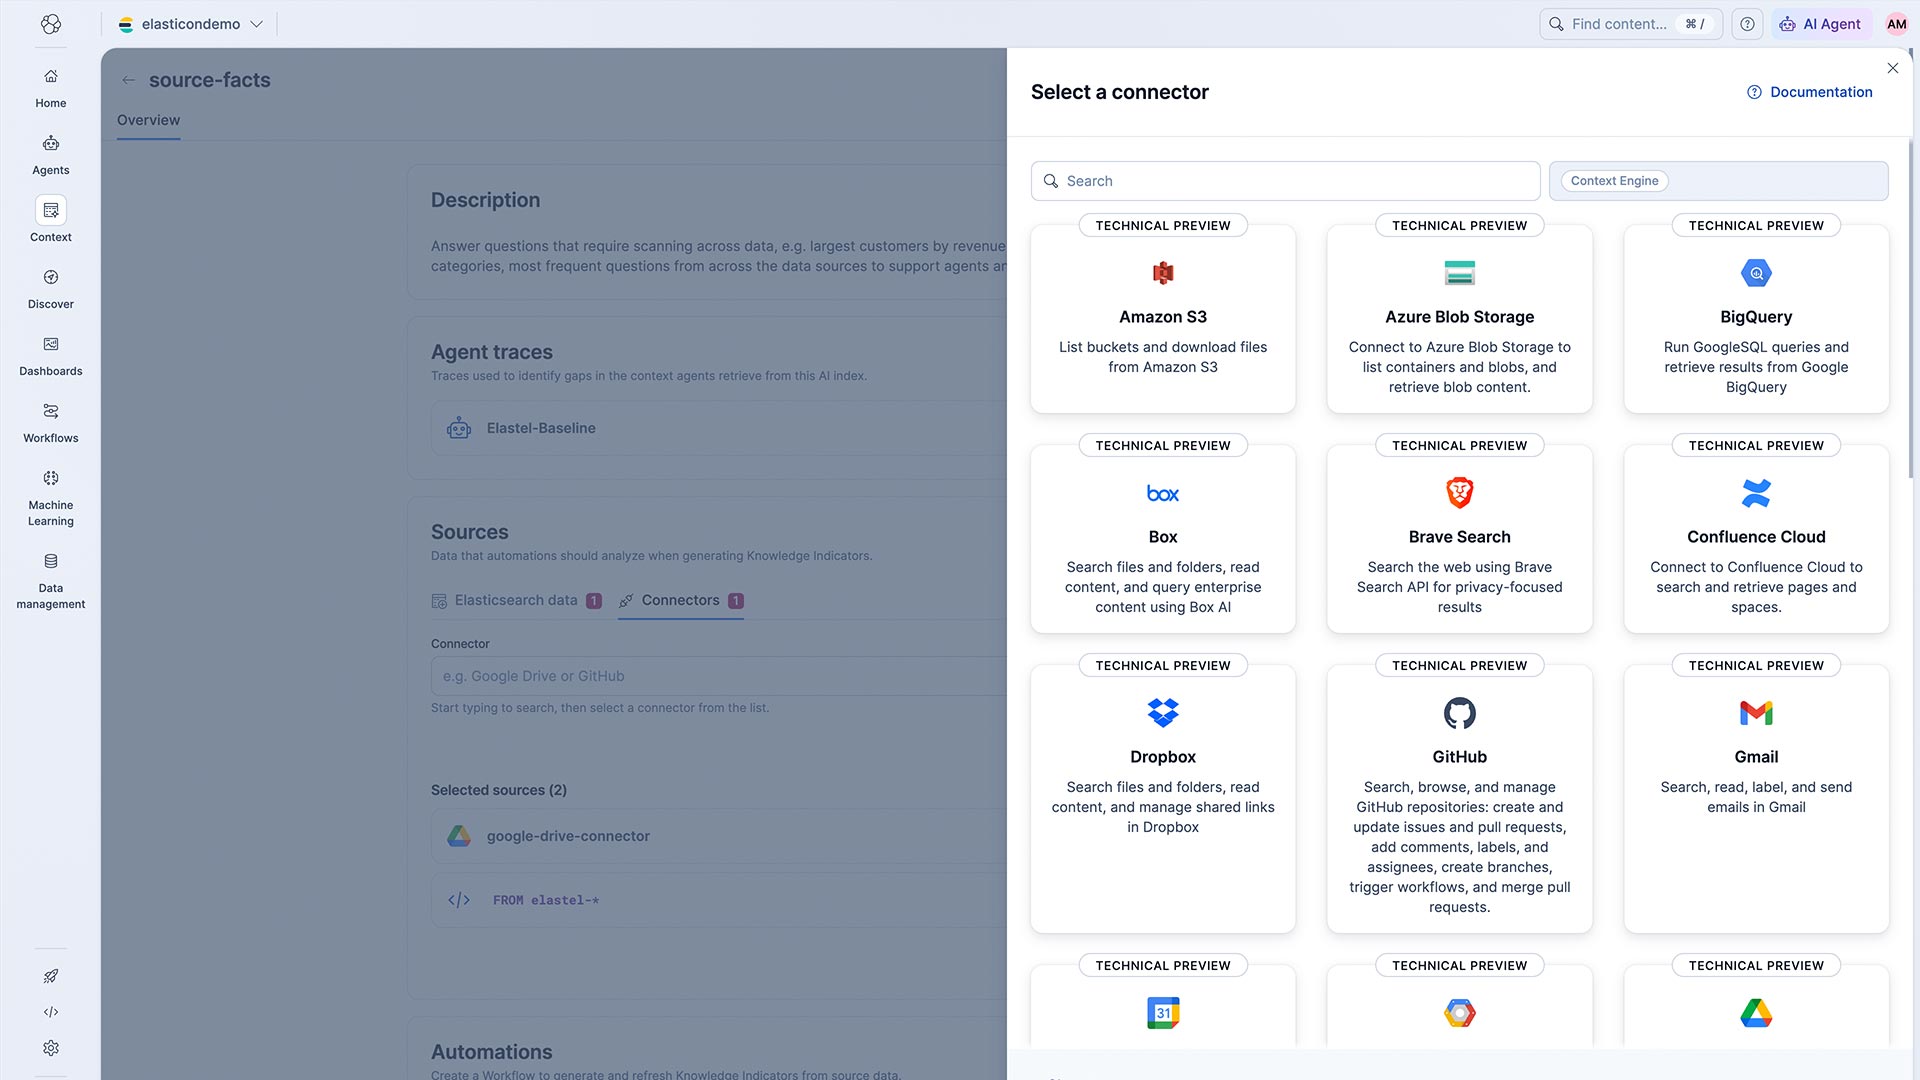
Reunir
Crie automações para gerar Indicadores de conhecimento que extraem a semântica dos dados, descrições, relações e fatos para um índice de IA.
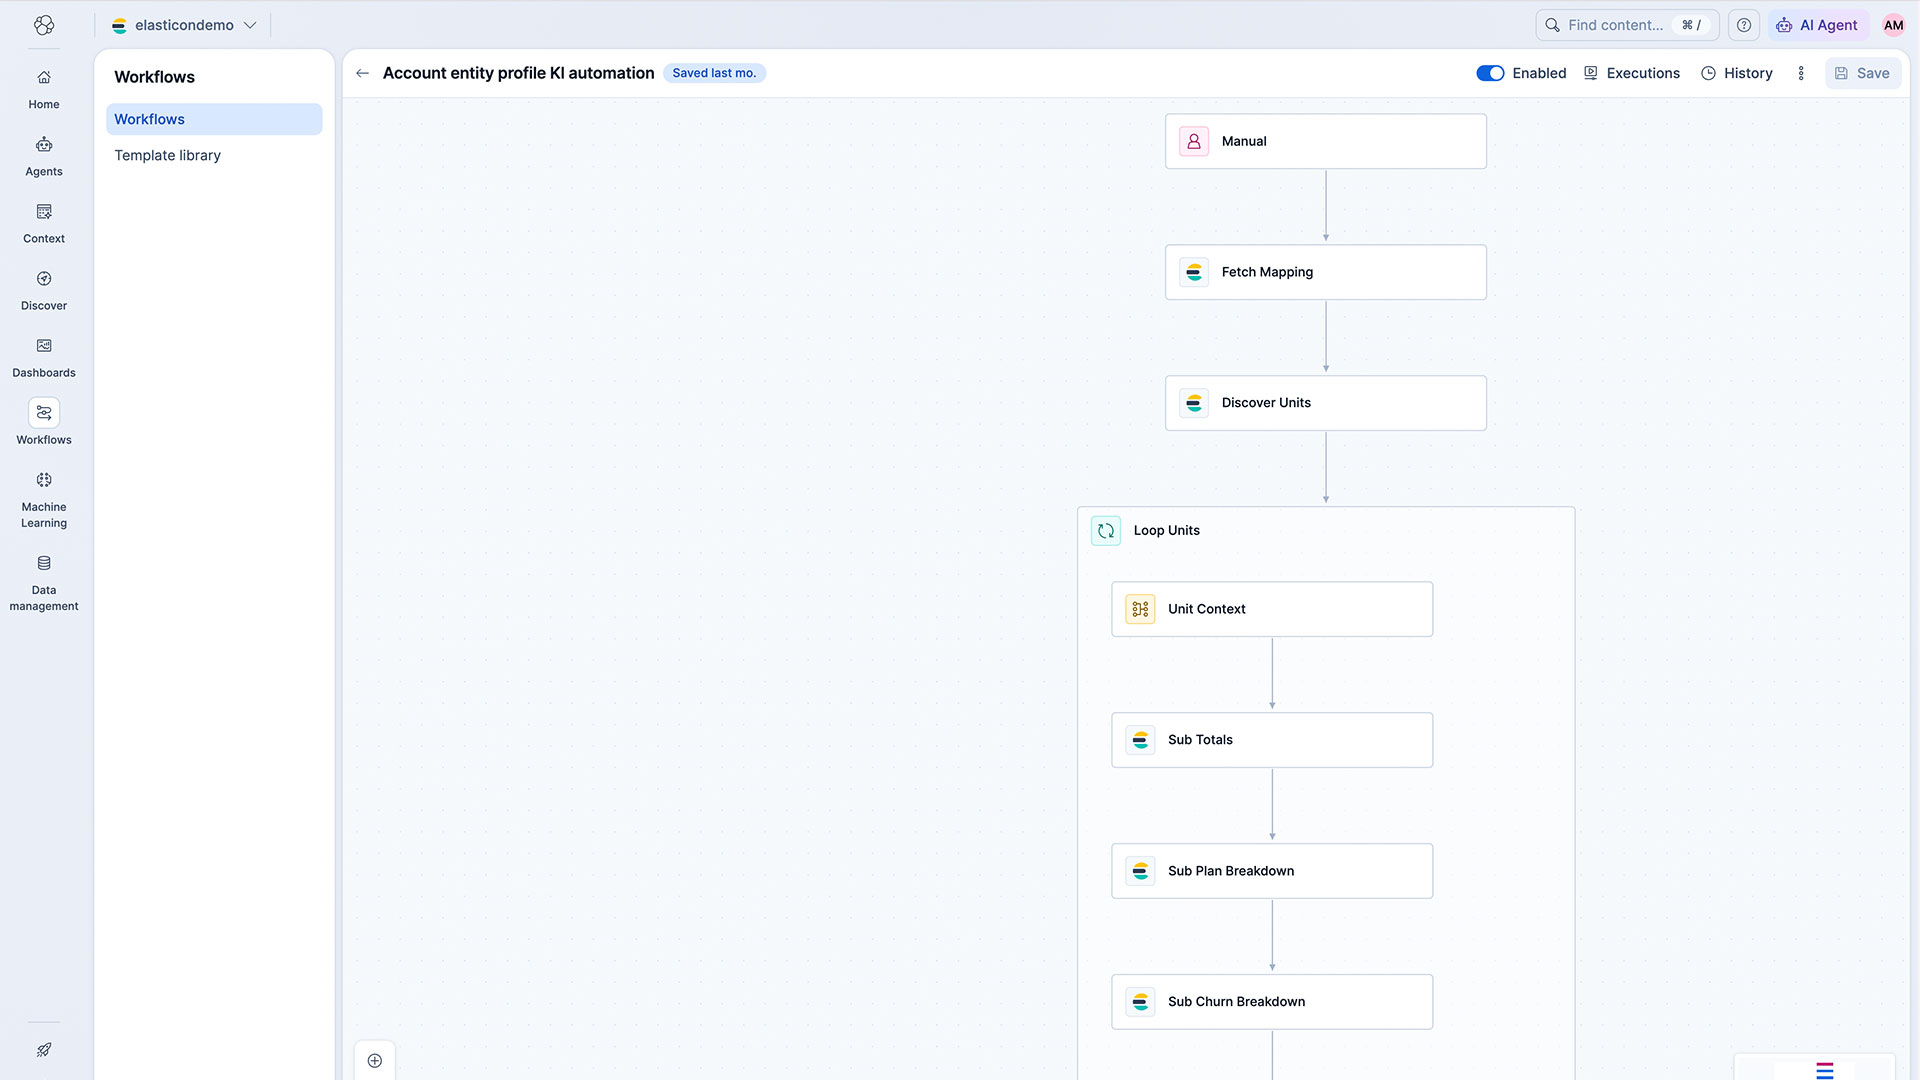
Recuperar
Use a ES|QL combinável para recuperar o contexto mais relevante no momento da inferência.
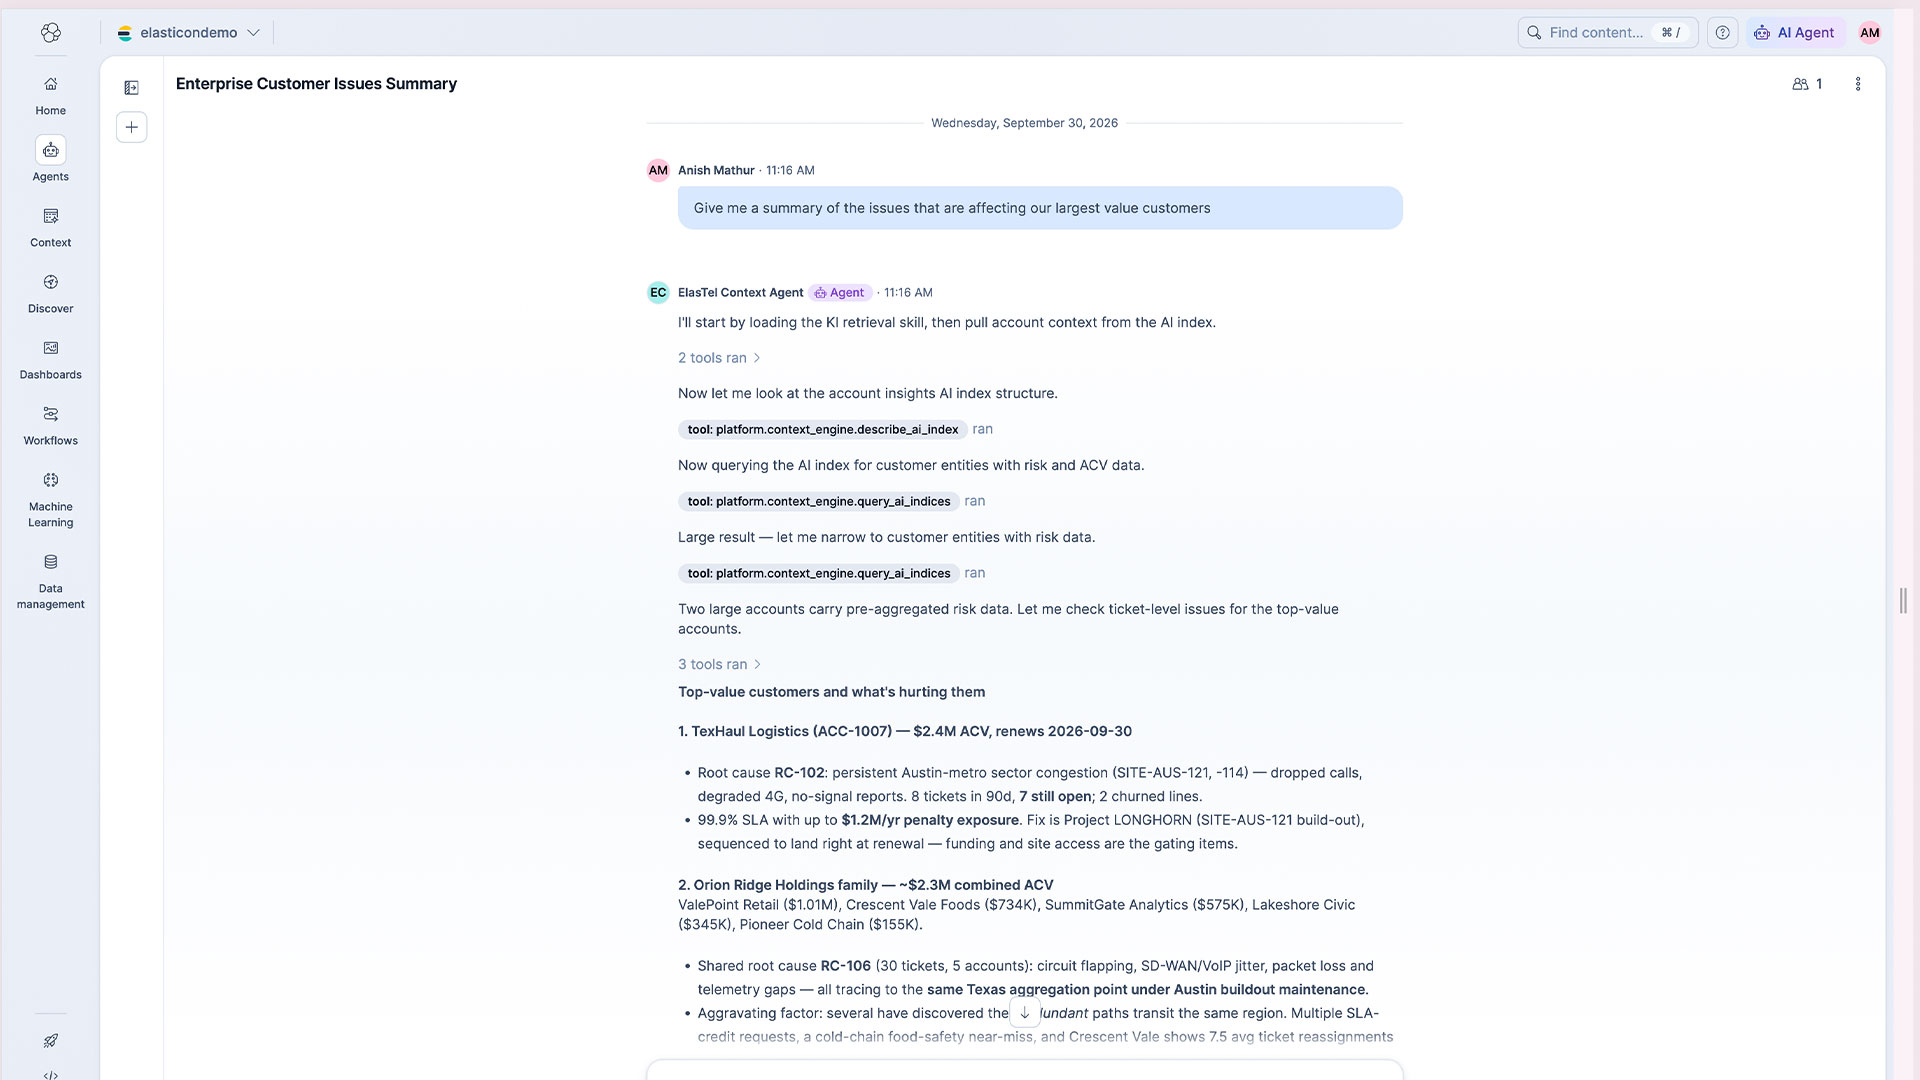
Observe e melhore
Use avaliações e rastreamentos para acompanhar as respostas dos agentes e melhorar o contexto.
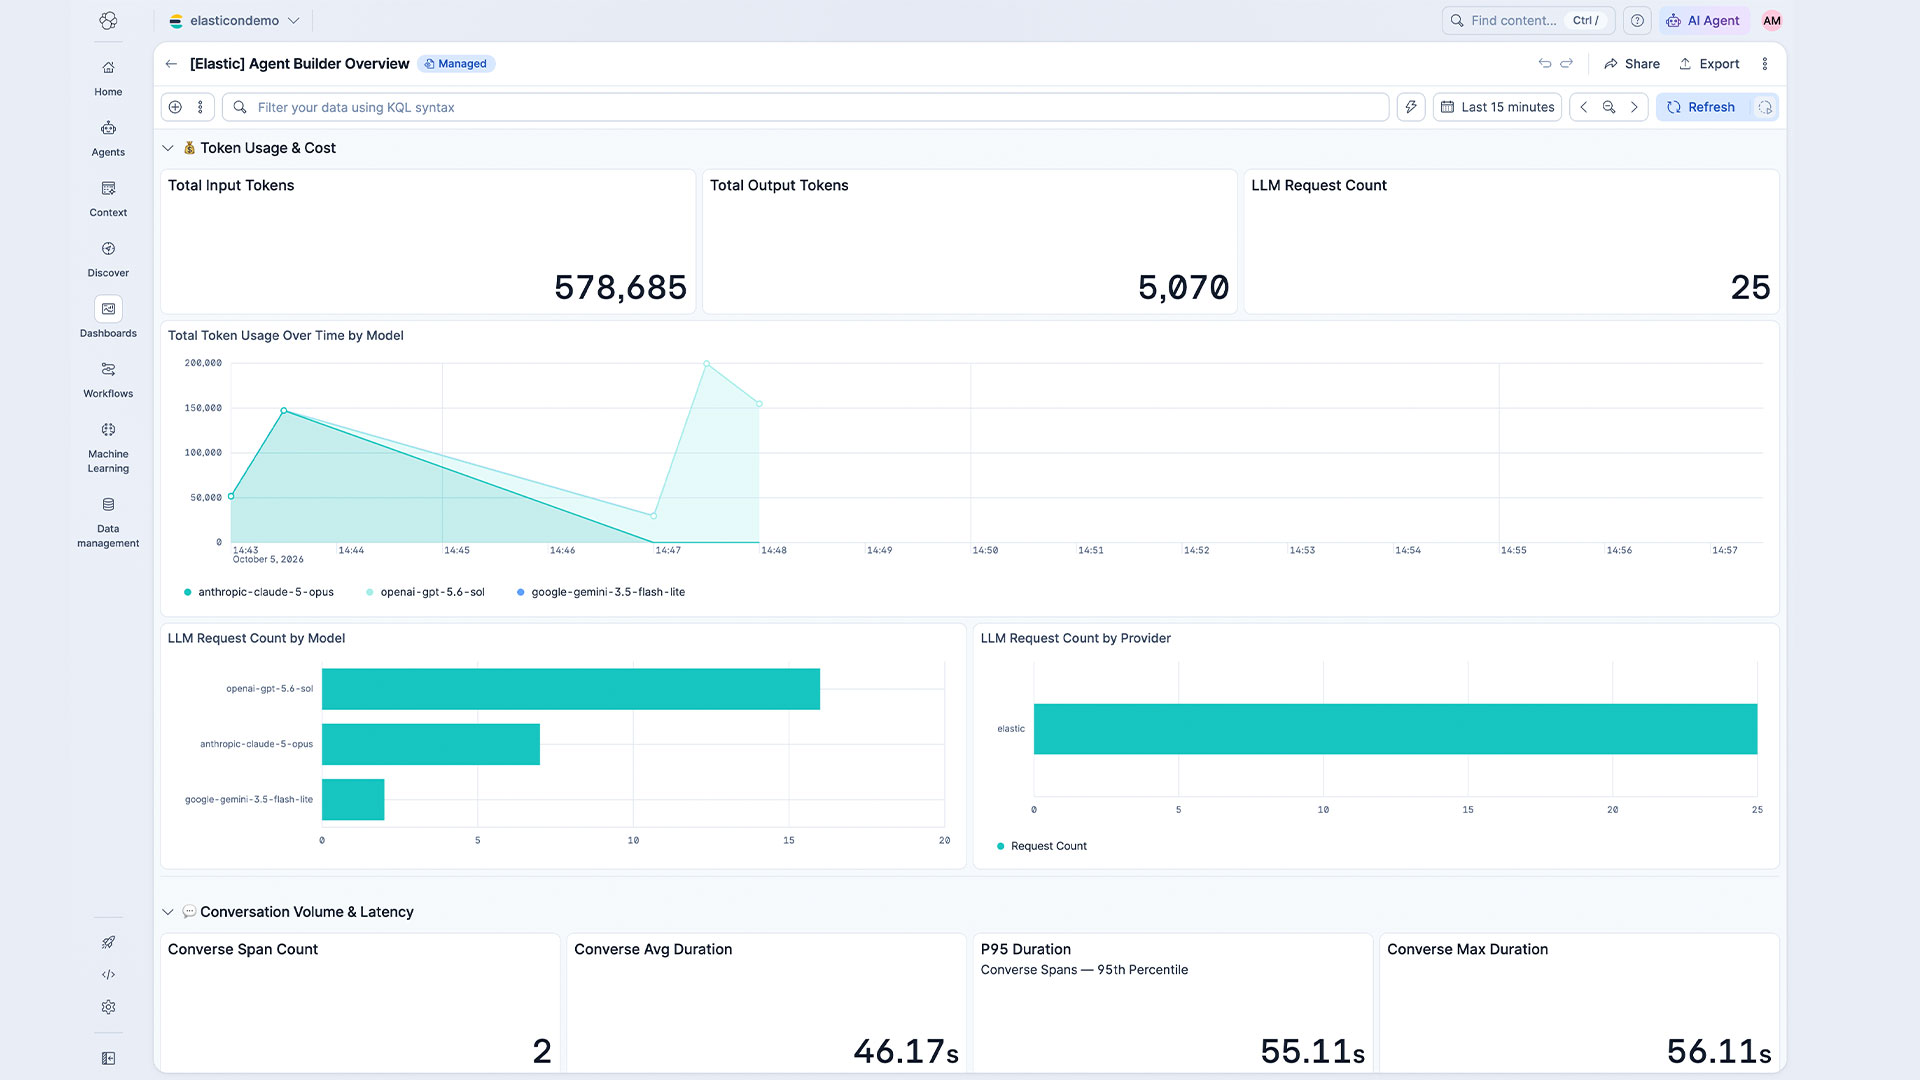
Integrar
Disponibilize contexto para agentes próprios e de terceiros por meio de plugins que permitem a integração com diferentes ambientes de execução de agentes, como Claude Code, Codex, LangChain Deep Agents, agentes gerenciados pelo Claude, AWS AgentCore, Gemini Agent Platform e outros.
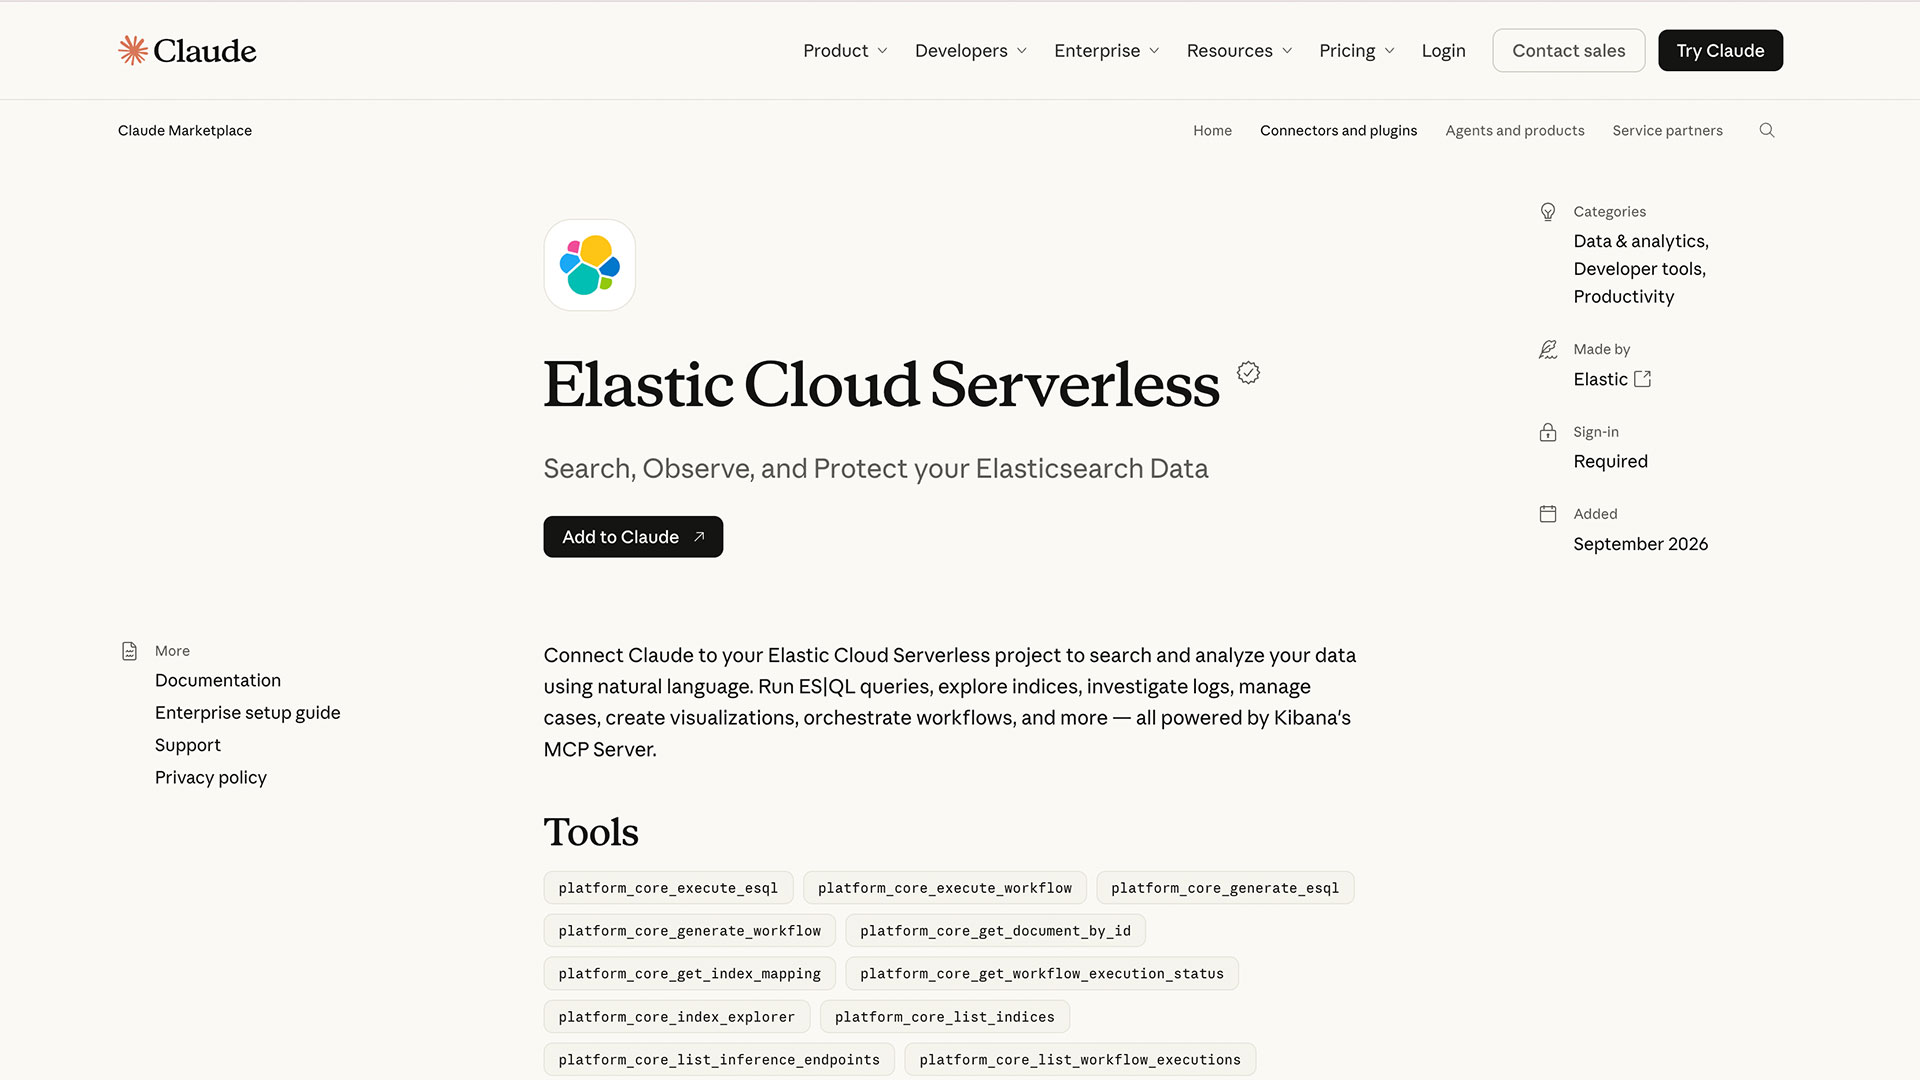
Arquitetura
As automações pré-extraem indicadores de conhecimento para um índice de IA, para que qualquer agente possa recuperar contexto relevante com uma simples consulta ES|QL.
Tipos de contexto
Crie vários tipos de indicadores de conhecimento a partir de dados brutos.
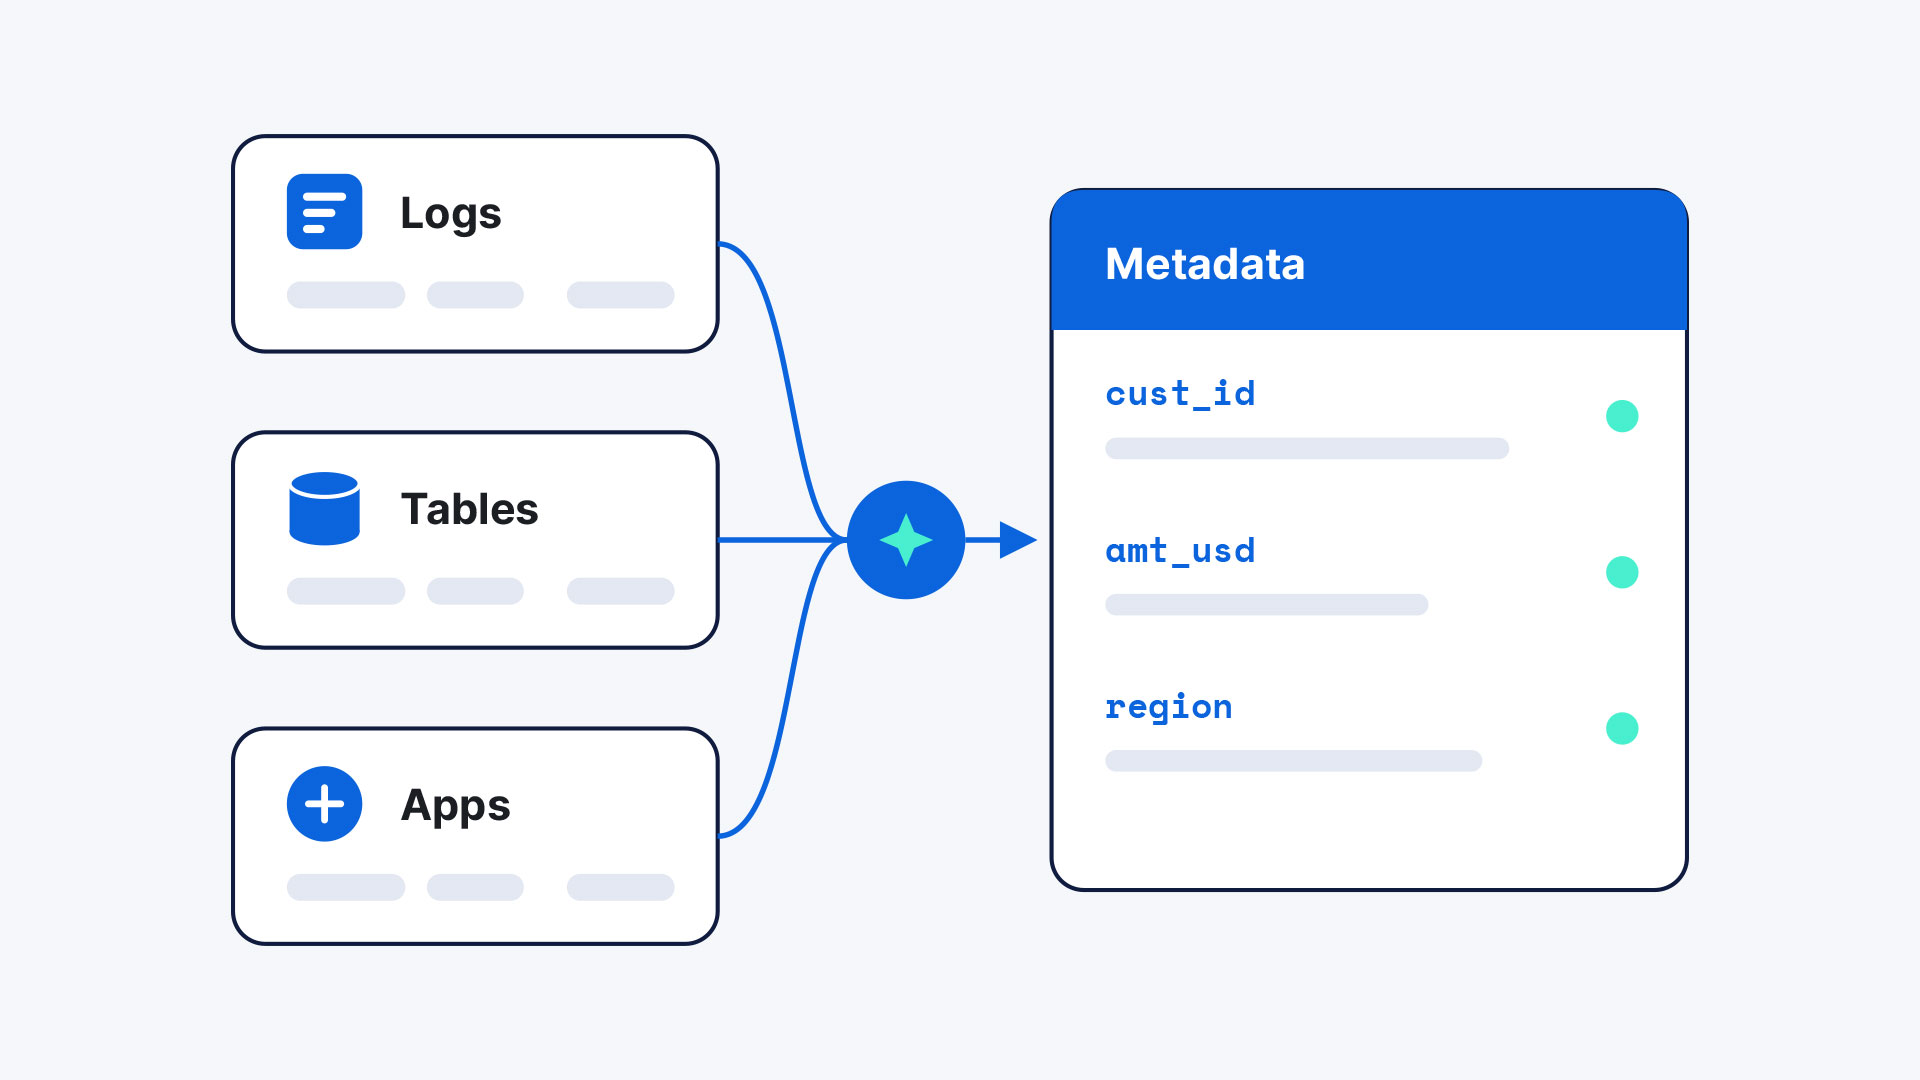
Metadados semânticos das fontes
Crie perfis de fontes de dados, incluindo descrições de finalidade, campos, distribuição e características dos dados, para orientar como consultá-las e quando utilizá-las.
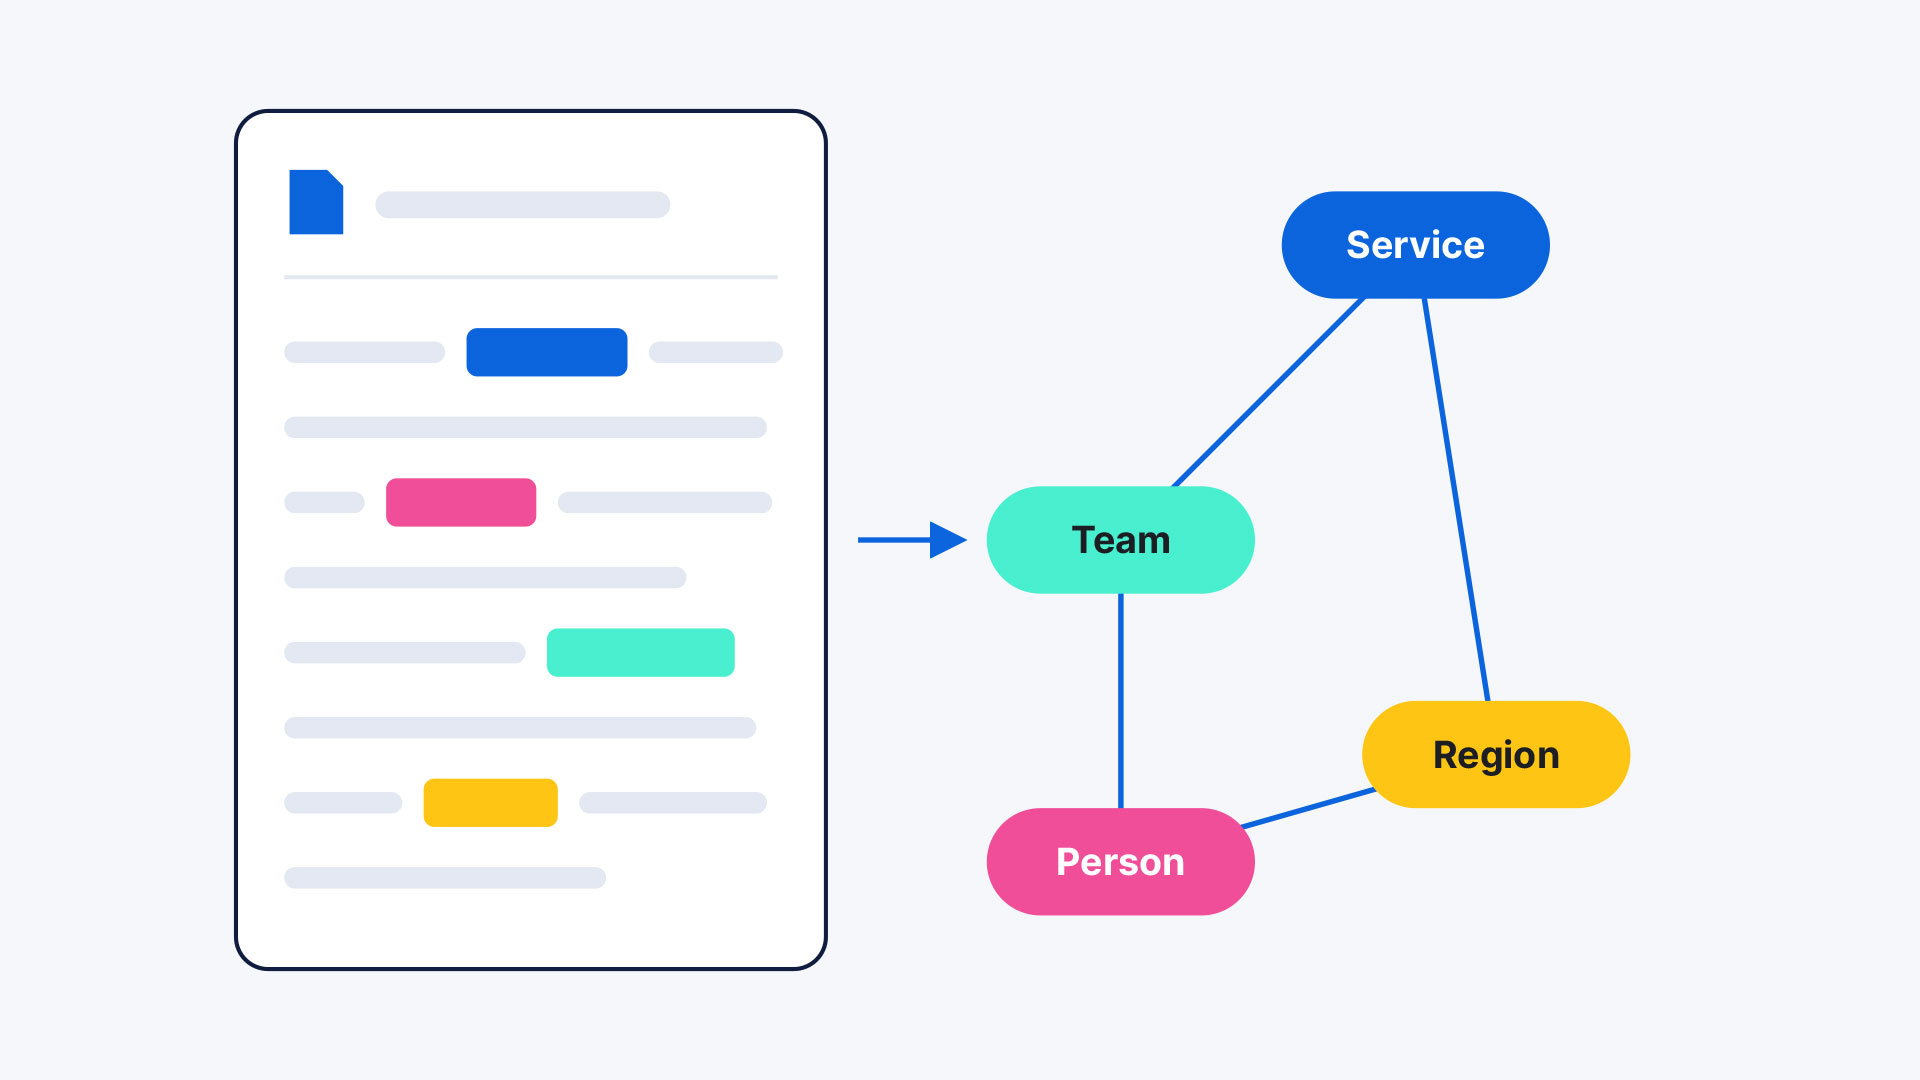
Entidades e relações de documentos
Extraia entidades como contas, contatos, projetos, objetivos de negócios, sistemas e serviços, e armazene-as junto com seus relacionamentos semânticos para orientar o raciocínio do agente.
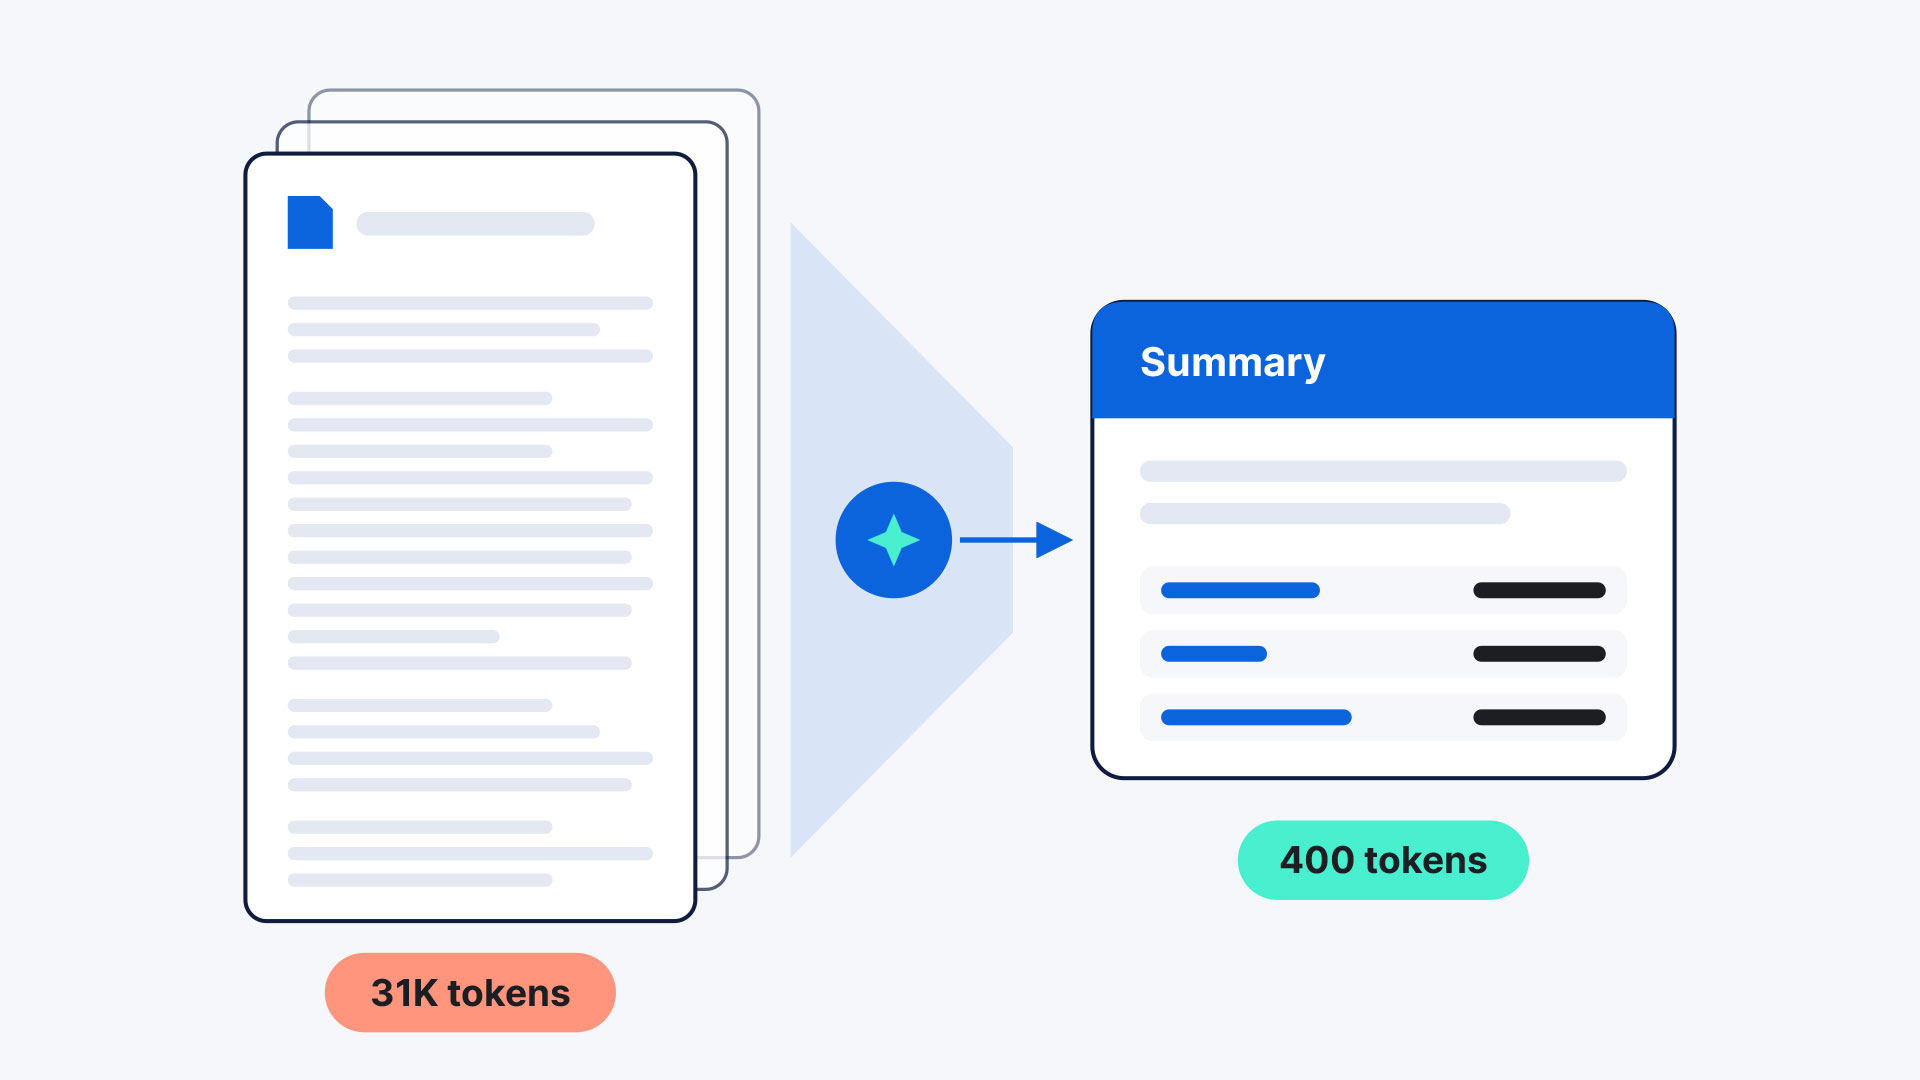
Fatos e resumos do documento
Resuma documentos grandes e complexos e extraia informações essenciais para reduzir a necessidade de leituras dispendiosas de documentos.
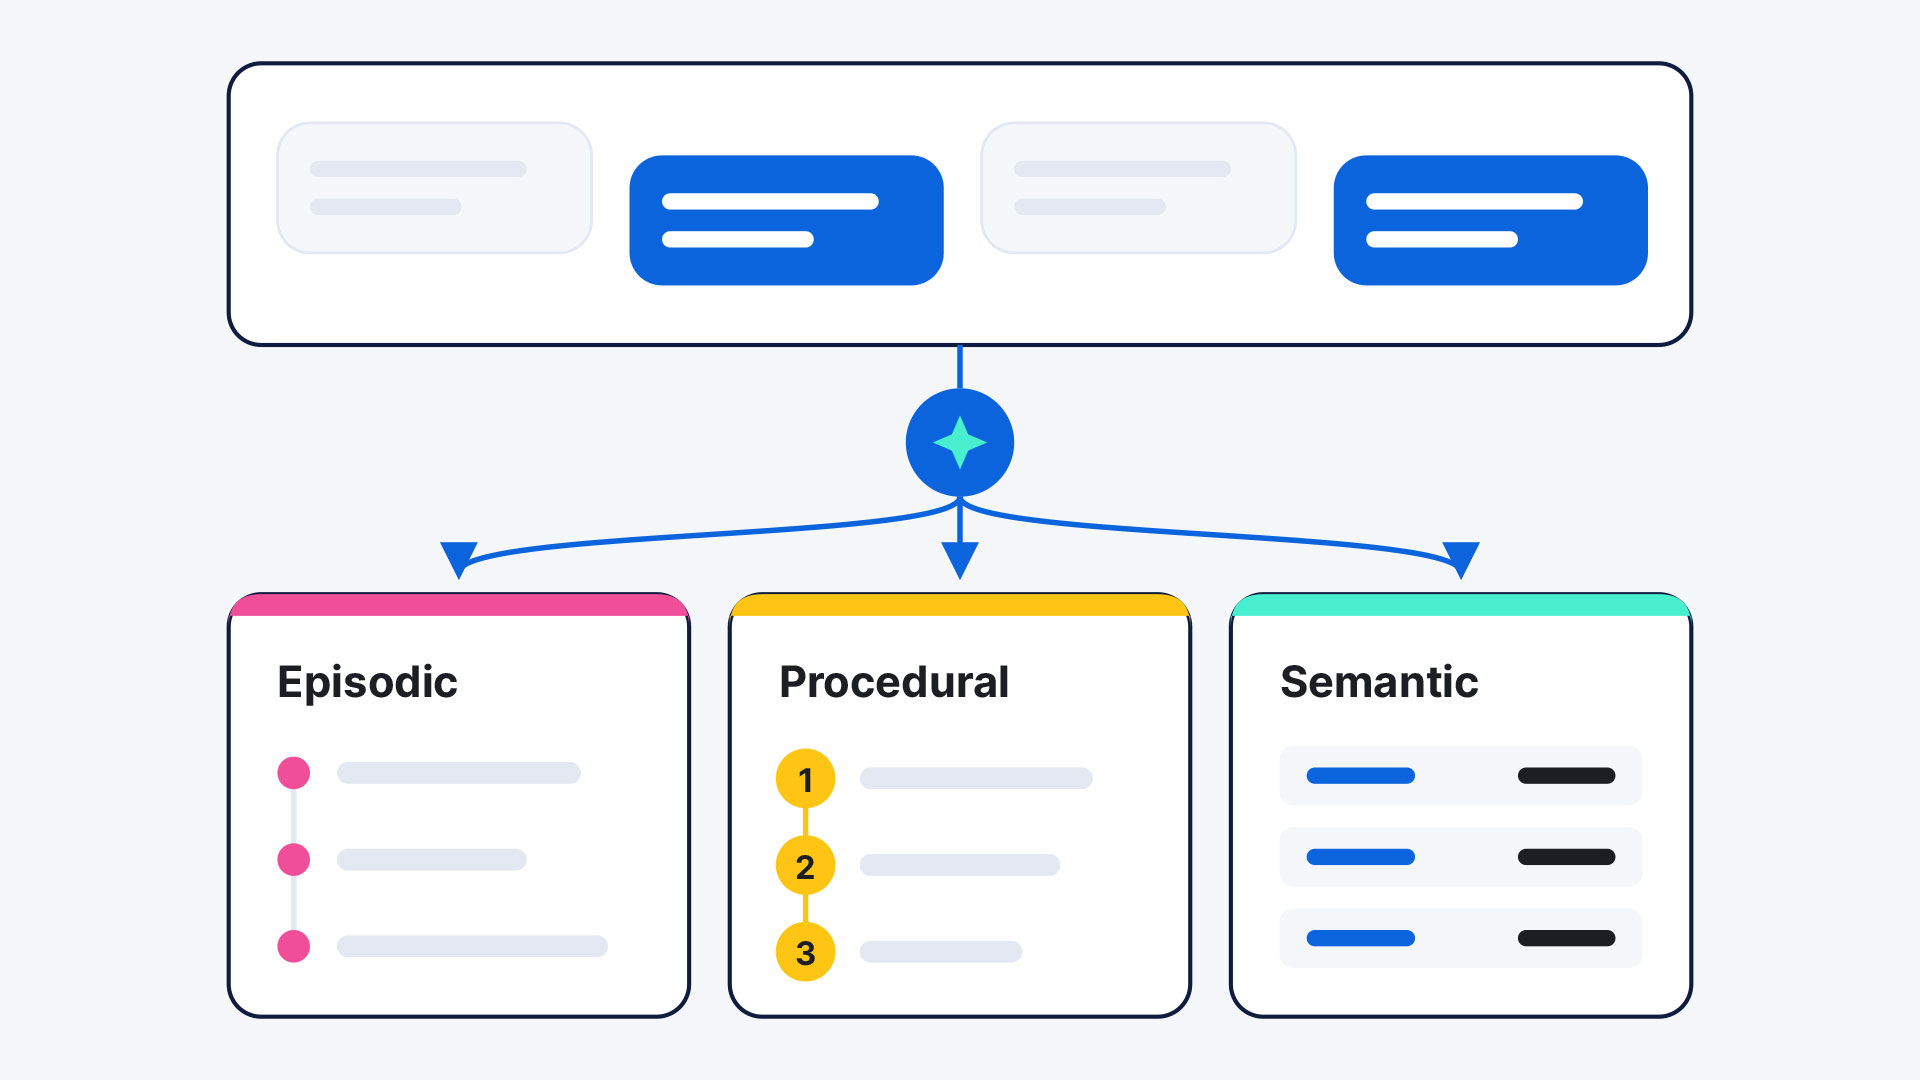
Memória do agente a partir das interações
Registre memórias para agilizar as respostas e ampliar continuamente o conhecimento de cada agente.
CASOS DE USO
Casos de uso do agente
Mapeie, pré-compute e identifique relacionamentos.


INTEGRAÇÕES
O melhor da categoria? Integrado diretamente
Integre-se aos frameworks e aplicativos de agentes mais populares.
RECURSOS PARA COMEÇAR
Dê os próximos passos
Saiba mais com tutoriais passo a passo, demonstrações e documentação.
Siga um tutorial passo a passo para criar e armazenar contexto em um índice de IA e desenvolver agentes mais inteligentes usando menos tokens.
Explore esta demonstração interativa para ver como é fácil começar a usar o Context Engine.
Perguntas frequentes
O que é um mecanismo de contexto?
O que é um mecanismo de contexto?
Um mecanismo de contexto é uma parte da arquitetura de agentes que coleta e cria contexto a partir de dados específicos do negócio e de interações para tornar um agente mais eficiente e eficaz.
Qual é a diferença entre um mecanismo de contexto e um banco de dados vetorial ou armazenamento de memória?
Qual é a diferença entre um mecanismo de contexto e um banco de dados vetorial ou armazenamento de memória?
Um mecanismo de contexto se baseia em bancos de dados vetoriais e repositórios de memória. Um banco de dados vetorial funciona como um componente de armazenamento e recuperação de contexto, enquanto um repositório de memória captura o contexto diretamente das interações com agentes. Um mecanismo de contexto decide o que armazenar nesses repositórios; como estruturá-lo; como mantê-lo, governá-lo e protegê-lo; e quais ferramentas disponibilizar para recuperá-lo.
Já tenho um catálogo de dados. Por que preciso de um mecanismo de contexto?
Já tenho um catálogo de dados. Por que preciso de um mecanismo de contexto?
Os catálogos de dados descrevem os dados, mas dependem de informações estáticas e precisam ser atualizados manualmente. À medida que os dados mudam, os casos de uso dos agentes se expandem e o comportamento dos usuários e os prompts evoluem, os catálogos de dados rapidamente ficam desatualizados. Além disso, geralmente não oferecem insights extraídos dos próprios dados. Eles conseguem descrever a estrutura e o esquema dos dados, mas não entidades, anomalias ou tendências que exigem pesquisa e recuperação de informações.
O que é um indicador de conhecimento?
O que é um indicador de conhecimento?
Um indicador de conhecimento é uma unidade de contexto. Pode ser qualquer elemento de contexto que seja útil para agentes, incluindo descrições de índices e fontes de dados, entidades extraídas, fatos baseados em documentos e muito mais.
O que é armazenado em um índice de IA?
O que é armazenado em um índice de IA?
Um índice de IA armazena indicadores de conhecimento derivados de fontes de dados e memórias geradas a partir das interações e dos rastreamentos dos agentes.
Como a segurança e as permissões são aplicadas?
Como a segurança e as permissões são aplicadas?
Os índices de IA podem ser gerenciados e ter suas permissões configuradas da mesma forma que outros índices do Elasticsearch, com controle de acesso completo baseado em funções. Fluxos de trabalho e agentes podem ser executados em nome de um usuário para limitar e auditar o acesso. O mecanismo de contexto também registra a procedência de cada indicador de conhecimento gerado, permitindo gerenciar o acesso.
Como é definido o preço do mecanismo de contexto?
Como é definido o preço do mecanismo de contexto?
Atualmente, o mecanismo de contexto não tem um preço separado durante a fase de prévia privada. Os preços serão anunciados posteriormente.