Estrategia de niveles de datos de Elastic: optimización para una implementación resiliente y eficiente

 Share on Twitter
Comparte en Twitter

 Share on LinkedIn
Comparte en LinkedIn

 Share on Facebook
Comparte en Facebook

 Share by Email
Comparte por correo electrónico

 Print this page
Imprime
En Elastic, la mayoría de nuestras implementaciones exitosas de clientes comienzan con un único caso de uso destinado a abordar requisitos comerciales específicos. A menudo, Elastic se adopta inicialmente porque los desarrolladores aprecian las características que ofrece. Sin embargo, debido a su flexibilidad y capacidad de personalización, los clientes tienden a ampliar su adopción para abordar diversas necesidades, como logging y monitoreo de rendimiento de aplicaciones, SIEM y operaciones de seguridad, e incluso casos de uso de búsqueda más complejos que utilizan los datos ya disponibles en Elastic.
En el entorno de TI actual, simplemente almacenar datos (logs, rastreos, métricas y documentos) es insuficiente. Las organizaciones necesitan una solución que permita a sus equipos acceder y utilizar estos datos de forma rápida y efectiva. La eficiencia es clave en la gestión de datos, ya que cada bit de datos almacenados genera costos de hardware, licencias, mantenimiento y gestión.
En este blog, analizaremos cómo las organizaciones con grandes cantidades de datos pueden optimizar la forma en que se almacenan en diferentes niveles para obtener ahorros de costos y derivar más valor de sus datos.
El desafío: gestión de datos eficiente y con escalabilidad
Las organizaciones adoran Elastic por su velocidad, escalabilidad, capacidad de personalización y funcionalidad. Debido a esto, a menudo encuentran nuevos casos de uso para Elastic. Esto se convierte en un desafío cuando se ingestan grandes cantidades de datos sin considerar cómo se almacenan, gestionan y utilizan, lo que puede provocar cuellos de botella en la gestión de datos. A medida que aumentan los datos, sus configuraciones actuales tienen dificultades para manejar las nuevas necesidades, alcanzando los límites de su hardware y licencias.
Si tu organización está experimentando estos problemas, la solución es más manejable de lo que podrías esperar.
La solución: una estrategia de datos impulsada por el negocio
La forma de superar este desafío es definiendo una estrategia de datos que se alinee con tus objetivos comerciales. En lugar de recopilar y conservar datos basados en requisitos arbitrarios, hazte las siguientes preguntas:
¿Qué datos deben recopilarse para impulsar un objetivo empresarial?
¿Con qué frecuencia se usan estos datos?
¿Existe una fecha de caducidad después de la cual estos datos ya no son valiosos?
¿Existen requisitos de cumplimiento para estos datos?
Con base en las respuestas a las preguntas anteriores, las organizaciones pueden crear una estrategia de datos orientada al negocio para optimizar la forma en que se almacenan y utilizan los datos, maximizando su inversión existente en Elastic.
Caso de estudio
Para mostrar los beneficios de adoptar esta estrategia, exploremos un caso de estudio de un cliente que ha pasado por este proceso.
Este cliente normalmente procesa 5 TB de datos por día y maneja un promedio de 250 000 eventos por segundo. Sin embargo, a veces el volumen aumenta a 7 TB por día y 350 000 eventos por segundo. La implementación de Elastic para este cliente se centró en la ingesta de un gran volumen de datos de seguridad y ponerlos a disposición del equipo del centro de operaciones de seguridad (SOC) para la búsqueda de información sobre incidentes cibernéticos e investigaciones de fraude.
Esta implementación fue tan exitosa que el cliente agregó nuevos casos de uso que requerían una retención de datos más larga y capacidades de búsqueda más rápidas desde una gama más amplia de fuentes de datos. Apuntaron a los siguientes resultados comerciales:
Optimización de log: Al optimizar sus niveles de datos, las organizaciones pueden mejorar sus prácticas de gestión de logs, asegurándose de conservar los logs correctos durante el tiempo adecuado, lo que mejora la eficiencia operativa y el cumplimiento de las normas.
Uso mejorado de la licencia: La estratificación eficiente del almacenamiento significa un mejor uso de la licencia, lo que permite a las organizaciones aprovechar al máximo sus recursos existentes y potencialmente evitar costos de licencia innecesarios.
Eficiencia empresarial mejorada: La capacidad de encontrar información a partir de logs de manera más eficiente puede llevar a una mejor eficiencia empresarial, lo que permite una toma de decisiones más rápida y una planificación estratégica más informada.
Incorporación de nuevos casos de uso: Con niveles de datos optimizados, las organizaciones pueden incorporar fácilmente nuevos casos de uso, expandiendo sus capacidades de analíticas de datos sin inversiones significativas en infraestructura.
Estrategia de datos clara: La optimización de los niveles de datos contribuye a una estrategia de datos clara, asegurando que los datos sean confiables, fácilmente accesibles y gobernados de manera efectiva, sentando las bases para la toma de decisiones basada en datos.
Jerarquización de datos
La división en niveles de datos es un tema complejo y matizado que merece su propio blog para ser analizado. Sin embargo, para los fines de definir una estrategia de datos, los diferentes niveles de datos pueden simplificarse en tres usos principales: ingesta, búsqueda y almacenar.
Ingesta (nivel hot): Ingesta datos lo más rápido posible con una latencia mínima.
Búsqueda (nivel caliente y tibio): Búsqueda de datos rápidamente y procesa grandes conjuntos de datos.
- Almacenar (nivel frío y congelado): Almacena datos durante el tiempo que sea necesario y realiza búsquedas ad-hoc de baja frecuencia.
Crecimiento y conservación de datos
Comprender el rango de requisitos de retención de datos es crucial para el cumplimiento y una gestión de datos eficiente. Diferentes normativas requieren periodos de retención variables:
Requisitos de retención SOX: 7 años
Requisitos de conservación de datos de HIPAA: 6 años
Requisitos de conservación de datos de PCI DSS: 1 año
Requisitos de conservación de datos de Basilea II: 3–7 años
Registros de empleados del RGPD:
Salarios: 3 años
Registros fiscales: 6 años
Nombre, dirección: 3 años
- Ley de Normas Justas de Trabajo: 2 – 3 años
Arquitectura anterior vs. nueva
Arquitectura anterior
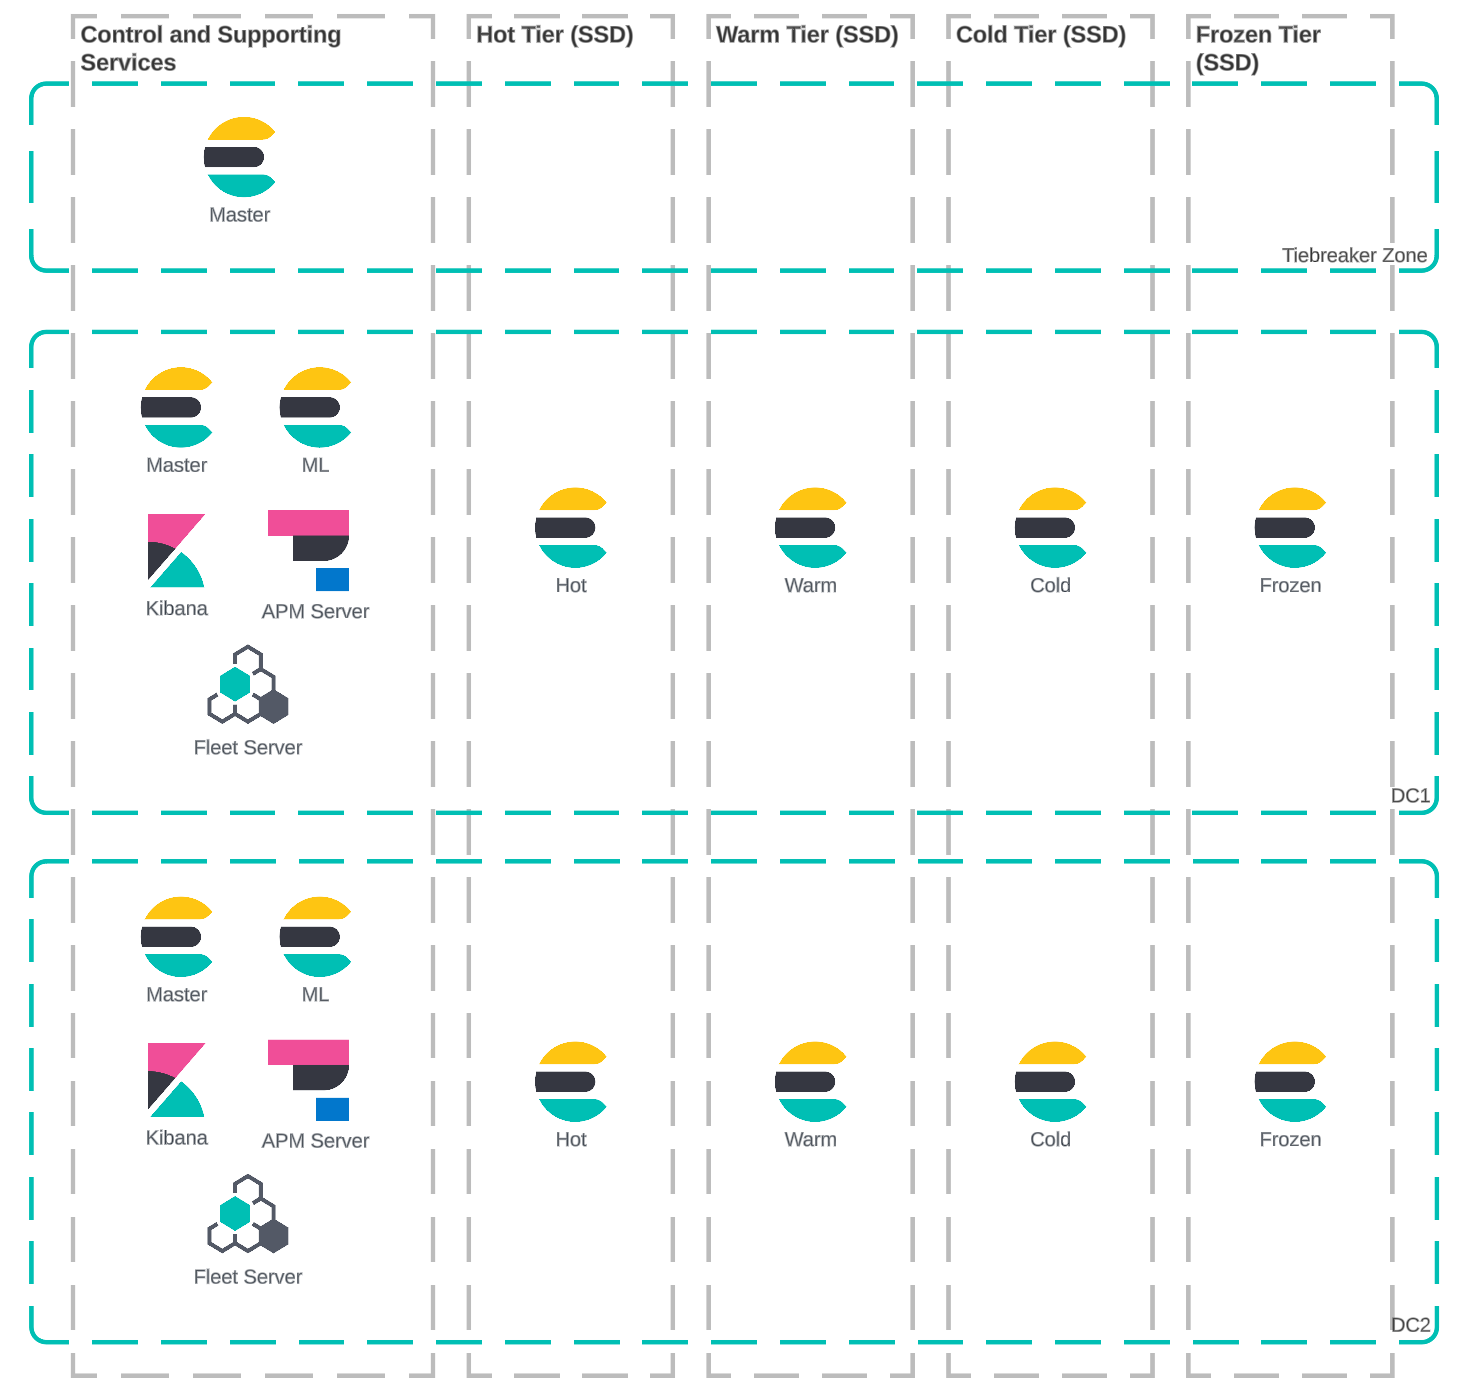
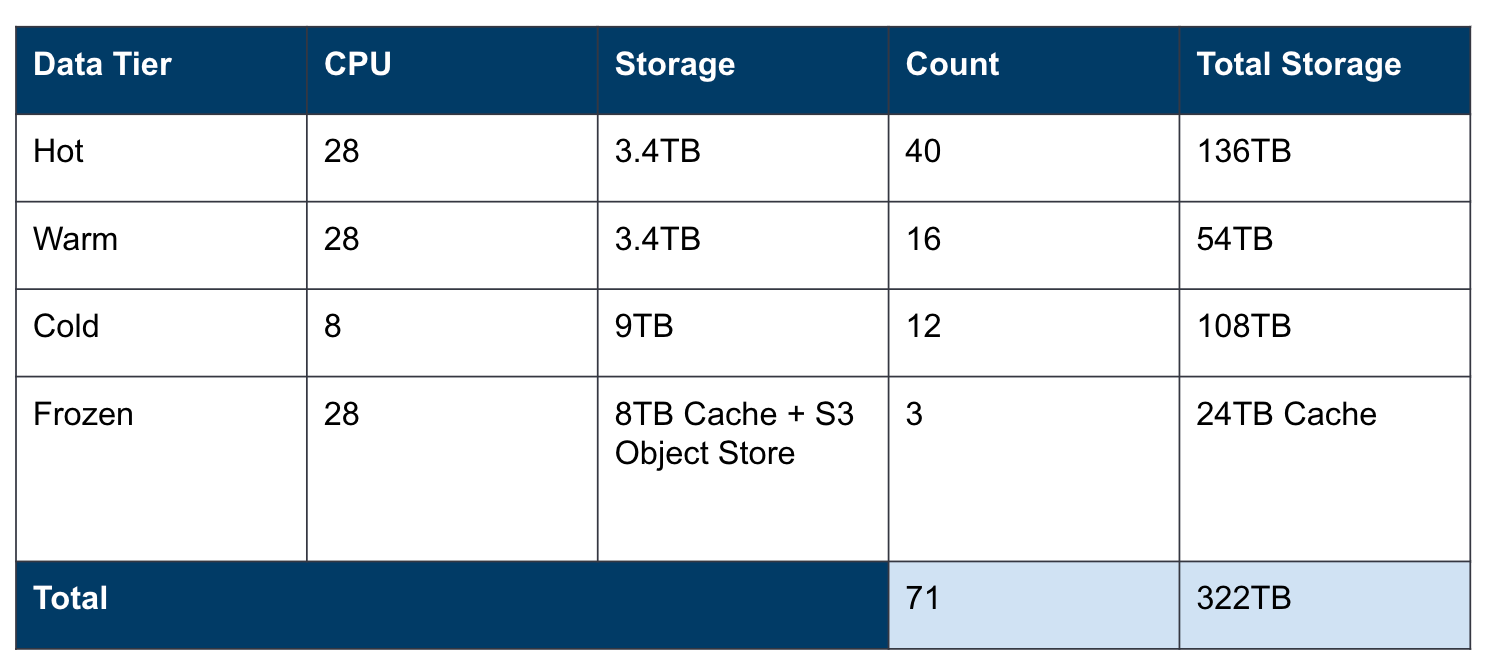
La arquitectura anterior tenía dos centros de datos con una implementación de almacenamiento de cuatro niveles que cubría diversas necesidades de manejo de datos. Esta implementación requería más hardware, licencias y gastos generales en la gestión operativa.
El cliente conservó todos los logs durante 90 días, independientemente de cómo se utilizaran los datos.
7 días caliente
2 días tibio
10 días en frío
Días restantes en congelado
El cliente tenía el mismo hardware tanto en el nivel caliente como en el tibio. El nivel tibio se utilizaba exclusivamente para forzar la fusión de índices para snapshots buscables. Los niveles tibio y frío estaban muy subutilizados tanto en CPU como en almacenamiento. El nivel congelado era limitado, lo que resultaba en búsquedas históricas lentas.
Nueva arquitectura
Tras revisar cómo se utilizaron los datos, se descubrieron los siguientes hallazgos:
La mayor parte de los datos de alto volumen solo se buscaron en las primeras 24 horas después de la ingesta.
Después de 24 horas, el uso principal de los datos fue para investigaciones de seguridad, lo cual requería búsquedas ad hoc.
Algunos índices seleccionados debían retenerse durante más tiempo para el reporte.
Debido a los nuevos requisitos de cumplimiento, los datos debían retenerse hasta por un año.
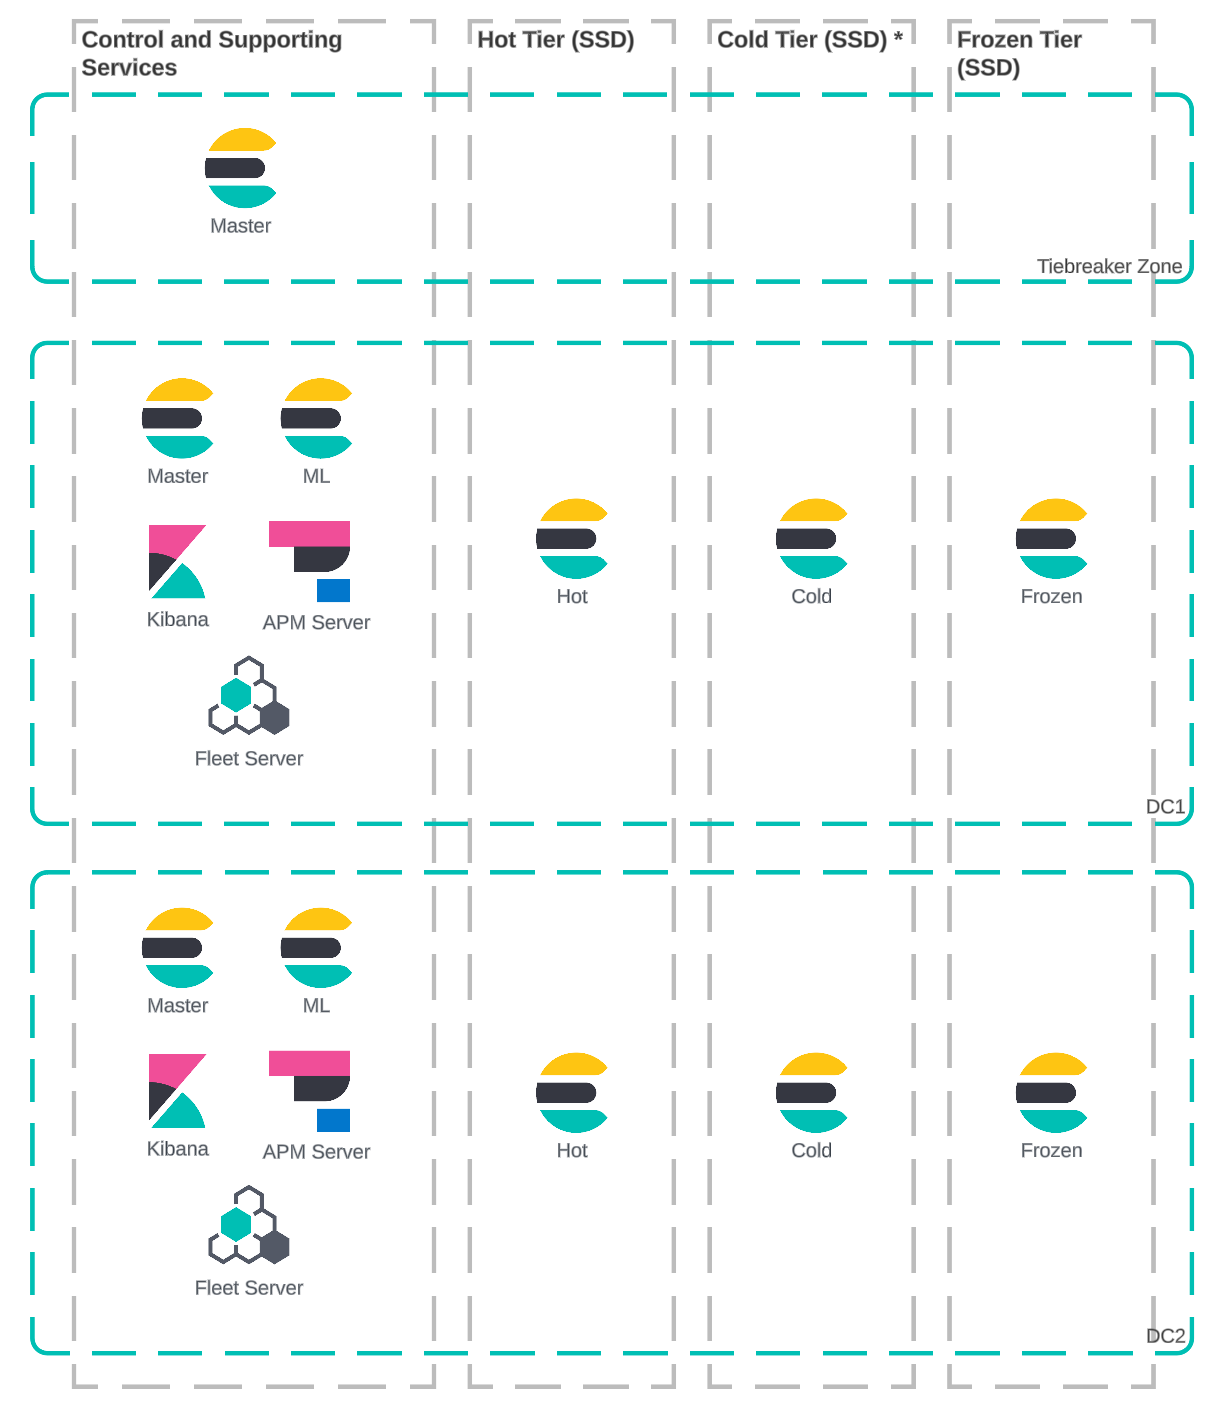
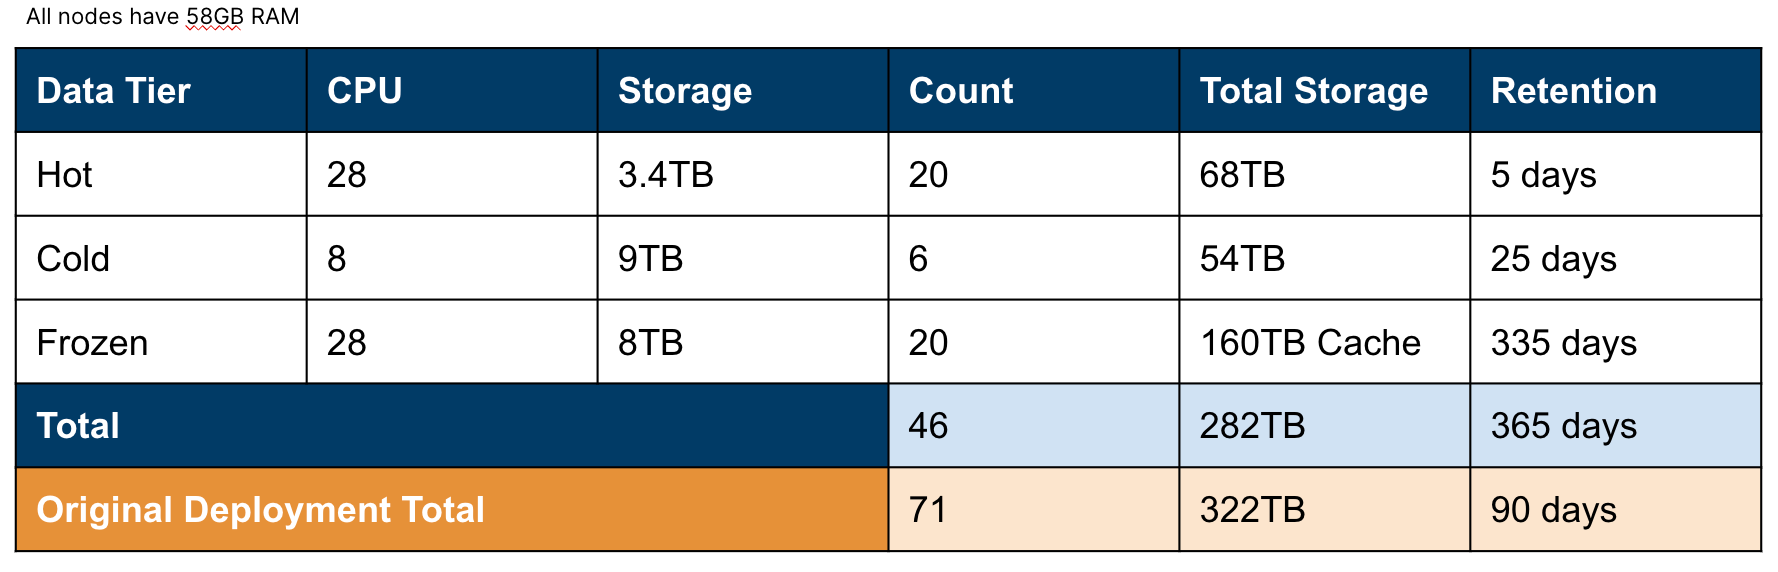
Migrar a una arquitectura caliente/frío/congelado
Los Node del nivel caliente tenían capacidad suficiente para realizar actividades de fusión forzada, lo que permitió eliminar el nivel tibio.
La mayor parte de los datos puede pasar del nivel caliente directamente al nivel congelado después de 36 horas.
Los datos que requieren almacenamiento local para casos de uso de reporte pueden mantenerse en el nivel frío.
El nivel caliente también puede reducirse porque hay menos datos que deben retenerse.
Ampliar el nivel congelado aumenta la cantidad de memoria caché disponible para las búsquedas, lo que mejora el rendimiento de búsqueda. Además, permite que los datos se conserven durante un año en lugar de solo 90 días.
Optimización del almacenamiento
Mejor densidad de almacenamiento: el nivel frío puede aprovechar un snapshot buscable como réplica. El nivel congelado almacena todos los datos en el repositorio de snapshot y solo almacena en caché los resultados de búsqueda en su caché local.
Una menor replicación de datos requiere menos Node, lo que reduce el uso de hardware y licencias.
Todos los niveles utilizan los mismos requisitos de almacenamiento, lo que permite consolidar y reutilizar el hardware fácilmente.
Los cambios liberaron entre 20 y 30 Node y licencias, que se reutilizaron para crear casos de uso adicionales.
La nueva arquitectura tiene como objetivo consolidar los perfiles de hardware para cargas de trabajo de logging y seguridad, introduciendo potencialmente una tercera zona para una mayor resiliencia. También se centra en la optimización del almacenamiento, incluida una mejor densidad de almacenamiento y una menor replicación de datos, lo que resulta en menos Node necesarios y una utilización optimizada de la licencia. Esta arquitectura permite la consolidación de perfiles de hardware.
Beneficios de la reestructuración
Estrategia de retención de datos mejorada: una estrategia de niveles de almacenamiento más eficiente puede conducir a una mejor retención de datos, lo cual puede ser particularmente importante para fines de seguridad y cumplimiento.
Gestión de Platform simplificada: Consolidar perfiles de hardware y reducir la cantidad de Node necesarios puede simplificar la gestión de la Platform, lo que reduce la carga operativa.
Huella de hardware reducida: La optimización de los recursos de cómputo y la densidad de almacenamiento puede llevar a una huella de hardware reducida, ahorrando espacio y energía.
ROI mejorado: Al optimizar sus niveles de almacenamiento, la organización puede lograr un mejor retorno de la inversión, aprovechando al máximo su infraestructura existente.
Las ventajas de la nueva arquitectura incluyen una gestión más simple, una mejor utilización de licencias y hardware, una mayor retención de datos y un despliegue más pequeño, lo que conduce a actualizaciones más rápidas y a una mayor resiliencia de la infraestructura. Sin embargo, las posibles desventajas pueden incluir un rendimiento de búsqueda más lento para ciertos casos de uso que requieren almacenamiento rápido con altos IOPS debido a que se almacenan más datos en los niveles congelados.
Implementación de la estrategia
Una estrategia de datos en niveles permite a las organizaciones optimizar el rendimiento para los datos recientes mientras almacenan de manera eficiente grandes volúmenes de datos. Al aprovechar la conciencia de asignación de shard, las organizaciones pueden definir las características de cada nivel y programar la migración de índices de acuerdo con la estrategia de datos. Esto garantiza que los datos se almacenen en el nivel de hardware más apropiado en cualquier momento, equilibrando las consideraciones de rendimiento y costo.
Ejemplos de niveles de almacenamiento y proporciones de memoria
La relación entre memoria y almacenamiento es una consideración crucial al planificar el crecimiento de Elastic. A continuación, se presentan los cuatro niveles de almacenamiento disponibles para los clientes de Elastic:
Nivel caliente: optimizado para el rendimiento de ingesta y búsqueda, normalmente mediante SSD de alta velocidad con una relación de memoria a almacenamiento de alrededor de 1:30
Nivel warm: Optimizado para la capacidad de almacenamiento, utilizando SSD o HDD con una proporción de memoria a almacenamiento de aproximadamente 1:160
Nivel frío: optimizado para la capacidad de almacenamiento mediante el uso de un snapshot buscable como réplica (aunque la relación de almacenamiento es la misma que en el nivel templado, la eliminación de una réplica local reduce a la mitad los requisitos de almacenamiento).
Nivel congelado: Optimizado para fines de archivo, emplea almacenamiento de snapshot económico con caché de disco local para proporcionar una relación memoria-almacenamiento superior a 1:1000
Análisis de costos de alto nivel de diferentes configuraciones de almacenamiento
En nuestro análisis, evaluamos el costo total de propiedad (TCO) para varias configuraciones de almacenamiento a fin de optimizar la implementación de Elastic de otro cliente. A continuación, se muestra un desglose detallado de estas configuraciones y sus costos asociados:
Clúster de ES autogestionado
1 TB de ingesta diaria
Retención total 365 días
| Configuración | Días de retención | Nodos | Costo de hardware | Costo de almacenamiento de snapshot | Costo total (TCO) |
| caliente-tibio | 7 caliente, 358 tibio | 4 calientes, 60 tibios | $44 954 | $7 665 | $52 619 |
| Caliente-tibio-frío | 7 caliente, 90 tibio, 268 frío | 4 calientes, 15 tibios, 23 fríos | $28 231 | $7 665 | $36 795 |
| Caliente-tibio-congelado | 7 caliente, 90 tibio, 268 congelado | 4 calientes, 15 tibios, 3 congelados | $17 051 | $7 665 | $22 204 |
| Caliente-congelado | 7 caliente, 358 congelado | 4 calientes, 4 congelados | $6 198 | $7 665 | $12 066 |
Consideraciones para la planificación de capacidad
Al planificar la capacidad para cada nivel, es crucial dimensionarlos de forma independiente según sus requisitos específicos. Esto implica comprender las necesidades de almacenamiento y rendimiento de cada nivel y asegurar que estén adecuadamente provisionados. Además, las organizaciones deben considerar los requisitos de capacidad general y cómo interactuarán los diferentes niveles para garantizar una estrategia de almacenamiento equilibrada y eficiente.
Reflexiones finales
Optimizar la jerarquización del almacenamiento no se trata solo de ahorrar costos; se trata de permitir que las organizaciones evolucionen y se adapten a nuevos desafíos y oportunidades.
Al abordar los desafíos de optimización de Platform empleando los principios de la estrategia de datos, las organizaciones pueden facilitar nuevos casos de uso, mejorar la fiabilidad de los datos y potenciar su estrategia global de datos. Consulta nuestra documentación para saber cómo tu organización puede construir una implementación resiliente y eficiente de Elastic empleando el datos tifering.
El momento del lanzamiento de cualquiera de las características o funcionalidades descritas en esta publicación queda a exclusivo criterio de Elastic. Es posible que algunas características o funcionalidades que no estén disponibles en este momento no se lancen a tiempo o no se lancen en absoluto.
Comparte
- Share on Twitter
Comparte en Twitter
- Share on LinkedIn
Comparte en LinkedIn
- Share on Facebook
Comparte en Facebook
- Share by Email
Comparte por correo electrónico
- Print this page
Imprime