Visualización de Sankey con Vega en Kibana 6.2
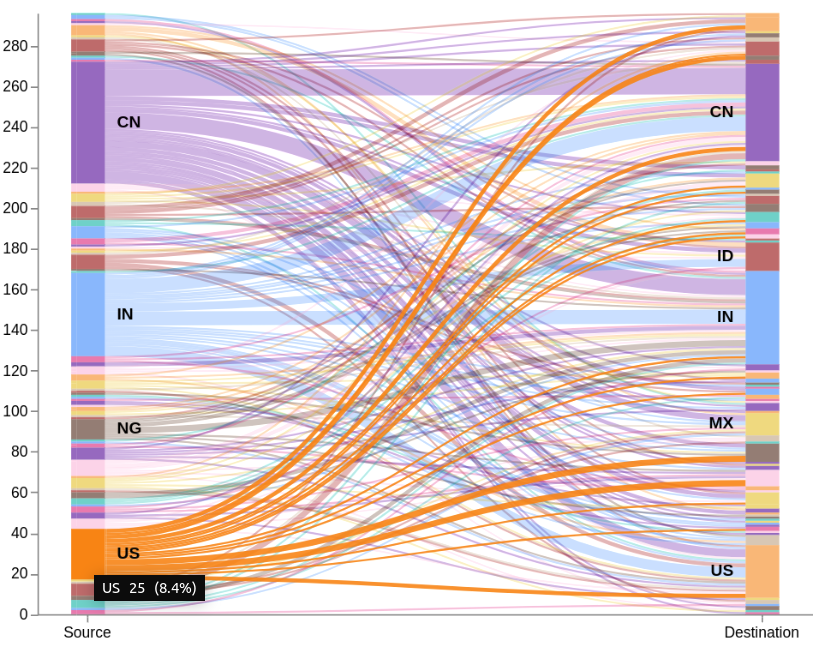
Continuando con la serie sobre la creación de grafos de Vega personalizados en Kibana, el tema de hoy es un grafo de Sankey simple de dos niveles para mostrar patrones de tráfico de red. (La última vez, hablamos sobre la visualización de Vega personalizada en Kibana.) Un diagrama de Sankey es un tipo de diagrama de flujo en el que el grosor de las líneas se muestra de forma proporcional a la cantidad de flujo. Cada entrada en los datos de muestra tiene un código de país de origen y de destino. El grafo tendrá dos modos: todos a todos (predeterminado), además de que permitirá a los usuarios seleccionar el país de origen o el de destino, y mostrar solo el tráfico relacionado.
Requisitos previos
- Descargar Elasticsearch 6.2 o posterior
- Descomprime y ejecuta
bin/elasticsearch - Descargar Kibana 6.2 o posterior(misma versión que Elasticsearch)
- Descomprime y ejecuta
bin/kibana - Usa la utilidad makelogs para generar datos de muestra. Instálalo con
npm install -g makelogs, ejecútalo conmakelogs. Es posible que quieras generar un set de datos más grande con un parámetro-c 100k. Esto asume que ya tienes NPM. ¡No hagas esto en un clúster de producción! - Ve a http://localhost:5601/
- Haz clic en la pestaña Management (último icono a la izquierda), crea un nuevo patrón de índice: introduce
logstash-*para el patrón de índice, haz clic en Next step, elige@timestamppara el filtro de tiempo y haz clic en Create index pattern. - Prueba que todo funcione usando la pestaña Discover, configurando el filtro de tiempo en la esquina superior derecha para la última 1 hora y observando datos generados aleatoriamente.
datos
Para este ejemplo, usaré geo.src (como el primer stack) y geo.dest (como el segundo stack) campos de los datos aleatorios generados por la utilidad makelogs. Los campos representan el origen y el destino del tráfico. Esta búsqueda agregaría por ambos campos usando la agregación compuesta de Elasticsearch, contar la cantidad de documentos para cada combinación y devolver los primeros 10.
GET logstash-*/_search
{
  "size":0,
  "aggs": {
    "table": {
      "composite": {
        "size":10,
        "sources": [
          {"stk1": {"terms": {"campo": "geo.src"}}},
          {"stk2": {"terms": {"campo": "geo.dest"}}}
        ]
      }
    }
  }
}
Intenta ejecutar esta búsqueda en la pestaña Dev Tools: deberías ver algo así:
{
  // ... omitiendo algo de metainformación ...
  "aggregations": {
    "table": {
      "buckets": [
        {
          "key": {
            "stk1": "AE",
            "stk2": "AR"
          },
          "doc_count": 1
        },
        {
          "key": {
            "stk1": "AE",
            "stk2": "BD"
          },
          "doc_count": 2
        },
        // ... 8 objetos más
    ]
  }
}
Estrategia de visualización
Podemos pensar en el grafo de Sankey como Node organizados en pilas, con aristas que conectan los Node. Para este grafo solo tenemos dos pilas: la de origen y la de destino. Las dos pilas se dibujan como barras verticales, una a cada lado de la pantalla. Cada pila tiene países apilados uno encima del otro. Cada país consiste en Node: porciones del país de origen que están conectadas con los Node en el país de destino.
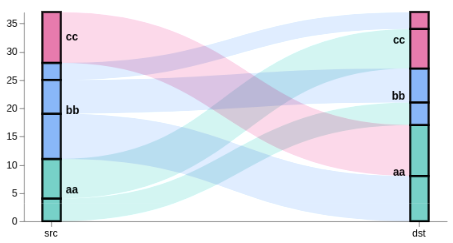
Necesitamos tener varias tablas de datos para dibujar el grafo anterior:
- Node (nodos) Esta tabla no se utilizará para dibujar directamente, pero se usará como fuente de datos para las otras tablas. Podemos visualizar los Node como cajas negras en la imagen de arriba; tenemos 12 de ellos aquí. Cada Node consiste en el recuento de documentos que representa, el ID del stack, el código de país y la posición dentro del stack (
y0ay1). Ten en cuenta que esta tabla no tiene ninguna coordenada de "pantalla", solo los datos fuente. Incluso la posición en el stack se expresa en términos de recuentos de documentos. El primer Node iría de0..n1-1, el segundo serían1..n2-1, etc. Además, como tenemos dos stacks, habría dos de los primeros, segundos, ... Node, uno para cada stack. - aristas Una lista de líneas (6 en este caso), cada una conectando un Node en los lados izquierdo y derecho. La línea necesitará un par de coordenadas (x, y), grosor de línea (strikeWidth) y color de línea (igual que el Node de origen). Esta tabla se genera tomando todas las filas
stack=="stk1"de la tabla de Node y buscando el Node correspondiente para el stack de destino. Una transformación linkpath genera el texto de ruta SVG que describe la línea curva. - groups Cada grupo combina todos los Node del mismo país para el mismo stack. En este grafo tenemos 6 grupos, 3 a cada lado. Cada grupo debe tener un ID de stack (stk1 o stk2), el valor Y inicial y final (y0 e y1, similar a la tabla de Node) y el código de país. Esta tabla también se genera a partir de la tabla de Node, agrupándola por ID de stack y código de país, y apilándola de forma similar a los Node. Los valores y se alinearán con la tabla de Node porque ordenamos ambas tablas según los mismos valores.
Además de las tablas, uso tres escalares para proyectar desde el "espacio de coordenadas de datos" hacia el "espacio de coordenadas de pantalla". El escalar "x" determina la ubicación de las pilas stk1 y stk2 en la pantalla. La escala "y" mapea la altura del grafo a la altura total de todos los Node en la pila más alta (en nuestro caso, ambas pilas tienen la misma altura). Por último, la "color" escalar asigna un color a cada país.
El último paso es convertir las tablas de datos en elementos visuales mediante tres marcas: la marca path para los bordes, la marca rect para las pilas y la marca de texto para las etiquetas de país.
Interacciones
En este punto verás el grafo esperado, pero a menudo querrás definir cómo pueden interactuar los usuarios con el grafo. Esto se hace con señales —variables dinámicas que cambian su valor según los eventos y pueden usarse en varias expresiones.
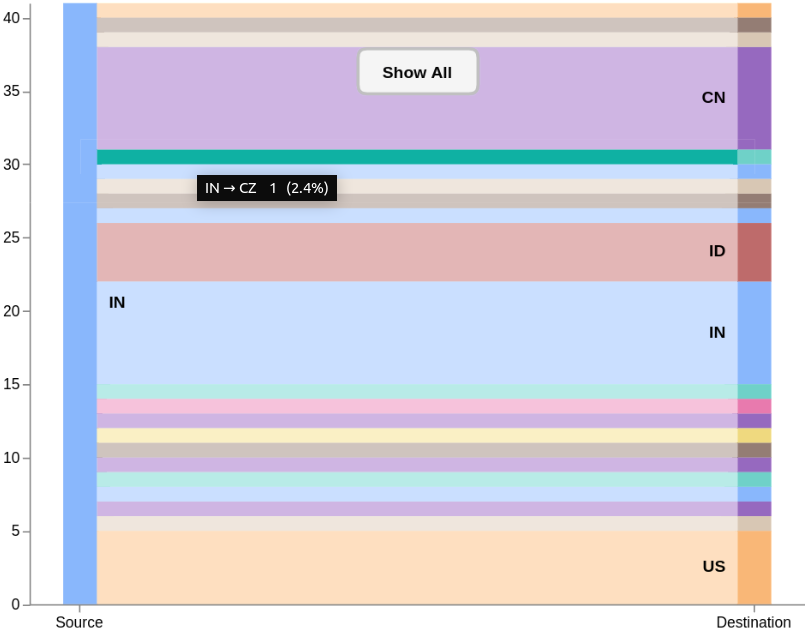
Cuando un usuario hace clic en un grupo de países en la pila de origen, el grafo debe ocultar todos los datos que no sean del país seleccionado. Del mismo modo, debería funcionar al hacer clic en el lado de destino. Esto se hace definiendo una señal groupSelector. Cuando se hace clic en groupMark, la señal se establece en el código de país como origen o destino. La tabla de Node se filtra automáticamente según el valor de la señal, y el grafo se vuelve a dibujar como si no existieran otros datos. Para volver atrás, muestro un cuadro rectangular en el medio con una marca de texto. Al hacer clic en el cuadro se restablece la señal, lo que restaura la tabla de Node a la lista completa.
Otra interacción es el "mouseover" sobre los países en las pilas. En el evento mouseover de groupMark, la señal groupHover se establece de forma similar a groupSelector. La señal se utiliza para controlar la transparencia de las líneas de borde.
Depuración y exploración
Entender el código de Vega puede ser un desafío a veces. Afortunadamente, puedes acceder al estado interno de Vega en cualquier momento usando las herramientas de depuración del navegador. En Firefox y Chrome, usa Control+Shift+I (Windows, Linux) o Command+Option+I (Mac). Usa la consola para ver el contenido de la tabla, p. ej. console.table(VEGA_DEBUG.view.datos('edges')) o el estado de una señal con VEGA_DEBUG.view.signal('height'). Incluso puedes ver los valores internos de escalar con VEGA_DEBUG.view._runtime.scales.y.
Código de Vega
Consulta los comentarios del código para obtener una explicación de lo que hace cada línea, o lee la documentación de Vega. Ten en cuenta que este código utiliza HJSON, una forma más legible de JSON.
{
  $schema: https://vega.github.io/schema/vega/v3.0.json
  datos: [
    {
      // realizar búsqueda en ES según el rango de tiempo seleccionado actualmente y el texto de filtro
      name: rawData
      url: {
        %context%: true
        %timefield%: @timestamp
        índice: logstash-*
        cuerpo: {
          size: 0
          aggs: {
            tabla: {
              compuesto: {
                tamaño: 10000
                fuentes: [
                  {
                    stk1: {
                      términos: {field: "geo.src"}
                    }
                  }
                  {
                    stk2: {
                      términos: {field: "geo.dest"}
                    }
                  }
                ]
              }
            }
          }
        }
      }
      // Del resultado, toma solo los datos que nos interesan
      formato: {property: "aggregations.table.buckets"}
      // Convertir key.stk1 -> stk1 para un acceso más sencillo a continuación
      transformación: [
        {type: "formula", expr: "datum.key.stk1", as: "stk1"}
        {type: "formula", expr: "datum.key.stk2", as: "stk2"}
        {type: "formula", expr: "datum.doc_count", as: "size"}
      ]
    }
    {
      nombre: Node
      source: rawData
      transformación: [
        // cuando se selecciona un país, filtrar los datos no relacionados
        {
          tipo: filtro
          expr: !groupSelector || groupSelector.stk1 == datum.stk1 || groupSelector.stk2 == datum.stk2
        }
        // Establecer una clave nueva para búsquedas posteriores: identifica cada node
        {type: "formula", expr: "datum.stk1+datum.stk2", as: "key"}
        // en lugar de cada fila de la tabla, crea dos filas nuevas,
        // uno para el origen (stack=stk1) y otro para el Node de destino (stack=stk2).
        // El código de país almacenado en los campos stk1 y stk2 se coloca en el campo grpId.
        {
          tipo: veces
          campos: ["stk1", "stk2"]
          as: ["stack", "grpId"]
        }
        // Crea una sortkey, diferente para los stacks stk1 y stk2.
        // El separador de espacio asegura el orden de clasificación correcto en algunos casos excepcionales.
        {
          tipo: fórmula
          expr: datum.stack == 'stk1' ? datum.stk1+' '+datum.stk2 : datum.stk2+' '+datum.stk1
          as: sortField
        }
        // Calcula las posiciones y0 e y1 para apilar Node uno encima del otro,
        // de forma independiente para cada pila, y asegurando que estén en el orden correcto,
        // alfabético desde la parte superior (invertido en el eje Y)
        {
          type: stack
          groupby: ["stack"]
          sort: {field: "sortField", order: "descending"}
          campo: tamaño
        }
        // calcular el punto central vertical para cada Node, usado para dibujar bordes
        {type: "formula", expr: "(datum.y0+datum.y1)/2", as: "yc"}
      ]
    }
    {
      nombre: grupos
      fuente: Node
      transformación: [
        // combinar todos los Node en grupos de países, sumando los recuentos de documentos
        {
          tipo: agregación
          groupby: ["stack", "grpId"]
          campos: ["size"]
          ops: ["sum"]
          as: ["total"]
        }
        // volver a calcular los valores de apilamiento y0,y1
        {
          type: stack
          groupby: ["stack"]
          sort: {field: "grpId", order: "descending"}
          campo: total
        }
        // valores de y0 y y1 del proyecto a coordenadas de pantalla
        // hacerlo una vez aquí en lugar de hacerlo varias veces en las marcas
        {type: "formula", expr: "scale('y', datum.y0)", as: "scaledY0"}
        {type: "formula", expr: "scale('y', datum.y1)", as: "scaledY1"}
        // indicador booleano si la etiqueta debe estar a la derecha de la pila
        {type: "formula", expr: "datum.stack == 'stk1'", as: "rightLabel"}
        // Calcular el porcentaje de tráfico para este país usando el escalar
        // límite superior del dominio, que representa el tráfico total
        {
          tipo: fórmula
          expr: datum.total/domain('y')[1]
          como: porcentaje
        }
      ]
    }
    {
      // Esta es una tabla de búsqueda temporal con todos los Node de stack 'stk2'
      nombre: destinationNodes
      fuente: Node
      transformación: [
        {type: "filter", expr: "datum.stack == 'stk2'"}
      ]
    }
    {
      nombre: edges
      fuente: Node
      transformación: [
        // solo queremos Node de la pila izquierda
        {type: "filter", expr: "datum.stack == 'stk1'"}
        // buscar el Node correspondiente de la pila derecha, mantenerlo como "target"
        {
          tipo: búsqueda
          de: destinationNodes
          clave: clave
          fields: ["campo"]
          as: ["target"]
        }
        // calcular la ruta de enlace SVG entre los stacks stk1 y stk2 para el par de Node
        {
          tipo: linkpath
          orient: horizontal
          forma: diagonal
          sourceY: {expr: "scale('y', datum.yc)"}
          sourceX: {expr: "scale('x', 'stk1') + bandwidth('x')"}
          targetY: {expr: "scale('y', datum.target.yc)"}
          targetX: {expr: "scale('x', 'stk2')"}
        }
        // Un pequeño truco para calcular el grosor de la línea.
        // El valor debe ser el mismo que la altura del Node, pero escalando
        // el tamaño respecto a la altura de la pantalla da un valor invertido porque la Y de la pantalla
        // la coordenada va de arriba abajo, mientras que el Y=0 del grafo
        // está en la parte inferior. Por lo tanto, restar el conteo de documentos escalado de la altura de la pantalla
        // (que es el límite "inferior" de la escala "y") nos da el valor correcto
        {
          tipo: fórmula
          expr: range('y')[0]-escalar('y', datum.size)
          as: strokeWidth
        }
        // La información sobre herramientas necesita el porcentaje de tráfico total del enlace individual
        {
          tipo: fórmula
          expr: datum.size/domain('y')[1]
          como: porcentaje
        }
      ]
    }
  ]
  escalar: [
    {
      // calcula el posicionamiento de la pila horizontal
      nombre: x
      tipo: banda
      rango: ancho
      dominio: ["stk1", "stk2"]
      paddingOuter: 0.05
      paddingInner: 0.95
    }
    {
      // esta escala sube tanto como el valor y1 más alto de todos los Node
      nombre: y
      tipo: lineal
      rango: altura
      dominio: {data: "nodes", field: "y1"}
    }
    {
      // usa rawData para asegurar que los colores permanezcan iguales al hacer clic.
      nombre: color
      tipo: ordinal
      rango: categoría
      dominio: {data: "rawData", fields: ["stk1", "stk2"]}
    }
    {
      // esta escala se utiliza para mapear los id internos (stk1, stk2) a nombres de stack
      nombre: stackNames
      tipo: ordinal
      range: ["Source", "Destination"]
      dominio: ["stk1", "stk2"]
    }
  ]
  axes: [
    {
      // el eje x debe usar un formato de etiqueta personalizado para imprimir los nombres de stack correctos
      orient: abajo
      escalar: x
      codificar: {
        etiquetas: {
          actualización: {
            texto: {scale: "stackNames", field: "value"}
          }
        }
      }
    }
    {orient: "left", scale: "y"}
  ]
  marcas: [
    {
      // dibujar la línea de conexión entre stacks
      tipo: ruta
      nombre: edgeMark
      desde: {data: "edges"}
      // esto previene algunos problemas de dimensionamiento automático con un strokeWidth grande para las rutas
      clip: true
      codificar: {
        actualización: {
          // De forma predeterminada, usa el color del Node izquierdo, excepto cuando se muestra el tráfico
          // desde un solo país, en cuyo caso usa el color de destino.
          stroke: [
            {
              test: groupSelector && groupSelector.stack=='stk1'
              escalar: color
              campo: stk2
            }
            {scale: "color", field: "stk1"}
          ]
          strokeWidth: {field: "strokeWidth"}
          ruta: {field: "path"}
          // al mostrar todo el tráfico y desplazar el puntero sobre un país,
          // resaltar el tráfico de ese país.
          strokeOpacity: {
            signal: !groupSelector && (groupHover.stk1 == datum.stk1 || groupHover.stk2 == datum.stk2) ? 0,9 : 0,3
          }
          // Asegúrate de que los bordes seleccionados al pasar el puntero se muestren en la parte superior
          zindex: {
            signal: !groupSelector && (groupHover.stk1 == datum.stk1 || groupHover.stk2 == datum.stk2) ? 1 : 0
          }
          // formatear texto de información sobre herramientas
          información sobre herramientas: {
            señal: datum.stk1 + ' → ' + datum.stk2 + '    ' + format(datum.size, ',.0f') + '   (' + format(datum.percentage, '.1%') + ')'
          }
        }
        // Resaltado simple al pasar el mouse sobre una sola línea
        al pasar el cursor: {
          strokeOpacity: {value: 1}
        }
      }
    }
    {
      // dibujar grupos de stack (países)
      tipo: rect
      nombre: groupMark
      desde: {data: "groups"}
      codificar: {
        aquí es donde entra: {
          completa: {scale: "color", field: "grpId"}
          ancho: {scale: "x", band: 1}
        }
        actualización: {
          x: {scale: "x", field: "stack"}
          y: {field: "scaledY0"}
          y2: {field: "scaledY1"}
          fillOpacity: {value: 0.6}
          información sobre herramientas: {
            signal: datum.grpId + '   ' + format(datum.total, ", ',.0f') + '   (' + format(datum.percentage, '.1%') + ')'
          }
        }
        al pasar el cursor: {
          fillOpacity: {value: 1}
        }
      }
    }
    {
      // dibujar etiquetas de código de país en el lado interno del stack
      tipo: texto
      desde: {data: "groups"}
      // no proceses eventos para las etiquetas; de lo contrario, el mouseover de la línea no se verá limpio
      interactive: false
      codificar: {
        actualización: {
          // dependiendo de qué stack sea, posiciona x con algo de relleno
          x: {
            signal: escalar('x', datum.stack) + (datum.rightLabel ? bandwidth('x') + 8 : -8)
          }
          // en medio del grupo
          yc: {signal: "(datum.scaledY0 + datum.scaledY1)/2"}
          alinear: {signal: "datum.rightLabel ? 'left' : 'right'"}
          línea base: {value: "middle"}
          Peso de la fuente: {value: "bold"}
          // mostrar solo la etiqueta de texto si la altura del grupo es lo suficientemente grande
          texto: {signal: "abs(datum.scaledY0-datum.scaledY1) > 13 ? datum.grpId : ''"}
        }
      }
    }
    {
      // Crea un botón de "mostrar todo". Se muestra solo cuando se selecciona un país.
      tipo: grupo
      datos: [
        // Necesitamos hacer que el botón se muestre solo cuando la señal groupSelector sea true.
        // Cada marca se dibuja tantas veces como elementos haya en los datos de respaldo.
        // Lo que significa que si la lista de valores está vacía, no se dibujará.
        // Aquí creo una fuente de datos con un objeto vacío y filtro esa lista
        // basado en el valor de la señal. Esto solo se puede hacer en un grupo.
        {
          nombre: dataForShowAll
          valores: [{}]
          transform: [{type: "filter", expr: "groupSelector"}]
        }
      ]
      // Establecer el tamaño y la posición del botón
      codificar: {
        aquí es donde entra: {
          xc: {signal: "width/2"}
          y: {value: 30}
          ancho: {value: 80}
          altura: {value: 30}
        }
      }
      marcas: [
        {
          // Este grupo se muestra como un botón con esquinas redondeadas.
          tipo: grupo
          // el nombre de marca permite la captura de señales
          name: groupReset
          // Solo muestra el botón si dataForShowAll tiene valores.
          desde: {data: "dataForShowAll"}
          codificar: {
            aquí es donde entra: {
              cornerRadius: {value: 6}
              completa: {value: "#f5f5f5"}
              trazo: {value: "#c1c1c1"}
              strokeWidth: {value: 2}
              // usar el tamaño del grupo primario
              height: {
                campo: {group: "height"}
              }
              ancho: {
                campo: {group: "width"}
              }
            }
            actualización: {
              // los grupos son transparentes de forma predeterminada
              opacidad: {value: 1}
            }
            al pasar el cursor: {
              opacidad: {value: 0.7}
            }
          }
          marcas: [
            {
              tipo: texto
              // si es verdadero, prevendrá hacer clic en el botón cuando esté sobre el texto.
              interactive: false
              codificar: {
                aquí es donde entra: {
                  // centrar el texto en el grupo de paréntesis
                  xc: {
                    campo: {group: "width"}
                    mult: 0.5
                  }
                  yc: {
                    campo: {group: "height"}
                    mult: 0.5
                    compensación: 2
                  }
                  alinear: {value: "center"}
                  línea base: {value: "middle"}
                  Peso de la fuente: {value: "bold"}
                  texto: {value: "Show All"}
                }
              }
            }
          ]
        }
      ]
    }
  ]
  señales: [
    {
      // utilizado para resaltar el tráfico hacia/desde el mismo país
      name: groupHover
      valor: {}
      on: [
        {
          eventos: @groupMark:mouseover
          update: "{stk1:datum.stack=='stk1' && datum.grpId, stk2:datum.stack=='stk2' && datum.grpId}"
        }
        {events: "mouseout", update: "{}"}
      ]
    }
    // se usa para filtrar solo los datos relacionados con el país seleccionado
    {
      name: groupSelector
      valor: false
      on: [
        {
          // Al hacer clic en groupMark, se establece esta señal en los valores de filtro
          eventos: @groupMark:click!
          update: "{stack:datum.stack, stk1:datum.stack=='stk1' && datum.grpId, stk2:datum.stack=='stk2' && datum.grpId}"
        }
        {
          // Hacer clic en el botón "show all" (mostrar todo), o hacer doble clic en cualquier parte lo restablece
          eventos: [
            {type: "click", markname: "groupReset"}
            {type: "dblclick"}
          ]
          update: "false"
        }
      ]
    }
  ]
}
Componentes de resaltado
Para resaltar los componentes de las pilas y generar la imagen de explicación anterior, reemplaza la sección url con estos valores codificados de forma rígida y añade una marca adicional después de todas las demás marcas.
valores: {
  agregaciones: { table: { cubetas: [
    {key: {stk1:"aa", stk2:"cc"}, doc_count: 7}
    {key: {stk1:"aa", stk2:"bb"}, doc_count: 4}
    {key: {stk1:"bb", stk2:"aa"}, doc_count: 8}
    {key: {stk1:"bb", stk2:"bb"}, doc_count: 6}
    {key: {stk1:"bb", stk2:"cc"}, doc_count: 3}
    {key: {stk1:"cc", stk2:"aa"}, doc_count: 9}
]}}}


{
  tipo: rect
  desde: {data: "nodes"}
  codificar: {
    aquí es donde entra: {
      trazo: {value: "#000"}
      strokeWidth: {value: 2}
      ancho: {scale: "x", band: 1}
      x: {scale: "x", field: "stack"}
      y: {field: "y0", scale: "y"}
      y2: {field: "y1", scale: "y"}
    }
  }
}
Enlaces útiles:
- Documentos sobre Vega en Kibana
- Documentación de Vega
- Ejemplos de Vega
- Documentación de Vega-Lite
- Ejemplos de Vega-Lite
Preguntas y comentarios
Para debatir sobre esta publicación de blog, utiliza nuestro foro